

写文章


- @hdddddddd1234567


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
Mineru本地部署(截止2025.7.21)
配置这个过程踩雷不少,故简单写一篇博客作为记录,也供大家参考。mineru一直都在更新迭代,故教程都是针对当前时间节点的,但基本其他版本要做的工作也是环境配置和模型下载这两步,都可以参考。大家一定要仔细阅读官方的readme,我就是觉得已经配环境无数,直接半调子开跑,所以踩坑无数,折腾了很久。可以参考和。
LLM微调实战Demo项目——实现自己的AI微信分身
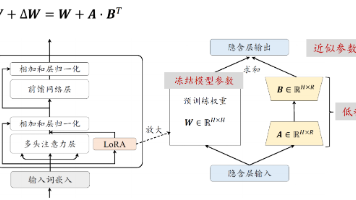
摘要:本文介绍了基于LLaMA-Factory框架的大模型微调实践,重点探讨了LoRA和QLoRA两种高效微调方法。通过个人微信聊天记录微调Qwen2.5-1.5B-Instruct模型,详细阐述了数据收集、处理、模型训练及WebUI搭建的全过程。实验采用特定好友的私聊数据保持风格一致性,使用4-bit量化和低秩适配技术降低显存需求。最终实现的对话系统能较好模仿个人说话风格,相比原始模型更具自然对
YOLO引入注意力模块
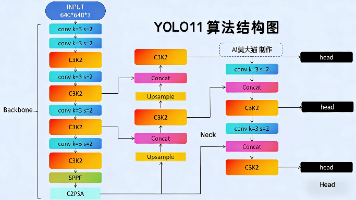
这里对自己简单的修改YOLO网络做一个记录,YOLO这个框架非常成熟(修改yolov8、v9、v11等等都是相同的方法),进行这种即插即用模块的修改非常简单,下面我会以非常典型的CBAM模块为例子。

到底了