- @chen695969


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
DeepSeekMine 2.2.0版本带来多项优化:界面适配暗黑/浅色模式;检索算法升级,精准问答情况下(问题详细且不模糊)正确率达75%-80%;百万字文件上传速度提升至1秒内;修复API调用问题,支持7家供应商;新增OCR图片识别、密码找回、翻译智能体功能;优化笔记编辑体验;支持自定义知识库存储位置;针对qwen3模型进行专项优化,8GB显存下性能接近满血大模型。下载地址:https://d

该项目是基于Django的校园二手交易平台开发项目。项目目标是为大学生提供一个安全便捷的校园二手物品买卖平台。项目的主要功能包括用户注册和认证、物品发布和搜索、交易信息管理等。项目开发遵循敏捷开发方法和迭代开发流程,通过持续的迭代和测试逐步改进和扩展功能。

DeepSeek于2026年7月起在V4-Flash与V4-Pro中原生支持OpenAI Responses协议,实现Agent优先的多步推理、工具调用与流式语义事件输出,虽无服务端状态管理,但核心能力完备。此举大幅降低开发者构建复杂Agent系统的工程成本,减少协议转换层依赖,推动国产大模型向“代理式”接口对齐,标志着协议能力成为新一代AI基础设施的关键竞争点。

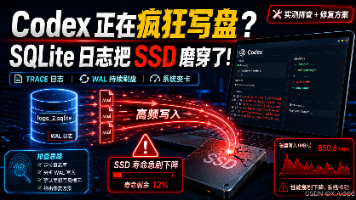
Codex 疯狂写盘的锅终于查到了:不是代码,不是系统,而是本地 SQLite 日志库。本文用亲测方式还原问题、定位 logs_2.sqlite 异常写入,并给出一条命令完成备份、拦截、清 WAL、验证的修复方案。
邓俊辉算法训练营,如果需要答案代码可以私聊博主有任何疑问或者问题,也欢迎私信博主,大家可以相互讨论交流哟~~

自然语言处理(NLP)是人工智能和计算语言学的一个分支,致力于使计算机能够理解、解释和生成人类语言。这篇博文将深入探讨自然语言处理的基础知识、挑战、典型任务及其广泛的应用前景。自然语言处理致力于使计算机理解和生成自然语言。其本质在于结构预测,即从输入的自然语言中提取出有用的结构化信息。例如,从句子“The rat ate cheese”中提取出其句法结构。结构预测的过程涉及到多个层次的语言分析,包

scikit-learn是一款用于数据挖掘和数据分析的简单高效的工具,基于NumPy、SciPy和Matplotlib构建。它能够进行各种机器学习任务,如分类、回归和聚类。

在这篇全面深入的博文中,我们将带您穿越机器学习的世界,从最基础的概念出发,一步步深入到最尖端的技术和方法。我们不仅仔细剖析了监督学习和无监督学习的细节、技巧和应用场景,还探讨了深度学习和集成学习如何推动着机器学习领域的快速发展。此外,文章还深入讨论了过拟合、数据限制等实验设计中的关键问题,以及贝叶斯统计和最小描述长度等学习理论的分析,为读者提供了一幅机器学习领域的全景图。

这意味着⾸先要创建折叠,然后使⽤这些折叠为数据的不同列创建⽬标编码特征,⽅法与在折叠上拟合和预测模型的⽅法相同。因此,如果您创建了 5 个折叠,您就必须创建5 次⽬标编码,这样最终,您就可以为每个折叠中的变量创建编码,⽽这些变量并⾮来⾃同⼀个折叠。随机森林模型的粉丝会从这⾥开始,⽽忽略逻辑回归模型,认为这是⼀个⾮常简单的模型,不能带来⽐随机森林更好的价值。如果使⽤这种⽅法,最终可能会创建⼤量特征,

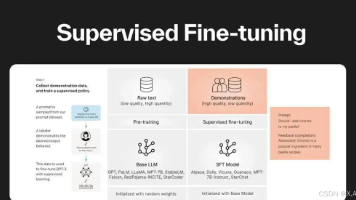
本文系统梳理大模型微调关键问题,涵盖显存估算、灾难性遗忘、数据构建、领域适配及训练优化等20个核心议题,为高效、稳定地开展全参数微调与指令微调提供实践指南