


- @a358463121


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
文本是教程"The Universal Approximation Theorem for neural networks" by Michael Nielsen的笔记。Universal approximation theorem为什么MLP可以拟合任意的函数?我们考虑一个最简单的神经网络,最后一层是sigmoid函数:事实上这就是一个线性函数,然后经过sigmoid扭曲为一条曲线,显然,b决定
沙普利值来源于合作博弈,cooperative game (coalitional game)。区别于传统博弈认为个体之间是相互独立的并分析其纳什均衡的方法,合作博弈会考虑每个player之间的协作关系,分析合作中会出现的112的收益等情景。合作博弈中一般包含N个参与者,以及一个用于评估不同参与者合作收益的value functionv, 且vϕ0。Shapley value的目的就是解释在一次可
探索性数据分析介绍当有人扔给你一份数据时,你对这份数据完全陌生,又没有足够的业务背景,会不会感觉无从下手。如果你什么都不管,直接把数据喂给各种模型,却发现效果不好,因为你没有好的特征,那么你可能需要的是数据探索。首先什么是探索性数据分析(Exploratory Data Analysis,EDA)?实际上,这是一系列的方法,它的目的就是让你最大化对数据的直觉,为了让你对数据有感觉,你不仅需要
探索性数据分析介绍当有人扔给你一份数据时,你对这份数据完全陌生,又没有足够的业务背景,会不会感觉无从下手。如果你什么都不管,直接把数据喂给各种模型,却发现效果不好,因为你没有好的特征,那么你可能需要的是数据探索。首先什么是探索性数据分析(Exploratory Data Analysis,EDA)?实际上,这是一系列的方法,它的目的就是让你最大化对数据的直觉,为了让你对数据有感觉,你不仅需要
文章目录Causal RL的基本settingCRL-TASK 1 GENERALIZED POLICY LEARNING (GPL)CRL-TASK 2. WHEN AND WHERE TO INTERVENE?CRL-TASK 3. COUNTERFACTUAL DECISION-MAKING参考资料本文内容是ICML 2020Causal Reinforcement Learning tut
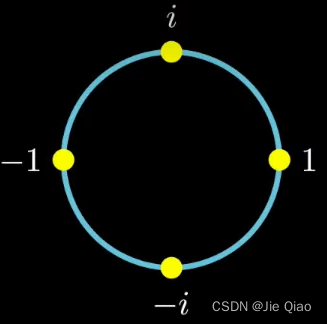
FFT是一个非常快速的离散傅里叶变换算法,他的算法复杂度是O(nlogn)\displaystyle O( n\log n)O(nlogn)。在讲解FFT之前,我们先介绍普通的离散傅里叶变换的的输入和输出是什么?以及一个离散傅里叶变换的简单应用。离散傅里叶变换的输入是一个数组,比如[5,3,2,1],输出是对应的复数,[11,3-2i,3,3+2i],可以自己试试:这个5,3,2,1可以看做是一
介绍本文主要介绍Trust Region Policy Optimization这篇文章,这篇文章主要回答了如下2个问题:两个不同策略的value function,他们的差异是多少?有什么办法可以保证,一个策略相比于另外一个策略一定能够提升呢?针对这两个问题,我们先定义一些基本的概念,基本定义下图是一个较为一般的强化学习MDP框架下的概率图模型注意,这个图并不一定通用,特别是reward(比如s
基本概念Agent : 是程序里面的决策者,他们需要根据环境交互来做出决策.Environment :agent会在里面交互.State : 环境中的状态,比如agent的位置,时间等等。不同的action会有不同的reward.环境有些是可观测的(比如reward),有些是不可观测的。强化学习的任务就是优化累计reward。state value function强化学习最重要的就是
介绍本文主要介绍Trust Region Policy Optimization这篇文章,这篇文章主要回答了如下2个问题:两个不同策略的value function,他们的差异是多少?有什么办法可以保证,一个策略相比于另外一个策略一定能够提升呢?针对这两个问题,我们先定义一些基本的概念,基本定义下图是一个较为一般的强化学习MDP框架下的概率图模型注意,这个图并不一定通用,特别是reward(比如s
Markov inequality若Y是非负随机变量,对于所有y>0\displaystyle y >0y>0,都有Pr{Y≥y}≤E[Y]y\mathrm{Pr}\{Y\geq y\} \leq \frac{\operatorname{E}[ Y]}{y}Pr{Y≥y}≤yE[Y]如上图,yPr{Y≥y}\displaystyle y\mathrm{Pr}\{Y\geq y