


- @Qiled


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
基于python的今日头条文章抓取内含signature算法扫二维码添加微信 备注:爬虫 , 拉你进爬虫交流群 或许你会成为第一个加群的人~ 刚有的创群想法!1. 简单文字描述头条爬虫注意点由于还没有大批量爬取测试,这里只能作为参考!例如我们现在需要爬取右边的头条链接 https://www.toutiao.com/a6920021307803468302/我们用python编写代码会发现,返回的
Android抓包 - Okhttp混淆导致Hook工具失效本文部分内容参考 loco 大佬的文章,同时借用loco大佬文章中的2个APP(有无混淆)。微信公众号: yeshengit这篇文章的主要目的是介绍使用Frida来处理APP没使用Android自带的HTTP客户端进行请求,且对HTTP客户端进行了混淆,导致JustTrustMe失效的问题。首先,我们先看下该样例应用的源码,...
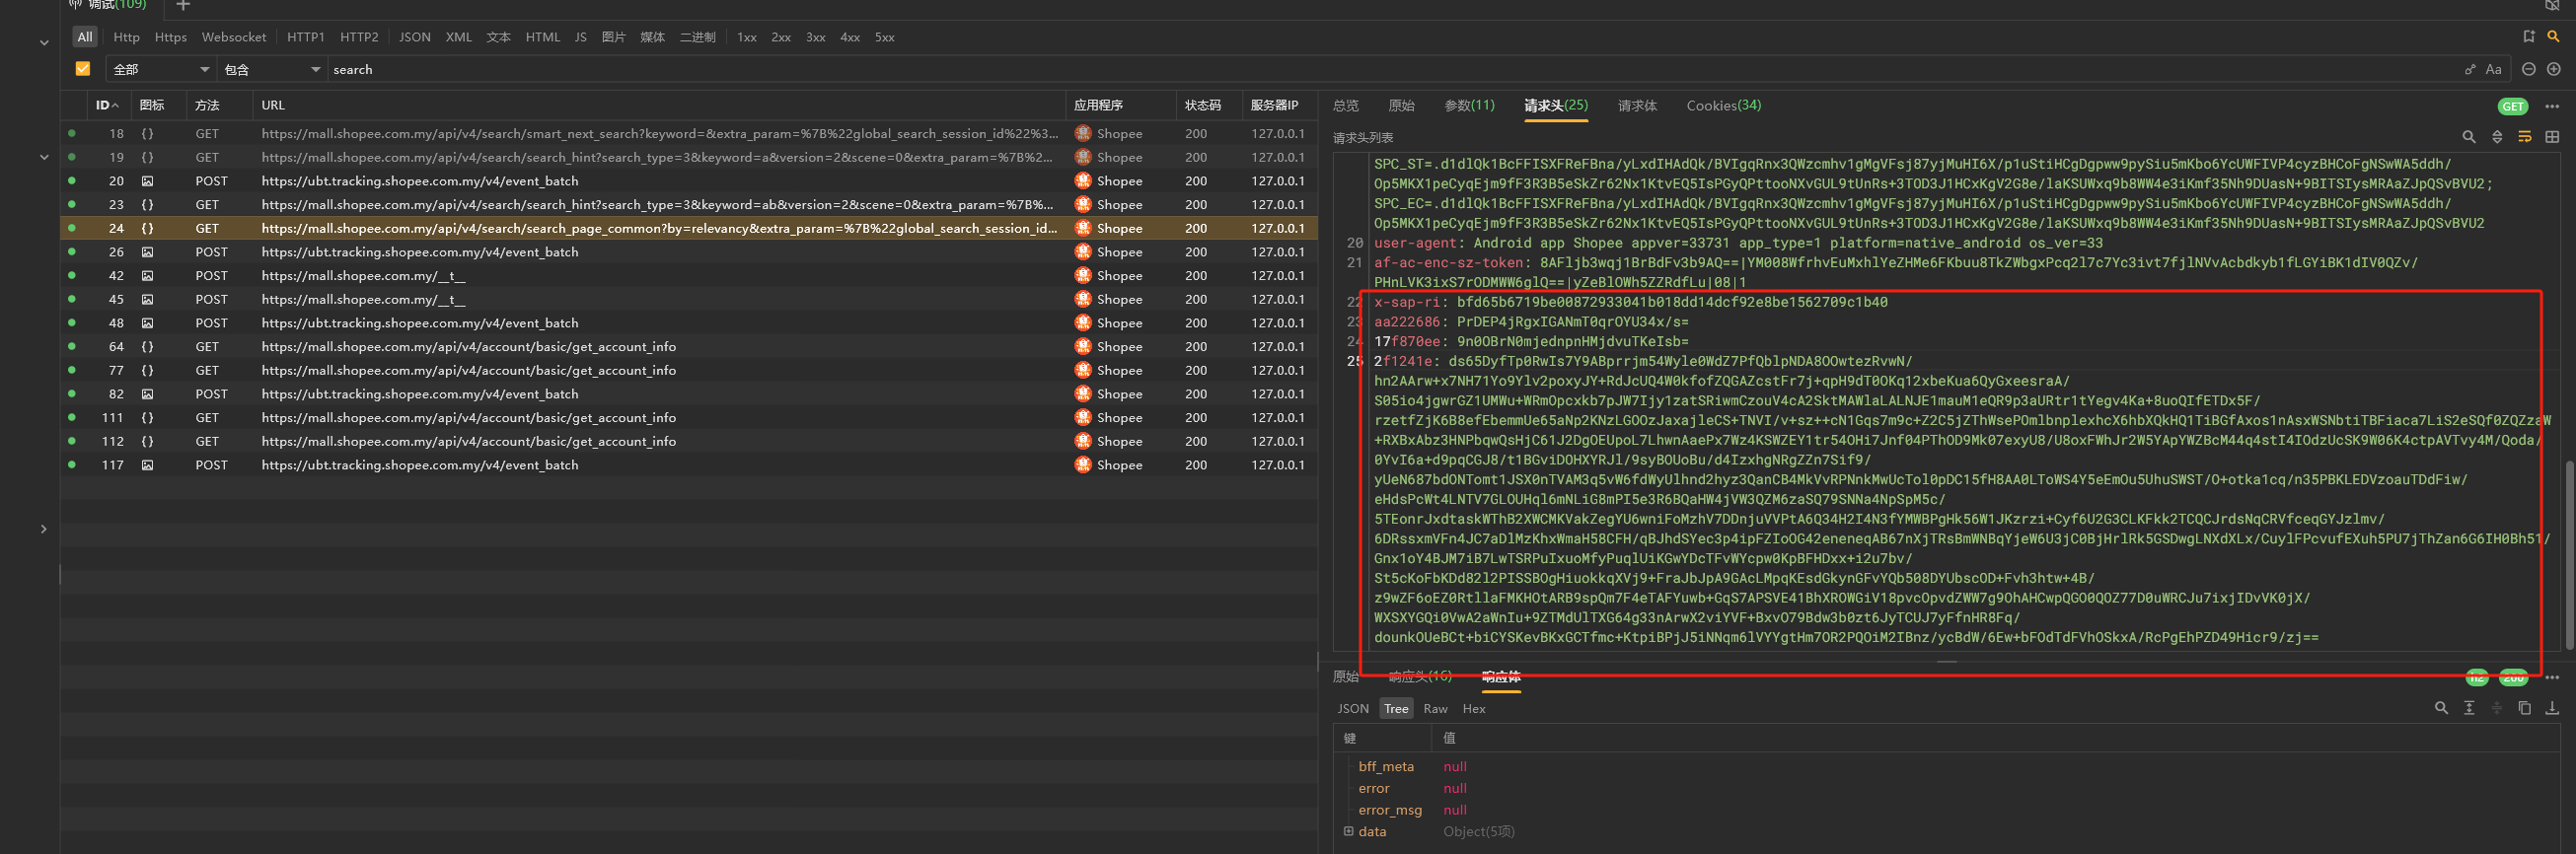
shopee的环境补起来相对容易, 唯一的难点在于 “异常的处理”, 当然, 这只是对于我来说的难点. 对于各位大佬来说, 这种应该是信手拈来的东西.接下来, 继续复现如画大佬的算法分析文章.
💡分析trace, 我们应该以结果为导向. 只关注于我们需要的数据. 一些其他无用的运算我们应该选择性跳过. 一行行分析下去十分的疲惫.Unidbg运行一遍,搜索运行下这个Key, 我们在下面的堆栈中, 可以看到memcpy的调用地址为。在Unidbg文章中, 我们尝试过多次主动调用, 文中可以发现, 只有。因为可以猜测到循环, 并且, 我们目前需要知道,这个未知的字节是什么?我们只需要,这个框

首发地址:http://zhuoyue360.com/crack/104.html。

最近拼多多的anti_content算法更新了. 闲着无聊就看了看.总思路如下:首先我们抓包, 看到我们今天的目标. anti_content.现在,我们通过堆栈入口随便下个断点.然后我们在CallStack中向下寻找.,经过漫长的寻找. 我们可以在图中所示的地方找到关键点.然后我们在a变成anti_content的前一次循环进入.也就是a = {}的时候进入.然后一路F11, ...
#今日头条Web端爬虫as,cp值破解请各位转载的朋友请注明出处.作者:小胖实验网址:https://www.toutiao.com/ch/news_tech/实验环境:Windows10实验工具:Chrome,Fiddler(该抓包观察比较方便,当时抓取HTTPS的网页需要设置证书,具体请百度品尝,很多教程)0x1:分析A:打开头条官网抓包.发现其是一个ajax的页面.然后抓包...
很多初学者包括我在首次安装numpy的时候会遇到这个问题!You are using pip version 9.0.1, however version 10.0.0 is available.You should consider upgrading via the 'python -m pip install --upgrade pip' command.参考了一些博客后,得知总结方案:运行
Frida逆向与自动化:Frida开发和调试环境搭建安卓逆向交流QQ群: 348355266文章目录1. objection与frida版本匹配安装1. 一般情况下的安装2. 指定版本安装2. objection 连接非标准端口1. Frida指定端口启动2. objection 指定端口连接3. 简单体验3. objection 内存漫游、hook、trace1. 内存漫游4. objectio
腾讯vData_VMP分析个人博客:http://www.zhuoyue360.com/1. 环境搭建不太好拿实际的网站来做实战,所以使用Wampserver64 + html来搭建测试站, 需要本地html文件的可以联系QQ 2625112940. 验证码识别,图像识别,安卓逆向相关的朋友也可以联系我.2. 分析vData使用了JS-VMP的技术哈.至于JSVMP是啥?请参考下面这篇文章给"某音
