- @HuiMinHuang2001


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文以 llama.cpp 为工具,系统梳理端侧运行大模型的内存账本:权重、键值缓存(KV Cache)、运行时缓冲与框架开销。强调 KV Cache 随上下文线性增长,是长对话瓶颈的关键;量化虽省内存但影响质量,需实测验证。通过 llama-bench 实现可复现基准测试,提出“先算账、后实测”的工程方法,帮助判断模型容量可行性,避免因忽略缓存与碎片导致的 OOM 问题。

本地化语音链路中,TTS仍依赖云端会导致断网即哑、数据外泄。kokoro-onnx以约80MB量化模型实现轻量本地合成,支持多语言多音色,通过文本前端、时长预测、声码器三段打点定位延迟瓶颈。虽精度受量化影响,但其MIT/Apache双许可与清晰版本管理,适合需闭环部署的场景。关键在验证文件完整性、匹配音色表,并用实测耗时替代体感判断优化方向。
本文对比端侧ASR两大工程路线:whisper.cpp(ggml自研)与sherpa-onnx(ONNX Runtime+硬件EP),聚焦可复用的选型方法。以whisper.cpp为例,剖析其自包含特性、量化必要性及实测关键——需控制变量,对比同设备、同音频下的延迟、内存、准确率三维度数据。强调量化虽降体积但损质量,必须实测CER;指出whisper.cpp当前不支持高通QNN,NPU加速需谨慎验
本文将语音助手链路从“设备+服务器”迁移至单板本地化,聚焦VAD、ASR、TTS三环的端侧部署。选用sherpa-onnx框架统一实现多任务(含关键词唤醒、说话人分离等),支持12种语言及五大NPU加速(含Qualcomm QNN),通过逐环验证与有界队列串联,确保链路稳定。基于同一模型族对比原云端方案,保障实验可比性,并明确标注小语种识别、音色自然度与NPU回退路径等边界条件,实现全链路本地化闭
将大模型从云端迁移至端侧,本质是延迟结构的重构:网络往返被消除,但本地算力压力显著放大。首 token 延迟与生成吞吐需分开评估,优化顺序应为模型尺寸→上下文长度→量化与系统参数。实测表明,“端侧更快”并非必然,需结合硬件、模型规模与网络环境综合验证。语音链路中句级流式会放大单次延迟差异,必须以“一轮对话”为单位测试。数据采集须避免缓存、温度漂移等干扰,保留原始日志以保障可复现性。最终决策应基于真
“模型加载失败”是多种病因的统称,本质需按路径、完整性、版本、格式、权限、内存顺序排查,避免盲目试错。最快方法是使用已知可用的小模型进行替换法分诊,快速定位问题域。注意“能加载”不等于“能用”,输出异常多由版本或模板不匹配导致。预防关键:路径用绝对路径、下载后校验哈希、版本组合明确定义。
本地大模型服务的“OpenAI 兼容”仅保证核心请求响应结构一致,深层语义与行为差异易被忽略。需分层验证:传输、字段、语义、行为层,尤其警惕“静默忽略”——参数有效但无实际作用。建议先用 model+messages 跑通,逐项测试参数并建立兼容度矩阵。端侧与云端在并发、上下文上限及字段处理上存在差异,务必实测验证,避免上线后暴露隐患。
本文介绍将小智(xiaozhi-esp32)系统中的LLM层从云端迁移至本地端侧的改造实践。基于端侧大模型服务的OpenAI兼容接口,仅需修改配置即可实现“设备+服务端”向“单板全栈”的转变,显著提升离线可用性与数据隐私性。改造聚焦于低门槛、高见效的LLM层,避免动辄复杂的ASR/TTS链路,同时明确边界:端侧0.5B模型能力弱于云端,但换来部署简化、断网可用与数据不出设备的核心优势。通过建立基线
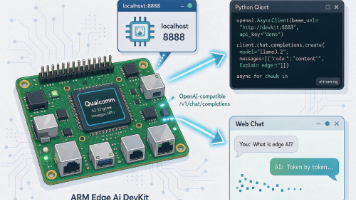
本文介绍将小智(xiaozhi-esp32)系统中的LLM层从云端迁移至本地端侧的改造实践。基于端侧大模型服务的OpenAI兼容接口,仅需修改配置即可实现“设备+服务端”向“单板全栈”的转变,显著提升离线可用性与数据隐私性。改造聚焦于低门槛、高见效的LLM层,避免动辄复杂的ASR/TTS链路,同时明确边界:端侧0.5B模型能力弱于云端,但换来部署简化、断网可用与数据不出设备的核心优势。通过建立基线
本文聚焦端侧大模型落地挑战与实践路径,解析将大语言模型(LLM)部署于边缘设备的机遇与三大约束:算力、内存与功耗。基于AidLite底座构建的AidGen推理框架,实现生成式模型在CPU/GPU/NPU上的高效调度,支持多轮对话与本地化推理。以犀牛派X1为平台,推荐从0.5B小模型起步,通过Model Farm获取适配模型,结合aidgen_chat_template.txt规范对话格式,实现在隐