- @BumbleBee16


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
LLM Wiki 的真正价值,不在于单次回答的智能程度,而在于它试图将 LLM 从一个"每次都重来的回答器"升级为一个"越用越值钱的知识运行时"。LLM = 编译器聊天 = 入口Wiki = 产品Graph = 导航Schema = 操作系统Review = 刹车Log = 审计轨迹但它并非没有争议。幻觉回写、治理成本、部分更新等问题决定了它目前的定位是"小规模深度知识工程工具",而非万能的替代品
许多看似需要"更聪明模型"的问题,实际上只是接口问题——把任务所需的数据纳入上下文,或把完成任务所需的操作封装成工具,原本不可解的任务就可能变得可解。以 Manus 和 OpenClaw 为例,两者的演进本质上都是观察空间和动作空间的扩展。Manus 把深度调研、代码生成和电脑操控三条原本独立的路线合并到同一个 Agent 中;OpenClaw 则通过 WhatsApp、Telegram 等消息渠
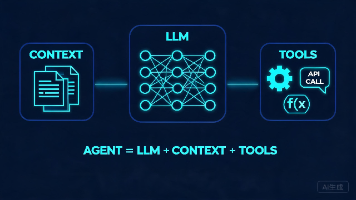
许多看似需要"更聪明模型"的问题,实际上只是接口问题——把任务所需的数据纳入上下文,或把完成任务所需的操作封装成工具,原本不可解的任务就可能变得可解。以 Manus 和 OpenClaw 为例,两者的演进本质上都是观察空间和动作空间的扩展。Manus 把深度调研、代码生成和电脑操控三条原本独立的路线合并到同一个 Agent 中;OpenClaw 则通过 WhatsApp、Telegram 等消息渠
本质:Agent = LLM + 上下文 + 工具,是把思考、现场、执行连成闭环的持续运行系统;引擎:ReAct(思考—行动—观察)循环驱动任务状态不断朝完成推进;关键:上下文工程决定决策质量,"看见什么"比"模型多大"更重要;工程化:靠 Harness 支撑框架做校验、容错、验证,遵循简单、透明、工具优先原则;选型:工作流与自主智能体无高下之分,按路径是否可预知选择,优先最小架构;安全:贯穿输入
在构建复杂的AI Agent系统时,我们常常面临一个架构抉择:是打造一个"全能"的单体Agent,通过集成多种工具调用(Tool Calling)来处理一切任务,还是将其拆分为多个职责单一的"子Agent",通过协同合作来完成目标?这个问题不仅是面试中的"灵魂拷问",更是决定系统能否在生产环境中稳定、高效、可扩展的关键。本文将深入剖析单体Agent与多Agent架构的本质区别,探讨何时必须"拆分"
AI Agent(智能体)通常被描述为“感知—规划—行动”的循环:接收用户输入或环境事件,调用大模型推理,再借助工具(检索、数据库、HTTP 接口、代码执行等)完成任务。一个看似简单的对话请求,背后可能串联多次 LLM 调用、知识库查询、工具调用和结果汇总,端到端耗时从几百毫秒到几十分钟不等。,让各环节按自身节奏消费、重试和扩展。Kafka 是可选方案之一,而非天然唯一解;下文会专门讨论它的适用前
AI Agent(智能体)通常被描述为“感知—规划—行动”的循环:接收用户输入或环境事件,调用大模型推理,再借助工具(检索、数据库、HTTP 接口、代码执行等)完成任务。一个看似简单的对话请求,背后可能串联多次 LLM 调用、知识库查询、工具调用和结果汇总,端到端耗时从几百毫秒到几十分钟不等。,让各环节按自身节奏消费、重试和扩展。Kafka 是可选方案之一,而非天然唯一解;下文会专门讨论它的适用前
把操作系统的内存管理思想引入大模型 Agent 记忆系统,是一次非常有价值的架构迁移。解决上下文窗口有限的问题。降低无关信息污染。大幅减少事实性幻觉。提供权限控制和信任边界。消除推理逻辑错误。解决数据本身冲突。让模型在数据库没有答案时凭空创造正确知识。所以,这套架构的真正意义不是让模型"更聪明",而是让模型"更诚实"。它让 Agent 知道:自己知道什么,自己不知道什么,以及应该去哪里找答案。
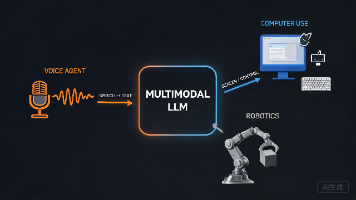
前几章构建的 Agent 与世界的交互是轮流的:用户说完一句,Agent 想一段、调用几个工具,再回一句;在它思考的这段时间里,世界被默认为静止的。这个前提如此自然,以至于很少被当成一个假设写出来。然而真实环境不会等模型作出反应:邮件在思考时到达,用户在说话途中插话,页面在两次截图之间已经变了样。本文围绕模态和触发时机两个维度,对 Agent 交互架构的扩展进行技术分析,涵盖异步事件驱动、语音交互
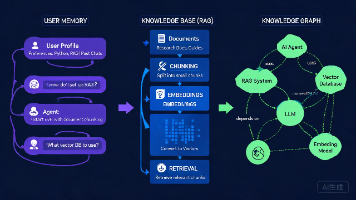
本文基于开源技术书《深入理解 AI Agent》第三章,系统梳理 Agent 跨会话的持久化知识体系。该章将上下文管理从单次会话扩展到跨会话场景,涵盖用户记忆系统的四种存储格式、RAG 完整技术栈、结构化索引方法、智能体化 RAG,以及知识更新的安全机制。两个尺度——面向个人的用户记忆和面向群体的共享知识库——共用许多底层技术,也面临同样的工程挑战。