


- @2601_96136364


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
不是,或者说,那只是最低级的形式。真正的 AI 辅助阅读应该做的是「嵌在阅读流里的精读辅助」——打开论文就能抓重点、逐段对照翻译、划词解释、笔记附着原文、跨文献对比。「贴给 ChatGPT 总结」能解决「快速知道这篇讲了啥」,但解决不了「精读时持续提效」——因为每看一段都要搬运内容,阅读流被打断。判断标准就是前面说的三点:能不能溯源原文、翻译在不在阅读流里、能不能跨文献。
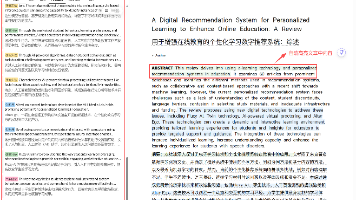
不是,或者说,那只是最低级的形式。真正的 AI 辅助阅读应该做的是「嵌在阅读流里的精读辅助」——打开论文就能抓重点、逐段对照翻译、划词解释、笔记附着原文、跨文献对比。「贴给 ChatGPT 总结」能解决「快速知道这篇讲了啥」,但解决不了「精读时持续提效」——因为每看一段都要搬运内容,阅读流被打断。判断标准就是前面说的三点:能不能溯源原文、翻译在不在阅读流里、能不能跨文献。
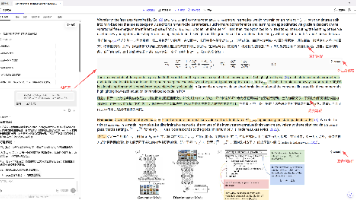
读英文论文的效率瓶颈,往往不在语言,而在交互。复制粘贴、切换窗口、反复选中——这些操作本身不难,但它们在持续消耗你的注意力。段落对照翻译之所以体验最好,不是因为它翻译得更准,而是因为它让你的视线不再跳跃、让你的节奏不再断裂。一般来说,Scholaread 免费版对轻度使用是够用的——每日有免费 AI 翻译额度,读几篇论文基本能覆盖。如果你文献量更大、需要高频使用,再考虑付费版。工具会越来越多,但知
聊天机器人的产出是一段话。读完就完了,你没法直接用于科研——写综述要用表格、整理文献要用分类、组会汇报要用提纲,一段话总结帮不上这些。真正的 AI Agent 能产出结构化成果:把文献整理成表格、把对比结果生成分类、把调研内容整理成可检索的笔记。“结构化产出"和"一段话总结”,是第三道分水岭。聊天机器人负责"说",Agent 负责"做"。判断你手里的是不是真 Agent,就看你让它"做一件事"时,

聊天机器人的产出是一段话。读完就完了,你没法直接用于科研——写综述要用表格、整理文献要用分类、组会汇报要用提纲,一段话总结帮不上这些。真正的 AI Agent 能产出结构化成果:把文献整理成表格、把对比结果生成分类、把调研内容整理成可检索的笔记。“结构化产出"和"一段话总结”,是第三道分水岭。聊天机器人负责"说",Agent 负责"做"。判断你手里的是不是真 Agent,就看你让它"做一件事"时,
聊天机器人的产出是一段话。读完就完了,你没法直接用于科研——写综述要用表格、整理文献要用分类、组会汇报要用提纲,一段话总结帮不上这些。真正的 AI Agent 能产出结构化成果:把文献整理成表格、把对比结果生成分类、把调研内容整理成可检索的笔记。“结构化产出"和"一段话总结”,是第三道分水岭。聊天机器人负责"说",Agent 负责"做"。判断你手里的是不是真 Agent,就看你让它"做一件事"时,
聊天机器人的产出是一段话。读完就完了,你没法直接用于科研——写综述要用表格、整理文献要用分类、组会汇报要用提纲,一段话总结帮不上这些。真正的 AI Agent 能产出结构化成果:把文献整理成表格、把对比结果生成分类、把调研内容整理成可检索的笔记。“结构化产出"和"一段话总结”,是第三道分水岭。聊天机器人负责"说",Agent 负责"做"。判断你手里的是不是真 Agent,就看你让它"做一件事"时,
聊天机器人的产出是一段话。读完就完了,你没法直接用于科研——写综述要用表格、整理文献要用分类、组会汇报要用提纲,一段话总结帮不上这些。真正的 AI Agent 能产出结构化成果:把文献整理成表格、把对比结果生成分类、把调研内容整理成可检索的笔记。“结构化产出"和"一段话总结”,是第三道分水岭。聊天机器人负责"说",Agent 负责"做"。判断你手里的是不是真 Agent,就看你让它"做一件事"时,
聊天机器人的产出是一段话。读完就完了,你没法直接用于科研——写综述要用表格、整理文献要用分类、组会汇报要用提纲,一段话总结帮不上这些。真正的 AI Agent 能产出结构化成果:把文献整理成表格、把对比结果生成分类、把调研内容整理成可检索的笔记。“结构化产出"和"一段话总结”,是第三道分水岭。聊天机器人负责"说",Agent 负责"做"。判断你手里的是不是真 Agent,就看你让它"做一件事"时,
追踪一篇核心论文的引用链,难的从来不是"找到谁引用了它"——Google Scholar 点一下就能看到 800 条的列表。难的是从 800 条里筛出 10 条真正值得精读的,并且理清它们之间的改进关系。Google Scholar 给你的是引用列表。Connected Papers 给你的是引文图谱。Scholaread 的 AI Agent 给你的是——每篇引用的骨架、8 篇核心改进论文的交叉
