- @2501_93573368


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
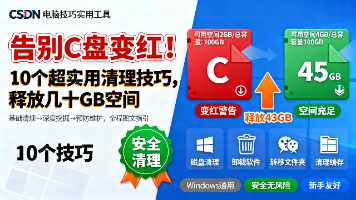
10个实用技巧帮你轻松清理C盘空间。基础清理包括:使用系统自带的磁盘清理工具、清空回收站、清理浏览器缓存。深度清理建议:卸载不常用大体积软件、清理系统更新缓存、转移默认文件夹到其他盘。预防措施包括:改变软件安装路径、定期清理下载文件夹。注意事项提醒避免误删系统核心文件。按此流程操作可释放10-50GB空间,让电脑重获流畅体验。
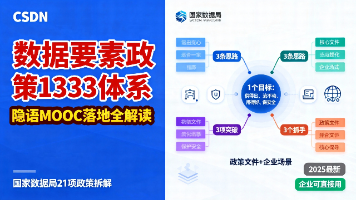
本文是隐语MOOC三期相关课程的干货笔记,聚焦国家数据要素政策“1333体系”展开全解读。文章先剖析了我国数据要素多年来“供不出、流不动、用不好”的核心症结,即“立法严、执法松”的体制性障碍与“没激励、缺约束、无容错”的机制性梗阻;随后详细拆解“1333体系”的核心逻辑——以“供得出、流得动、用得好、保安全”为1个目标,通过“统筹发展与安全、激发供给动力、释放流通活力”3条思路破解核心矛盾,以“授
本文详细介绍了如何在华为云ModelArts上快速适配部署Llama 3开源大模型的全流程。针对常见适配误区,文章指出关键在于对齐模型、代码和云环境三者的版本与配置。通过10分钟实操演示,包括创建DevContainer环境、拉取代码、调整依赖版本和修改适配脚本等核心步骤,并提供了本地与云环境(CPU/NPU)的性能实测对比。结果显示,按本文方法适配成功率达100%,且NPU环境下推理速度可达本地

本文介绍了Flutter for OpenHarmony中卡片式UI的设计与应用。卡片作为现代移动应用的基础UI模式,具有视觉隔离、层次分明、操作明确等优势。文章详细讲解了Flutter的Card组件特性,包括开箱即用的圆角阴影设计、高度自定义能力以及跨平台一致性。通过代码示例展示了从基础卡片构建到添加交互功能的完整实现过程,包括商品卡片、联系人卡片等多种布局模式。特别强调了在OpenHarmon
摘要:RoPE(旋转位置编码)解决了Transformer模型在长文本推理中的位置编码问题。相比传统绝对位置编码,RoPE通过旋转角度编码相对位置,具有更好的外推性和自然语言处理优势。在昇腾NPU上,ops-transformer采用逐元素操作而非矩阵乘法实现RoPE,利用Vector单元提升计算效率,并通过L1缓存和图编译优化减少数据搬运开销。这种数学设计与硬件优化的结合,使模型能在4K训练后直
摘要:大模型推理变慢的主要原因是Attention计算存在O(n²)复杂度问题,尤其长序列场景下显存带宽成为瓶颈。昇腾NPU通过CANNops-transformer中的FlashAttention优化方案,采用分块计算和在线softmax技术,将显存读写量从O(n²)降至O(n)。结合昇腾的达芬奇架构特性(大缓存、Cube单元等)和CANN软件栈的自动优化能力,实现了128K长序列推理延迟降低5
摘要:torchtitan-npu是CANN社区维护的昇腾NPU大模型训练参考实现,基于PyTorch+HCCL提供LLaMA等Transformer模型的分布式训练方案。它支持数据并行、张量并行和流水线并行的组合策略,通过HCCL实现高效通信优化。在8卡Ascend 910上,LLaMA-13B训练采用TP=8策略可降低单卡显存至9.5GB,组合并行策略最高吞吐达22,500 tokens/s。
摘要:NVIDIA Triton Inference Server 是一个开源的推理服务框架,提供请求排队、模型管理和多硬件调度功能。针对昇腾NPU场景,CANN社区开发的GE Backend使Triton能够通过AscendCL接口管理昇腾硬件上的推理任务。该方案支持多模型并发、动态加载和性能监控,在LLaMA-7B模型测试中仅引入4-7ms额外延迟,同时保留了Triton的运维优势。部署流程包
MindIE是昇腾NPU上的大模型推理服务框架,通过Continuous Batching实现高效并发处理:动态重组Batch,让短Token请求无需等待长Token请求完成。采用Block级KV Cache管理避免内存碎片,将Cache切分为固定大小Block按需分配。针对长Prompt优化提出Prefill Chunking技术,分段处理避免阻塞其他请求。同时解决了KV Cache耗尽(通过S
本文介绍了基于昇腾CANN和NPU的pyACL Python推理技术。pyACL是AscendCL的Python封装,通过import acl即可在NPU上加载OM模型并完成推理部署,支持NumPy数据自动转换为NPU Tensor,无需编写C++代码。文章详细展示了pyACL推理流程,包括初始化、模型加载、数据准备、异步推理和结果获取等步骤,并对比了pyACL与C++ ACLNN的差异。同时指出