

写文章


- @2401_88933643


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
0基础Python爬虫教程第二篇:抓取300+深圳二手车网站信息
本次教程,再次运用requests和库,实现了对汽车之家深圳二手车信息的爬取,并将300+数据保存到 Excel 文件中。同时,本次也增加说明了一些在爬虫过程中应对网站阻拦的常用方法,如设置合理请求头、随机延迟以及动态更换User-Agent等。这仅仅是我们爬虫之旅的一个小小开端,在未来的探索中,你可以根据实际需求,对这个爬虫程序进行灵活的修改与扩展,使其能够应对更加复杂多变的爬取任务。

0基础爬虫教程:获取网文榜单top200小说信息&制作数据可视图
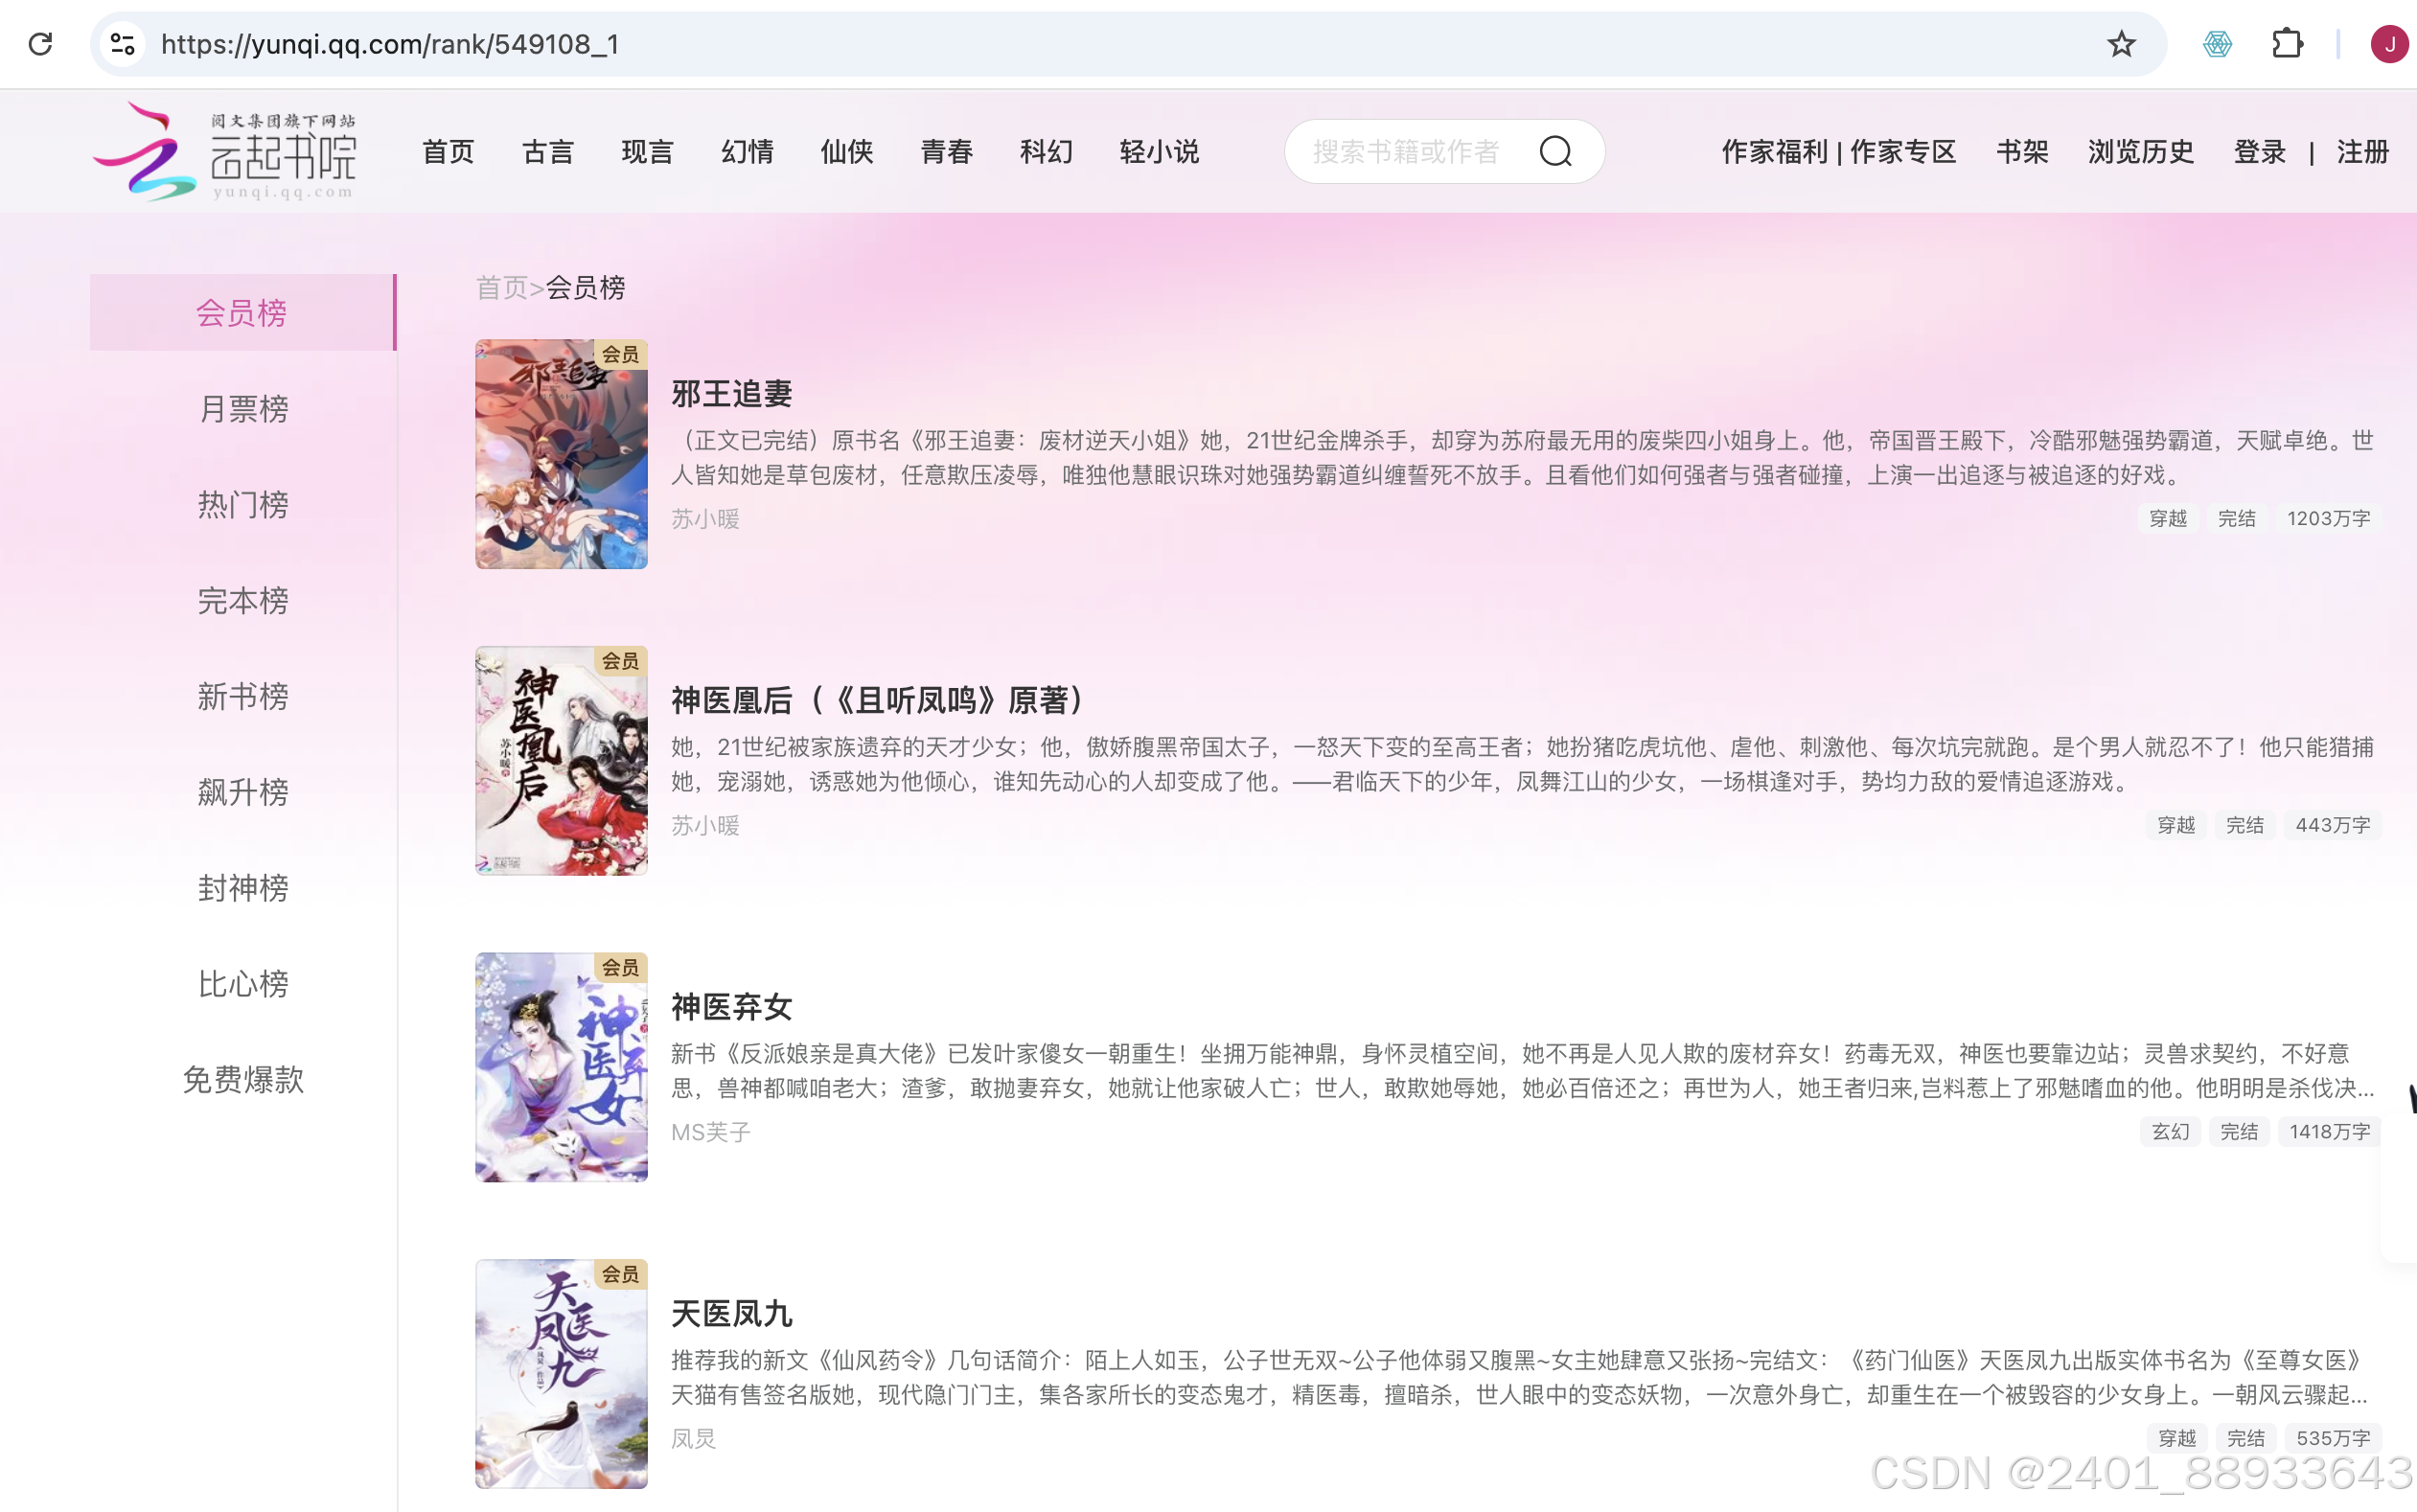
本教程将教你如何使用Python语言,结合强大的requests库和BeautifulSoup库,爬取网文网站:云起书院,会员榜单上200+本热门小说的网页信息、解析网页提取想要的数据(例如:书名、作者、简介、类型、是否完结、字数、详情页链接等),并使用Pyecharts库对获取的数据进行可视化分析,了解会员榜单上最受欢迎的小说种类。
到底了