


- @2301_81230251


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
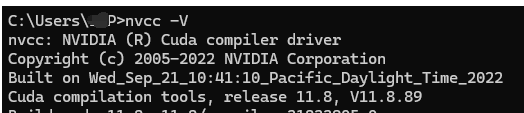
安装pytorch前需安装cuda。通过“nvidia - smi”命令查看显卡支持的CUDA最高版本,若版本不足需更新显卡驱动。在NVIDIA Developer官网或提供的网盘链接下载匹配版本的cuda,安装时建议选默认路径,安装过程中选择自定义安装并全选组件。安装完成后用“nvcc - V”命令检查是否安装成功。之后,进入cudnn官网,下载与cuda版本匹配的cudnn Windows版本
在机器学习中,损失函数(Loss Function)是一个衡量模型预测值与真实值之间差异的函数。它的主要作用是为模型提供一个优化的方向,通过最小化损失函数的值,使模型能够更好地拟合训练数据,从而提高模型的性能。损失函数是机器学习中的一个重要概念,它直接影响模型的训练效果和性能。根据不同的任务类型和数据特性,选择合适的损失函数,并结合有效的优化算法,可以更好地训练出性能优良的模型。在实际应用中,还需

偏置参数,调整状态的初始值;通过这些改进,Mamba 能够根据输入内容,比如文本中的关键词、语音中的重音,来动态调整状态更新的 “敏感度”:对于重要的信息,会增强记忆,让记忆衰减得慢一些;之前,Transformer 凭借强大的注意力机制成为序列建模的主流架构,但它有两个明显的缺点:一是注意力机制的计算复杂度会随着序列长度的平方增长,在长序列任务中效率很低;标准的状态空间模型中,那些关键矩阵参数是
随机森林作为一种强大的集成学习算法,在机器学习领域有着广泛的应用。它通过构建多棵决策树并综合其预测结果,有效地提高了模型的准确性和稳定性。在实际应用中,我们可以根据具体问题的特点和需求,合理调整随机森林的参数,以获得更好的模型性能。未来,随着数据量的不断增大和计算能力的提升,随机森林有望在更多领域发挥更大的作用。
CNN 在图像处理领域展现了强大的性能,但其应用也存在一些局限,如对数据量要求较高、模型结构复杂导致计算资源消耗大等。未来,随着硬件技术的不断发展和新算法的提出,如更高效的网络架构搜索方法、更精准的特征提取技术等,CNN 将在更多领域发挥更大的作用,为人工智能的发展提供更有力的支持。同时,研究人员也在探索如何将 CNN 与其他技术(如生成对抗网络、Transformer 等)相结合,以进一步提升模
在机器学习中,损失函数(Loss Function)是一个衡量模型预测值与真实值之间差异的函数。它的主要作用是为模型提供一个优化的方向,通过最小化损失函数的值,使模型能够更好地拟合训练数据,从而提高模型的性能。损失函数是机器学习中的一个重要概念,它直接影响模型的训练效果和性能。根据不同的任务类型和数据特性,选择合适的损失函数,并结合有效的优化算法,可以更好地训练出性能优良的模型。在实际应用中,还需
CNN 在图像处理领域展现了强大的性能,但其应用也存在一些局限,如对数据量要求较高、模型结构复杂导致计算资源消耗大等。未来,随着硬件技术的不断发展和新算法的提出,如更高效的网络架构搜索方法、更精准的特征提取技术等,CNN 将在更多领域发挥更大的作用,为人工智能的发展提供更有力的支持。同时,研究人员也在探索如何将 CNN 与其他技术(如生成对抗网络、Transformer 等)相结合,以进一步提升模
选择依据如果数据的量纲不同,且数值范围差异较大,可以选择归一化。如果数据服从正态分布或近似正态分布,且模型对数据分布有特定要求,可以选择标准化。对于基于距离的模型,如KNN、K-Means等,归一化通常更合适;对于基于梯度下降的优化算法,如线性回归、逻辑回归等,标准化通常更有效。注意事项在进行归一化或标准化时,需要保存归一化或标准化的参数(如最小值、最大值、均值、标准差等),以便在对新数据进行预处
KNN算法是一种简单而有效的机器学习算法,适用于分类和回归任务。它基于数据点之间的距离进行预测,具有简单易实现、对数据适应性强等优点,但也存在计算效率低、存储要求高等缺点。在实际应用中,需要根据数据的特点和任务需求选择合适的K值和距离度量方式,并对数据进行预处理,以提高算法的性能。
下采样是指从多数类中随机移除一部分样本,使得多数类和少数类的样本数量达到平衡或接近平衡的状态。上采样是指通过某种方式增加少数类的样本数量,使其与多数类的样本数量达到平衡或接近平衡。上采样和下采样是解决类别不平衡问题的两种重要方法。它们各有优缺点,在实际应用中需要根据数据集的特点和模型的需求进行选择。在实际操作中,也可以尝试结合使用这两种方法,以达到更好的效果。