登录社区云,与社区用户共同成长
邀请您加入社区
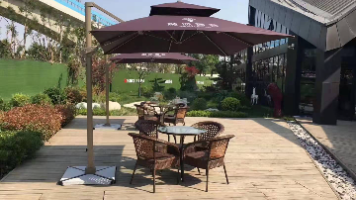
在成都,无论是餐饮外摆、庭院休闲还是露营基地,一把耐用又好看的遮阳伞是刚需。但很多人逛了一圈市场后发现:要么是广东发货的通货,质量看运气;要么是本地小作坊,款式老旧。最近不少商家开始把目光投向成都本地的源头厂家,原因很简单——没有中间商,价格实在,品质还能看得见摸得着。
PolarDB-X 采用 Shared-nothing 与存储分离计算架构进行设计,系统由5个核心组件组成。
本文介绍了 SLS 基本能力,并和开源自建 ELK 做了对比,可以看到 SLS 相比开源 ELK 有较大优势。
当管理多个Prometheus实例时,阿里云Prometheus托管版相比社区版提供了更可靠的数据采集和便捷的管理。本文比较了全局聚合实例与数据投递方案,两者在不同场景下各有优劣。
在大数据 ETL 场景,将 Kafka 中的消息流转到其他下游服务是很常见的场景,除了常规的消息流转外,很多场景还需要基于消息体内容做判断,然后决定下游服务做何种操作。
过去十年 AI 领域的显著进步,关键在于训练技术的革新和模型规模的快速攀升。尽管大模型展现了堪比人类的理解力,但其训练却对算力提出了极高的要求。唯有配备充足的计算资源,方能在海量数据上有效训练大模型,确保其在有限时间内实现优质收敛。
随着摩尔定律增长的逐渐减缓,系统规模的水平扩展已经成为提升系统性能的关键策略。然而,这种扩展依赖于分布式系统架构的支持,而分布式编程的固有复杂性给构建高效、可靠及弹性的系统带来了严峻挑战。因此,简化分布式编程依旧是分布式编程框架追求的核心目标。
青团社是国内领先的一站式灵活用工招聘服务企业,灵活用工行业的 Top1。青团社于 2013 年在杭州成立,业务已经覆盖全国,在行业深耕 10 年。我的分享将分为以下三部分:
随着可观测数据采集需求的不断推陈出新,多样化的数据输入输出选项、个性化的数据处理能力组合、以及高性能的数据处理吞吐能力已经成为顶流可观测数据采集器的必备条件。
Stable Diffusion 模型,已经成为 AI 行业从传统深度学习时代走向 AIGC 时代的标志性里程碑。越来越多的开发者借助 stable-diffusion-webui(以下简称 SDWebUI)能力进行 AI 绘画领域创业或者业务上新,获得高流量及商业价值,但是面对多客户、高并发的复杂场景,使用原生 Stable Diffusion API 会面临以下挑战
随着软件技术发展迭代,很多企业软件系统也逐步从单体应用向云原生微服务架构演进,一方面让应用实现高并发、易扩展、开发敏捷度高等效果,但另外一方面也让软件应用链路变得越来越长,依赖的各种外部技术越来越多,一些线上问题排查起来变得困难重重。
本文从浏览器架构演进、插件运行机制、插件基本介绍和一些常见的插件实现思路几个方向聊聊Chrome插件。
日志内容本身是一种重要信息,日志之间的相对顺序也是因果关系的一种反映,某些场景下如果日志内容完全相同,但是日志间的顺序错乱了反映出来的结果可能和真实世界里面的事件完全相反。
在单体的应用开发场景中涉及并发同步时,大家往往采用Synchronized(同步)或同一个JVM内Lock机制来解决多线程间的同步问题。而在分布式集群工作的开发场景中,就需要一种更加高级的锁机制来处理跨机器的进程之间的数据同步问题,这种跨机器的锁就是分布式锁。接下来本文将为大家分享分布式锁的最佳实践。
本篇文章通过几个技术点说明日志记录过程中的性能实践,计算机领域的性能往往都遵循着冰山法则,即你能看得见的、程序员能感知的只是其中的一小部分,还有大量的细节隐藏在冰山之下。
仅以此文,分享给那些初入职场仍在“学习与工作”之间徘徊不定的同学,或者是像作者一样已经工作一段时间却陷入迷茫的同学,希望有助于能让诸位重新迈开已经停下的脚步。
《两全其美:Sidecarless 与 Sidecar 模式融合的服务网格新形态》主题演讲中展示了一个基于服务网格 ASM 各项能力构建的 DEMO AI 应用。该应用集中展示了 ASM 在模型服务、请求处理、请求路由和安全中心集成单点登录等各项能力,且这些能力还完全是以 Sidecarless 的形态来实现的。
在日常的开发中,作者总结了平常用到的一些低成本、保持扩展性的套路,分享出来,欢迎大家讨论。
本文将围绕 MySQL 以及 PolarDB-X 的数据离线导入导出场景来展开。首先,通过实验进行了生态工具 BatchTool 与传统 mysqldump 的性能对比,然后结合具体的实践场景来介绍 BatchTool 不同参数的使用方式。
随着技术的不断更新迭代,一些曾经被认为是“标准答案”的观点和方法,已经不再适应当前的需求,甚至被视为过时的做法。在新的JDK版本中,许多新的特性、工具和方法被引入,使得Java编程变得更加简洁、高效和强大。所以,是时候对“八股文”进行一次知识库的清理和更新了。
作者通过本文聊聊自己写代码的要求及代码的可读性。
本文基于 2023 云栖大会上关于阿里云服务网格 ASM 产品技术最新进展分享的实录,来自阿里云云原生产品线服务网格团队的史泽寰、尹航同学将用 4 个部分,为读者介绍 ASM 如何落地这种 Sidecarless 和 Sidecar 模式融合的服务网格新形态,以及服务网格的 Serverless 化。
随着米哈游业务的高速发展,大数据离线数据存储量和计算任务量增长迅速,早期的大数据离线架构已不再满足新场景和需求。
在前文我们介绍了使用服务网格 ASM 的严格模式流量泳道进行全链路灰度管理的使用场景。该模式对于应用程序无任何要求,只需配置流量泳道即可实现。本文继续介绍流量泳道的第二种模式:宽松模式。
本文将和大家一同回顾 Spring Cloud Gateway 是如何满足 HTTP 请求/响应转换需求场景的,并为大家介绍在这种场景下使用 Higress 云原生网关的解决方案,同时还对比了两者的性能差异。
虽然目前 Java 11 和 Java 17 都还没有在国内大规模普及,Java 8 依然占据主流地位,但及时更新 JDK 版本可以为开发者带来许多重要的价值,包括应用程序性能和稳定性上的提升,以及可以帮助提升生产力的新功能。
在 Seata 出现之前,大家谈到分布式事务的态度是能避则避,大部分是靠写一些复杂的业务逻辑加消息最终一致性去解决数据一致性问题。但 Seata 开源之后,这些问题都变得简单起来。比如这里提到的无损上下线,核心关注的是服务的可用性还是其他问题。
新业务上线前,我们通常需要对系统的不同中间件进行压测,找到当前配置下中间件承受流量的上限,从而确定上游链路的限流规则,保护系统不因突发流量而崩溃。
2 年前的云栖大会,我们发布分布式云容器平台 ACK One,随着 2 年的发展,很高兴看到 ACK One 在混合云,分布式云领域帮助到越来越多的客户,今天给大家汇报下 ACK One 2年来的发展,如何帮助客户解决分布式领域多云多集群管理的挑战。
阿里云消息队列从诞生开始,至今已有十余年。今年,阿里云消息产品全面品牌升级为 ApsaraMQ,与时俱进,砥砺前行。2023 年,全系列产品 Serverless 化,面向企业提供极速弹性、更高性价比的云消息队列产品,帮助企业在消息队列使用上降本。
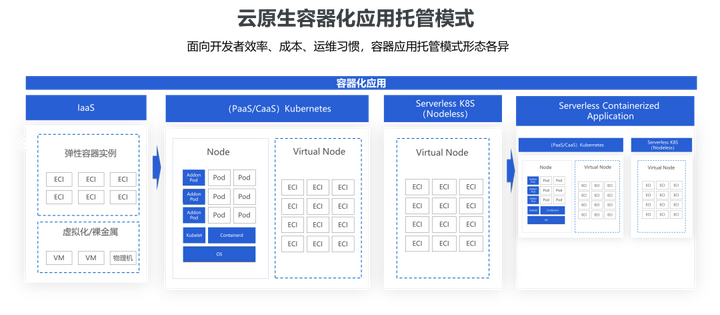
云原生这个概念从提出,到壮大,再到今天的极大普及,始终处于一个不断演进和革新的过程中。云原生体系下应用的托管形态是随着企业应用架构在不断演进的。最早的应用大多是集中式、单体式的,应用通过优雅的分层来实现领域模型的共享和更细致的模块拆分。
回顾曾在开放平台工作台的三年,发现自己主要是写业务为主。虽然和同伴们一起参与主导过从组件化到平台化、配置化到定制化的能力建设,但更多的精力也参与在客户拜访、ISV培训、数据分析和业务决策,这让我有了对业务方向的提前感知和判断,使得在技术侧能够前置准备,更好的服务业务目标。
学会如何利用 IDEA 高效 debug ,将会大大提升我们的工作效率,希望本文会给你一些参考。
PolarDB-X 正式发布 2.3.0版本,重点推出PolarDB-X标准版(集中式形态),将PolarDB-X分布式中的DN节点提供单独服务,支持paxos协议的多副本模式、lizard分布式事务引擎,可以100%兼容MySQL。
亚运会之后,杭州最大的盛会即将举行,这是疫情三年后的首届云栖大会📅 2023.10.31~11.2📌 杭州云栖小镇国际会议中心
匠心来自于重复性工作,但重复性工作未必一定培养出匠心。
本文介绍了一种新的基础模型SMT(Scale-Aware Modulation Transformer),它以更低的参数量(params)和计算量(flops)取得了大幅性能的提升。
本文会以阿里云容器服务 ACK(Alibaba Cloud Container Service for Kubernetes)为例,介绍基于 ACK 的应用高可用架构和治理的最佳实践。
随着深度学习大语言模型的不断发展,其模型结构和量级在快速演化,依托大模型技术的应用更是层出不穷。对于广大开发者来说不仅要考虑如何在复杂多变的场景下有效的将大模型消耗的算力发挥出来,还要应对大模型的持续迭代。
本文将为您演示如何使用GPU加计算巢来生成个人的数字写真。整个过程分为三步:第一步是开通FaceChain服务并创建实例;第二步是使用已开通的FaceChain服务进行训练;第三步是选择风格并生成个人的数字写真。在每一步中,都给出了具体的操作指引和注意事项。
本文旨在对 Istio Ambient Mesh 的流量路径进行详细解读,力求尽可能清晰地呈现细节,以帮助读者完全理解 Istio Ambient Mesh 中最为关键的部分。阅读本文需要读者具备基本的 TCP/IP 协议知识和操作系统网络知识,包括 iptables 和路由等。
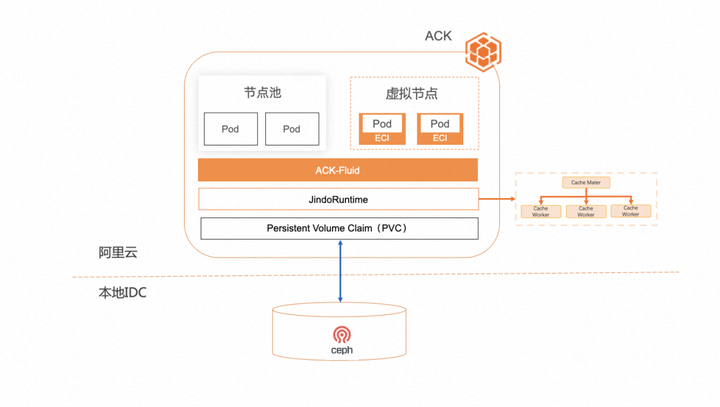
在之前的文章中,我们讨论了混合云场景下 Kubernetes 与数据相结合的 Day 1:解决数据接入的问题,实现云上计算和线下存储的连接。在此基础上,ACK Fluid 进一步解决了数据访问的成本和性能问题。而进入 Day 2,当用户真的在生产环境使用该方案时,最主要的挑战就是运维側如何处理多区域集群的数据同步。
本文总结了作者和团队的其他同学在全栈化实践中的痛点和问题,分享了自己的解决思路和经验,希望让后人可以更轻松加入全栈化大家庭,走的更快更稳。
日志是系统中熵增最快的一个模块,它承载了业务野蛮生长过程中的所有副产品。本文介绍了一个日志治理案例,围绕降本和提效两大主题,取得一定成效,分享给所有渴望造物乐趣的同学。
在本文中将重点介绍如何加速第三方存储访问,实现更好的性能,更低的成本以及降低对专线稳定性的依赖。
本次通过云原生网关可观测性进行故障发现和故障定位的实践过程中,首先通过网关的告警策略将故障通知到用户,然后通过 arms 提供的 prometheus 监控服务初步定位到出现故障的路由以及服务,之后通过 SLS 日志服务提供的网关的结构化日志进行查询分析,排查出部分错误是客户端请求路径错误导致,最后通过链路追踪对服务调用链路进行分析,最终成功对故障根因进行定位。