
【看这一篇就够了】近三年嵌入式软件开发技术栈汇总
【看这一篇就够了】近三年嵌入式软件开发技术栈汇总
文章目录
- 1. 开发基础
- C/C++基础
- Makefile
- git
- 卡尔曼滤波
- 2. MCU开发
- BOOT
- BSDIFF差分补丁升级
- 位带操作
- SysTick延时
- 时钟及PLL时钟锁相环
- 异常获取
- STM32
- STM32L4
- APM32
- AT32
- ADuCM4050
- 3. 外设开发
- UART/USART及重定向
- I2C
- SPI
- DSPI和QSPI
- 低功耗模式
- USB
- Flash和代码跳转
- DCMI
- 4. 毫米波雷达开发
- 上电时序
- FMCW
- 雷达参数设计
- chirps数
- MIMO
- 利用FFT测量的原理
- DBSCAN点云聚类算法
- CFAR动态门限
- 软件开发
- 5. 传感器、外部芯片开发
- ADXL系
- EEPROM
- OV2640
- PMIC
- HC05蓝牙
- GNSS
- 6. RTOS
- 多线程基本
- FreeRTOS
- TI-RTOS
- 7. Qt和LVGL
- Qt
- LVGL
- 8. Linux驱动
- 交叉编译
- Linux应用
- 驱动安装
- 字符驱动
- 块设备和platform(平台总线)驱动
- 地址映射,虚拟内存和硬件内存地址
- devmem命令
- 设备树节点
- 内核时钟
- 中断、上半部和下半部
- 多线程驱动安全
- 异步通知(进程通信)
- 9. 通讯协议、物联网、DSP及FatFS文件系统
- 通讯协议
- 物联网
- DSP
- FatFS文件系统
1. 开发基础
C/C++基础
main
可以用void 也可以用int
传参可以不用(void)
也可以传三个参数 不过一般是两个
int main(int argc , char* argv[],char* envp[]);
对应参数个数、参数(字符串形式)列表
第三个指向环境变量表字符串
指针和大小端
对于指针 看懂:((void(*)())NULL)(); 即可
大小端则对应内存分配:
uint32_t dat=0;
uint8_t buf[]={0x40,0x80,0x00,0x00};
memcpy(&dat,buf,4);
float f=0.0f;
swap32(&dat); //大小端转换
f=*((float*)&dat); //地址强转
printf("%f",f);
内存分配
堆、栈、数据段(全局、静态)、常量和代码段
全局存储区(静态存储区):全局变量和静态变量的存储是放在一块的,初始化的全局变量和静态变量在一块区域, 未初始化的全局变量和未初始化的静态变量在相邻的另一块区域。程序结束后有系统释放。
常量区只存储常量 不运行更改
栈就是函数内的临时变量
堆是靠用户分配的 全局可访问 如new和malloc 当然也要delete或者free
数据段存储静态变量和全局变量
常量和代码段则存储只读的数据
编译器编译后可以看到各个空间的利用率

如果是TI RTOS那种 则可以用堆空间来模拟线程中的栈 而不使用系统栈区
且内存分配可以由用户来定义

结构体、联合体、位段
除常见结构体外 还有联合体、位段
typedef struct {
	char c;
	int i;
} MyStruct;

typedef union {
	char c;
	int i;
} MyUnion;

struct packed_struct
{
    unsigned int f1 :1;
    unsigned int f2 :1;
    unsigned int f3 :1;
    unsigned int type :4;
    unsigned int index :9;
};
结构体内传入函数指针即可实现类似C++的函数调用
i++和++i
#include <stdio.h>
int main()
{
    int i=1,a=0,b=0;
    a=i++;
    b=++i;
    printf("i=%d,a=%d,b=%d\n",i,a,b);
    return 0;
}
得到:
3 1 3
原因是i++是先赋值在自增 ++i是先自增再赋值
指针常量
const int *a; 表示a是一个指针,可以任意指向int常量或者int变量(地址可变 内容不变),它总是把它所指向的目标当作一个int常量。也可以写成int const* a;含义相同。
int * const a; 表示a是一个指针常量(地址不变),初始化的时候必须固定指向一个int变量,之后就不能再指向别的地方了。
volatile关键字
用于防止编译器优化 常用于内存、寄存器直接操作
对该变量的存取操作不能进行优化,即告诉编译器每次存取该变量的时候都要从内存中去存取而不是使用之前在缓存寄存器中的备份
针对可能被同时使用的变量 要加上关键字 防止编译器优化
比如多线程使用的变量、中断中使用的变量
虚函数
函数声明:__weak 或virtual表示虚函数
在MCU开发中 使用__weak 声明表示虚函数 重写时 只需要去掉__weak定义即可 如:
__weak void HAL_UART_RxCpltCallback(UART_HandleTypeDef *huart);
在C++类声明中 virtual表示虚函数 重写时只能在继承其父类下声明的同名函数末尾加上override 然后再实现实例
譬如QThread下的run函数
virtual void run();

class Thread02 : public QRunnable
{
public:
    Thread02();
    ~Thread02();
    void run() override;
};
冒泡排序
void BubbleSort(uint8_t *buf, uint32_t len)
{
    uint32_t i = 0;
    uint32_t j = 0;
    uint8_t temp = 0;
    bool swapped = false;  // 优化:如果某次循环没有交换,说明已经有序

    for(i = 0; i < len - 1; i++)
    {
        swapped = false;
        for(j = 0; j < len - 1 - i; j++)
        {
            if(buf[j] < buf[j + 1])  // 降序排序
            {
                temp = buf[j];
                buf[j] = buf[j + 1];
                buf[j + 1] = temp;
                swapped = true;
            }
        }

        // 如果这次循环没有交换,说明数组已经有序
        if(!swapped) {
            break;
        }
    }
}
C++的不同点
命名空间
用::表示namespace
使用using namespace声明可指定
using namespace std;
int a=0;
cin>>a; //输入到a

cout<<a;  //输出a
在C++中运行C
如果在C++中运行C 则需要:
extern "C"
{
...
}
一般可以宏定义:
#ifdef __cplusplus
extern "C" {
#endif

...//C文件的函数声明

#ifdef __cplusplus
}
#endif
导入C库则使用前面加个c的方式导入
#include <cstdio>
class类
支持类class的定义方式 包括构造函数和解析函数
class A
{
public:
int a;
A();
~A();
private:
int b;
}

A::A()
{
...
}

A::~A()
{
...
}
同时 类可以继承 以实现加入第二个类的属性
class B
{
int b;
}
class A: public B
{
int a;
}
函数重载、函数模板
有编译器根据输入的参数变换不同的替换类型
int jf(int a,int b){	//1
	return a-b;
}
double jf(int a,double b){		//2
	return a-b;
}
double jf(double b,int a){		//3
	return a-b;
}
int jf(int a,int b,double c){	//4
	return a-b-c;
}

template<typename T1,typename T2>
T1 add(T1 a,T2 b) {
	return a+b;
}

int main(){
	int x=14,y=9,z=45;
	double m=9.45,n=7.22;
	cout<<"x-z="<<jf(x,z)<<endl;		//1
	cout<<"y-m="<<jf(y,m)<<endl;		//2
	cout<<"n-y="<<jf(n,y)<<endl	;		//3
	cout<<"x-y-z="<<jf(x,y,z)<<endl;		//4

	x=23;y=8;
	m=9.332;n=5.91;
	cout<<add(x,y)<<endl;
	cout<<add(m,x)<<endl;
	cout<<add(x,m)<<endl;
	cout<<add(n,m)<<endl;

	return 0;
}
Makefile
最简单的方式 编译、导入编译、删除
main: main.o input.o calcu.o
	gcc -o main main.o input.o calcu.o
main.o: main.c
	gcc -c main.c
input.o: input.c
	gcc -c input.c
calcu.o: calcu.c
	gcc -c calcu.c

clean:
	rm *.o
	rm main
使用自动化变量可以变成:
objects = main.o input.o calcu.o
main: $(objects)
	gcc -o main $(objects)

%.o : %.c
	gcc -c $<

clean:
	rm *.o
	rm main
编译时 会自动加载Makefile文件
使用名称变量 如指定内核源码文件的编译:
KERNELDIR := /home/alientek/linux/atk-mp135/linux/my_linux/linux-5.15.24
CURRENT_PATH := $(shell pwd)
obj-m := chrdevbase.o

build: kernel_modules

kernel_modules:
	$(MAKE) -C $(KERNELDIR) M=$(CURRENT_PATH) modules
clean:
	$(MAKE) -C $(KERNELDIR) M=$(CURRENT_PATH) clean
git
初始化 git init
首次使用还应添加邮箱、密钥
git config --global user.name "zhangsan"
git config --global user.email "zhangsan@xxxx.com"

ssh-keygen -t rsa -C "zhangsan@xxxx.com"  //保存密钥
在拉取、推送时要设置节点
git remote add origin http://192.168.1.88:7990/scm/l496/p_level_a121.git
拉取项目 git clone 项目地址
拉取某个分支 git pull origin 分支名
查看当前分支 git branch
创建并切换分支 git checkout -b 分支名
提交代码:
先暂存 再本地提交 最后远程提交
暂存 git add
git add --all  //添加所有修改的文件 更新整个仓库(删除的文件也会同步删除)
git add .  //根据.gitignore过滤
git add *  //添加文件
本地提交 git commit -m "更新的内容说明"
远程提交 git push origin 分支名
卡尔曼滤波

递归算法
在测量同一数据时 存在误差 最简单的方法就是求算术平均值
引入递归的思想 卡尔曼增益与估计误差、测量误差的关系为:

k越大 估计误差越小 结果趋近于上一次的估计值 数据收敛


数据融合
测量同一数据 有两种不同的测量方式 得出两种测量结果 且两者都有误差 满足正态分布

谁的方差越小 越相信谁的数据

数据预测
对于动态的数据 其数据一直在变化 存在系统误差(过程误差) 另外 有一个观测的测量结果 存在测量误差
通过递归思想 并将两者进行数据融合 得到五大公式:

通常用于一维数据随时间变化(过程)的滤波
2. MCU开发
BOOT
BOOT引脚检测上电后运行代码的位置:
BootLoader区域一般为0x1FFF 0000
BootLoader可以用串口来烧录代码
Flash用户代码运行地址为0x0800 0000
外设地址一般为0x4000 0000开头
SRAM地址一般为0x2000 0000开头
BSDIFF差分补丁升级
使用BSDIFF差分算法 可以实现补丁包差分升级 具体如下:
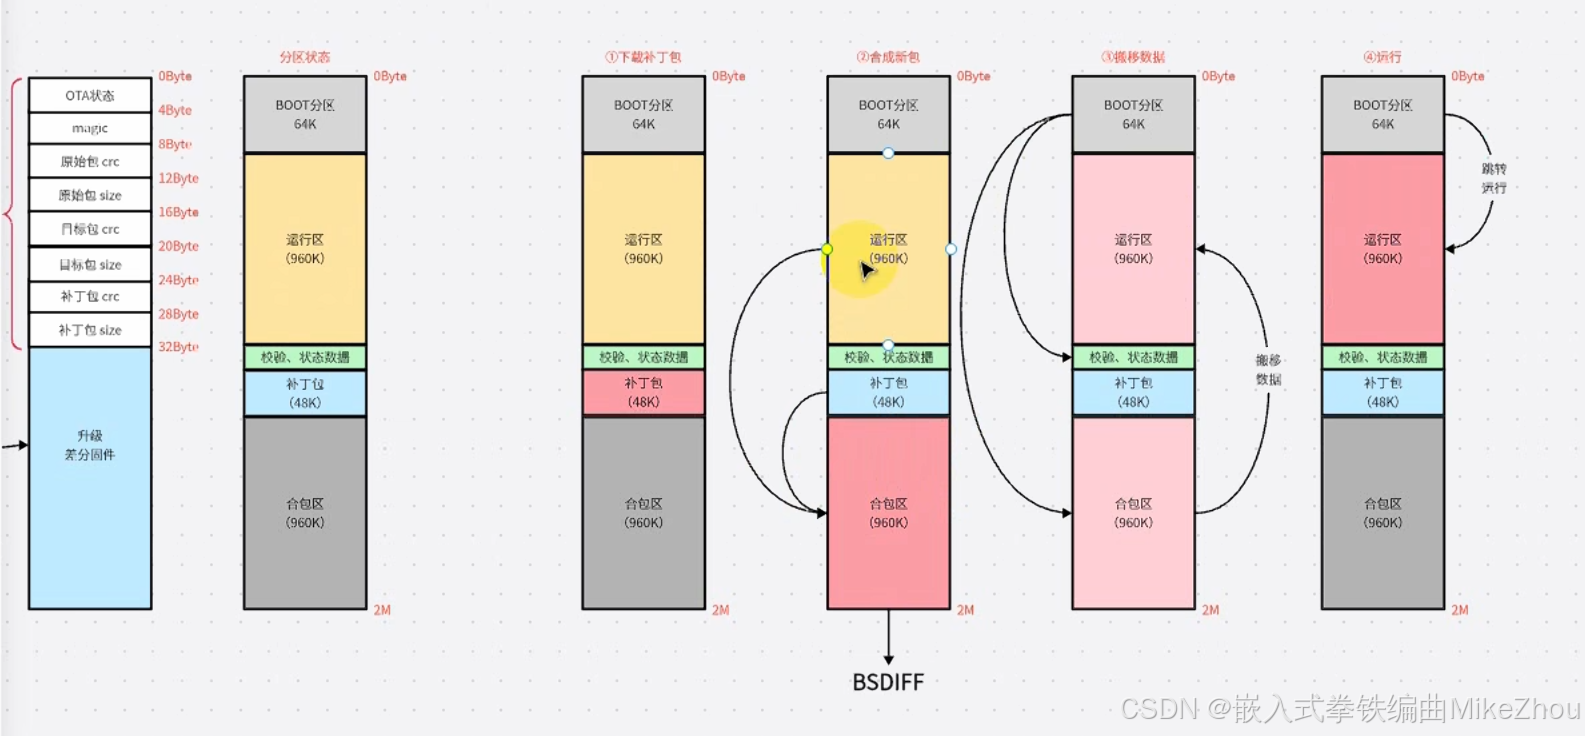
同样 也有其他类似的差分升级方法
位带操作
0x4000 0000或0x2000 0000地址上的1MB所在空间 扩充至位带别名区(0x4200 0000或0x2200 0000以上32MB)
且在原地址上 每1bit变成一个完整的寄存器(扩增32倍)
使其能够通过操作位带别名区的一个32位寄存器来操作一个bit
寄存器位带别名 = 0x42000000 + (寄存器的地址-0x40000000)×32 + 引脚编号×4

SysTick延时
上电后 SysTick中断标志一直不会清零
若不清零 会导致无法进入低功耗
SysTick延时需要分别进行
以下三个寄存器的操作 并等待SysTick->CTRL的计数清零标志
SysTick->LOAD = 50000000/1000*ms-1; // Count from 255 to 0 (256 cycles)  载入计数值 定时器从这个值开始计数
SysTick->VAL = 0; // Clear current value as well as count flag  清空计数值到达0后的标记
SysTick->CTRL = 5;
延时完毕后
关闭SysTick并清零
SysTick->CTRL = 0;
时钟及PLL时钟锁相环
通过PLL可以实现倍频
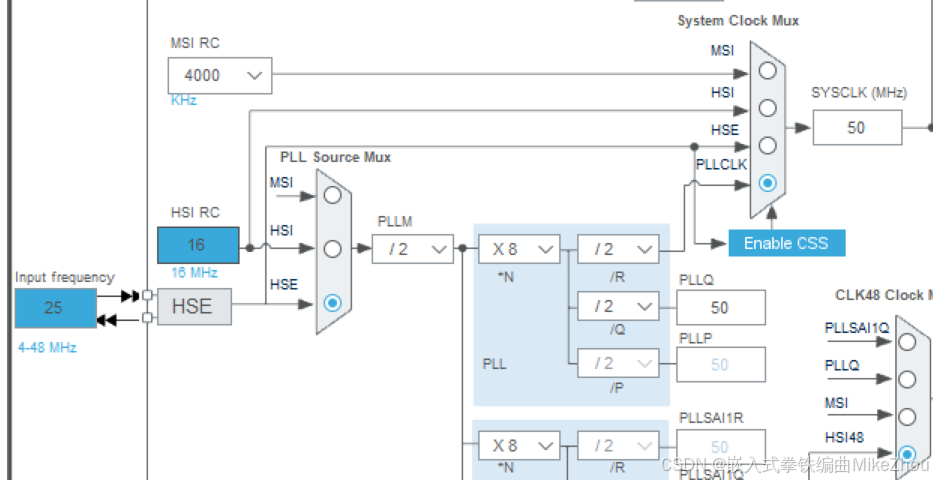
外部晶振若无法起振 原因可能是旁路电容没设计好
计算负载电容及最大驱动能力
然后对标晶振起振值 驱动能力大则能够起振
异常获取
异常中断
当MCU因堆栈溢出等造成异常会 会进入异常中断
可以在startup.s中查看
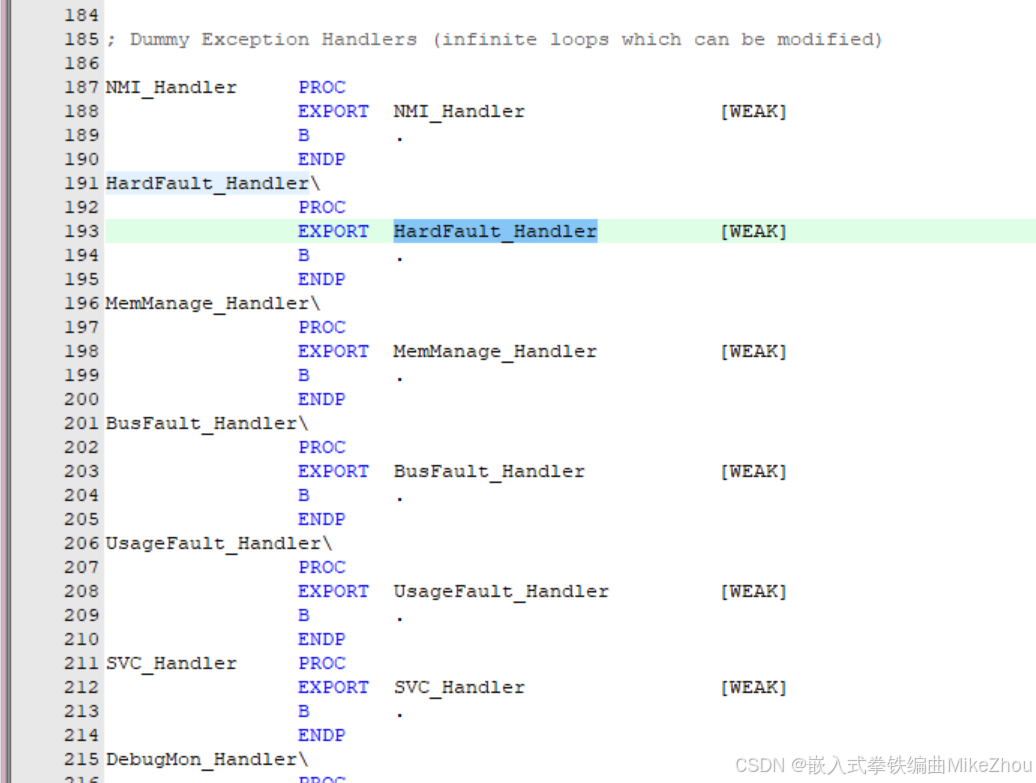
通常引起的时HardFault中断(包括内存溢出、非法赋值、寄存器操作错误、堆栈溢出等)
譬如手动引起异常:
*(uint32_t *)0x45678912=1;
异常的程序运行指针SP获取
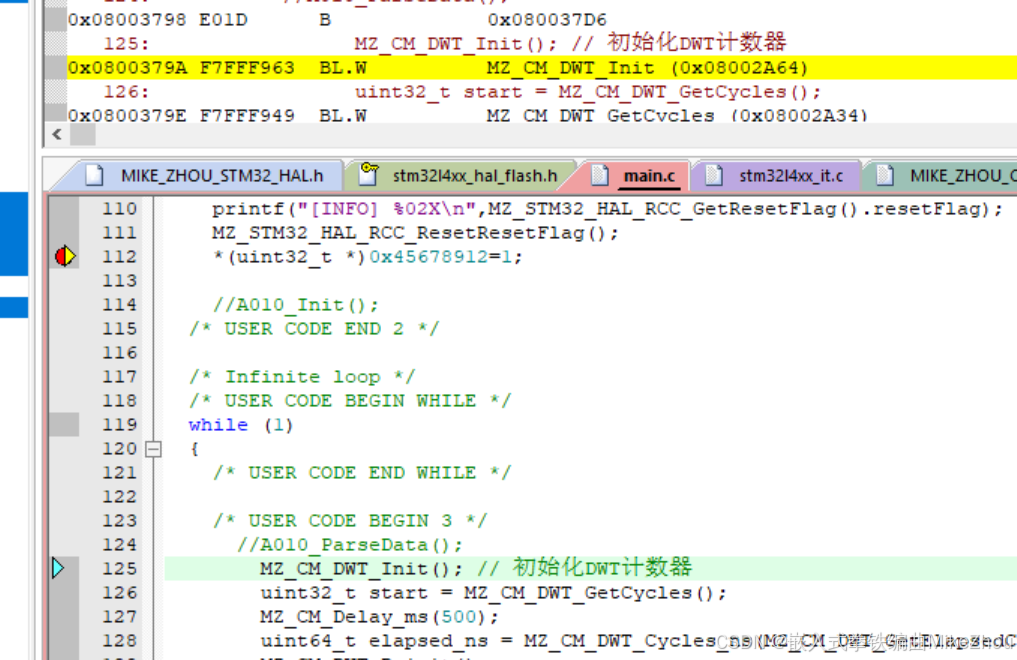
打个断点在异常代码处 可以看到地址为0x08003792
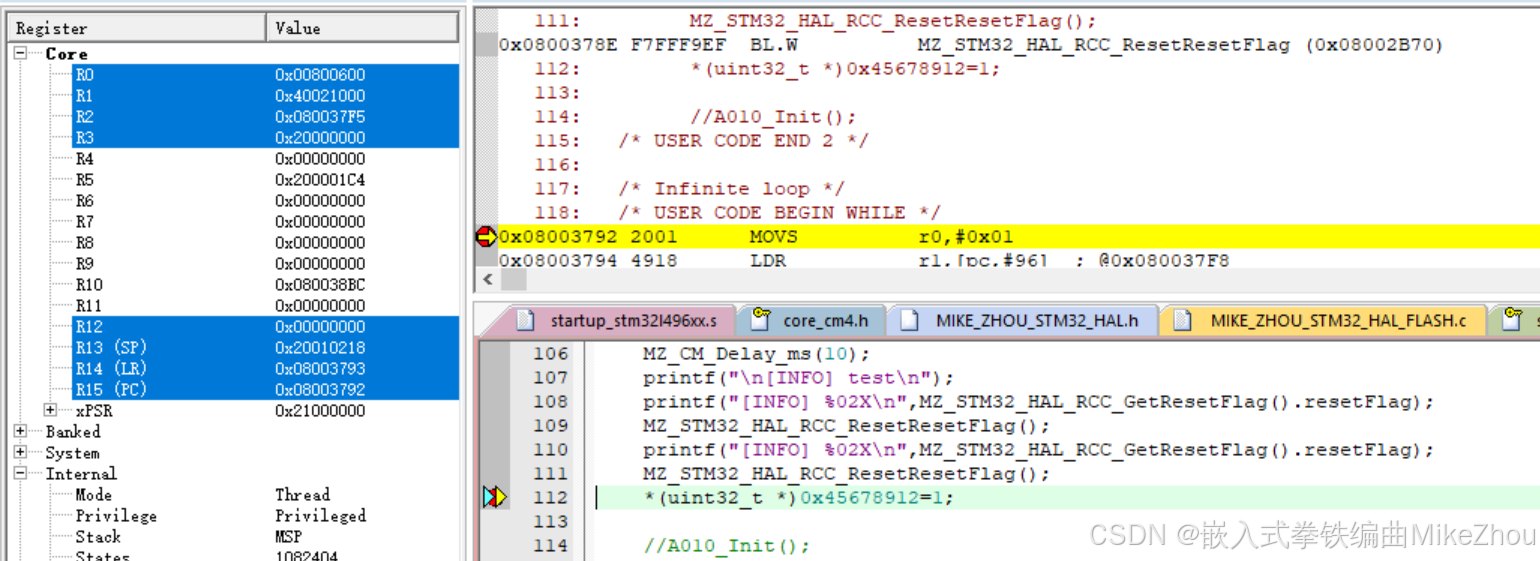
在HardFault_Handler中也打个断点 就能在运行到其中时停止
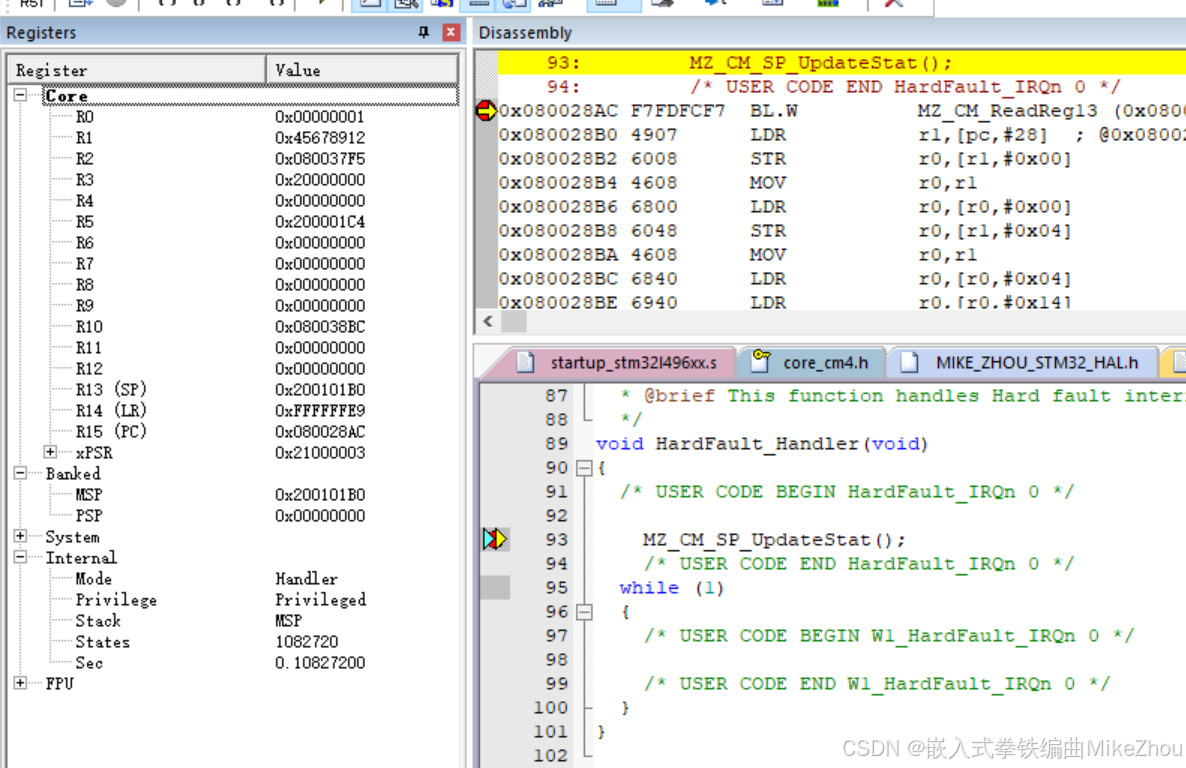
此时 LR寄存器为特殊标记值
0xFFFFFFE9对应的是要看MSP寄存器
0xFFFFFFFD对应的是要看PSP寄存器
具体根据芯片手册而定(cortex-M权威指南)
不过也有个更方便的方式是直接读取SP指针
通过汇编即可实现
__asm uint32_t MZ_CM_ReadReg13(void){
     MOV     R0, sp
     bx lr
}
那么 就可以通过此方式获取到0x200101B0
通过内存查看该地址:
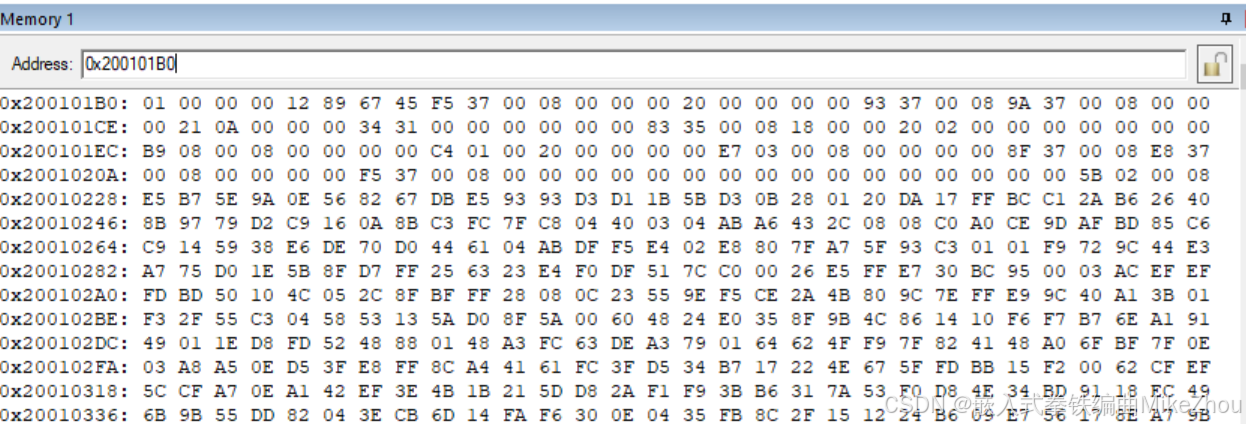
第5和6个uint32值即为上一次异常程序地址 和如果正常运行的话 下一个程序地址
注意为小端格式 所以解析出来就是0x08003793和0x0800379A

但程序地址的最后一位是标志位 用于区分是否为thumb指令或ARM指令(cortex权威指南)
由于历史原因,最初的16位单片机用的指令是Thumb指令,为16位指令。后来,ARM推出了32位的ARM指令。16位的指令更适合空间有限的嵌入式处理器,而32位的指令则更加灵活、功能丰富。因此,有些单片机在运行时可以根据需求切换指令状态。如下图:
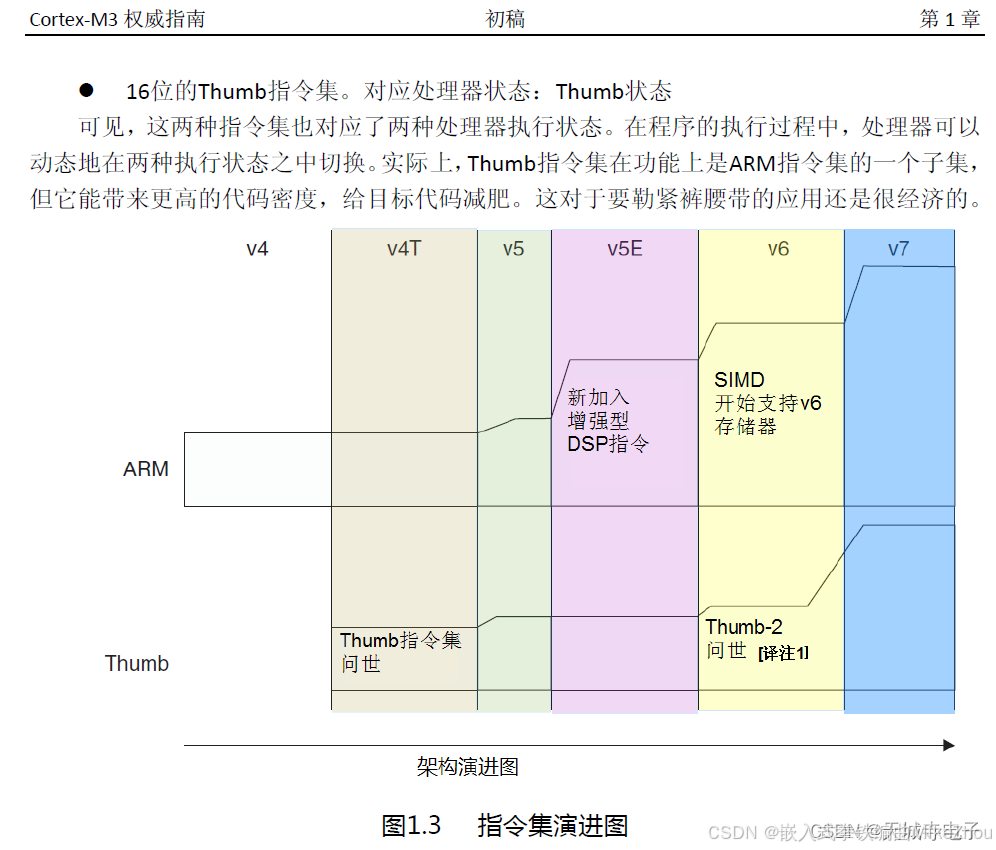
后来诞生了Thumb-2指令集,它实现了16位指令和32位指令的共存。而Cortex-M3架构则就是采用Thumb-2指令集。由于16位指令长度是2字节,32位指令长度是4字节,因此其PC指针地址是按照2字节(16位)对齐的。换言之其最低位一定是0。
另外 需要注意的是 如果在代码层面进行获取 不能包装子函数(子函数会导致LR和SP被重写) 所以直接用一个宏替代即可
#define MZ_CM_SP_UpdateStat() MZ_CM_SP_Stat.sp = MZ_CM_ReadReg13();MZ_CM_SP_Stat.spAddr = (uint32_t *)MZ_CM_SP_Stat.sp;MZ_CM_SP_Stat.lastFlashAddr = MZ_CM_SP_Stat.spAddr[5];MZ_CM_SP_Stat.nextFlashAddr = MZ_CM_SP_Stat.spAddr[6];
调用后 如下:
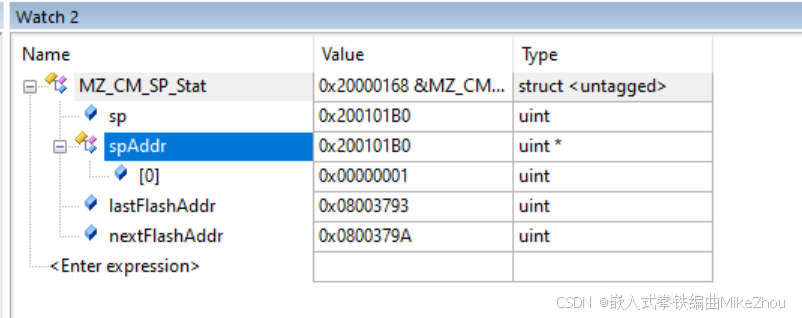
后一个地址正是如果正常运行的下一个程序语句地址
SCB寄存器错误类型获取
关键寄存器:
SCB->CFSR(可配置故障状态寄存器):判断故障类型(如内存访问错误、未对齐访问、指令执行错误)。
SCB->HFSR(硬件故障状态寄存器):确认是否为HardFault的直接触发原因。
SCB->MMFAR/SCB->BFAR:记录导致内存管理或总线故障的具体地址。
直接通过memcpy获取即可
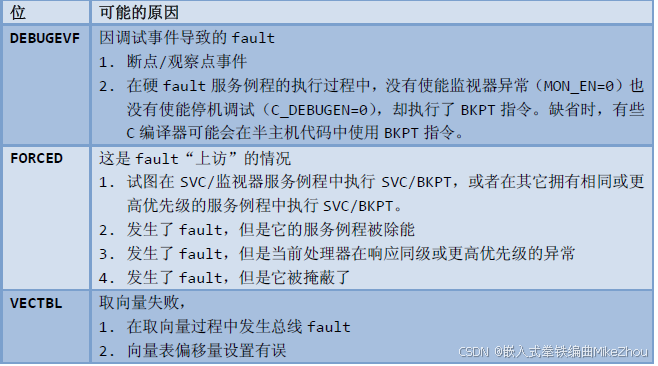
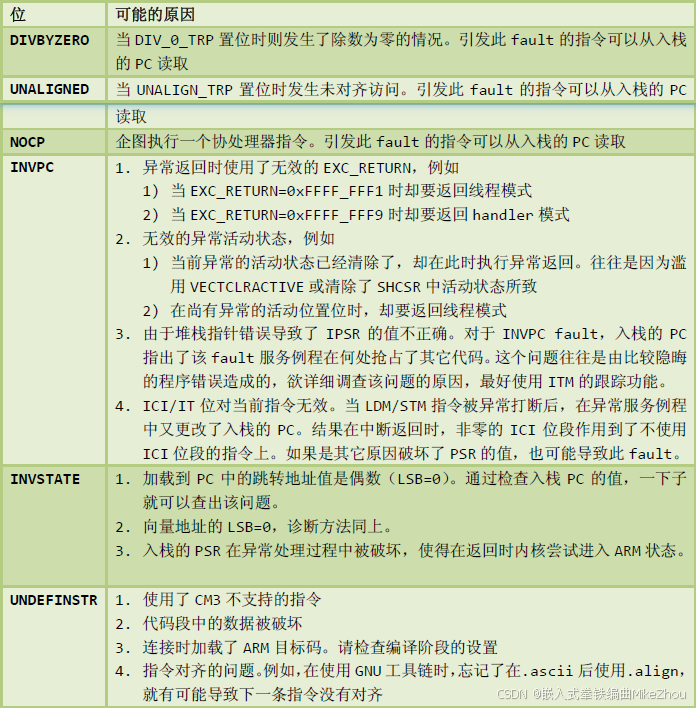
硬件错误异常 Hard fault status register (SCB->HFSR)
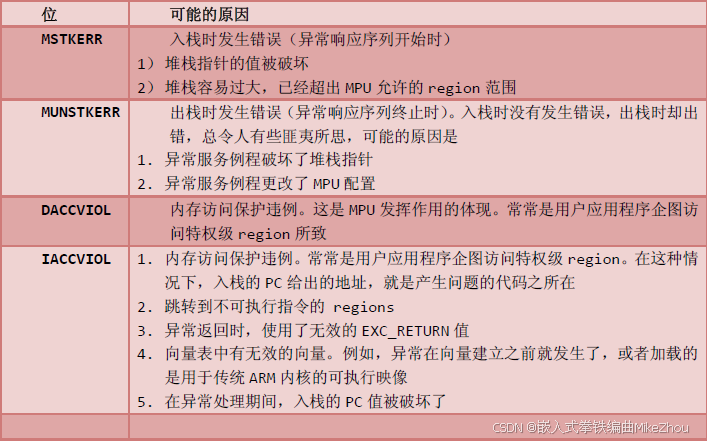
存储器管理错误异常 SCB->CFSR中MMFSR位
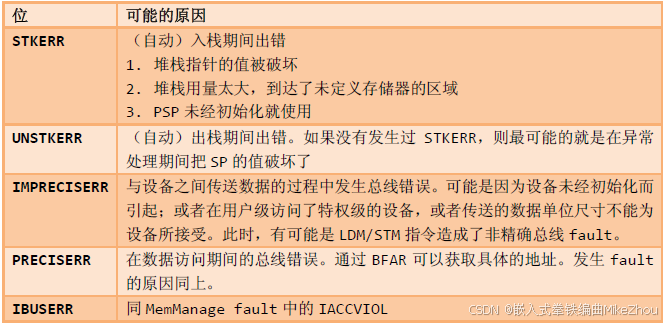
总线错误异常 SCB->CFSR中BFSR位
使用错误异常 SCB->CFSR中UFSR位
STM32
通过HAL库可以实现外设自动配置、时钟树配置等
但前提是要运行HAL的BIOS初始化
若完全使用标准库开发 则直接进行寄存器开发即可
资源丰富,参考资料和教程多
官方也支持了一些外部软件包
标准库中 中断由中断服务函数完成 进入中断后 需要手动清空中断标志位
而在HAL库中 中断由回调函数完成 回调函数又在中断服务函数中被调用
在HAL库中 大多数情况下 不用清理中断标志位
STM32L4
低功耗系列 其本身还是Cortex-M4架构 但计算能力、最大工作频率不及F4系列
支持LPUART等低功耗外设
支持UART低功耗唤醒及多种低功耗模式
APM32
与STM3不止P2P 而且R2R
完全可以用同型号的STM32HAL库开发
但内核和硬件上有一些阉割和不一样
如Flash擦写次数、FreeRTOS移植时的不一样
AT32
对标某些STM32的P2P 但寄存器不一样 只能用AT32的官方库(类似标准库)开发
好在官方支持做时钟配置、外设配置的软件
ADuCM4050
ADuCM4050功耗非常低
但开发资料有限
在仅靠手册的情况下 独自完成了学习和开发
并在中文社区进行首个开源及笔记总结
与STM32系列开发不同的是:
其为了节省系统资源 每次开发一个新的外设 都需要用户自己去开辟一段空间用于外设内存
且每打开一个外设 就得定义一段空间和句柄
unsigned char SPI2_MemorySize[ADI_SPI_MEMORY_SIZE]; //48b
3. 外设开发
UART/USART及重定向
UART是异步通信
通常空闲时为高电平 起始位为低电平 停止位为高电平
其Data数据段一般为LSB在前 即先传输低位数据
UART与USART的区别在于后者可以同步传输
在同步模式下 通过CLK信号来进行时钟同步
在半双工模式下 可以使用RTS CTS硬件流控制 控制输入/输出
RS232
改变了电平大小的串口通信
将TTL信号转变成了+3V至15V(0)和-3V至15V(1)
RS485
通过差分信号传输
逻辑1:A线的电压高于B线的电压,且 A+和B- 的电压差在 +2V~+6V 之间。
逻辑0:A线的电压低于B线的电压,且 A+和B- 的电压差在 -2V~-6V 之间。
重定向
为了使用printf、scanf等函数 对标准库中的fputc函数进行重定向
#pragma import(__use_no_semihosting_swi)
struct __FILE { int handle; /* Add whatever you need here */ };
FILE __stdout;
FILE __stdin;

//串口打印配置函数 printf
int fputc(int ch, FILE *f)
{
	HAL_UART_Transmit(&huart2,(uint8_t *)&ch,1,0xFFFF);
	return ch;
}
//串口接收函数 scanf
int fgetc(FILE *f)
{
  uint8_t ch = 0;
  HAL_UART_Receive(&huart2,&ch,1,0xFFFF);
  return ch;
}
I2C
一般先发7位从机地址+R/~W位(高电平为R 低电平为W) 然后等待从机响应 响应后 即可继续按MSB发送数据
注意7位从机地址 HAL库的API在传入时是需要自己手动往左移一位的 而有的SDK不需要
随机地址读写:先发从机地址 再发寄存器地址 然后再发一次从机地址+读写位 最后发数据
当前地址读写(顺序读写):先发从机地址+读写位 再发数据
对于HAL库:
HAL_I2C_Mem_Write  //随机地址写入
HAL_I2C_Mem_Read  //随机地址读取
HAL_I2C_Master_Transmit  //当前地址发送
HAL_I2C_Master_Receive  //当前地址接收
SPI
根据时钟极性(CPOL)及相位(CPHA)不同,SPI有四种工作模式。
时钟极性(CPOL)定义了时钟空闲状态电平:
CPOL=0为时钟空闲时为低电平
CPOL=1为时钟空闲时为高电平
时钟相位(CPHA)定义数据的采集时间。
CPHA=0:在时钟的第一个跳变沿(上升沿或下降沿)进行数据采样。
CPHA=1:在时钟的第二个跳变沿(上升沿或下降沿)进行数据采样。
在连续传输数据时 CS需要一直拉低
所以在HAL库中推荐使用软件CS
使用中断或DMA可以实现连续传输(ADuCM4050默认连续所以不需要)
如果速度过快 只能使用DMA
HAL_SPI_TransmitReceive_IT(hspi,pData,buf,x+y);
while(hspi->State!=HAL_SPI_STATE_READY);
Set_SPI_CS(hspi,GPIO_PIN_SET);
DSPI和QSPI
为了提高传输速度 把MOSI和MISO都设置为同方向的 可以在半双工传输时 数据量翻倍
同样 也有四根数据线的QSPI 即4线SPI
额外多出两根用于传输信号的线
有些器件支持QSPI 如TI毫米波雷达系列 其官方开箱工程在上电时需要检测QSPI通信的外部Flash
低功耗模式
以STM32L496的HAL库为例
低功耗有睡眠模式、停止模式、待机模式
另外 还有低功耗运行及睡眠模式(时钟频率2M以下)
睡眠模式任意中断均可唤醒 若为低功耗睡眠 则唤醒以后处于低功耗运行模式
进入低功耗模式时 可以选择WFI或WFE
停止模式0和1可以被外部中断、串口等外设唤醒 停止模式2只能被外部中断和与外部中断连线的器件如LPUART唤醒
待机模式只能由复位、系统WakeUp、RTC唤醒
停止模式进入时 会关闭部分时钟 唤醒后需要重新配置时钟
在进行UART的停止模式唤醒时 除了要保留HSI时钟外 还应将UART的时钟提前选择为HSI
并开启唤醒中断和串口停止模式
且要开启UART的停止模式时钟(HAL_UARTEx_EnableClockStopMode否则第一个数据会丢失)
__HAL_RCC_WAKEUPSTOP_CLK_CONFIG(RCC_STOP_WAKEUPCLOCK_HSI);	//保留唤醒用的HSI线 串口初始化时钟也必须要配置为HSI

UART_WakeUpTypeDef UART_WakeUpStruct={0};
UART_WakeUpStruct.WakeUpEvent=UART_WAKEUP_ON_READDATA_NONEMPTY;  //接收数据不为空时唤醒
HAL_UARTEx_StopModeWakeUpSourceConfig(huart,UART_WakeUpStruct);

__HAL_UART_ENABLE_IT(huart,UART_IT_WUF);	//开启唤醒中断
HAL_UARTEx_EnableClockStopMode(huart);
HAL_UARTEx_EnableStopMode(huart);		//开启模式
唤醒后则调用时钟初始化并关闭串口的停止模式
__HAL_RCC_PWR_CLK_ENABLE();
SystemClock_Config();
Ctrl_UART_StopMode_WakeUp(huart,false);
由于停止模式唤醒后 PLL完全被改变 PLLSAI时钟线无法重新初始化 建议直接将ADC定义为SYSTICK
USB
USB有主机和设备模式
在设备模式下 只需要两个数据引脚即可
在主机模式下 则需要额外一条输出引脚控制线
若配置为HS高速 则需要额外硬件支持
而FS(12MB)则上拉电阻即可
USB复位则只需要两个数据引脚低电平持续1ms即可
void Reset_USB_VPC(void)
{
	__HAL_RCC_GPIOA_CLK_ENABLE();

	GPIO_InitTypeDef GPIO_InitStruct = {0};
	HAL_GPIO_WritePin(GPIOA, GPIO_PIN_11|GPIO_PIN_12, GPIO_PIN_RESET);
	GPIO_InitStruct.Pin = GPIO_PIN_11|GPIO_PIN_12;
	GPIO_InitStruct.Mode = GPIO_MODE_OUTPUT_PP;
	GPIO_InitStruct.Pull = GPIO_NOPULL;
	GPIO_InitStruct.Speed = GPIO_SPEED_FREQ_VERY_HIGH;
	HAL_GPIO_Init(GPIOA, &GPIO_InitStruct);
	delay_ms(50);
}
USB支持MSC移动硬盘、VPC虚拟串口、DPU烧录升级等
MSC需要对应的存储函数来支持(如Flash操作) 可建立文件系统来使PC和MCU共同管理文件
VPC虚拟串口支持自动波特率等配置设定
DPU烧录时 需要配置Flash的读写函数 即可通过DPU软件进行烧录
烧录后 在引导程序上可以实现代码跳转
在主机模式下 MSC为Host模式 可以作为主机读取外部的移动硬盘
Flash和代码跳转
自带的Flash操作与硬件Flash相同
读取数据时可以直接读取
read_dat = *(__I uint64_t *)add;
但是写入时 需要先擦除再写 且擦除的最小单位以扇区或页面为单位
擦除前 需要先解锁Flash 写完数据后 再对Flash上锁
每次读写数据时 要保证字节对齐
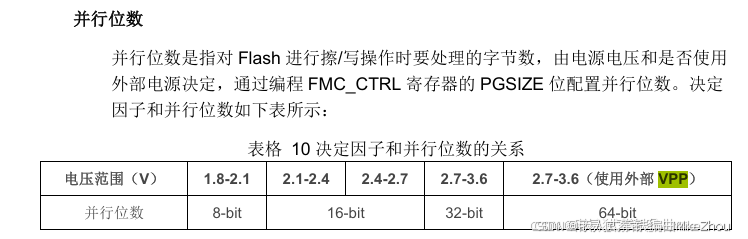
对于F4芯片 不同的工作电压模式下 字节对齐不同
通过定义一个地址的指针函数并调用 可以实现程序跳转
通过程序跳转前需要做的事:
1、禁止所有外设时钟
2、禁止使用PLL
3、禁止所有中断
4、清除所有中断挂起标志
所以要做的就是:
先关闭全局中断
清标志位
恢复HSI时钟
然后再使能全局中断
设置重映射到系统Flash(跳转到BootLeader需要)
设置主堆栈指针
使用 MSP 指针(在RTOS中)
运行跳转的函数指针
SysMemBootJump = (void (*)(void)) (*((uint32_t *) (BootAddr + 4)));
SysMemBootJump();
另外 若在Flash中运行多段代码时 非首地址开头的代码需要在编译时选择Flash下载位置
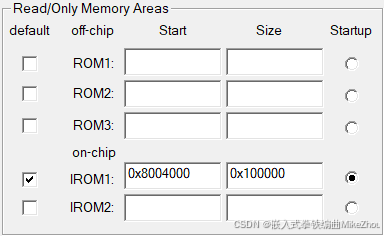
并且修改中断向量表位置:
修改VECT_TAB_OFFSET偏移 位于system_stm32f4xx.c中
DCMI
以STM32MP135为例
DCMI在接收数据时 主要以硬件同步的方式进行(也能使用内嵌码同步)
HSYNC(行同步)及VSYNC(帧同步)信号来同步
默认在PIXCLK信号的下降沿进行采样(当然也要结合驱动的摄像头实际)
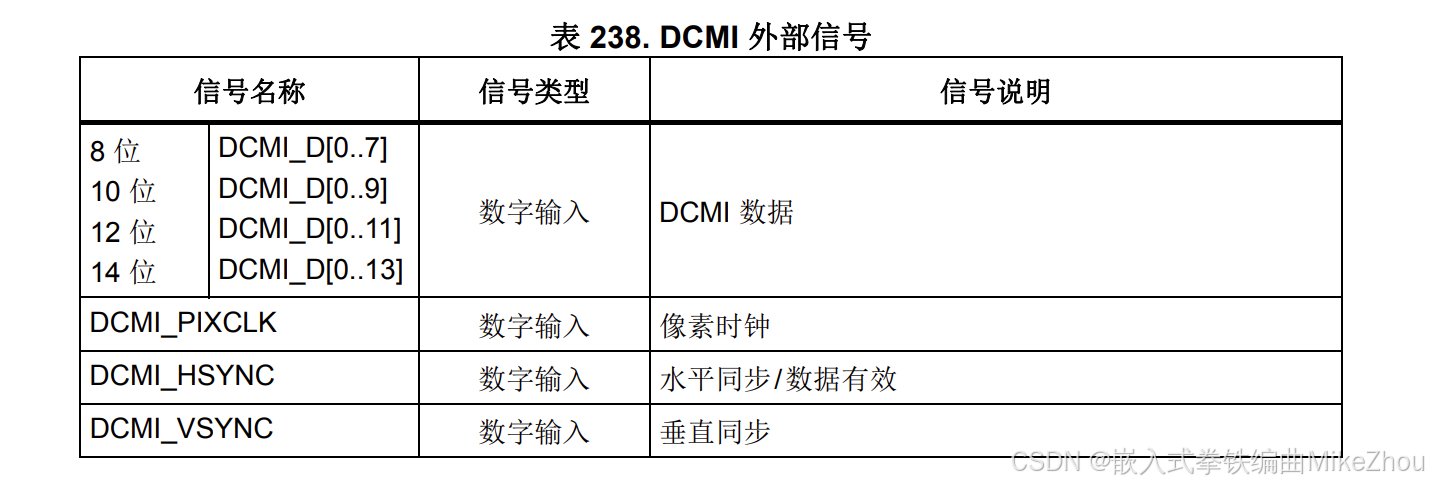
HSYNC和VSYNC为高电平时 表示行、帧结束(当然也要结合驱动的摄像头实际)
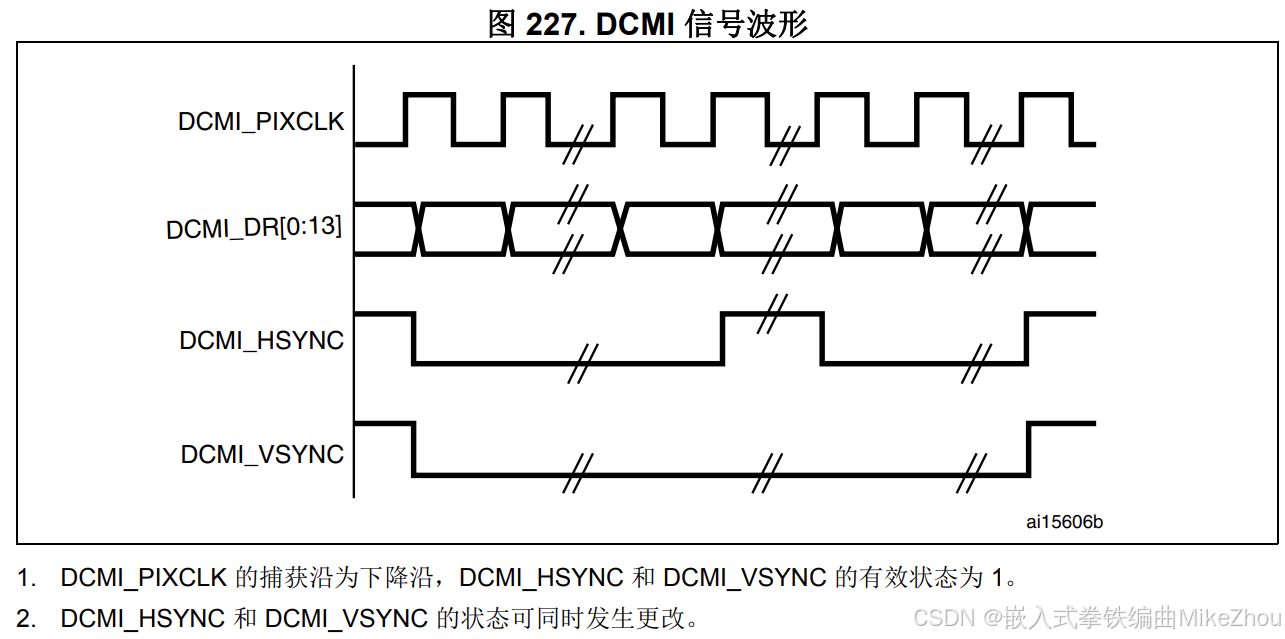
一般可以以RGB565格式和8位数据进行采集 则需要两个时钟周期
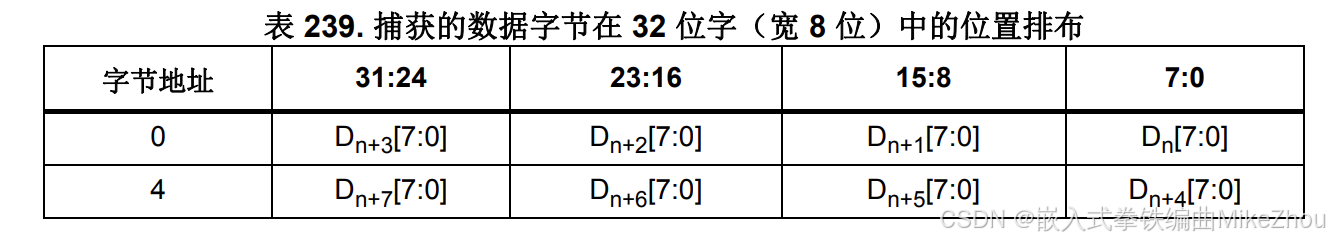
扫描顺序是从左到右为一行 然后从上到下每一行后为一帧
主要寄存器DCMI_CR :
ENABLE,该位用于设置是否使能 DCMI,不过,在使能之前,必须将其他配置设置好。
FCRC[1:0],这两个位用于帧率控制,我们捕获所有帧,所以设置为 00 即可。
VSPOL,该位用于设置垂直同步极性,也就是 VSYNC 引脚上面,数据无效时的电平状态。
HSPOL,该位用于设置水平同步极性,也就是 HSYNC 引脚上面,数据无效时的电平状态。
PCKPOL,该位用于设置像素时钟极性,我们用上升沿捕获,所以设置为 1。
CM,该位用于设置捕获模式,我们用连续采集模式,所以设置为 0 即可。
CAPTURE,该位用于使能捕获,我们设置为 1。该位使能后,将激活 DMA,DCMI 等待第一帧开始,然后生成 DMA 请求将收到的数据传输到目标存储器中。注意:该位必须在 DCMI
4. 毫米波雷达开发
上电时序
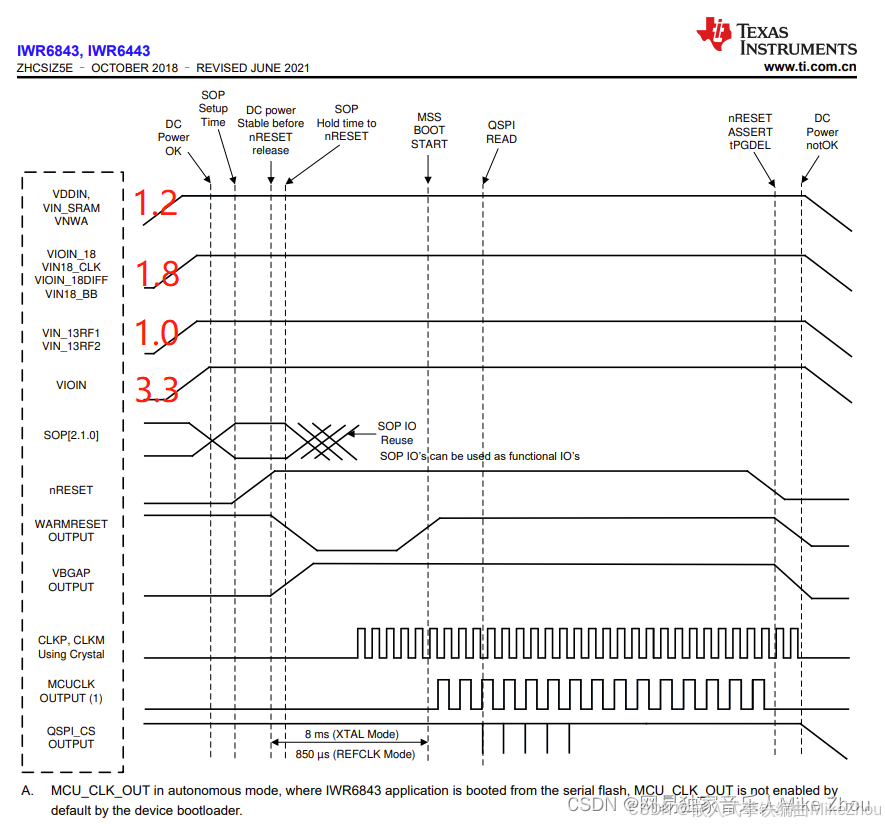
毫米被雷达四个电源输入需要满足上电时序的关系
FMCW
使用FMCW技术 使其发射的雷达波频率一直变化
一般从基础频率开始 逐渐上升
从而分辨出不同时间发射的雷达波
根据接收的雷达波的频率 即可通过延时时间得出距离
另外 目标有速度时 通过多普勒效应 导致相位(频率)发生改变 即可实现测速
一般采用原始数据求FFT并得出range、doppler数据 从而分辨目标
使用多个RX、TX时 能够根据不同的接收数据 分辨出角度信息
雷达参数设计
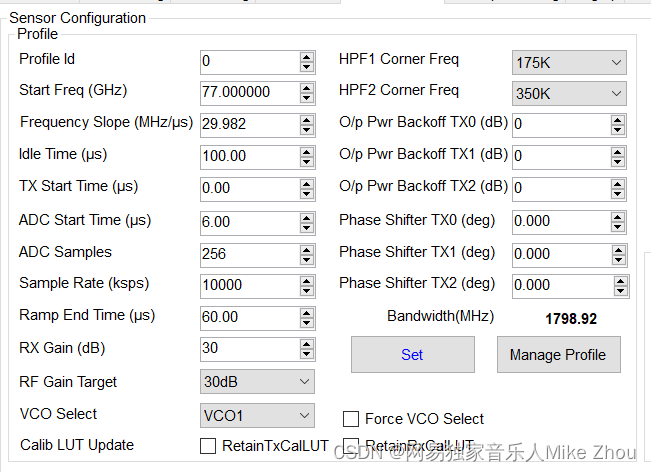
雷达参数设计包括ADC采样率、TX频率、数据接收方式、帧率、TX使能、采集时间等 chirps数不算雷达射频参数之内 最终的配置决定了距离、速度、角度分辨率和最终的算法性能 最后也决定了可适用的场景和范围
同样 也应通过应用场景来反推雷达参数设计
工作原理
在一帧的时间周期内 TX会发送一个或多个雷达波 然后被目标反射以后通过RX接收
接收后就是数据处理和算法的计算时间
下图为TI的demo工程流程 以一帧为周期

数据采样
可以对雷达接收的波形进行实数、1x复数、2x复数采样
一般是采用复数采样进行 其决定了性能和信号处理方式
ADC采样
配置采样可以获取到信号的采样 每次进行ADC采样时 获得的只是雷达接收RX天线的电压大小 所以不可能获得连续的上升下降沿波形
接收一个雷达波 从上升到下降 电压有变化 采样位数就是把这个电压变化转为多少个点 2^N(也就是ADC采样率) 一般为16位采样
同时 为了得到一个频率为N的信号 一般以2N的采样位数进行采样(信号与系统)
在TI的毫米波雷达配置中 这里的ADC采样以采样位数和ADC Samples体现 就是ADC点数
另外 在数据存储方面 一般ADC原始数据以2^N对齐 比如96个ADC Samples 其一个周期的采样数据为128 但只有前96个有效
TX使能、ADC采样时间
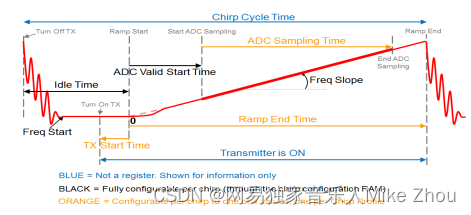
由于发射天线TX使能时 是一个从低电平到高电平的上升沿过程
而使能时 需要过一段时间才能稳定进行采样 所以要配置TX使能时间和ADC采样时间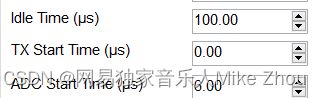
如图为配置波形 只能在中间稳定部分进行采样才行
分辨率
毫米波雷达一般以FMCW雷达为主
FMCW,即调频连续波。FMCW技术和脉冲雷达技术是两种在高精度雷达测距中使用的技术。其基本原理为发射波为高频连续波,其频率随时间按照三角波规律变化。
使用该技术的雷达通过不同的参数配置出来的各种分辨率就不同
包括距离分辨率、速度分辨率、角度分辨率
其中 速度分辨率是靠多普勒效应来测量的 也就是频率会发生红移蓝移
以雷达测一个有长度的目标来举例:
红色的为被测物体 TX为雷达所在地方的发射天线 蓝线和绿线为雷达波
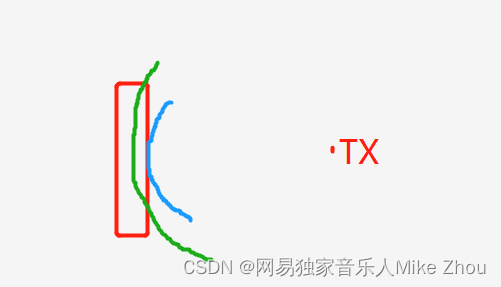
当雷达波第一次碰到目标时 也就是蓝波 得到一个距离d1 而被测物体有高度 所以被测物右上角反射的雷达波则为绿波
这样接收到的距离就肯定不是同一个值
如果距离分辨率不够 那么就没法测出绿波和蓝波有什么区别 就没法算出这个目标的轮廓
另外 在进行测角度时 如果角度分辨率不够 那么就没法测出物体的右上角和正前方有什么区别 也不能算出目标的轮廓
所以 应尽可能提高距离和角度分辨率以提高精确度
另外 如果目标离得近 那么不同轮廓的两个点无论是距离还是角度一定是较大的 所以在设计时 应该保证最大距离范围内也能分辨得到才行
分辨力
假设一个长度为10的物体 我需要测到两个点才能认为是一个目标 那么距离分辨率为10肯定是不行的
如果距离分辨率为5 那么有可能其中一个点刚好在目标的中间 也只能测到一个点(虽然大概率都是两个点)
一般用配置值x1.68来进行计算 比如分辨率为3 那么分辨力就是1.683=5.04 还是不能保证每距离5就有一个检测点
另外 如果目标有相对小范围的移动 多次采样是可以提高精度的 比如采样10次有9次都满足 那么算法上可以认为就被检测到了
chirps数
chirps数按理说不算雷达参数里的 但也决定了雷达的性能
所谓chirps 就是在同一帧内多次发送雷达波来进行测量
增加chirps数 可以有效增加目标的能量 并降低噪音
比如前面提到的TX的MIMO模式 就是在不同的chirps中开启不同的TX 每个TX位置不同 每个chirps测量的数据就不同 那么就可以通过算法过滤出能量最强的目标
但对于移动速度过快的目标 每个chirps测量出来的位置和结果都不一样 那么这个时候就需要缩短chirps的周期时间或者在算法上进行优化 甚至减少chirps数
所以chirps数也不是越多越好
MIMO
通过时分复用(TDM-MIMO)、频分复用(BPM-MIMO)的方式可以进行雷达TX发射
时分复用即不同时间用不同的TX去发射
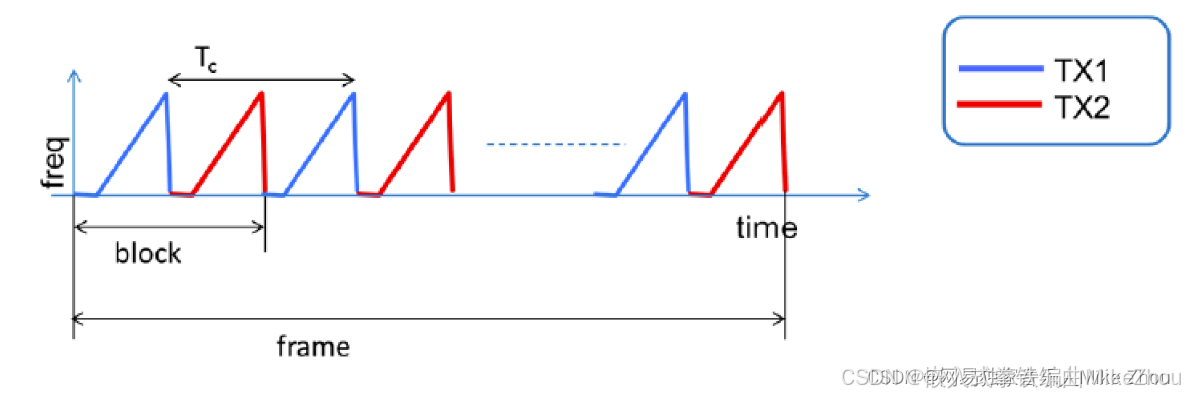
频分复用则在同一时间用多个TX去发射(不同发射天线通过相位编码进行区分(正交))
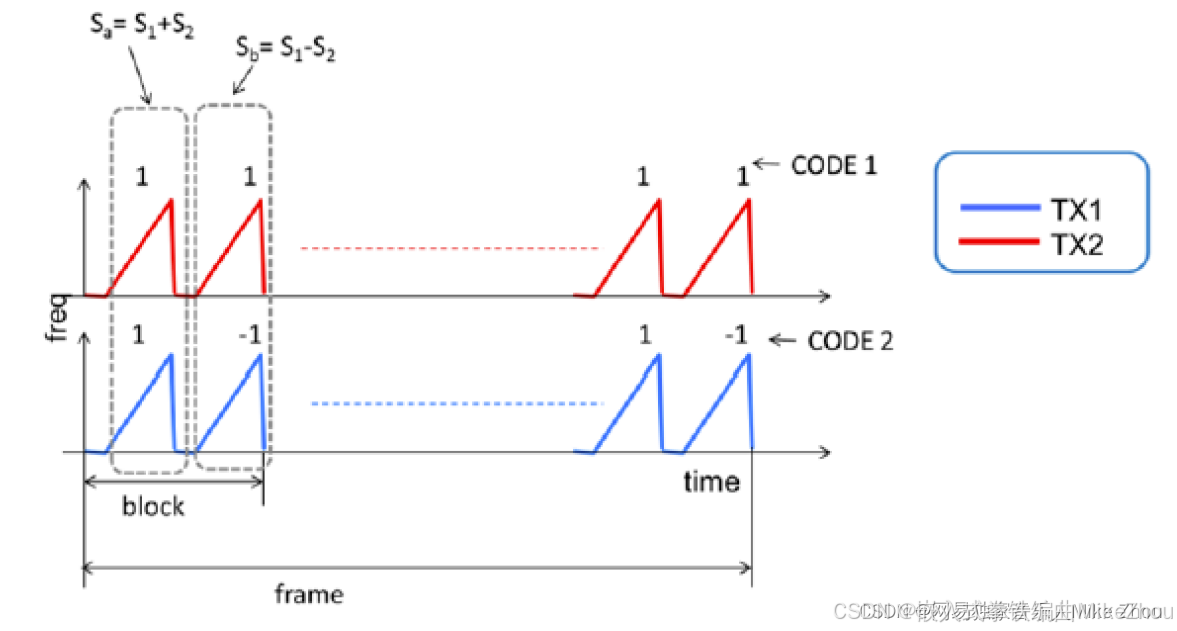
由于TX位置不同 能有效提高分辨力
利用FFT测量的原理
对某一帧中的某一个chirp的某一个rx的数据求fft 得到距离(即某一时刻对一个rx的fft)
对某一帧中的某一个rx的所有同族chirps的数据求fft得到速度(即某一帧过程中 一个rx的数据 在同族chirps中的变化求fft)
对某一帧中的某一个chirp的多个同类rx求fft得到角度(即某一时刻 多个同类rx中的数据求fft)
在时间尺度上 对距离结果求FFT 可以求出距离的变化频率 进而得到心率 呼吸速率等
DBSCAN点云聚类算法
通过定义邻域半径和核心点数来定义一个簇
领域半径越大 目标越大
若设置过小:会将连续区域误分为多个小簇
若设置过大:会将多个独立簇合并
核心点数越大 需要的点越多
若设置过高:只有极高密度区域会被识别为簇
若设置过低:噪声点可能被误认为簇
CFAR动态门限
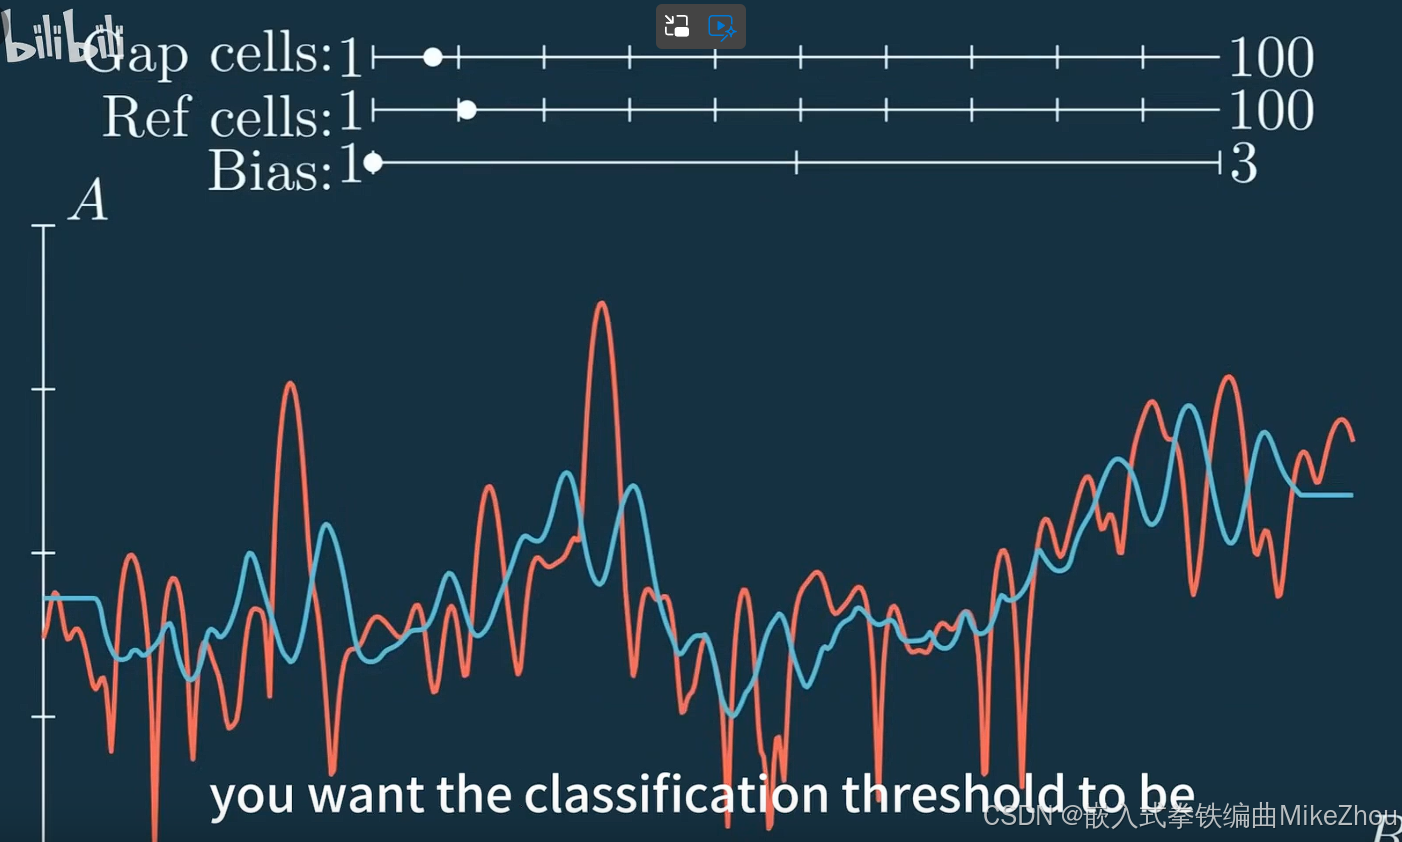
动态门限
对给定点 取其两边的范围 进行动态平均化 求得一个门限
超过门限则为目标点
Gap cells: 反应细节程度 面对小宽度目标 要给小 大宽度目标 要给大
Ref cells:作平均值时的宽度 越大越接近算术平均值
Bias: 增益
软件开发
可以单独使用MSS来进行开发 也可以MSS DSS协同开发
整体上采用TI-RTOS来进行开发
MSS主要负责控制、通信 而DSS主要用于算法处理
二者通过Mailbox进行信息交流
gMmwMssMCB.peerMailbox = Mailbox_open(MAILBOX_TYPE_DSS, &mboxCfg, &errCode);
Mailbox_write (gMmwMssMCB.peerMailbox, (uint8_t*)message, sizeof(MmwDemo_message));
通过Mailbox接收中断来post信号量 以此控制线程的同步 并读取Mailbox
Semaphore_pend(gMmwMssMCB.mboxSemHandle, BIOS_WAIT_FOREVER);
retVal = Mailbox_read(gMmwMssMCB.peerMailbox, (uint8_t*)&message, sizeof(MmwDemo_message));
在MSS中 同MMWave API来进行雷达配置
也可以直接移植CLI中的配置函数来进行
一个普通的开发方式是:
通过配置ADCBuf来获取雷达数据
采集到的雷达数据通过SOC监听后进入回调 并将数据通过Address Translate翻译出来
然后再获取数据
但是也可以配置Datapath(类似DMA)使其自动将数据转移
通常 数据处理都由DSS来完成 MSS只需要配置、解析DSS数据、输出
5. 传感器、外部芯片开发
ADXL系
ADXL363 ADXL357 ADXL345等
用于测量姿态、加速度方向
为了保证每次数据的整合性(XYZ三个数据值必须是同一个测量周期下的)
所以应配置为单次测量模式
并采用中断的测量方式测量

得出数据后 通过卡尔曼滤波缩小方差
若使用XYZ三个数据分开滤波
滤波后再进行整合 可能导致三个方向之和大于1
所以也可以整合后再进行滤波
EEPROM
常见Flash如SPI协议W25Q128、I2C协议的M24C32等

擦除时 以扇区为单位 也就是256*16=4096个字节
W25Q128的寄存器地址有24位
读操作:发送读命令0x03 发送地址 返回读取的字节
擦除操作:发送写使能0x06 等待空闲 发送0x20 发送地址 等待空闲
写操作:先进行擦除操作 然后发送写使能0x06 发送页写命令0x02 发送地址 发送数据字节 等待空闲
每次操作前 最好都读一下状态寄存器 以保证芯片为空闲
OV2640
OV2640通常可选择RGB565格式 传输8位、10位数据
为契合STM32的DMCI协议 可以配置为8位传输
若选择8位传输 则引脚选择Y2至Y9
其配置通过SCCB协议完成 兼容I2C协议
可配置数据格式、PCLK频率、帧率、分辨率大小 MSB、LSB等
在RGB565格式下 数据定义为:

PMIC
以AD5421为代表的4-20mA
以LP87524、LP87702为代表的BUCK电源
具有延时上电控制模式、低功耗、中断、WDT等
可通过寄存器或引脚共同作用开启BUCK
如LP87524:
#define LP87524_BUCK0_CTRL1 0x02 //写入0x34,bit7控制开启
#define LP87524_BUCK1_CTRL1 0x04 //写入0x44,bit7和EN1控制开启
#define LP87524_BUCK2_CTRL1 0x06 //写入0x54,bit7和EN2控制开启
#define LP87524_BUCK3_CTRL1 0x08 //写入0x64,bit7和EN3控制开启
HC05蓝牙
通过AT指令配置蓝牙信息
1.测试指令:发送AT,得到回应OK
2.获取软件版本号:发送AT+VERSON,得到版本号
3.获取蓝牙地址:AT+ADDR,获得蓝牙地址
4.配置蓝牙模块名称:AT+NAME=“(名称)”
5.配置密码:AT+PSWD=(密码)(4位)
6.配置主从模式:AT+ROLE=0或1(0为从模式,1为主模式)
配置后 即可在移动端连接蓝牙
通过串口与MCU连接 从而发送数据
协议栈可由软件实现

GNSS
定位芯片如移远L76C等
通过串口字符串进行通信
支持WSG84、GCJ02等格式
如果使用GCJ02,则需要转换为WSG84格式才能精确得到坐标
转换为球形坐标系后 可求三点定位
记录定位信息可以转换为类似xml文件的GPX文件
其基本格式同xml、html相似
关键字为:
海拔:ele
时间:time
心率:heartrate
功率:power
踏频:cadence
距离:distance
通过弧度求解 可以算出每个点的速度等信息
6. RTOS
多线程基本
为了能在一个CPU下运行多个任务 引入多线程概念
在C中 使用pthread库
在Python中 则使用threading库
最常见的线程锁就是Mutex 基本上各类多线程都会将其实现
Mutex不能在中断中使用 因为其会导致线程的休眠
在MCU中 通常使用系统定时器来设立RTOS的心跳
也就是每次产生系统时钟中断时 进行任务调度
对于裸机开发 可以使用定时器中断来模拟多线程 而不用移植多线程库
但对于比较复杂的项目 则必须要使用RTOS
在移植RTOS时 需要注释掉中断服务函数(中断由RTOS接管) 或关闭系统中断
FreeRTOS
一般通过SYSTICK来支持心跳
FreeRTOS是硬件上的系统移植 其根据不同架构调用了硬件底层中断 systick等外设 以实现任务调度
FreeRTOS移植时 要注意不同架构的Config文件不同
在同一架构示例的工程中 拷贝FreeRTOSConfig.h到移植工程中
另外还要根据架构来导入port.c文件
有的国产MCU如APM32F407 虽然完全对标STM32F407 但其架构阉割 在移植FreeRTOS时 要选择M3架构的
并选择导入heap_4.c文件(用于内存管理 这个比较常用)
使用该内存管理方式 会自动分配和释放内存,并合并内存碎片
移植后 使用xTaskCreate建立线程 并通过vTaskStartScheduler开启任务调度
另外 注意中断位数是否匹配 否则引起vTaskStartScheduler卡死
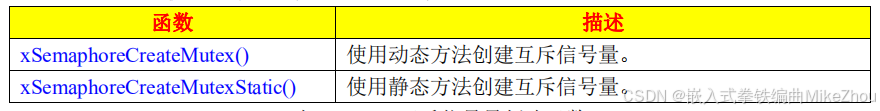
在FreeRTOS中 信号量与互斥量整合一起
使用xSemaphoreCreateMutex来建立互斥量
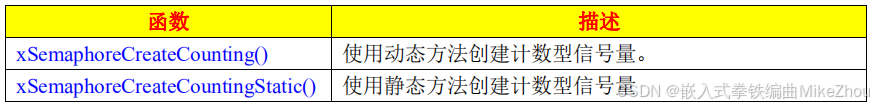
而信号量的创建则使用xSemaphoreCreateCounting函数
二值信号量和互斥锁
另外还有一种信号量 二值信号量xSemaphoreCreateBinary();
类似于互斥锁 但是区别在于:
使用场景
互斥锁:适用于需要确保资源独占访问的场景,例如保护全局变量或共享设备。互斥锁通过优先级继承机制避免优先级反转问题,确保高优先级任务能够及时获取资源。
二值信号量:适用于需要任务间同步的场景,例如中断服务程序与任务之间的同步。二值信号量通过中断触发事件,任务在获取信号量后执行相关操作。
二值创建时初始值为0 互斥锁是1
所以创建后 信号量必须先give 然后才能获取 否则获取不成功
而互斥锁一开始就能被获取
信号量速度快于互斥锁;
二值信号量不支持优先级继承,锁支持并且解决优先级反转问题
互斥锁适合保护长时间运行的代码块,二值信号量适合任务间的简单同步;
二值信号量不可以递归,同一个任务对同一个二值信号量的获取操作将会导致该任务被挂起;
递归互斥锁允许任务在已经持有互斥锁的情况下再次获取该互斥锁;
优先级反转问题解决
二值信号量会有任务优先级翻转的问题:ABC三个任务,依次越低优先级;C先运行拥有信号量,使用途中还没释放信号量,被B抢占,B开始运行,B运行一段时间后,A运行抢占B,但是A等待信号量,A阻塞;B继续运行,B运行完,C运行,C释放信号量,A运行,A运行完,C再运行。
将信号量换成互斥锁 则在A获取互斥锁时 就会等待C持有互斥锁 并将C的优先级跳高为A
任务切换
任务分成以下几个状态:
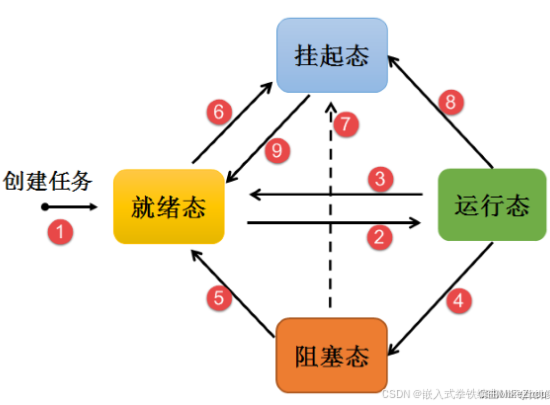
进行任务切换时 通过ISR中断进行调度
每个任务在创建时 都会分配模拟栈 模拟栈除了函数所用的临时变量外 还需要保存任务的基础寄存器(R0-R15寄存器) 以及相关人物属性
任务切换时 通过PenSV或SVC服务(新版本都是用PenSV)
该服务会自动保存R0-R15寄存器(上下文) 特别是R15的MSP(或PSP)寄存器 用于指引代码跑到哪个地方
在任务切换时 就会将相关寄存器内容保存在模拟栈里面
其中 SysTick用于时间片轮询调度 在调度时 若有任务切换请求 就会转到PenSV或SVC中断 并将寄存器值压入各类任务栈中 且LR被赋值为特殊值EXC_RETURN
恢复任务时 则是从任务栈中先获取寄存器值 再接着跑
TI-RTOS
TI-RTOS支持大部分TI官方的MCU、DSP
需要进行TI的SYS/BIOS移植才能使用TI-RTOS
在移植时 注意要先进行硬件初始化 但要关闭系统中断
并使用BIOS_start()开启任务调度
移植时 需要导入cfg文件 并对其进行配置
所有的中断都由cfg中导入的hwi模块进行控制
如:
var ti_sysbios_hal_Hwi10Params = new ti_sysbios_hal_Hwi.Params();
ti_sysbios_hal_Hwi10Params.instance.name = "Hwi_spiA_RX";
Program.global.Hwi_spiA_RX = ti_sysbios_hal_Hwi.create(72, "&sysbios_HWI_spiA_RXISR", ti_sysbios_hal_Hwi10Params);
在cfg中需要指定系统时钟频率的大小
BIOS.cpuFreq.lo = 100000000;
时钟则通过cfg文件来指定
如:
ti.sysbios.knl.Clock.tickSource = Clock.tickSource_USER
对于线程安全 支持信号量、事件、队列、Mailbox(还可以用来发送数据)
函数分别为:
Semaphore_create:
系统中通过 Semaphore_pend(),与 Semaphore_post()两函数对信号量进行获取与释放
Event_create:
SYS/BIOS 中事件请求与发布是通过 Event_pend(),Event_post()函数进行
Queue_create:
不常用
Mailbox_pend()用于等待来自邮箱的邮件 Mailbox_post()用于向邮箱发送邮件
此外 可以通过write和read函数来读取邮件的信息
在接收到邮件时 进入邮件中断 常用信号量来进行post操作 而非使用Mailbox
在TI-RTOS中 常用Task_sleep进行演示操作
7. Qt和LVGL
Qt
Qt开发大量使用类的方式来进行
其功能函数则通过信号槽来进行连接
如果用Qt Creator直接生成代码 其会生成对应的moc文件
如果要删除相关槽函数 需要在其中手动删除 避免槽函数未定义连接
槽函数连接中 使用connect函数
其传参为 A类 A的信号 B类 B的槽函数 链接方式
在链接槽函数时 支持传参 仅传入要传的参数类型即可
如:
connect(this, SIGNAL(startWork(QString)), worker, SLOT(Judg_doWork(QString)));
同样 在发送信号时 也要进行传参
emit this->startWork("text");
其中 链接方式中 链接方式共有五种 分别为:
enum ConnectionType {
        AutoConnection,
        DirectConnection, //相当于直接调用函数
        QueuedConnection,  //信号和槽函数不再同一个线程中,当发送信号的线程发送信号后立即执行下面的代码,发送的信号会放到另一个线程的信号队列中等待获取执行,相当于非阻塞模式
        BlockingQueuedConnection,  //信号和槽函数不再同一个线程中,当发送信号的线程发送信号后阻塞执行下面的代码,发送的信号会放到另一个线程的信号队列中等待获取执行,相当于阻塞模式
        UniqueConnection =  0x80  //不能单独使用 要与其他链接方式共同作用 主要使信号发送者和接受者有唯一的连接。防止多次调用connect形成重复关联。一旦形成重复关联,信号一旦发射,就会有对应的槽函数多次执行
    };
其中 默认为AutoConnection
系统会根据发射信号的线程和接收槽函数的线程自动选择合适的连接方式。如果信号和槽函数在同一线程中,采用直接连接,否则采用队列连接
为了使其在不同的线程中运行(如串口、多线程定时等) 则应使用QueuedConnection
子线程在操作主线程控件时(如更改GUI的某个控件内容) 最好用槽函数的方式链接 并且使用QueuedConnection
在Qt定时器中 共有两种方式进行开发
QTimer 和 timerEvent
相关操作不同的点在于:
QTimer采用槽函数链接 timerEvent则采用虚函数回调
绘图上 采用QPixmap画布及mouseEvent事件监控输入
每次更新画布时 需要调用paintEvent事件下的函数进行刷新
这两个事件都是位于QWidget下的虚函数
所以画布是继承QWidget的
在多线程开发中 使用QMutex可以做到线程同步
最简单的线程开发即为QThread的run函数
而建议的方式则是继承QObject类 然后将整个类moveToThread到一个QThread线程中
使用QThread::sleep()会导致线程阻塞 建议使用QElapsedTimer 和QCoreApplication::processEvents则不会阻塞线程
为了能够将定时器移动到一个线程中执行 定时器必须使用moveToThread移动到线程中
可以创建一个继承QObject的类 来进行操作
同时 将这个大类也移动到同一个线程中执行
通过信号槽来连接QThread的started()信号与定时器的start()函数来进行定时器开启
调用停止函数后 则在此线程中运行Judg_doWork函数 停止定时器 将Flag置位
结束时 使用QCoreApplication::processEvents();来进行等待且不会使主线程卡死
同理 在进行多线程的等待和循环判断时 也应使用QCoreApplication::processEvents();
如:
void GUI_Delay_Judge(uint16_t ms)
{
    QElapsedTimer t;
    t.start();
    while(t.elapsed()<ms && GUI_Status<4)
    {
        QCoreApplication::processEvents();
    }
}
在QMainWindow下有个setCentralWidget函数
该函数可以将控件居中并填充至整个widget
如果要操作QWidget的模块居中 则需要将定义的继承QWidget改成继承QMainWindow
对于QSerialPort 建议是将RX和TX都放在一个多线程中去执行
多线程接收则直接创建一个多线程任务即可
对于多线程发送:
Qt官方明确说明了 为了安全 针对外设进行操作的库 比如串口 都一律禁止使用多线程发送方式
虽然在子线程中调用串口发送可以正常使用 但会产生一次警告性质的报错:
QObject: Cannot create children for a parent that is in a different thread.
所以不得使用多线程进行串口发送
但也有解决方案:
方案一:主线程中设置一个定时器用于原子变量监控 检测到flag发生改变时 表示子线程有串口发送需求 进而发送
方案二:子线程操作一个控件 如textEdit 当textEdit 被改变时 触发信号 进而在主线程中调用发送函数
这样一来 可以实现在子线程中 操作主线程的控件 主线程通过任务调度控制串口发送
而子线程在操作主线程控件时 最好用槽函数的方式链接 并且使用QueuedConnection
LVGL
移植LVGL需要两个步骤:
- 定义一个心跳
- 绑定显示、触摸等函数
LVGL靠软件来进行任务调度和轮询 实际上类似软件多线程
建立两个定时器线程 一个1ms 一个5ms 分别调用lv_tick_inc(1);和lv_timer_handler();
当然 有硬件定时器更好
void timer0_callback(void * pCBParam,uint32_t Event,void * pArg)
{
    lv_tick_inc(1);
}
void timer1_callback(void * pCBParam,uint32_t Event,void * pArg)
{
    lv_timer_handler();
}
绑定显示触摸函数时 只需要定义好触摸状态、触摸坐标、画点函数即可
当然 如果能直接画线、画面则能大大加强帧率
对于显示函数 LVGL提供了三种缓存方式 如果采用一级缓存 则只需要定义一个显示函数

对于应用 lv_btn_create用于创建按钮 并使用lv_obj_add_event_cb绑定事件
用lv_label_create来创建标签
帧率信息显示在:
lv_conf.h中第282行,找到:LV_USE_PERF_MONITOR,原值:0, 修改为:1
内存显示则在:
lv_conf.h中第289行,找到:LV_USE_MEM_MONITOR,原值:0, 修改为:1
8. Linux驱动
交叉编译
编译ARM内核需要交叉编译器
arm-none-linux-gnueabihf-gcc
同时需要目标ARM板子的Linux系统内核环境
并编译内核:
make ARCH=arm CROSS_COMPILE=arm-none-linux-gnueabihf- stm32mp1_atk_defconfig
make ARCH=arm CROSS_COMPILE=arm-none-linux-gnueabihf- uImage vmlinux dtbs LOADADDR=0xC2000040 -j4
make ARCH=arm CROSS_COMPILE=arm-none-linux-gnueabihf- stm32mp1_atk_defconfig
make ARCH=arm CROSS_COMPILE=arm-none-linux-gnueabihf- modules -j4
如果是第一次编译 则可能有所不同 需要根据实际手册来
每次编译时 需要连接到内核再编译
编译前要配置环境变量:
source /etc/profile
需要先在此文件中 指定内核环境所在目录
Makefile
KERNELDIR := /home/alientek/linux/atk-mp135/linux/my_linux/linux-5.15.24
CURRENT_PATH := $(shell pwd)

obj-m := test.o

build: kernel_modules

kernel_modules:
	$(MAKE) -C $(KERNELDIR) M=$(CURRENT_PATH) modules

clean:
	$(MAKE) -C $(KERNELDIR) M=$(CURRENT_PATH) clean
然后执行编译
make ARCH=arm CROSS_COMPILE=arm-none-linux-gnueabihf-
Linux应用
文件
通过read、open、write等进行普通IO下的文件操作
常用于驱动的应用
或通过标准IO定义的FILE下的库函数 fread、fwrite、fopen进行操作
常用于文件的应用
信号
注册信号:
#include <signal.h>
typedef void (*sighandler_t)(int);
sighandler_t signal(int sig, sighandler_t handler);
发送信号至进程:
int kill(pid_t pid, int signo);
驱动安装
将编译好的驱动推荐放置到ARM板子的/lib/modules/<kernel-version>目录下
加载驱动:
insmod test.ko 或 modprobe test.ko
建议用modprobe 原因是可以解决依赖关系

查看已安装的模块:
使用lsmod或cat /proc/devices查看 其中 还能看到已安装的驱动设备号(新安装的不能重复)
最后如果不需要了 则卸载
卸载模块:
rmmod test 或 modprobe -r test
建议在安装或卸载驱动后 使用sync命令可以同步内核
同样 安装设备树文件、修改内核 同理
修改设备树文件后 必须调用此命令
字符驱动
驱动开发主要就是实现驱动入口、出口函数 然后用以下语句注册驱动:
module_init(led_init);
module_exit(led_exit);
MODULE_LICENSE("GPL");
MODULE_AUTHOR("ALIENTEK");
MODULE_INFO(intree, "Y");
新字符驱动可以自动生成设备树文件等 比较方便、
在 Linux 中使用 cdev 结构体表示一个字符设备,cdev 结构体在 include/linux/cdev.h 文件中
里面包含了file_operations 结构体 以及dev_t 变量等等
定义了cdev变量后 需要进行初始化cdev_init并传参file_operations变量
其中的.owner都要为THIS_MODULE
如:
创建字符设备驱动时 需要使用cdev_init来创建设备 并传入fops结构体
结构体中 实现字符设备驱动的相关函数 其中open 、release 必须实现
/* 设备操作函数 */
static struct file_operations newchrled_fops = {
	.owner = THIS_MODULE,
	.open = led_open,
	.read = led_read,
	.write = led_write,
	.release = 	led_release,
};

cdev_init(&newchrled.cdev, &newchrled_fops);
初始化后 使用以下函数往cdev中添加dev设备号变量
这里要注意 虽然cdev中有dev变量 但不能直接赋值 需要使用cdev_add函数来添加
新字符设备驱动安装时 能够自动申请驱动号(也可定义)
块设备和platform(平台总线)驱动
块设备面向存储,platform面向SoC外设
platform实现硬件抽象,便于移植
块设备
块设备驱动用于管理以固定大小数据块为单位进行读写的存储设备,如硬盘、SSD、U盘等。
数据块为单位:以512字节、4KB等固定大小的块进行读写
缓存机制:内核提供页面缓存(page cache)优化性能
随机访问:支持任意位置的读写操作
缓冲I/O:数据先经过内核缓冲区
struct block_device_operations {
    int (*open)(struct block_device *, fmode_t);
    int (*release)(struct gendisk *, fmode_t);
    int (*ioctl)(struct block_device *, fmode_t, unsigned, unsigned long);
    int (*getgeo)(struct block_device *, struct hd_geometry *);
    // ...
};

struct gendisk;
struct request_queue;
开发方式:
分配gendisk结构
设置设备容量和操作函数
创建请求队列(request queue)
注册块设备到系统
platform
Platform总线是虚拟总线,用于连接片上系统(SoC)中的各种外设,如GPIO、I2C控制器、定时器等。
驱动模型组成:
Platform Device(平台设备):
描述硬件资源(内存地址、中断号等)
通过设备树(Device Tree)或ACPI描述
Platform Driver(平台驱动):
实现设备的具体操作函数
通过probe()函数初始化设备
struct platform_driver {
    int (*probe)(struct platform_device *);
    int (*remove)(struct platform_device *);
    struct device_driver driver;
    // ...
};

struct platform_device {
    const char *name;
    int id;
    struct resource *resource;
    // ...
};
地址映射,虚拟内存和硬件内存地址
Linux设备如果最后要操作寄存器进行开发的话 不可避免的会使用内核寄存器
Linux设备如今大多已支持直接从硬件地址读写 但不建议直接采用
对于安装了MMU的设备 可以通过MMU映射到虚拟内存地址 然后对虚拟内存读写后内核则进行物理地址操作
ioremap 函数用于获取指定物理地址空间对应的虚拟地址空间
void __iomem *ioremap(resource_size_t res_cookie, size_t size);
卸载则用:
void iounmap (volatile void __iomem *addr)
Linux设备最好是通过虚拟内存来访问 并且用以下的几组函数来操作内存
使用 ioremap 函数将寄存器的物理地址映射到虚拟地址以后,我们就可以直接通过指针访问这些地址,但是 Linux 内核不建议这么做,而是推荐使用一组操作函数来对映射后的内存进行读写操作。
读:
 u8 readb(const volatile void __iomem *addr)
 u16 readw(const volatile void __iomem *addr)
 u32 readl(const volatile void __iomem *addr)
写:
 void writeb(u8 value, volatile void __iomem *addr)
 void writew(u16 value, volatile void __iomem *addr)
 void writel(u32 value, volatile void __iomem *addr)
devmem命令
Linux中可以通过devmem命令来进行物理寄存器操作
其命令格式为:
读:
devmem [ADDR] [长度]
写:
devmem [ADDR] [长度] 内容
如:
devmem 0x5000A000 32 0x12345678
设备树节点
通过OF函数可以实现对设备树中的设备节点的读取
如of_property_read_u32_array函数可以实现读取reg 等属性
另外 还可以通过不同的方式(如通过姓名)查询节点信息:
struct device_node *of_find_node_by_name(struct device_node *from,
										const char *name);
struct device_node *of_find_node_by_type(struct device_node *from, const char *type)
struct device_node *of_find_compatible_node(struct device_node *from,
											const char *type,
											const char *compatible)
struct device_node *of_find_matching_node_and_match(struct device_node *from,
													 const struct of_device_id *matches,
													 const struct of_device_id **match)
或者父子节点:
struct device_node *of_get_parent(const struct device_node *node)
struct device_node *of_get_next_child(const struct device_node *node,
 									 struct device_node *prev)
在设备树里面 pinctrl节点用于操作GPIO
pinctrl节点展示了GPIO的相关配置、内容
有GPIO控制节点的设备 设置好设备树以后就可以使用 gpio 子系统提供的 API 函数来操作指定
的 GPIO
对于GPIO操作 同样也有对应的API在gpio.h下
涉及到的设备节点操作of函数库为of_gpio.h
GPIO操作函数如下:
int gpio_request(unsigned gpio, const char *label)
void gpio_free(unsigned gpio)
int gpio_direction_input(unsigned gpio)
int gpio_direction_output(unsigned gpio, int value)
#define gpio_get_value __gpio_get_value
int __gpio_get_value(unsigned gpio)
#define gpio_set_value __gpio_set_value
void __gpio_set_value(unsigned gpio, int value)
相关OF函数如下:
int of_gpio_named_count(struct device_node *np, const char *propname)
int of_gpio_count(struct device_node *np)
int of_get_named_gpio(struct device_node *np,
					 const char *propname,
					 int index)
内核时钟
系统本身是由MCU中的定时器提供时钟频率的
在 Cortex-A7 内核中有个通用定时器 相关配置可以看内核文档Cortex-A7 Technical ReferenceManua.pdf
硬件定时器提供时钟源,时钟源的频率可以设置, 设置好以后就周期性的产生定时中断,系统使用定时中断来计时
系统频率是可以设置的
通过内核编译前进行设置:
make ARCH=arm CROSS_COMPILE=arm-none-linux-gnueabihf- stm32mp1_atk_defconfig
make ARCH=arm CROSS_COMPILE=arm-none-linux-gnueabihf- menuconfig
Linux 内核使用全局变量 jiffies 来记录系统从启动以来的系统节拍数,系统启动的时候会
将 jiffies 初始化为 0,jiffies 定义在文件 include/linux/jiffies.h 中,定义如下:

同时 可以通过以下函数来进行超时判断

jiffies是节拍数 所以jiffies/频率(HZ)就是秒 反之 秒数*频率就是节拍数
为了方便开发,Linux 内核提供了几个 jiffies 和 ms、us、ns 之间的转换函数:

所以说 jiffies 可以作为一个时间戳进行判断 不用当心绕回(溢出) 因为时间很久
通过这些函数 使其能够实现时间戳读取、延时等函数
驱动层也可以直接通过mdelay、udelay、ndelay来进行延时
对于内核定时器
相关操作库为timer.h
这里操作的定时器为系统内核层面的定时器 而非裸机开发中的某个定时器
要使用内核定时器首先要先定义一个 timer_list 变量,表示定时器,tiemr_list 结构体的expires 成员变量表示超时时间,单位为节拍数。比如我们现在需要定义一个周期为 2 秒的定时器,那么这个定时器的超时时间就是 jiffies+(2*HZ),因此 expires=jiffies+(2*HZ)。function 就是定时器超时以后的定时处理函数,我们要做的工作就放到这个函数里面,需要我们编写这个定时处理函数,function 函数的形参就是我们定义的 timer_list 变量。
在这个回调函数里面 可以继续赋值expires 使其周期性运行
所以常用的只需要用timer_setup、mod_timer、del_timer即可操作
中断、上半部和下半部
通过request_irq
函数可以申请中断
其中 中断服务函数是一个回调
中断标志flag则有:

name:中断名字,设置以后可以在/proc/interrupts 文件中看到对应的中断名字
最后的dev是一个指针 可以定义成结构体 用来判断设备或传参
如果使用的是共享中断 dev就是用来区分的方式
request_irq 函数会默认使能中断
另外 释放中断则是free_irq
中断服务函数原型为irqreturn_t (*irq_handler_t) (int, void *)
使用函数enable_irq、disable_irq操作中断开关
disable_irq函数会等待中断完成以后才返回
在等待期间不能产生新的中断
而使用disable_irq_nosync则能立即返回
中断通常需要快速返回
而将耗时的任务放在主线程中执行
中断服务函数为上半部 耗时的任务放在下半部中执行
实现下半部可以用软中断( softirq_action)、tasklet、工作队列( work_struct)来实现
同样 设备树节点也支持中断开发 对应的就是irq的of函数
多线程驱动安全
原子变量结构体为atomic_t类型 初始化则为ATOMIC_INIT方法:
atomic_t b = ATOMIC_INIT(0); //定义原子变量 b 并赋初值为 0
操作函数有:

这里的原子操作 多作为一个变量用于内核中的状态判定 但也可以作为一种普通变量来使用
其操作方式与普通变量的区别为:
在C语言中 给一个变量赋值 会转成三句汇编
比如 a=3
实际上就是:
ldr r0, =0X30000000 /* 变量 a 地址 */
ldr r1, = 3 /* 要写入的值 */
str r1, [r0] /* 将 3 写入到 a 变量中 */
而如果有两个线程同时调用了a这个变量 则可能在这两个线程中的汇编语句交替执行 导致赋值错误

但如果使用原子变量 并通过原子变量API来进行操作 则可以将每次调用时的语句完全执行完后才能执行另外一个线程的调用
其实相当于:
mutex.lock();
a=3;
mutex.unlock();
但本身要方便得多 占用资源也少 只需要一行API函数即可
对应的还有原子位操作(只操作一位)

自旋锁的定义类型为spinlock_t 其实与互斥锁大同小异
但是互斥锁在锁住占用时 线程可以进行休眠(CPU可以进行其他的任务调度 直到被其他线程解锁后使用)
自旋锁则是使线程原地等待 相当于while(flag)
所以 中断中可以使用自旋锁
但使用自旋锁的时间不宜过长 因为while(1)本身会极度占用系统资源
自旋锁执行后 不能调用任何可以引起休眠的函数 也不能递归自己锁自己 避免死锁
在中断中使用自旋锁要避免死锁发生 所以在自旋锁上锁时 可以调用以下API来关闭中断

使用rwlock_t类型的读写锁可以防止重复读写的操作
但读写锁的读写没法同时工作 用顺序锁可以解决这个问题
其结构体变量为seqlock_t
信号量的定义为semaphore
互斥锁定义为mutex
如果在中断中要进行上锁操作 那么需要注意以下几点
自旋锁、原子变量可以在中断中使用
自旋不会使中断休眠 而原子变量本身都不算是一个锁
但中断中不要使用信号量和互斥锁的上锁功能
如果在中断中因为上锁而被占用 则中断直接休眠 完全无法退出
异步通知(进程通信)
相对于驱动中的信号 由驱动向应用层发送的信号
若要使用信号 则需要定义一个 fasync_struct 结构体指针变量
需要在设备驱动中实现 file_operations 操作集中的 fasync 函数,此函数格式如下所示
当设备可以访问的时候,驱动程序需要向应用程序发出信号,相当于产生“中断”。kill_fasync函数负责发送指定的信号
应用程序接收驱动信号同样需要通过signal函数来注册
然后使用 fcntl(fd, F_SETOWN, getpid())将本应用程序的进程号告诉给内核。
最后开启异步通知
flags = fcntl(fd, F_GETFL); /* 获取当前的进程状态 */
fcntl(fd, F_SETFL, flags | FASYNC); /* 开启当前进程异步通知功能 */
通过 fcntl 函数设置进程状态为 FASYNC,经过这一步,驱动程序中的 fasync 函数就会执行
譬如:
signal(SIGIO, sigio_signal_func);
fcntl(fd, F_SETOWN, getpid()); // 将当前进程的进程号告诉给内核
flags = fcntl(fd, F_GETFD); // 获取当前的进程状态
fcntl(fd, F_SETFL, flags | FASYNC); // 设置进程启用异步通知功能
接收到SIGIO信号时 执行sigio_signal_func
9. 通讯协议、物联网、DSP及FatFS文件系统
通讯协议
一般由串口协议来完成上位机/下位机之间的通信
通常将接收放在串口中断中完成 并判断状态机
解析则在主线程中完成
除自定的协议外 就是HART协议了
HART协议是作用在4-20mA 12-24V双线下的
其电流大小可以表示数值的大小
电流由AD5421控制
HART协议的调制解析则由AD5700完成
其协议栈实现了长短结构、主从结构、命令响应、先导码等
常用于工业仪表领域

其频率对应关系为 2200Hz表示0 1200Hz表示1
HART调制解调芯片的波特率一般为1200 奇校验
物联网
移远的物联网EC800M板底层采用RTOS开发 实现了移远Python解释器
支持SIM卡、MQTT协议、requests、GNSS等
其中 MQTT协议支持腾讯云的API包
另外也支持串口、PWM、GPIO、定时器等硬件外设
同样 也有支持AT指令版本的SDK
DSP
TI的常见DSP如毫米波雷达C6000系列 或C2000系列
而C2000是用的最多的DSP
在C2000上移植SYS/BIOS 使其能够运行System_printf等函数外 还可以通过TI-RTOS进行多线程开发
但是要注意移植后关闭系统中断
C2000的SCI外设与UART基本一致 但是多了一个Address模式

也就是多了一位地址位 该模式可以在SCI_setAddrMultiProcessorMode中开启
若不开启 就是普通模式


在使用时 可以直接当作UART来使用
发送有好几种方式 最常用的是SCI_writeCharArray和SCI_readCharArray
也就是阻塞发送和接收
FatFS文件系统
文件系统在CubeMX中可以配置移植

修改以支持中文字符
修改MAX_SS为2048(496的一个页面是2K)
这里MAX_SS只能选择512 1024 2048 4096 其对应的就是格式化中的“分配单元大小”
也就是规定其最小操作单元为2048
另外要打开RTC 以配置日期获取函数
CubeMX生成代码后 需要在工程中进行配置
导入用户文件:

导入外设中的FatFS库文件

其中 user_diskio.c是CubeMX生成的 其函数被 diskio.c调用
如果手动移植FatFS则需要直接修改 diskio.c
在 user_diskio.c中 需要定义好相关的Flash操作函数 即write、read、ioctl、初始化驱动函数
其实现的作用与Linux驱动类似
另外 注意修改堆栈大小 以支持至少一次擦除一页的内存空间
获取时间函数则在fatfs.c中定义
驱动移植好后 即可通过FatFS的API实现挂载、读写等应用层函数的封装
如可定义:
void FatFS_Init(void);
void FatFs_GetDiskInfo(void);
void FatFs_ScanDir(const TCHAR* PathName);
void FatFs_ReadTXTFile(TCHAR *filename);
void FatFs_WriteTXTFile(TCHAR *filename,uint16_t year, uint8_t month, uint8_t day);
void FatFs_GetFileInfo(TCHAR *filename);
void FatFs_DeleteFile(TCHAR *filename);
void FatFs_PrintfFileDate(WORD date, WORD time);
采用f_mount挂载 f_mkfs格式化 其工作区和工作区大小 以及分配单元大小都要与实际配置的擦除单元大小对齐
其API函数与C应用类似 常用函数有f_gets、f_open、f_read、f_write、f_close、f_mkdir等
更多推荐

 13
 0
- 0


 已为社区贡献1条内容

所有评论(0)