
神经网络基础(三)
目录
前面的文章 神经网络基础(一)讲了神经网络和深度学习的概念,神经网络基础(二)讲了神经网络的训练流程并补充了激活函数和损失函数的知识。在这篇内容中,我们要学习的是,如何用代码来实现神经网络的训练过程。
一、模拟前向传播
大家看下,假如我们有如下的一个神经网络,共分为4层:
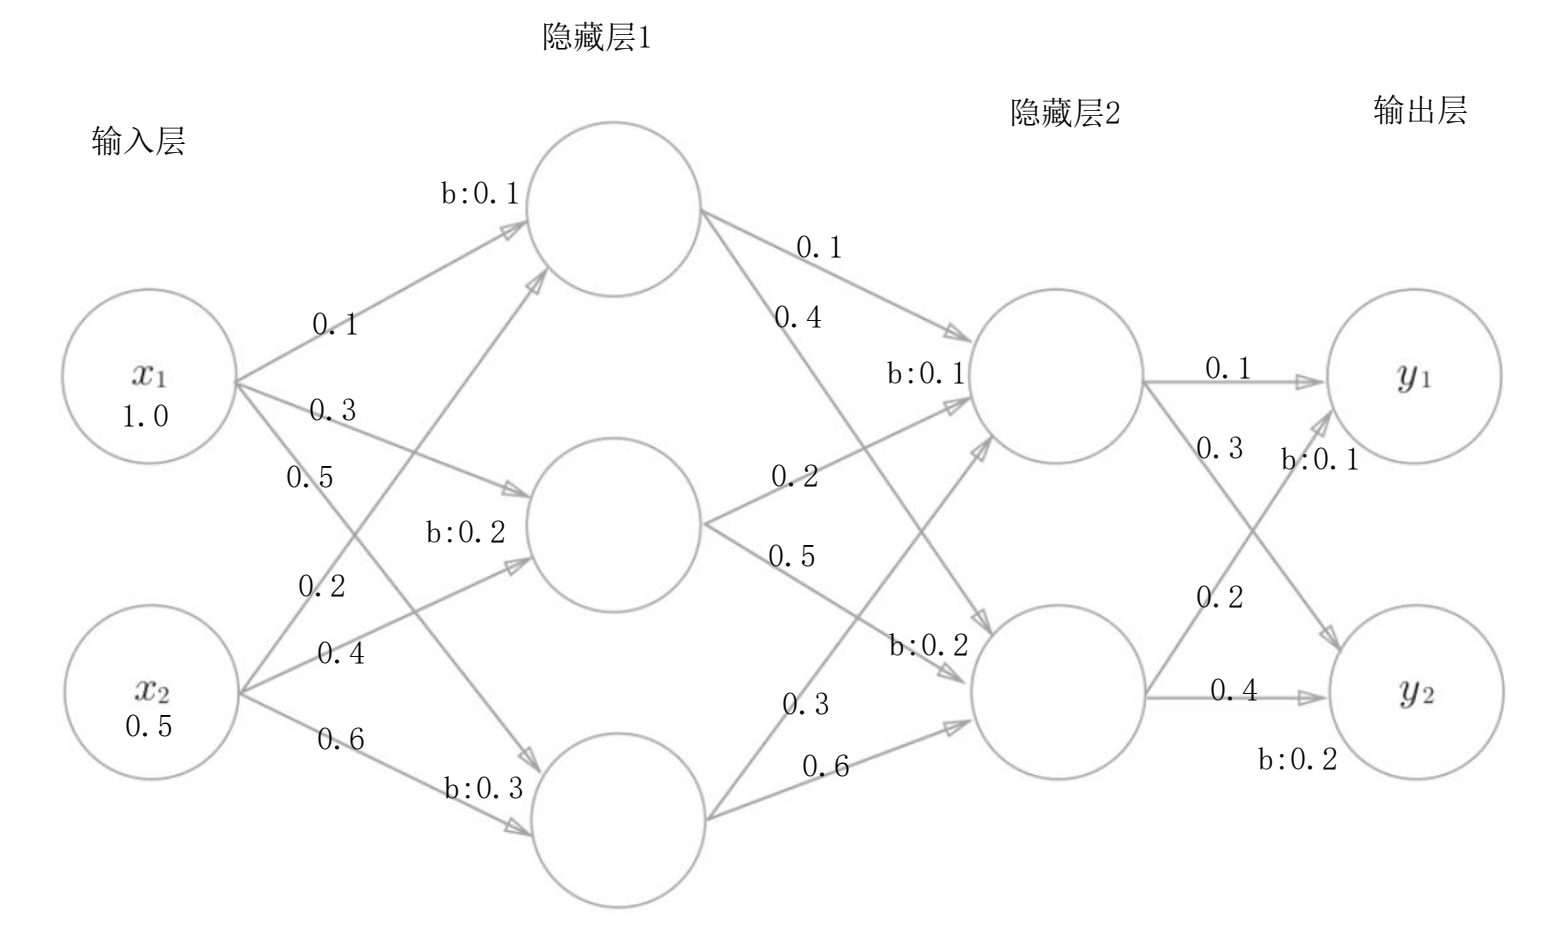
输入层(第0层)有2个神经元
隐藏层1(第1层)有3个神经元
隐藏层2(第2层)有2个神经元
输出层(第3层)有2个神经元
每两个神经元之间都有一个权重(weight)每个输入都有一个 偏置b(bias)。前向传播就是从左到右一层一层的向前传,传递的过程就是不断推进的过程。
我们看下,初始化网络和设置输入值的过程,所有值都在图中标出来了。
# 初始化网络(初始权重和偏置)
def init_network():
    network = dict()
    network['W1'] = np.array([[0.1, 0.3, 0.5], [0.2, 0.4, 0.6]])
    network['b1'] = np.array([0.1, 0.2, 0.3])
    network['W2'] = np.array([[0.1, 0.4], [0.2, 0.5], [0.3, 0.6]])
    network['b2'] = np.array([0.1, 0.2])
    network['W3'] = np.array([[0.1, 0.3], [0.2, 0.4]])
    network['b3'] = np.array([0.1, 0.2])
    return network

# 初始化网络
network = init_network()
# 设置输入值
x = np.array([1.0, 0.5])
# 前向传播
y = forward(network, x)
还记得前面的这张图及图中的公式吗?
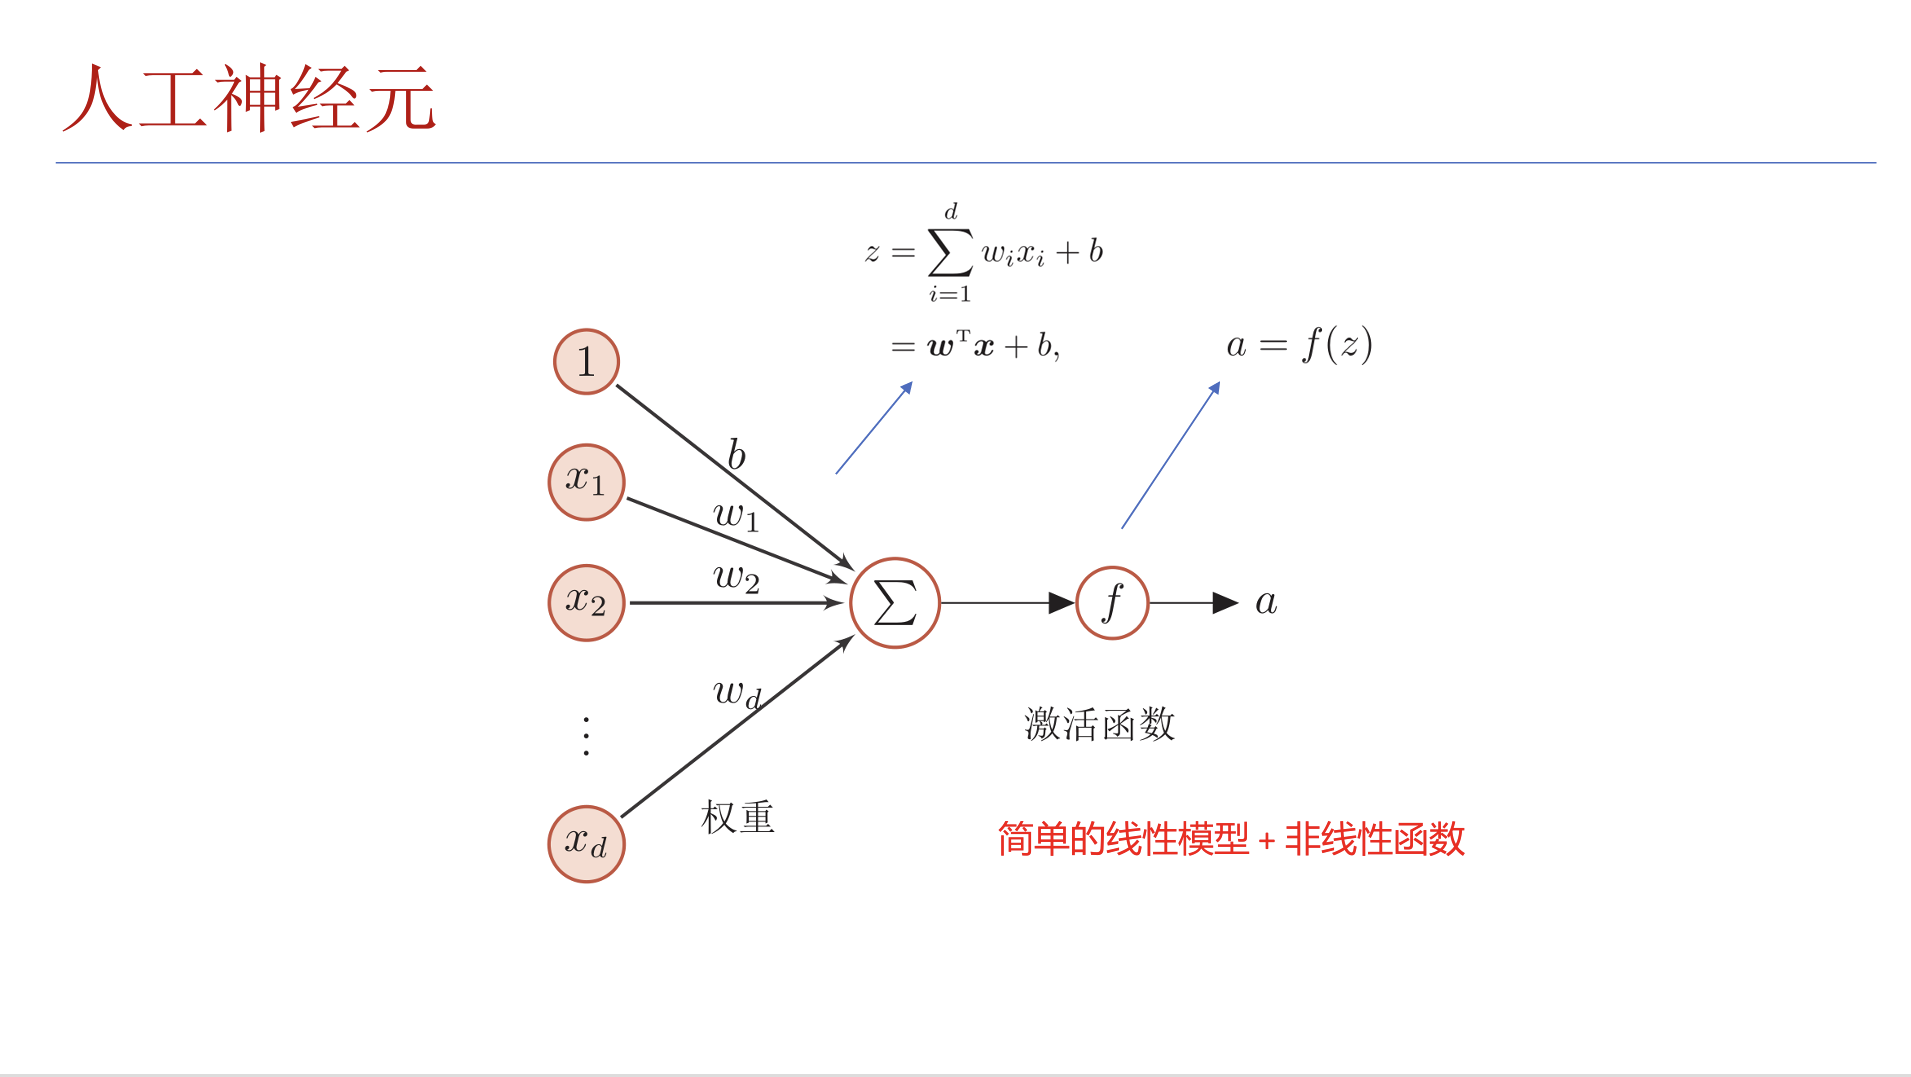
在代码中,我们需要借助numpy这个工具来帮我们完成计算的过程。
# sigmoid激活函数
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

# 恒等函数,作为输出层的激活函数
def identity_function(x):
    return x

# 前向传播
def forward(network, x):
    W1, W2, W3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']
    # hidden layer 1
    a1 = np.dot(x, W1) + b1
	# 前向传播 使用sigmoid
    z1 = sigmoid(a1)

    # hidden layer 2
    a2 = np.dot(z1, W2) + b2
    z2 = sigmoid(a2)

    # output layer
    a3 = np.dot(z2, W3) + b3
    y = identity_function(a3)
    return y
第0层x和第一层w1点乘后加上b1的结果,sigmoid函数激活后得到z1,z1又和第二层w2点乘后加上b2的结果,sigmoid函数激活后得到z2,z2又和输出层w3点乘后加上b3,就是最终输出:

总结一下:神经网络的计算函数 = 矩阵乘法(线性)+ 激活函数(非线性)
网络层数、参数量属于人为设定的超参数。比如 2.6T、2.8 万亿参数量,2 层、3 层网络,不存在绝对的标准答案。每一层、每一个神经元数字对应的现实物理含义难以解读,属于黑盒模型,不适合拆解每一个数值去分析意义。
二、编写一个完整的神经网络
神经网络基础(二)中介绍了神经网络的完整训练过程。我们用代码实现一下这个过程:
首先是初始化神经网络:
# n为样本大小,d_in为输入维度,h为隐藏层维度,d_out为输出维度
n, d_in, h, d_out = 64, 1000, 100, 10

# 随机生成输入数据x和目标输出y
x = np.random.randn(n, d_in)      # 输入数据,形状为(64, 1000)
y = np.random.randn(n, d_out)     # 目标输出,形状为(64, 10)

# 随机初始化权重参数
# 输入层到隐藏层的权重(1000,100)
w1 = np.random.randn(d_in, h)
# 隐藏层到输出层的权重(100,10)
w2 = np.random.randn(h, d_out)
样本一共有64个样本(可随意指定,但通常取 2 的幂次),即输入输出训练的数据集的个数是64个,输入层维度为1000,隐藏层维度为100,输出层维度为10。权重w1,w2也先随机生成。
训练100次的过程:
for t in range(100):
    # 前向传播
    temp = x.dot(w1)                  # 输入层到隐藏层的线性变换
    temp_relu = np.maximum(temp, 0)   # ReLU激活函数,隐藏层输出
    y_pred = temp_relu.dot(w2)        # 隐藏层到输出层的线性变换,得到预测值

    # 计算损失函数(均方误差和)
    loss = np.square(y_pred - y).sum()
    loss_history.append(loss)  # 记录loss值
    print(t, loss)

    # 反向传播,计算梯度
    grad_y_pred = 2.0 * (y_pred - y)              # 损失对预测输出的梯度
    #print('grad_y_pred=', grad_y_pred.shape) #(64, 10)
    grad_w2 = temp_relu.T.dot(grad_y_pred)        # 损失对w2的梯度
    grad_temp_relu = grad_y_pred.dot(w2.T)        # 损失对隐藏层输出的梯度
    grad_temp = grad_temp_relu.copy()             # 复制一份用于ReLU处理
    grad_temp[temp<0] = 0                         # ReLU小于0的部分梯度置零
    grad_w1 = x.T.dot(grad_temp)                  # 损失对w1的梯度

    # 更新权重参数
    w1 = w1 - learning_rate * grad_w1
    w2 = w2 - learning_rate * grad_w2
1)前向传播
x点乘w1,再用Relu函数来激活(参看上篇文章,Relu的介绍,x>0时==》relu(x) = x,当x <= x时==》relu(x) = 0),得到temp_relu;temp_relu再去点乘w2完成正向传播,得到预测值y_pred。
2)损失函数
用MSE(参看上篇文章)的方法计算预测值y_pred和真实值y之间的误差,并记录下来。
3)反向传播
反向传播和正向传播方向相反,是以损失误差为起点,利用链式求导法则,把误差信号从输出层向输入层反向回传。大家可以看下计算公式:
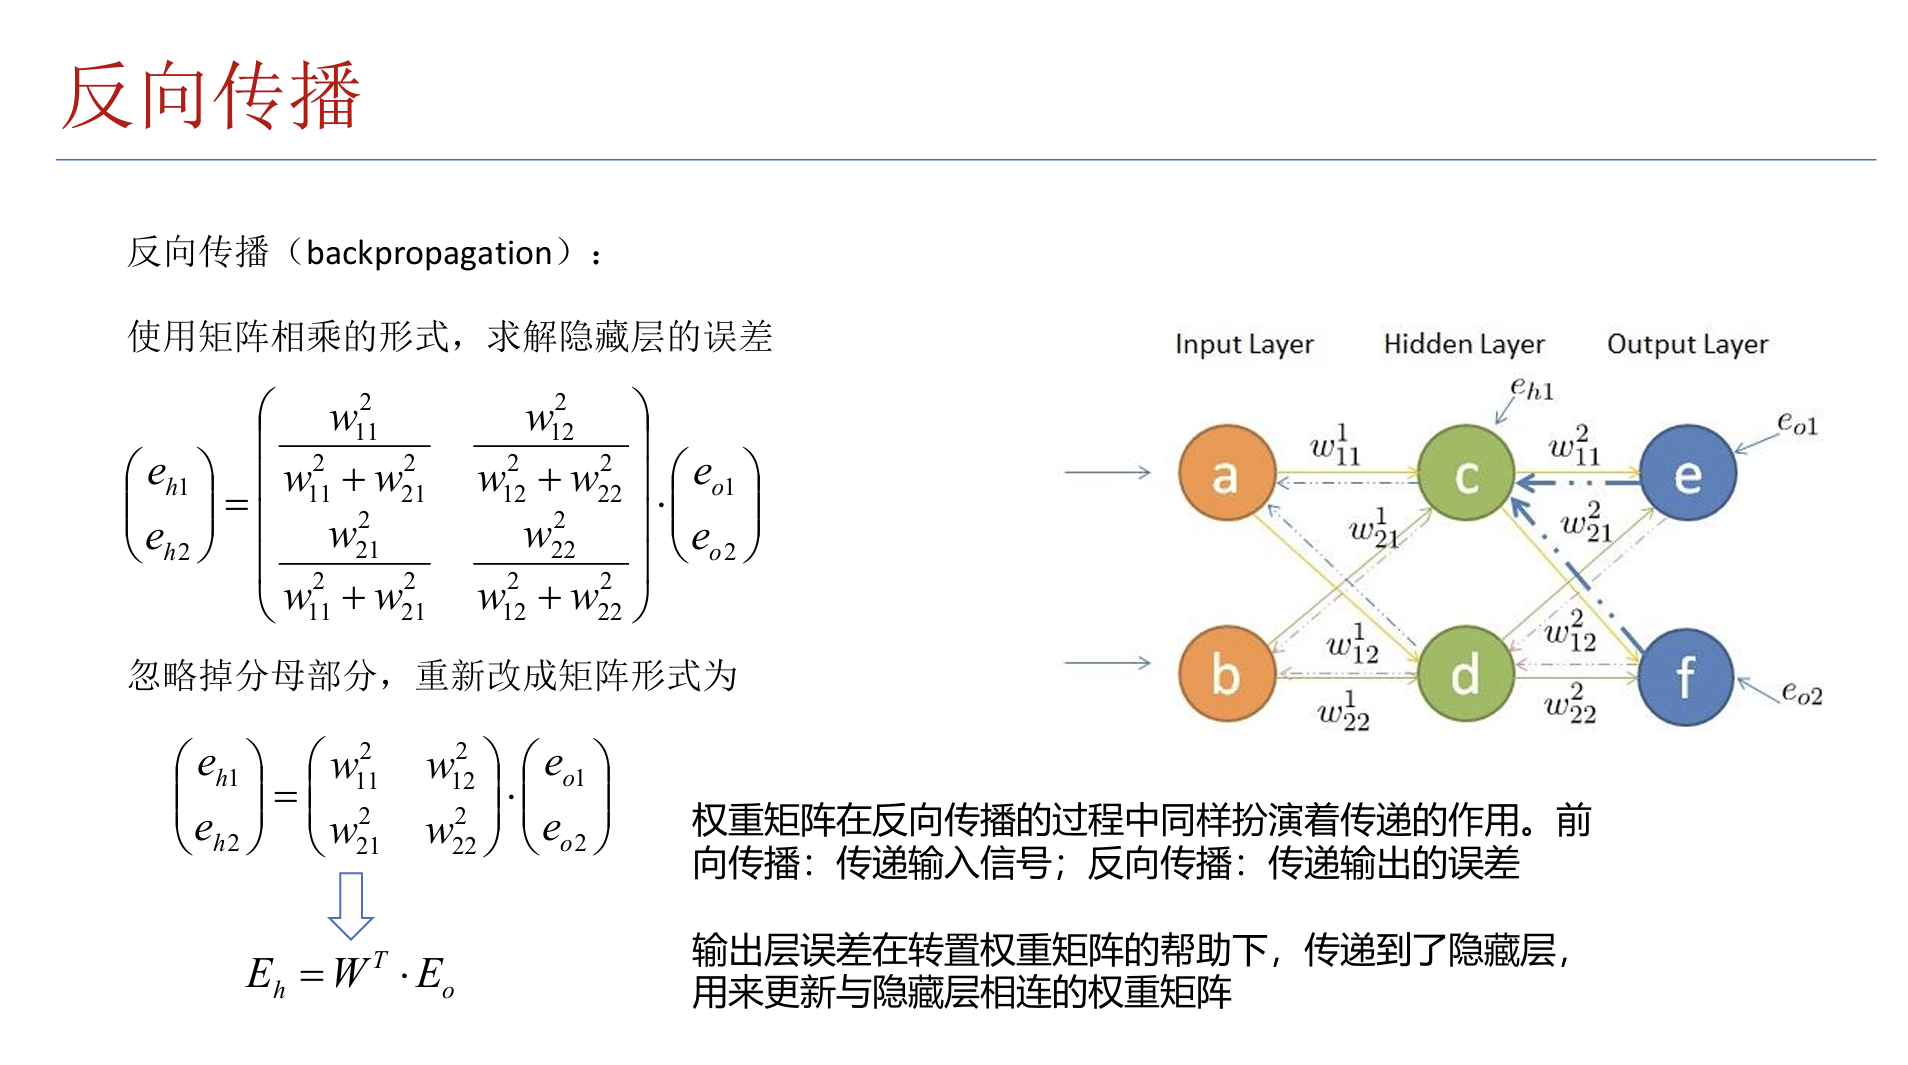
这里的计算公式比较复杂,但是numpy帮我们处理了。我们就大概理解下,c和d的误差是通过e和f节点来计算的。通过上面的公式,其实是转置权重矩阵 * 误差 可以得到上一层的误差,从输入层一直往前推(从右往左),直到输出层。
预测值y_pred和真实值y 之间的差值 * 梯度2(输入层到隐藏层,隐藏层到输出层)得到 grad_y_pred,grad_w2 等于 temp_relu转置后点乘grad_y_pred。grad_w1 等于 x转置后点乘grad_temp。
4)权值更新
简单理解公式:新权重 = 旧权重 − 学习率 × 梯度 学习率控制参数每一步改动的幅度;学习率太大训练容易震荡不收敛,太小训练进度会十分缓慢。
输出结果:
每一个循环就是一个迭代,在不断的迭代中,误差越来越小。大家看下Loss曲线:刚开始的迭代中误差非常迅速的下降,迭代到某一个次数后,误差基本不再下降了。这说明训练已基本完成。
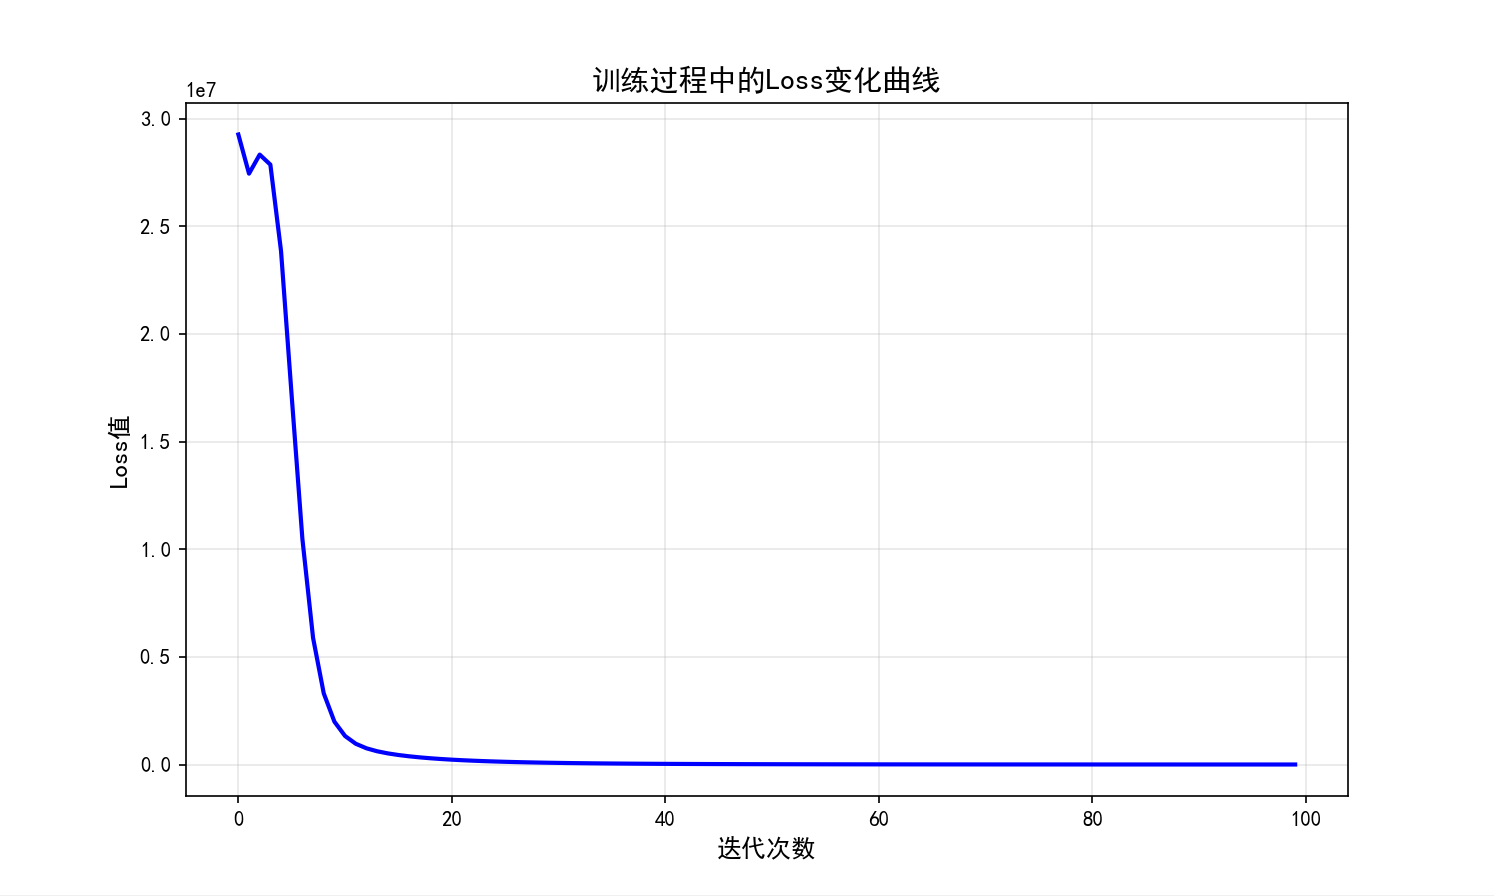
输出误差:
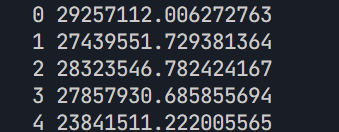
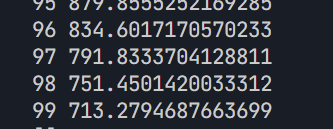
我们可以直观的看到,输出的误差越来越小了。
总结:
网络结构中有输入层、隐藏层和输出层。隐藏层就像一个黑箱子隐藏起来了,也可以把它理解成叫特征提取层,不需要人工手动设计特征规则。我们只需要传入输入和输出,就可以自动调整神经网络中的参数(自己去找对应的特征)。
这种特征万事万物都可以按照这个模式来做匹配。从图像的识别,从房价的识别计算,甚至股票的涨跌等等。只要你特征提取的好,他自己作为一个组合以后的话,就可以帮你来去做后续的预测。
三、波士顿房价预测(应用)
波士顿房价数据集:housing.csv
该数据集最初由美国波士顿地区的房屋信息统计而来, 最早用于研究空气质量对房价的影响,是机器学习的 经典回归数据集。
数据量:共506条样本,每条样本对应一处房产
特征数:13个特征+ 1个目标值(房价)
分隔符:空格分隔,无表头
大家看下,下面是数据的加载及初始化输入层和隐藏层的过程:
# 数据加载(从housing.csv读取,无表头,空格分隔)
data = pd.read_csv('housing.csv', header=None, delim_whitespace=True)
X = data.iloc[:, :-1].values  # 前13列为特征
y = data.iloc[:, -1].values  # 最后一列为目标
# 将y转为列向量,方便后续矩阵运算
y = y.reshape(-1, 1)

# 数据规范化(标准化处理,使每一列特征均值为0,方差为1)
x = (X - np.mean(X, axis=0)) / np.std(X, axis=0)
print(x)  # 打印标准化后的特征矩阵
n_feature = x.shape[1]  # 特征数量(13)
print(n_feature)

n_hidden = 10  # 隐藏层神经元数量
# 初始化输入层到隐藏层的权重和偏置
w1 = np.random.randn(n_feature, n_hidden)
b1 = np.zeros(n_hidden)
# 初始化隐藏层到输出层的权重和偏置
w2 = np.random.randn(n_hidden, 1)
b2 = np.zeros(1)
下面是迭代100次去调整神经网络的过程(可以调大迭代次数,我这里只是示范):
def Relu(x):
    # ReLU激活函数,小于0的部分置为0
    result = np.where(x>0, x, 0)
    return result

# 设置学习率
learning_rate = 1e-5

def MSE_loss(y, y_hat):
    # 均方误差损失函数
    return np.mean(np.square(y_hat - y))

def Linear(X, W1, b1):
    # 线性变换:X @ W1 + b1
    return X.dot(W1) + b1

# 输入特征维度13,隐藏层10维,输出1维(房价)
loss_history = []  # 记录每轮训练的损失,用于绘制误差曲线
for t in range(100):
    # 前向传播:输入->隐藏层->输出
    l1 = Linear(x, w1, b1)      # 输入层到隐藏层的线性变换
    s1 = Relu(l1)               # 隐藏层激活
    y_pred = Linear(s1, w2, b2) # 隐藏层到输出层的线性变换,得到预测值

    # 计算损失
    loss = MSE_loss(y, y_pred)
    loss_history.append(loss)
    print(t, loss)

    # 反向传播:计算梯度
    grad_y_pred = 2.0 * (y_pred - y)           # 损失对预测输出的梯度
    grad_w2 = s1.T.dot(grad_y_pred)            # 损失对w2的梯度
    grad_temp_relu = grad_y_pred.dot(w2.T)     # 损失对隐藏层输出的梯度
    grad_temp_relu[l1<0] = 0                   # ReLU小于0的部分梯度置零
    grad_w1 = x.T.dot(grad_temp_relu)          # 损失对w1的梯度

    # 更新权重参数
    w1 = w1 - learning_rate * grad_w1
    w2 = w2 - learning_rate * grad_w2
大家可以看下,在这个例子中迭代的部分代码和上面的代码几乎一样。而且对于数据集中的数据,我完全不知道每一列代表什么,也不需要知道。大家看下训练情况:
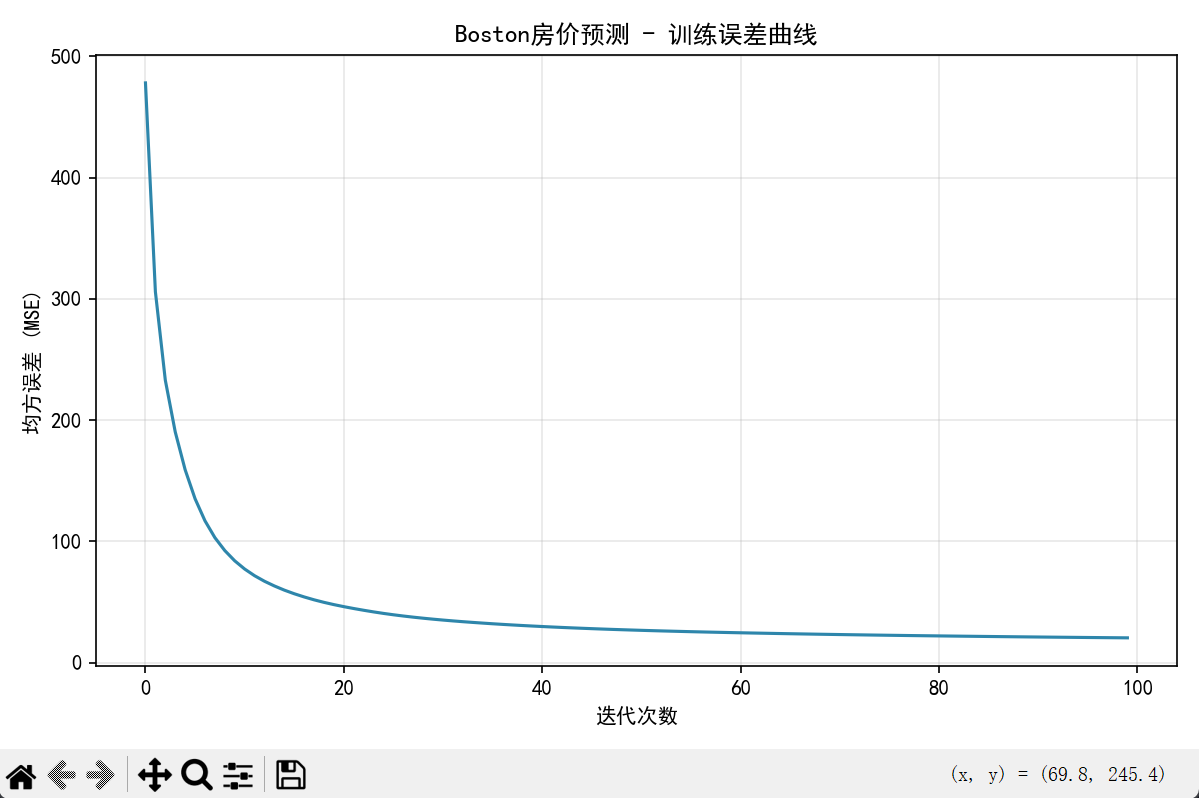
预测的房价与实际的房价之间的误差越来越小了。
更多推荐

 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)