
R-CNN 拆解:47 秒花在哪?跟着 2000 个候选框,走完“先猜、后认、再修框”三步流水线
R-CNN 拆解:47 秒花在哪?跟着 2000 个候选框,走完“先猜、后认、再修框”三步流水线
📍 系列路标|本系列共 7 篇,按“原理演进 → 逐篇拆解 → 流派对比 → 代码与选型”编排:
- ✅ 第 1 篇|R-CNN 发展史——四代模型因何而生、各解决了什么问题。
- ✅ 第 2 篇|R-CNN 拆解(本篇)——从一张图片出发,走完“先猜后认”的完整流程。
- ⏳ 第 3 篇|Fast R-CNN 拆解——RoI Pooling 如何把 47 秒压到 0.3 秒。
- ⏳ 第 4 篇|Faster R-CNN 拆解——RPN 如何让网络自己学会“找框”。
- ⏳ 第 5 篇|Mask R-CNN 拆解——从“框住”到“像素级抠图”的最后一公里。
- ⏳ 第 6 篇|R-CNN vs YOLO——两阶段与单阶段,谁快谁准谁更适合你。
- ⏳ 第 7 篇|手撕代码与工业选型——从零实现一个检测器 + 真实项目里到底选谁。
一、先搭框架:一张图进 R-CNN,要过哪三道门?
第 1 篇给出过一句结论:R-CNN 是第一个把深度学习搬进目标检测的模型,它用“准”换来了“慢”。把镜头推进到机器内部,要回答的更细问题是:那约 2000 个候选框是怎么“猜”出来的?CNN 到底“看”了框里的什么?最后那个框又是怎么从“大概在这”变成“刚好圈住”的? 要把这三件事讲清楚,先把整条流水线钉在墙上。
1.1 用一张流程图看穿全局
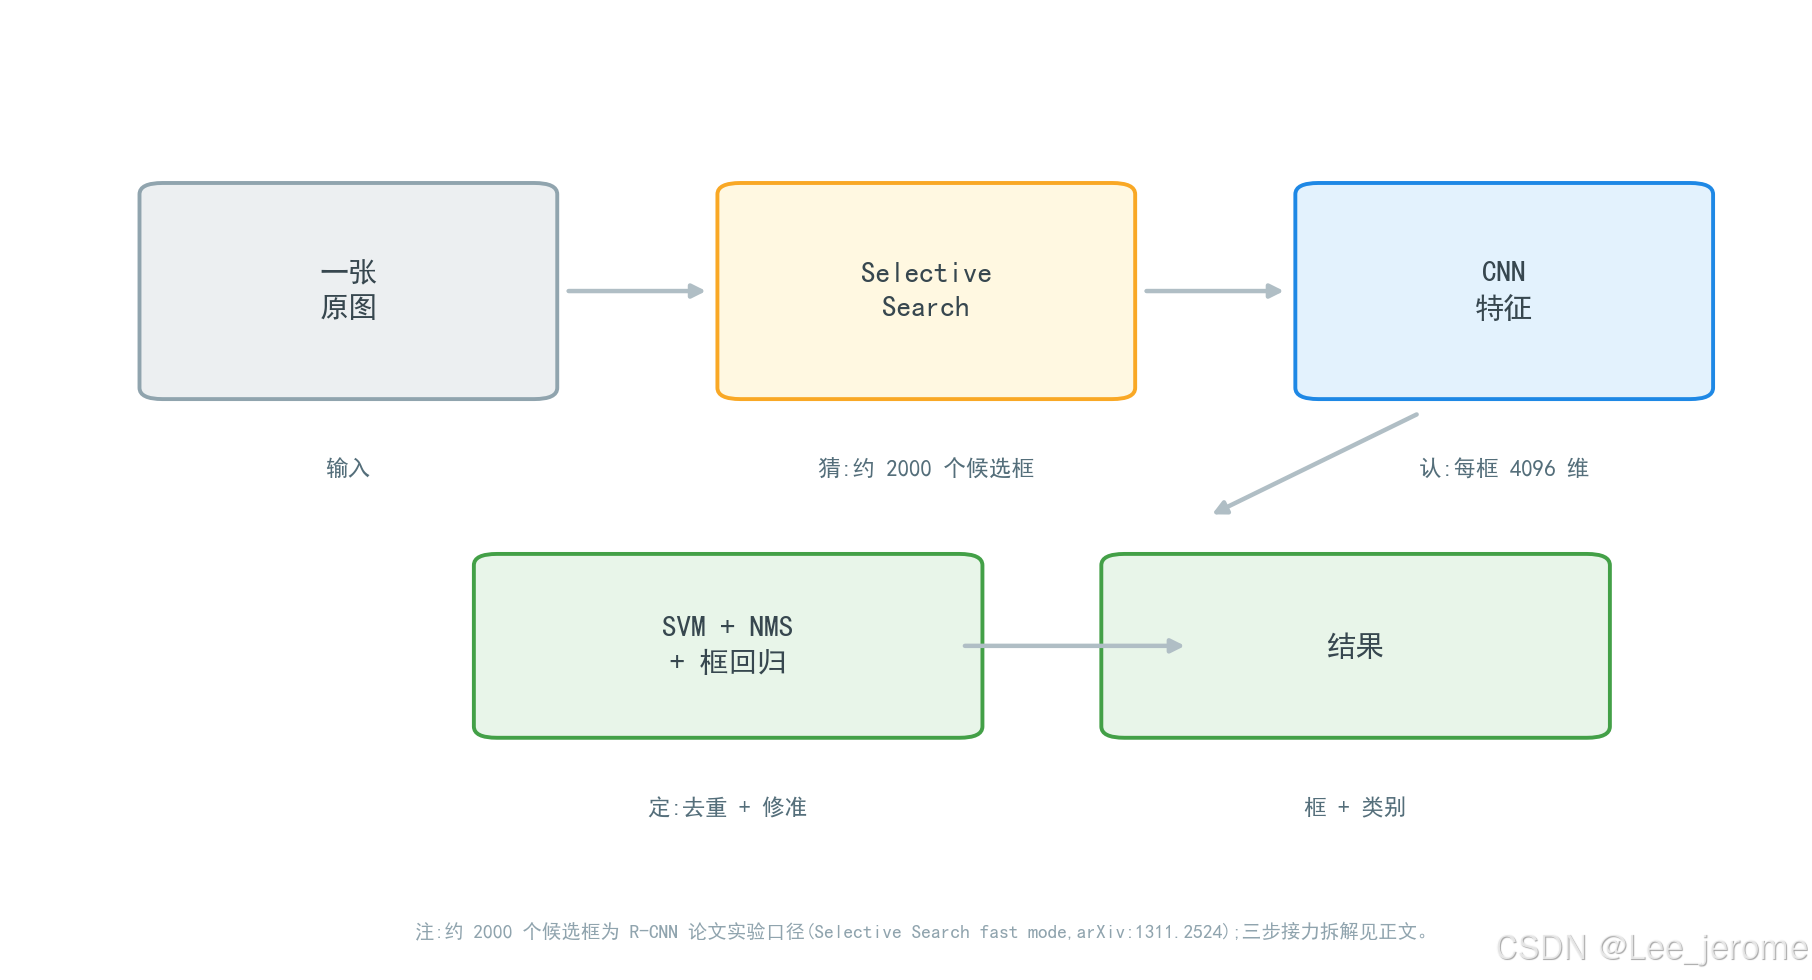
图 1|R-CNN 推理流水线全景:灰 = 输入,黄 = CPU 上的传统算法,蓝 = 深度学习,绿 = 后处理与输出;每个环节下方标注它的“产出”
🤔 怎么读这张图? 从左往右是“从图到答案”的推进:先有输入,再由黄、蓝、绿三种颜色的环节接力。读的时候盯住两件事:其一,蓝色环节的输入是一个个被单独切出来、重新缩放的框,而不是原图——这是理解后面“为什么慢”的钥匙;其二,注意每道门的“产出”都在变:从“约 2000 个候选框”,到“2000 段特征向量”,最后才是“框 + 类别 + 置信度”。三道门分工如下:第二章到第四章就按这个顺序,把每一道门拆开看。
1.2 三道门各管一件事,也各欠一笔“债”
- 第一道门「猜」——找位置:用传统算法 Selective Search 把“物体大概在哪”先框出来。它类别无关、跑在 CPU 上,欠下的债是“不知道框里是什么,还可能漏掉目标”;
- 第二道门「认」——看内容:把每个候选框送进 CNN,得到能判别类别的特征。它欠下的债是“每个框都要完整跑一遍网络”,同一张图的低级特征被反复计算;
- 第三道门「定」——下结论:SVM 判类别、NMS 去重、回归修框。它欠下的债是“三个环节各自训练、互不通气”,整条流水线没法端到端优化。
这套“先猜后认”的接力,在 VOC2010 上把 mAP 从传统方法巅峰 DPM 的 33.4% 直接抬到 53.7%——这是精度上一次里程碑式的越级。代价则是那笔著名的“47 秒账单”,它具体由哪些开销攒成,第五章单独算给你看。
二、第一道门「猜」:Selective Search 怎么“无中生有”掏出约 2000 个框?
2.1 难点先摆出来:位置问题是“无限”的
一个物体可能出现在画面的任何位置、任何大小、任何长宽比。如果像 DPM 时代那样滑窗穷举——窗口从左上角挪到右下角,再换几档尺寸和比例各扫一遍——理论上要检查的位置数量是个天文数字,而其中绝大多数窗口里只有背景。
所以聪明的做法是先“大幅淘汰”:用便宜、快速、类别无关的手段,把整张图压缩成约 2000 个“可能有物体”的位置,把“精挑细选”留给后面的 CNN。这就像找东西时不逐寸翻地板,而是先按“颜色相近、纹理相近”把杂物归成几堆,再在每堆附近仔细找。候选框的质量决定精度的上限——漏掉的物体,后面 CNN 再强也没有机会见到。
2.2 三板斧:过分割 → 反复合并 → 每轮合并都记下一个框
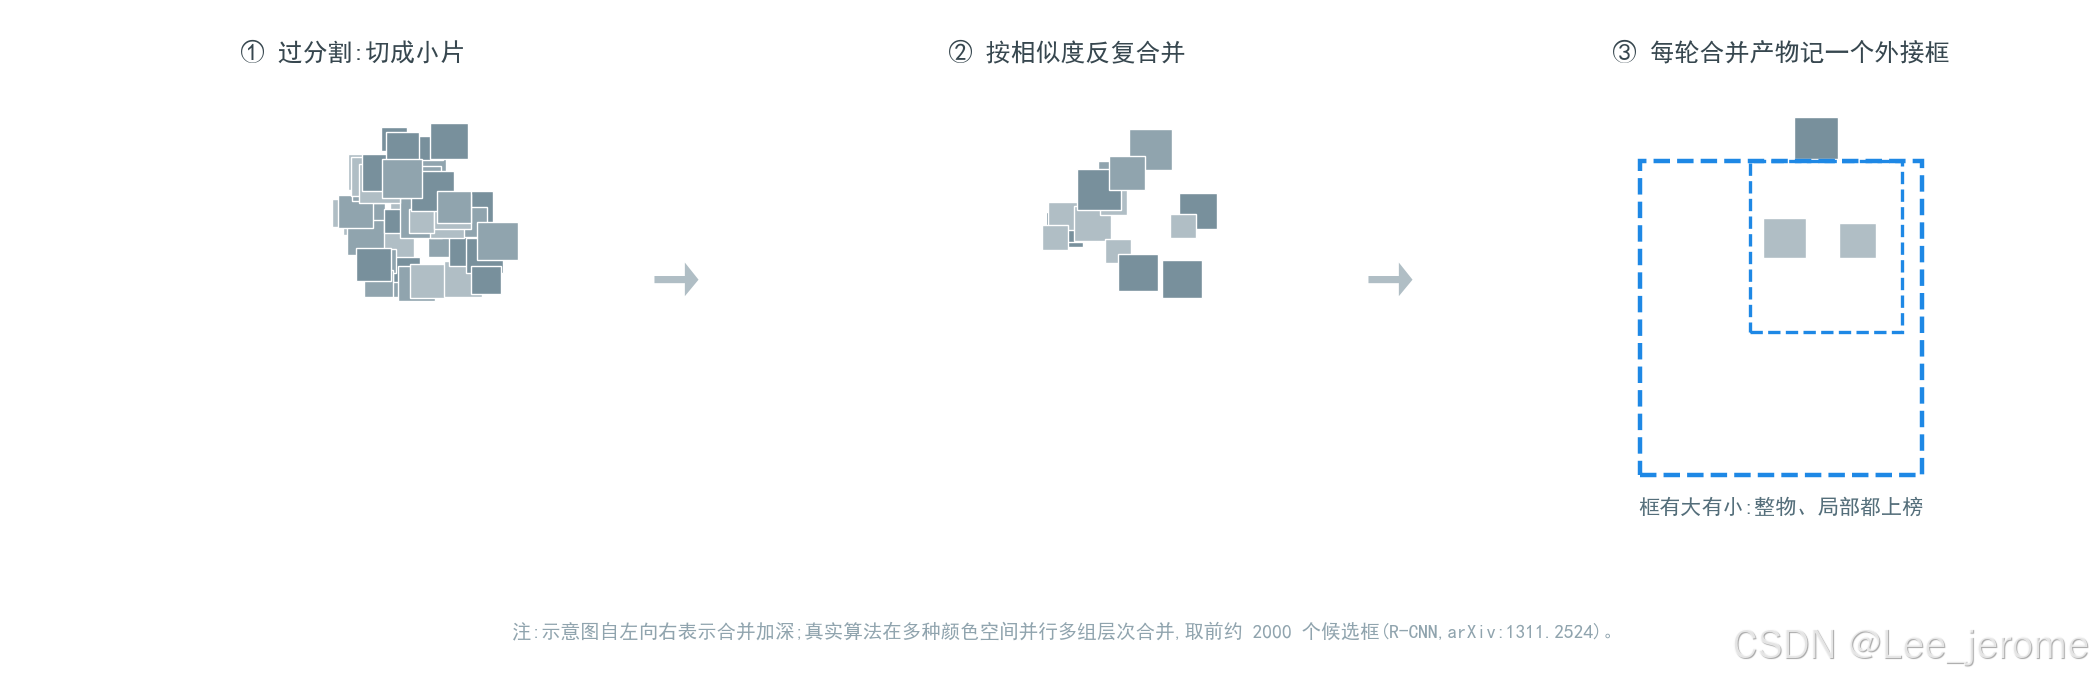
图 2|Selective Search 的工作方式(示意):先把图切成许多小片(过分割),再反复合并“长得像一伙的”相邻小片,每一轮合并的产物都记一个外接框——合并轮次越深,框的粒度越大,小到局部、大到整只物体的框就都被收集起来了
🤔 怎么读这张图? 从左到右三帧是“从碎到整”的合并过程:第一帧是过分割,一个物体区被切成了许多小片;第二帧里,相邻且“长得像一伙”的小片被不断并成更大的片;第三帧表示合并到不同深度时,每轮产出的整体都被记下一个外接框——于是框有大有小,大到整物、小到局部都会被收录。读的时候还要记得:这一过程完全不看“框里是什么”,它只依据颜色、纹理这些低级线索决定谁和谁合并。
具体机制分三步:
- 过分割起步:先用图割类算法把图切成几百到几千个小区域(超像素),同属一个物体的区域通常被切得七零八落;
- 贪心层次合并:反复把“最相似”的相邻区域并成一个整体——相似度由四个维度综合给出:颜色(直方图相近)、纹理(局部梯度分布相近)、尺寸(优先并小块,防止大块一口吞掉整张图)、填充(允许形状互补的区域贴合,比如文字与它所在的招牌、杯口与杯身);
- 每轮合并都记账:把每一轮合并产出的整体取一个外接框记下来。合并是从小到大的,所以记录下来的框天然覆盖多种尺度。
此外还有一招“多样性”:算法会在多种颜色空间里并行执行好几组这样的合并,再把结果融合去重,最后按启发式得分排序,取前约 2000 个(论文实验用 Selective Search 的 “fast mode”)交给下一道门。位置这一关,到此就算“猜”完了。
2.3 它只负责“可能”,不负责“是谁”
这一道门有两个必须认清的边界。第一,它是类别无关的:它不知道“猫”长什么样,只会把“颜色纹理上看起来自成一体”的区域圈出来,所以框里可能是完整物体、物体的局部,也可能是背景。第二,它是外部传统算法:跑在 CPU 上、需要单独维护,而且与后面的 CNN 完全没有信息往来——它不认识语义,纯靠低级线索猜测。这两个边界,正是后来 R-CNN 家族两次重大手术的病灶位置,先记下,后面会回到这里。
三、第二道门「认」:CNN 如何把一个框变成“能认类别的特征”?
3.1 先把候选框“整形”:任何框都改写成 227×227,带 16 像素上下文
CNN 不是“想裁多大裁多大”的:它的输入尺寸是写死的。2014 年主角网络的输入是 227×227 的 RGB 图。于是每个候选框都要经历一次“整形”:先取它的外接矩形,再向外扩一圈——论文在缩放到 227 后保留了 p = 16 像素的上下文——然后拉伸到统一尺寸。多留这圈“环境”不是凑数:纯目标的剪影丢失了它所在场景的信息,CNN 认起来反而吃亏,论文里叫这一步 warp(扭曲缩放)。
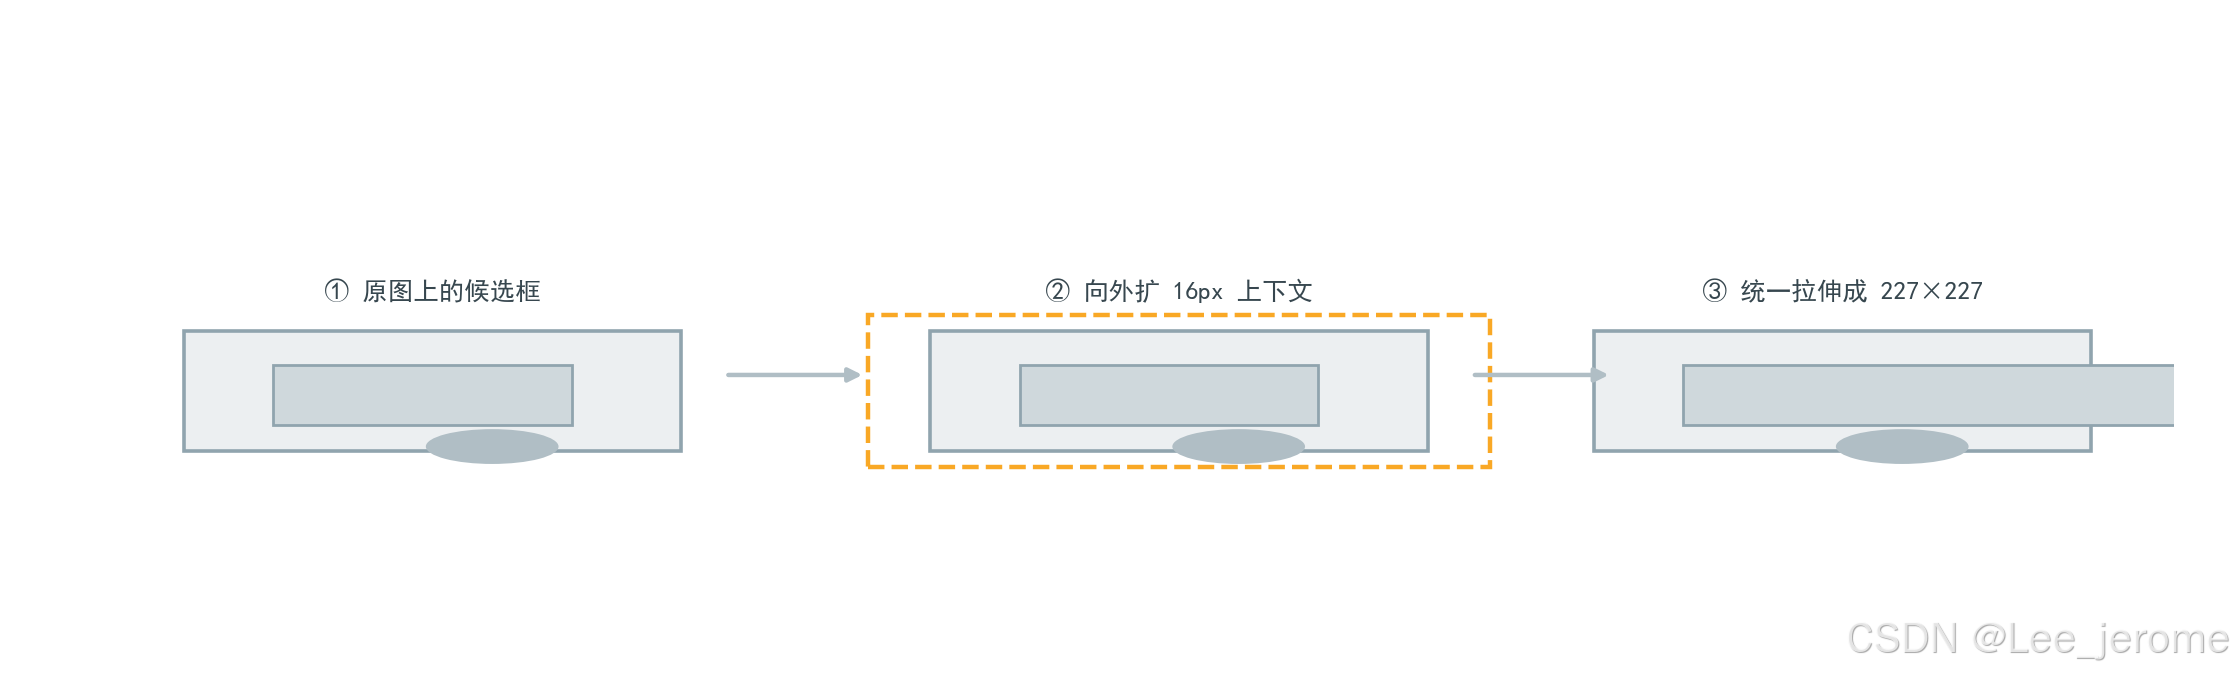
图 3|warp 的三步整形:候选区域 → 外扩 16px 上下文 → 统一拉伸成 227×227(示意)
🤔 怎么读这张图? 从左到右看三步:先取出候选框内的内容;因为只裁框内会让物体“失去环境”,要把外接矩形向外扩一圈(虚线示意,论文口径 p = 16 像素)再整体取出;最后统一拉伸成 CNN 唯一认识的 227×227 方形。注意任意长宽比的区域都会被“压”成方形,形状难免有些变形——这就是 warp 为了适配固定尺寸输入付出的代价。
3.2 全篇通用的一把尺子:IoU 重合度
从这一步开始,“框框得准不准”会反复出现。它需要一个客观的度量:两个框重叠到什么程度,才算“框住了同一个东西”?这把尺子叫 IoU(交并比):
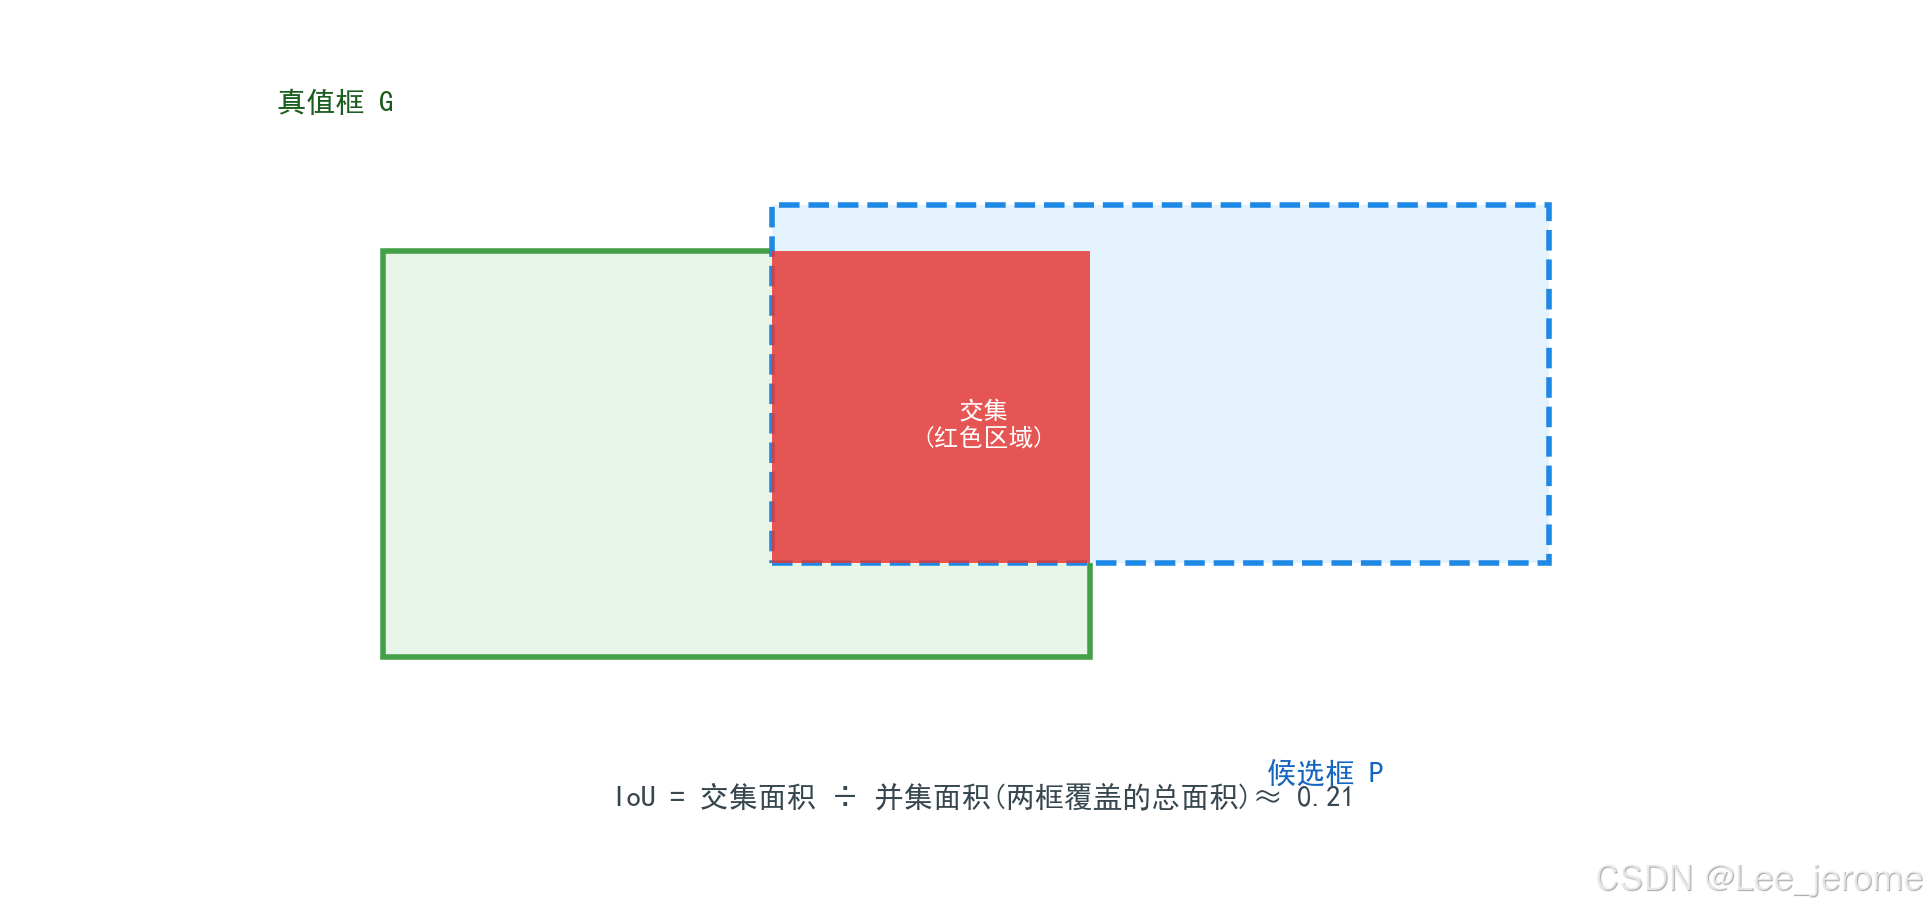
图 4|IoU(交并比)的定义:重合程度 = 交集面积 ÷ 并集面积;完全重合为 1,完全不沾边为 0(几何与数值为示意)
🤔 怎么读这张图? 绿色实线框是“标准答案”真值框,蓝色虚线框是某个候选框。两框重叠的区域(红色交集)除以两框覆盖的总范围(并集),比值越接近 1,说明候选框“套得越准”。后文会反复出现的 0.3、0.5、0.6 三档阈值,读的都是这把尺子上的刻度。
3.3 一次完整前向,一段 4096 维的“语义指纹”
整好形后,每个候选框被完整地送进 CNN:从第一层卷积开始,逐层提取边缘 → 部件 → 整体语义的层级特征,最终在最后的全连接层得到一条 4096 维的特征向量。这条向量可以理解为“这段画面的语义指纹”:同类的物体(哪怕换个角度、换身颜色)指纹相近,不同类的东西指纹相远——SVM 正是靠这条指纹来判类。注意两个细节:
- 论文的 CNN 主体有 5 层卷积 + 2 层全连接;最后一个全连接层(fc7)之前的 pool5(6×6×256 = 9216 维)保留了更多空间细节,第四章的框回归会用它的特征;
- 每个候选框都是独立完整地跑一遍网络,框与框之间没有任何计算共享——同一个物体被十几个高度重叠的候选框圈住时,它的特征就被白算了十几遍。这一条的代价,第五章算账。
3.4 “借来的眼睛”要先复训:ImageNet 预训练 → VOC 微调
检测数据又少又贵:标一个“框 + 类别”远比标“这张图是猫”费劲。直接拿小数据从零训一个大 CNN,几乎必然过拟合。R-CNN 的答案今天人人熟知、当时是反直觉的——迁移学习:
- 先在 ImageNet 上预训练:让 AlexNet 在 1000 类、百万级的图像分类任务上先学会“看世界”的通用能力(只会给整图分类,从没见过“框”);
- 再到检测数据上微调:把最后一层从 1000 类换成 21 类(20 个 VOC 类别 + 背景),用学习率 0.001(预训练的十分之一)在 VOC 的候选框上继续训练,把“会分类的眼睛”改造成“会认检测窗口的眼睛”。
微调时的正负样本划分,就要动用 3.2 那把尺子了:与某个真值框 IoU ≥ 0.5 的候选框判为正样本(并归到那个真值框的类别名下),其余一律当背景;由于正样本天然稀少,每个 mini-batch 里强制配 32 个正样本 + 96 个背景。论文实测这一步价值巨大:在 VOC2007 上,不微调时表现最好的特征层约 46.2%,微调后冲到 54.2%——+8 个百分点。
四、第三道门「定」:SVM 判类、NMS 去重、回归修框,为什么要“三件套”?
4.1 判类:每类一个线性 SVM,而不是直接用微调好的 softmax
按理说,微调后的 CNN 最后一层已经是个 21 类分类器,直接拿它打分不就行了?论文专门试过并给出数据:同样用微调后的特征,直接用 softmax 打分是 50.9%,换成“每类一个线性 SVM”是 54.2%。为什么会这样?
关键在正样本的定义不同。微调阶段为了凑够训练数据,把 IoU ≥ 0.5 的“带抖动框”都算成了正样本,网络学的是“大致是这个物体就行”;而 SVM 阶段只把严格的真值框当正样本,学的是“严丝合缝就是这个物体”。再加上 SVM 在小样本、高维特征下配合正则更稳,所以论文选择把“判类”从网络里拆出来,为 20 个类别各训练一个二分类线性 SVM(车/非车、人/非人……),让每个类别拥有一套独立的判别边界。
4.2 喂给 SVM 的正负样本:正例只认真值框,负例要够“干净”
每个类别的 SVM 都面临同一个问题:怎么定义“负样本”?一个框和车半重叠、到底算不算“车”的坏样本?论文用验证集做网格搜索,最终把门槛定在 IoU = 0.3:
- 正例:仅该类所有真值框(绝不掺“抖动框”);
- 负例:与该类任何一个真值框的 IoU 都低于 0.3 的候选框;
- 灰色地带(IoU 在 0.3 到接近 1 之间、又不是真值框):既不当正也不当负,直接忽略。
阈值选错代价很大:论文实测把它放宽到 0.5,mAP 掉 5 个点;收紧到 0,再掉 4 个点——可见“半像不像”的样本怎么处理,直接影响学到什么。
还有一个实操细节叫难例挖掘(hard negative mining):负样本动辄几十上百万,内存装不下、也没必要全学。做法是先用一批容易的负样本粗训一轮,然后把“模型当前最容易误报成物体”的难负样本挑出来补进去再训,通常扫一遍训练集就收敛。SVM 打分在推理时也便宜:所有框对某个类的一次打分,本质是一批点积,论文用一次矩阵乘法批量算完(约 2000×4096 的特征矩阵乘 4096×20 的权重矩阵)。
4.3 NMS:同一类的“重复答题”,只留最高分
候选框天生会“扎堆”:同一个物体往往被十几个大同小异的框同时圈住,SVM 会给它们都打高分。要是全部输出,一个物体会被画十几遍框。**非极大值抑制(NMS)**专门处理这件事:按类独立地执行——先按分数从高到低排,最高分的框留下;凡是与它 IoU 超过阈值的框,一律视为“同一个物体的重复表达”删掉;再对下一个最高分重复此过程。最后每个物体只保留一个“最佳答案”。
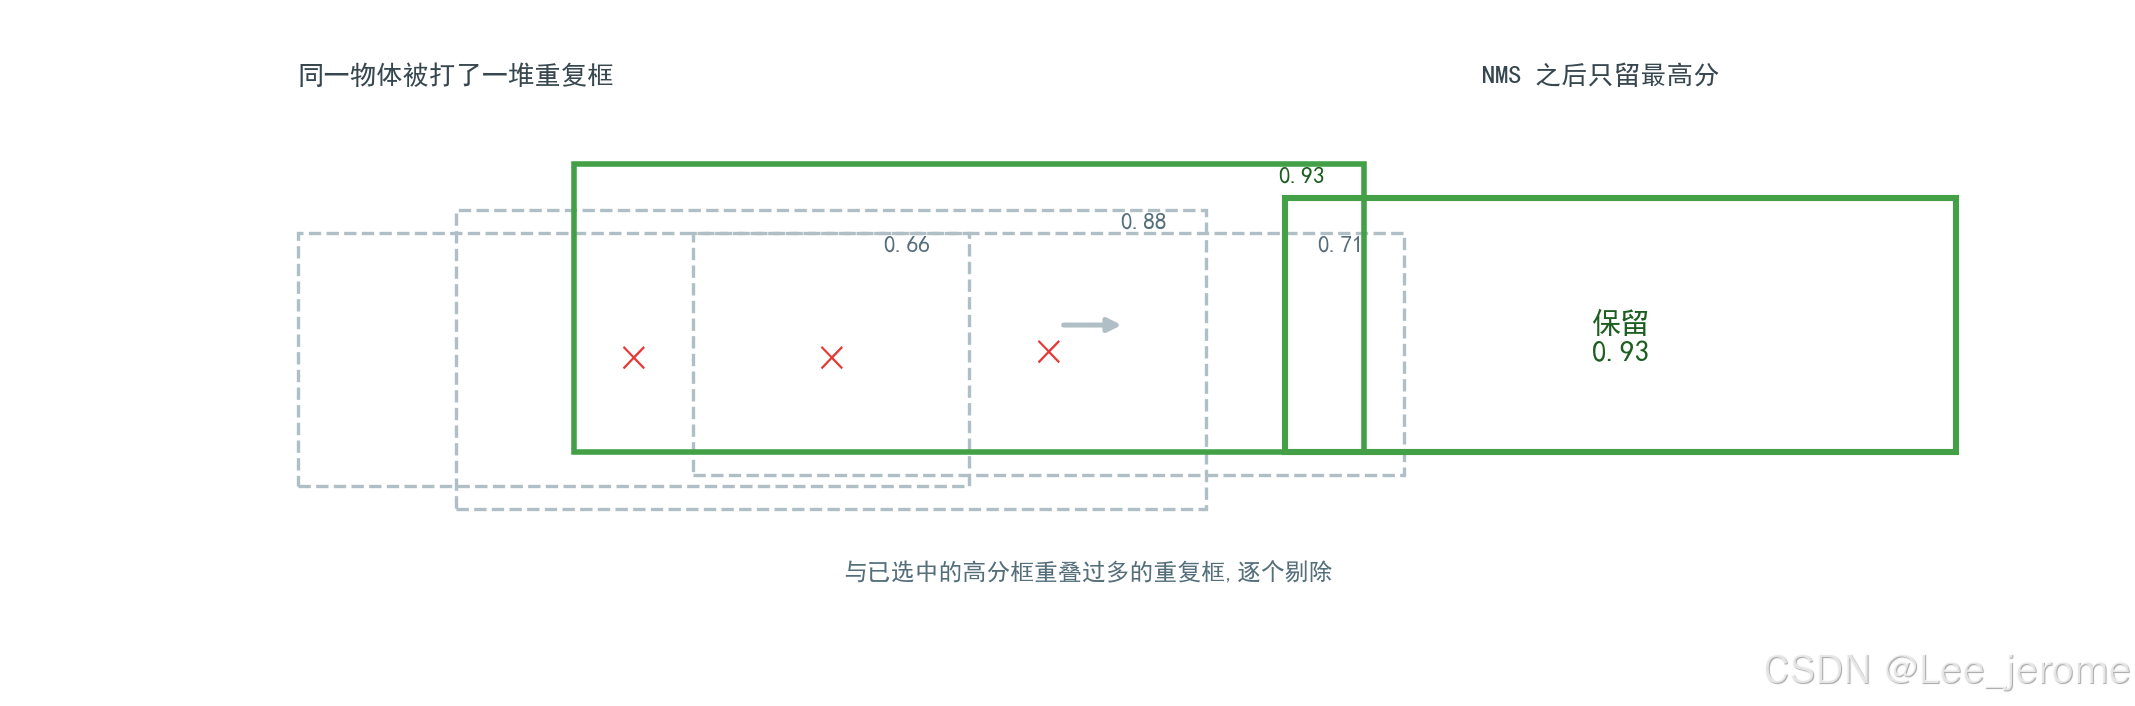
图 5|NMS 去重:同一个物体被打出的多个重叠框,只保留得分最高的一个,其余剔除(示意)
🤔 怎么读这张图? 左边是打分后同一物体上的一堆重叠框,分数从 0.66 到 0.93 各不相同——若全部输出,一个物体会被画好几遍。NMS 的做法是:先按分数排序,最高分(0.93)留下,与它重叠过多的框逐个剔除(画 ×);最终如右图,一个物体只输出一个“最佳答案”。
4.4 回归:把“圈住了但没圈准”的框修到贴边
拆完前面的环节,论文对错误做了一次“尸检”,发现最大的误差来源不是“认错类”,而是**“框对了但没框准”**——IoU 落在 0.1 到 0.5 之间的定位误差,占比远超“把猫认成狗”这类语义错误。CNN 特征足够强之后,剩下的短板主要在地理位置精度上。
于是有了最后一件工具——框回归(bounding-box regression):为每个类别训练一个小线性回归器,输入用保留空间细节的 pool5 特征(9216 维),输出 4 个修正量——中心点的横、纵平移,以及宽、高的缩放,把候选框“挪向”真值框。它有两条纪律:
- 只对“几乎框对”的框学习:参与训练的候选框与真值框的 IoU 要达到论文口径的 0.6 量级。教一个只框住猫尾巴的框去“挪成整只猫”毫无意义,回归只负责把 90 分的框修到 98 分;
- 类别专属:猫的框和车的框,各自的“修法”是分开学的。
收益立竿见影:VOC2007 上从 54.2% 涨到 58.5%(论文表述为提升 3~4 个点);在 VOC2010 上,框回归把结果从 50.2% 推到 53.7%——别小看这几个点,“能不能再贴边一点点”正是检测精度最磨人的战场。
五、把账算清:47 秒与数百 GB,是怎么一笔一笔攒出来的?
5.1 训练为什么是“三段式”,又贵在哪?
回顾一下 R-CNN 一共要学三样东西:CNN 参数(微调)、20 个类别 SVM、20 个框回归器。它们各训各的,共用同一条“特征流水线”,于是训练被拆成典型的三段式:
- ImageNet 预训练(这步用的是公开分类任务,白拿通用视觉能力);
- 在 VOC 候选框上微调 CNN;
- 为 SVM 和回归器提取并缓存全部训练特征 → 训 SVM → 训回归器。
第 3 段的“缓存特征”是最大的开销来源:每一张训练图里约 2000 个候选框的特征都要算出来、写进磁盘,供 SVM 与回归器反复读取训练。VOC2007 训练集约 5000 张图,逐框落盘的结果是数百 GB 的磁盘占用(论文实测用 VGG16 时仅特征提取就要约 2.5 个 GPU 天)——这就是第 1 篇提到的“几百 GB 磁盘都装不下”的来历。整条流水线在 VOC2007 上完整训一遍(VGG16 口径),公开数字约 84 小时。
5.2 测试为什么慢:同一套卷积,被重复算了约 2000 遍
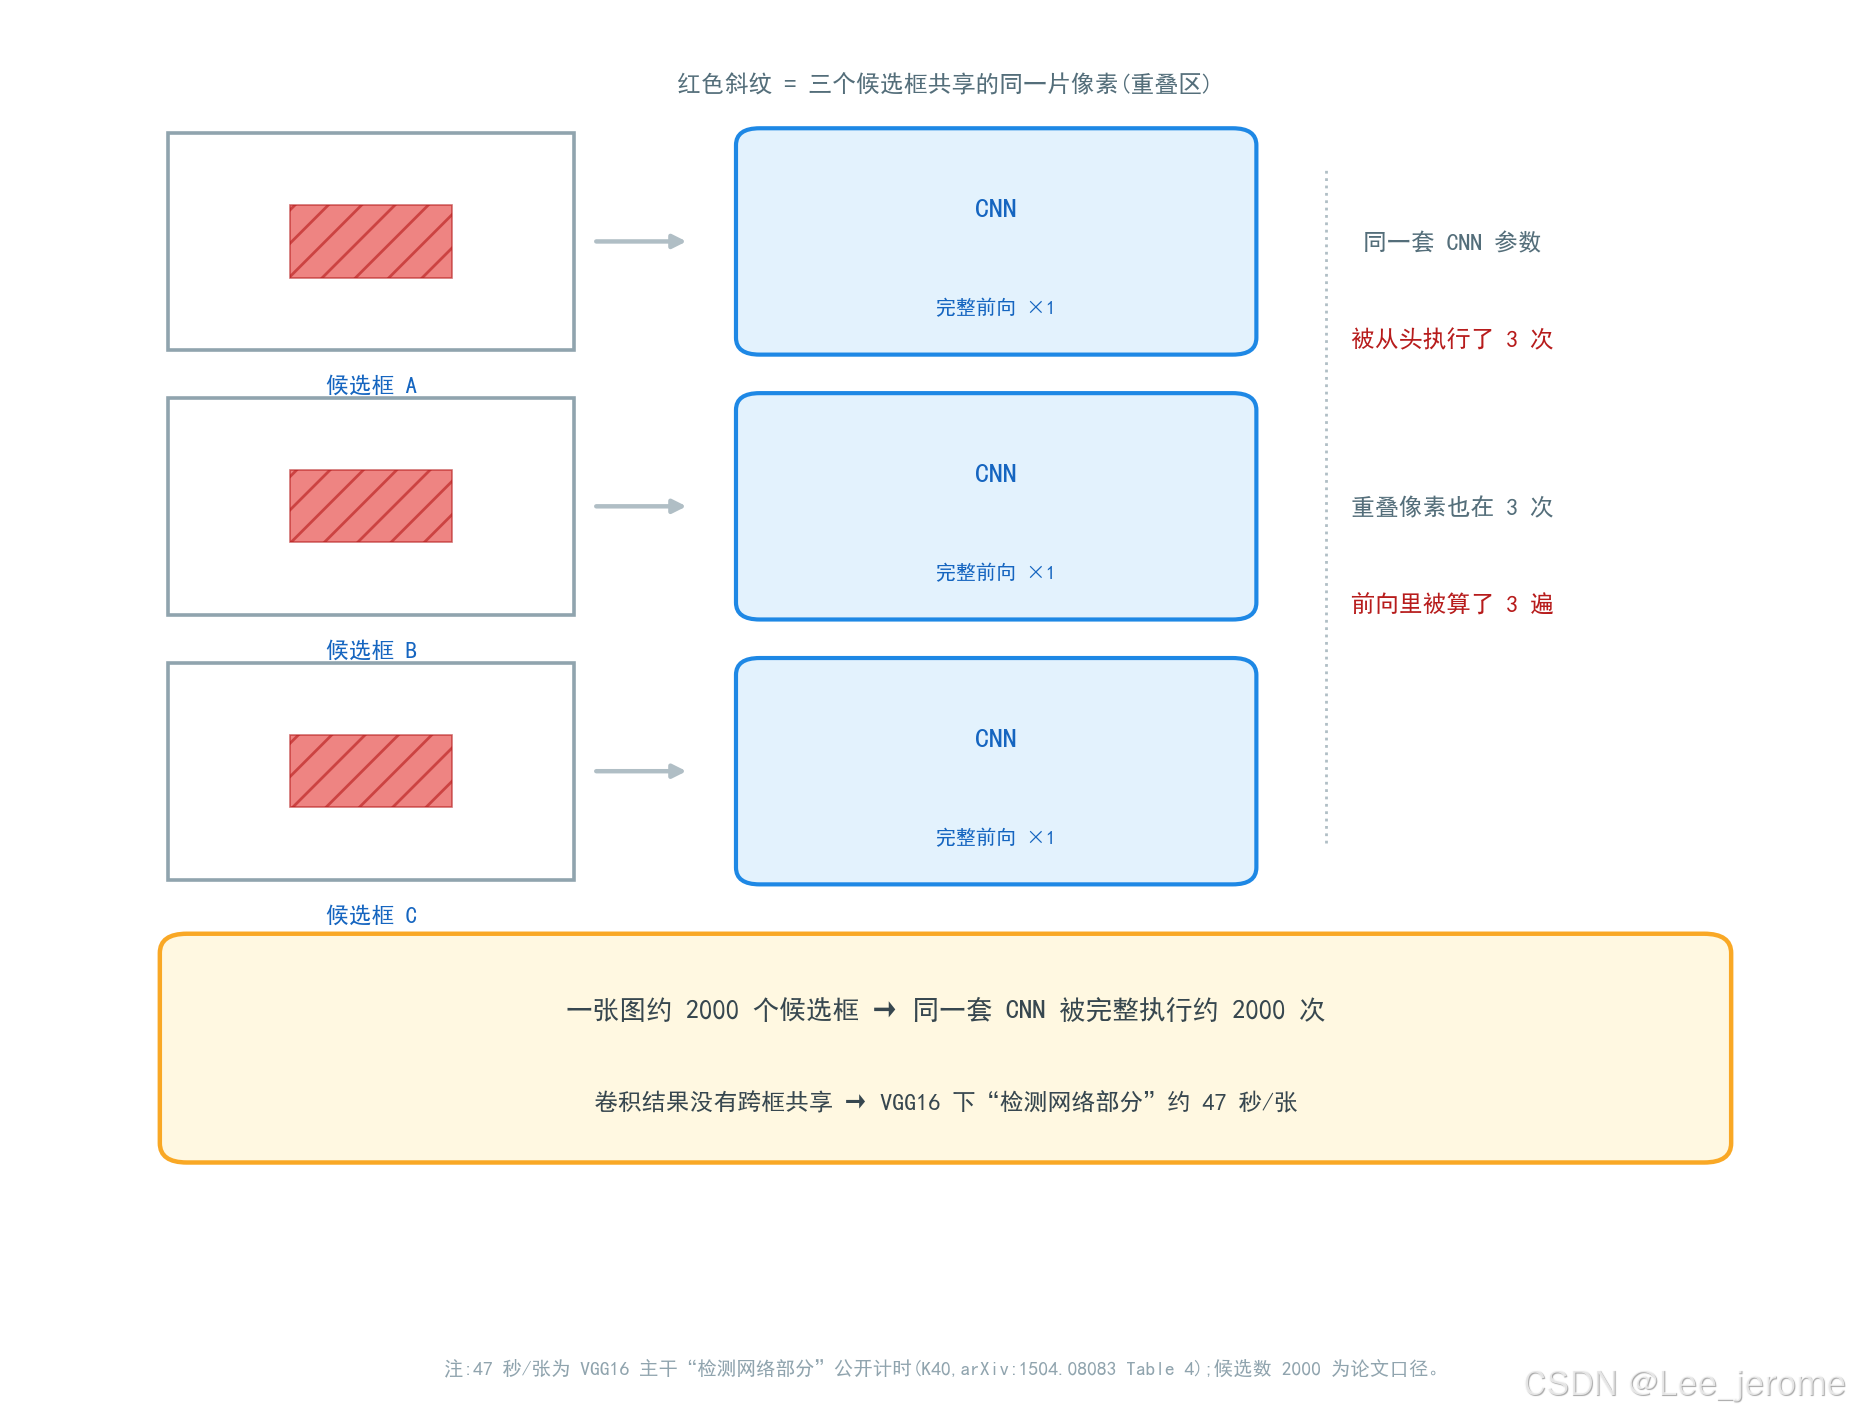
图 6|慢的根源示意:同一张图上的候选框高度重叠,却各自完整穿过一次 CNN,重叠区域被反复计算
🤔 怎么读这张图? 左上方是一张同时被三个候选框(蓝色虚线)圈住的图,框与框有大片重叠;中间每个候选框都被单独拉出来,各自从第一层卷积开始完整跑一遍 CNN(右侧蓝色块)。于是同一片重叠区域,在 3 次前向里被算了 3 遍——放到整张图上,就是约 2000 个候选框、约 2000 次完整前向。这张图只想说明一件事:慢的根源不在“算得重”,而在“算得重复”——同一张图的低级卷积结果,本可以只算一次、让所有候选框共享。
账单明细(均为论文公开口径):
| 花在哪 | 数量级 | 来源口径 |
|---|---|---|
| 候选框生成 + CNN 特征(测试) | GPU 约 13 秒/张,CPU 约 53 秒/张 | R-CNN 论文运行时分析(≈AlexNet 主干) |
| 检测网络部分(测试) | 约 47 秒/张 | VGG16 主干,K40 GPU,见 Fast R-CNN 同表对比 |
| 训练特征落盘 | 数百 GB,提取约 2.5 GPU 天 | VGG16,VOC2007 约 5 千张图 |
| 完整训练(VOC2007) | 约 84 小时 | VGG16 口径 |
5.3 成绩单:精度是怎么一级一级堆上去的?
把这套流水线的每一次“加零件”单独列出来,能看到一条清晰的精度爬坡:
| 一行改动 | CNN 主干 | VOC2007 test mAP |
|---|---|---|
| 仅用 ImageNet 预训练特征 + 每类 SVM(不做检测微调) | ≈ AlexNet(TorontoNet) | 46.2% |
| + 在检测候选框上微调 CNN | ≈ AlexNet | 54.2% |
| + 框回归修定位 | ≈ AlexNet | 58.5% |
| + 主干换成更深的 VGG16(OxfordNet) | VGG16 | 66.0% |
📌 注:上表引自 R-CNN 论文表 2(VOC2007 test,公开口径)。46.2% 对应未微调时表现最好的 fc6 层特征;54.2% 为微调后取 fc7;66.0% 与 5.2 表中的“47 秒 / 84 小时”同属 VGG16(OxfordNet)口径(Fast R-CNN 论文 Table 4 对 R-CNN 的逐行测量亦为 66.0%、47.0 秒、84 小时)。VOC2010 上框回归的效果为 50.2% → 53.7%(对比基准 DPM 为 33.4%)。不同论文评测时的 GPU 型号与实现略有差异,看趋势与数量级即可。
六、拆完再装回去:R-CNN 的账本与没还完的债
6.1 一张表看全整条流水线
| 环节 | 输入 | 核心工具 | 输出 | 主要代价 |
|---|---|---|---|---|
| 猜 · 找框 | 原图 | Selective Search(CPU 传统算法) | 约 2000 个候选框 | 秒级 CPU 开销;类别无关;可能漏检 |
| 认 · 提特征 | 候选框(warp 成 227×227) | ImageNet 预训练 + VOC 微调的 CNN | 2000×4096 维特征矩阵 | 每框一次完整前向 → 测试约 47 秒/张(VGG16,网络部分) |
| 定 · 判类 | 特征向量 | 每类一个线性 SVM(难例挖掘) | 每个候选框的各类分数 | 训练要离线缓存特征 |
| 定 · 去重 | 打分后的框 | 按类 NMS | 每类一个物体只留一个框 | 去重阈值需要调 |
| 定 · 修框 | pool5 特征 | 每类一个线性回归(IoU ≥ 0.6 样本) | 修正后的贴边框 | 多一段独立训练;VOC2007 约 +4 个点 |
📌 注:47 秒为 VGG16 主干“检测网络部分”的公开计时(K40,不含候选框生成的 CPU 时间),≈AlexNet 主干时“候选框 + 特征”约 13 秒/张(GPU);训练端数百 GB 特征缓存与 84 小时同为 VGG16 口径。所有数字见第五章账单表,详细出处见文末来源行。
6.2 三笔没还完的账
把流水线从头到尾拆完,“47 秒”已经不再是一个神秘数字,而是一笔一笔能对上的开销。顺着这台机器的结构往下想,还有三个问题无法在这一代内部解决:
- 重复计算:同一张图的低级卷积,为什么非要给 2000 个框各算一遍?能不能整张图只算一次、再按框的位置去“取”特征?
- 各自为政:CNN、SVM、回归器三段训练互不相通,分类的错误无法反向修正特征提取器——能不能把它们合成一个网络、用一个损失函数一次训完?
- 不会学习的“猜”:找框靠 CPU 上的传统算法,它不认语义、只会用颜色纹理猜测,还可能漏检——能不能让网络自己学会“哪里有物体”?
这三笔账,恰好就是系列路标中接下来两篇各自的主线:第 3 篇拆解 Fast R-CNN 的 RoI Pooling,看它如何共享卷积、把 47 秒压到 0.3 秒;第 4 篇拆解 Faster R-CNN 的 RPN,看网络如何学会自己“找框”。这台被拆开的“慢机器”虽然笨重,但它框出的每一个问题,都精确地指定了下一代要动的手术位置。
📚 数据与事实来源:R-CNN(Girshick et al., CVPR 2014, arXiv:1311.2524,微调/正负样本/阈值/难例挖掘/框回归及其 54.2%、58.5%、50.2%→53.7% 等见正文与表 2、附录 B/C;运行时“候选框+特征 13s/张(GPU)/53s/张(CPU)”见原文运行时分析)· Fast R-CNN(Girshick, ICCV 2015, arXiv:1504.08083,Table 4 同口径给出 R-CNN 66.0%、47.0s/张、84h、特征数百 GB 与 2.5 GPU 天)· Selective Search(Uijlings et al., IJCV 2013)· PASCAL VOC 评测口径(Everingham et al., IJCV 2010)。
更多推荐

 21
 0
- 0


 已为社区贡献9条内容

所有评论(0)