
美团LongCat-Flash-Thinking大模型技术深度解析,带你掌握模型融合秘籍!
前几天刚不久,美团发布了 LongCat-Flash-Chat,将大模型的“卷”带到了新高度。
而就在这两天,美团就发布了对应的推理模型 LongCat-Flash-Thinking。在保持了 LongCat-Flash-Chat 极致速度的同时,全新发布的 LongCat-Flash-Thinking 更强大、更专业。综合评估显示,LongCat-Flash-Thinking 在逻辑、数学、代码、智能体等多个领域的推理任务中,取得了不错的效果。
一、 训练细节
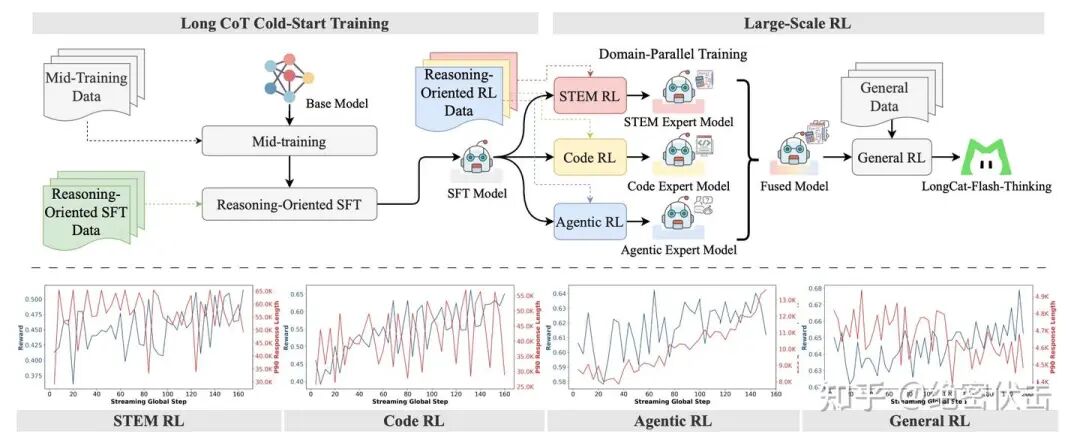
LongCat-Flash-Thinking 的训练流程与 GLM-4.5 十分相似。主要区别在于,GLM-4.5 在分领域强化学习之后,会直接对各个专家模型进行蒸馏,并最终统一到一次 SFT;而 LongCat-Flash-Thinking 则选择先对专家模型进行 Model Fusion,得到 Fused Model,再进入 General RL。下图展示了 GLM-4.5 与 LongCat-Flash-Thinking 的差异:
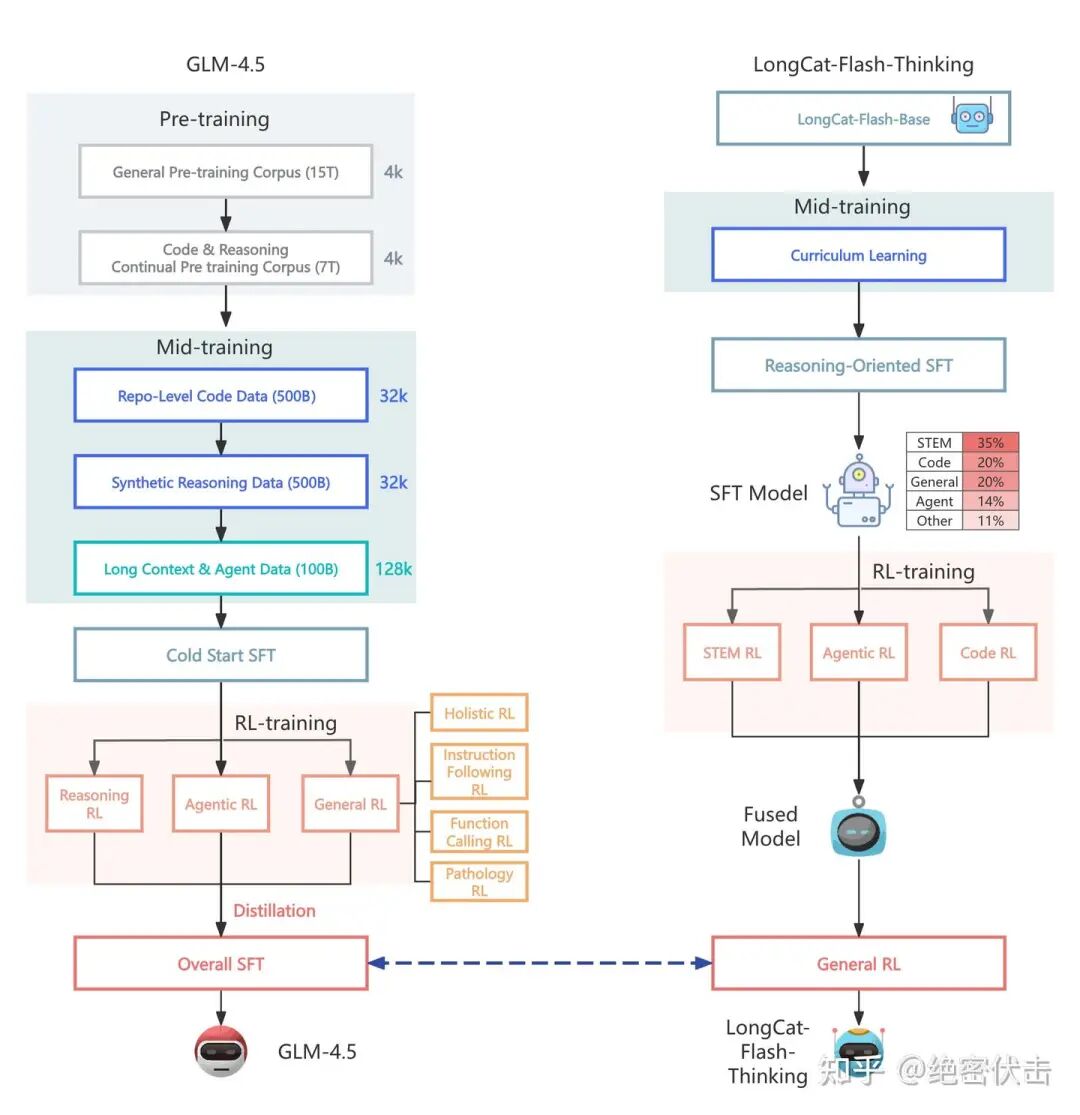
从上图可以看出,两者的核心区别在于对三个专家模型的处理方式。GLM-4.5 选择直接蒸馏三个专家模型,并在此基础上统一进行 SFT;而 LongCat-Flash-Thinking 则先将三个专家模型融合为一个 Fused Model,再进入通用强化。
除此之外,虽然在一些细节上可能存在差异,但整体方向大体一致。接下来,我们将重点介绍美团在模型融合上的具体做法。
- Model Fusion
===============
在 Large-Scale RL 阶段,得到了三个 领域专家模型:
- • STEM Expert Model(擅长数学和科学推理)
- • Code Expert Model(擅长代码生成与程序推理)
- • Agentic Expert Model(擅长工具调用和交互式任务)
问题在于:
- • 直接将不同领域的模型混合,会产生 参数干扰(interference)。
- • 有的参数更新可能互相冲突,甚至导致某些领域性能下降。
因此,需要一种 稳定的模型融合方法,将多个专家模型合并为一个 统一的 Fused Model,并尽可能保留各自优势。
2.1 Normalization(归一化任务向量)
每个领域的更新量定义为:
即 RL 之后的参数减去 SFT 基线参数
- • 不同领域的 可能尺度差异很大。
- • 解决方法:对它们做 归一化处理,保证每个领域在融合时权重相对均衡。
比如 L2 Norm 归一化 对每个任务向量 做:
这样每个领域的更新方向保留,但幅度被压到同一尺度。归一化后的向量再加权合并:
其中 可以是:
- • 等权重 (uniform):所有领域一样重要。
- • 性能加权 (performance-based):某领域在验证集表现更好,就赋予更大权重
2.2 Dropout(丢弃冗余参数)
在领域并行 RL 后,我们有三个专家模型:STEM、Code、Agentic。
- • 这些模型的参数更新( )往往存在 重叠的部分。
- • 举例:STEM 和 Code 都会更新某些 “通用推理” 参数,比如 attention 层的权重,方向差不多。
- • 如果直接把所有更新叠加,会导致 重复贡献 → 参数过大偏移 → 训练不稳定。
因此,需要一种方法来 削减冗余,这就是 Dropout。
- • 借鉴了 DARE (Domain-Aware Redundancy Erasing) 思路。
- • 对“重复更新”的参数,不是全部保留,而是 随机丢弃一部分,减少累积放大的效应。
举个例子,假设我们融合三个专家在某一参数 W 上的更新:
- • STEM:+0.10
- • Code:+0.12
- • Agentic:+0.11
这三个更新方向几乎一致,说明是 高度冗余。 如果直接相加:
→ 更新量过大,可能破坏训练稳定性。
引入 Dropout:
-
• 假设 Dropout rate = 0.33
-
• 随机丢弃其中一个更新,比如丢掉 STEM 的贡献:
-
• 这样仍然保留了方向(正向增强),但避免了三者累加过大。
2.3 Erase(擦除冲突更新)
- • 借鉴 SCE (Selective Conflict Erasing) 的思路。
- • 如果某个参数在不同专家模型中的更新方向冲突严重,且有一方属于“少数派”,则擦除掉少数派的更新。
例子:
- • STEM 模型:参数 W 增加 +0.2
- • Code 模型:参数 W 增加 +0.25
- • Agentic 模型:参数 W 减少 -0.8
- • 融合时发现:STEM 和 Code 一致,而 Agentic 方向相反且幅度大。
- • 采用 Erase:删除 Agentic 在该参数上的更新,只保留 STEM + Code 的共识更新。
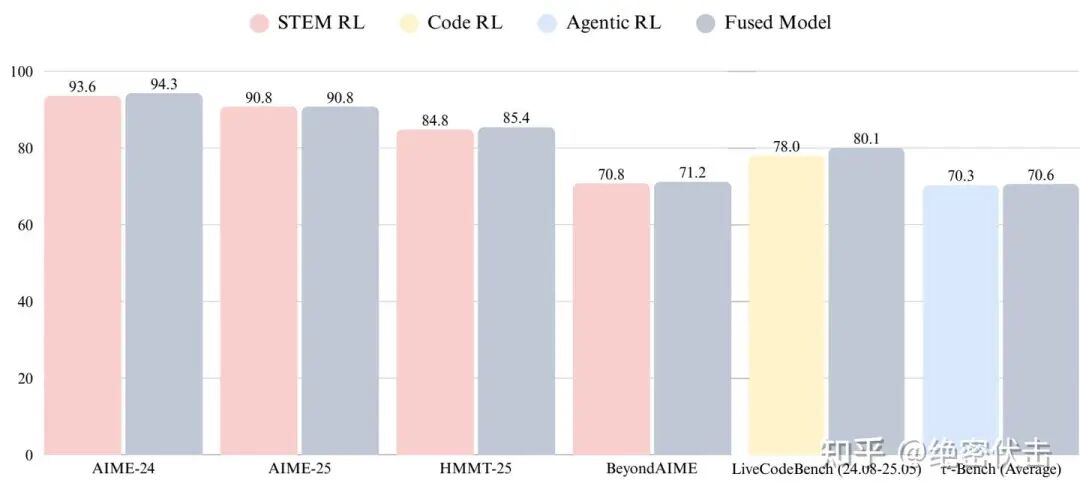
通过 Normalization + Dropout + Erase,最终得到一个 统一的 Fused Model。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一直在更新,更多的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
01.大模型风口已至:月薪30K+的AI岗正在批量诞生
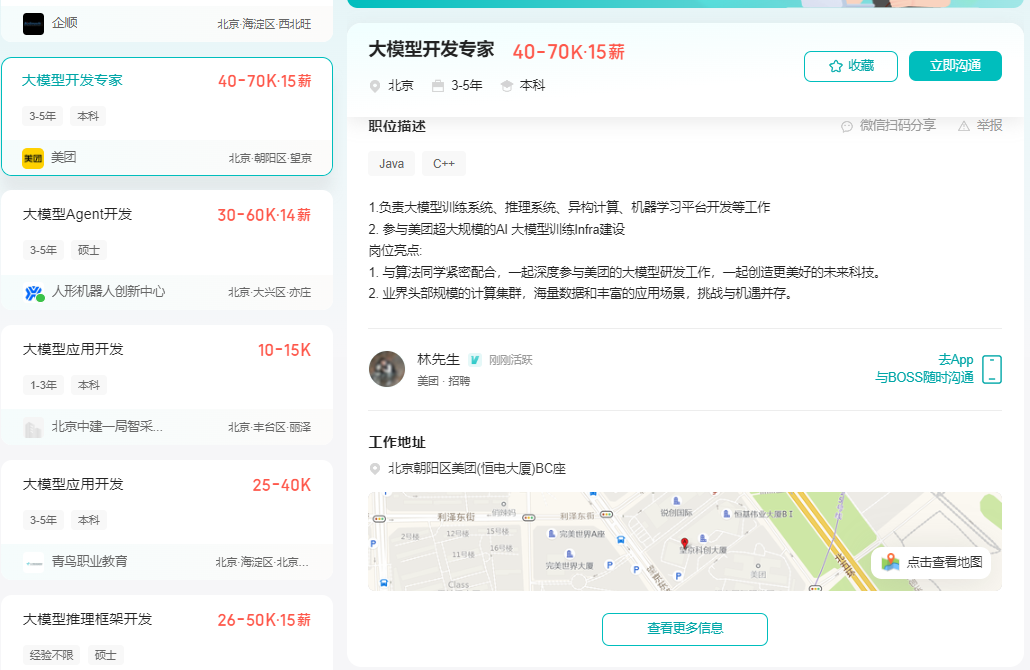
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K(数据来源:BOSS直聘报告)
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!
02.大模型 AI 学习和面试资料
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
更多推荐


 30
 0
- 0


 已为社区贡献476条内容

所有评论(0)