
【面试必备】AI大模型岗位攻略:机器学习知识点与经典考题大揭秘!
这份面试资料内容较完整,建议大家点赞 + 收藏,方便后续随时查看,避免需要时找不到;如果它帮到了你,也欢迎分享给身边有面试需求的朋友~
Q1: 什么是偏差(Bias)和方差(Variance)?如何理解它们与过拟合、欠拟合的关系?
答案:
-
•
偏差:模型预测值的期望与真实值之间的差异。衡量了模型的拟合能力。高偏差意味着模型过于简单,无法捕捉数据中的基本关系,导致欠拟合。
-
•
方差:模型预测值的变化范围或离散程度。衡量了模型的稳定性。高方差意味着模型过于复杂,对训练数据中的噪声过度学习,导致过拟合。
关系图解:
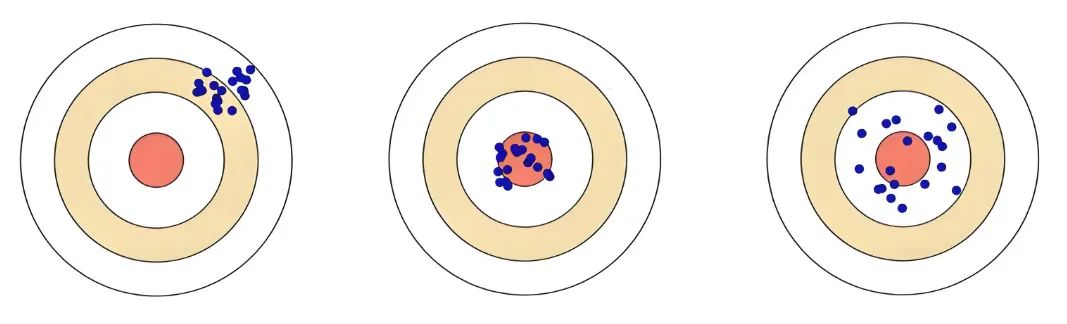
下图经典地展示了偏差-方差权衡(Bias-Variance Trade-off):
-
•
左列(欠拟合):弹孔全部集中在靶心外围,既不精确也不稳定。高偏差,低方差。
-
•
中列(理想):弹孔紧密集中在靶心附近,既精确又稳定。低偏差,低方差。
-
•
右列(过拟合):弹孔散落在靶心周围,平均位置可能在靶心,但非常不稳定。低偏差,高方差。
总误差主要由偏差、方差和不可避免的噪声构成。我们的目标是通过模型选择、正则化等手段,找到两者之间的最佳平衡点,使总误差最小。
Q2: 常用的模型评估指标有哪些?准确率(Accuracy)在什么情况下会失效?
答案:
常用指标:
- 分类问题:准确率(Accuracy)、精确率(Precision)、召回率(Recall)、F1-Score、ROC曲线与AUC值、PR曲线。
- 回归问题:均方误差(MSE)、平均绝对误差(MAE)、R平方(R²)。
准确率失效的场景:主要发生在数据分布极度不平衡的数据集上。
例子:在一个欺诈检测数据集中,正常交易(负样本)占99%,欺诈交易(正样本)占1%。如果一个模型简单地将所有样本都预测为“正常”,它的准确率高达99%,但这个模型是毫无用处的。
解决方案:在这种情况下,应使用精确率(预测出的欺诈中有多少是真的欺诈)、召回率(所有真实的欺诈中有多少被抓住了)和F1-Score(两者的调和平均)来评估模型。
Q3: 详细解释逻辑回归(Logistic Regression)的原理。它为什么是分类模型却叫“回归”?
**答案:
原理:
-
线性部分:首先,它和线性回归一样,计算输入特征的加权和:
z = w₁x₁ + w₂x₂ + ... + wₙxₙ + b。 -
激活函数:然后将线性结果
z输入到 Sigmoid函数 中,将输出压缩到(0, 1)区间:σ(z) = 1 / (1 + e^{-z})。这个值可以解释为样本属于正类的概率。 -
决策与损失:通过设定一个阈值(如0.5)来进行类别判断。使用交叉熵损失函数(而非均方误差)来衡量预测概率与真实标签的差异,并通过梯度下降法最小化损失来学习参数
w和b。
为什么叫“回归”:因为它的核心第一步(计算 z)来源于线性回归,是在用线性回归的思想去预测一个“概率值”,只不过后续加了一个非线性映射和决策过程,使其用于分类。它是对线性回归的扩展。
Q4: 简述决策树是如何构建的?以及它的核心算法ID3、C4.5和CART的区别?
答案:
构建过程(递归):从根节点开始,选择最佳特征对数据进行分割,直到满足停止条件(如节点样本数过少、纯度已足够高)。
选择最佳特征的标准:
******* ID3:使用信息增益(Information Gain)。InfoGain = H(D) - H(D|A),其中 H(D)是父节点的经验熵,H(D|A)是按特征A分割后的条件熵。它倾向于选择取值较多的特征。
-
C4.5:使用信息增益比(Gain Ratio),对ID3进行改进。
GainRatio = InfoGain / H_A(D),其中H_A(D)是特征A本身的熵。这克服了ID3偏向多值特征的缺点。 -
CART:使用基尼系数(Gini Index)。
Gini(p) = 1 - Σ p_i²,衡量数据的不纯度。基尼系数计算更快,且大多数情况下与信息熵的效果类似。******
一直在更新,更多的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
Q5: 解释一下XGBoost的原理和它相比传统GBDT的优势。
答案:
**********原理:XGBoost(eXtreme Gradient Boosting)是梯度提升决策树(GBDT) 的一种高效实现。它是一种加法模型,通过多轮迭代,每轮训练一个新的决策树来拟合前一轮模型的残差(负梯度),最终将多个弱学习器集成为一个强学习器。****
核心优势:
-
正则化:在目标函数中加入了L1/L2正则化项,有效控制模型复杂度,防止过拟合。
-
二阶泰勒展开:GBDT只用一阶导数,而XGBoost使用损失函数的一阶和二阶导数,可以更精准地逼近损失函数,从而更快地收敛。
-
并行处理:虽然Boosting是串行思想,但XGBoost在特征粒度上实现了并行,在寻找最佳分裂点时,预先对特征排序并存储为块结构,大大加快了计算速度。
-
灵活性:支持自定义损失函数(只需一阶和二阶可导)。
-
缺失值处理:内置机制能自动学习缺失值的分裂方向。
Q6: 反向传播(Backpropagation)算法是如何工作的?请描述其核心思想。
答案:
反向传播是神经网络训练的核心算法,其核心思想是链式法则。
工作流程:
-
前向传播:输入数据从输入层到输出层,逐层计算并存储每个神经元的输出值。
-
计算损失:在输出层计算预测值与真实值之间的损失(Loss)。
-
反向传播:将损失从输出层向输入层反向传播,利用链式法则计算损失函数相对于每一层权重和偏置的梯度。
-
•
∂L/∂W = (∂L/∂y) * (∂y/∂z) * (∂z/∂W),其中L是损失,y是输出,z是线性激活前的值,W是权重。
- 参数更新:使用优化器(如SGD、Adam)根据计算出的梯度更新网络中的所有权重参数(
W = W - η * ∂L/∂W)。
这个过程循环往复,直到模型收敛。
Q7: 缓解过拟合的常用技术有哪些?
答案:
***** •
数据层面:获取更多训练数据、数据增强(如图像旋转、裁剪)。
-
•
模型层面:简化模型(减少层数、神经元数)、Dropout(训练时随机丢弃一部分神经元,强制网络学习更鲁棒的特征)、权重正则化(L1/L2,给权重增加约束)。
-
•
训练技巧:早停(Early Stopping)(在验证集性能不再提升时停止训练)。
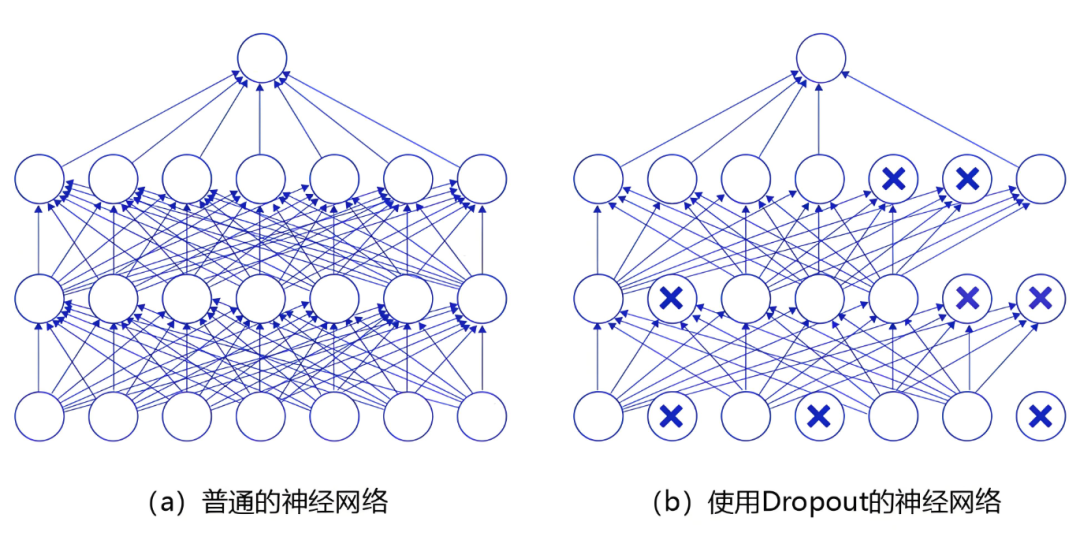
Dropout示意图:
-
•
左图:标准的全连接神经网络。
-
•
右图:应用Dropout之后,会将标了×的神经元从网络中删除,让它们不向后面的层传递信号。在学习过程中,丢弃哪些神经元是随机决定,因此模型不会过度依赖某些神经元,能一定程度上抑制过拟合。
Q8: CNN中的卷积层和池化层分别有什么作用?
答案:
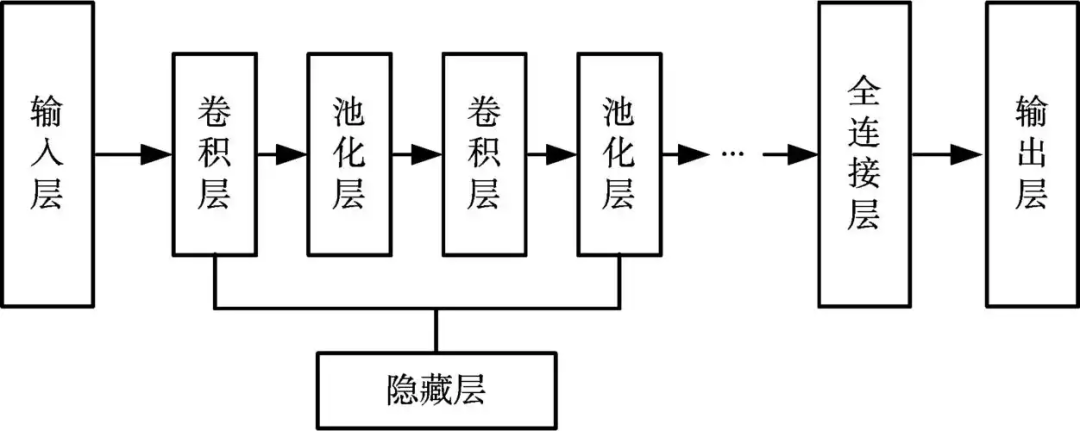
******卷积层(Convolutional Layer):
-
•
作用:使用卷积核(滤波器)在输入数据(如图像)上进行滑动窗口计算,提取局部特征(如边缘、角点、纹理等)。浅层卷积核提取低级特征,深层卷积核组合低级特征形成高级特征(如物体部件)。
-
•
参数共享:一个卷积核在整个输入上共享参数,极大减少了参数量。
池化层(Pooling Layer,如Max Pooling):
-
•
作用:降采样,减少特征图的空间尺寸(Width & Height)和参数量。从而增加感受野,使得网络关注是否存在某种特征而非其精确位置,提供一定的平移不变性并防止过拟合。
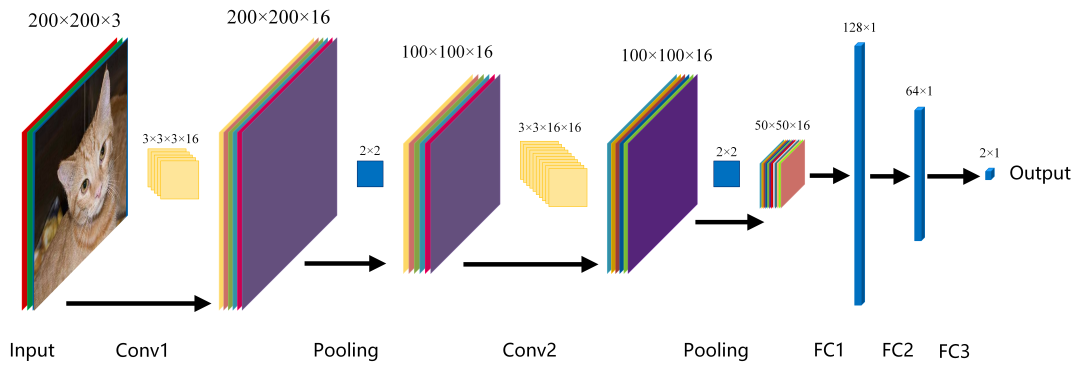
CNN特征提取示意图:
 Q9: 全量微调(Full Fine-tuning)存在什么问题?介绍两种参数高效微调(PEFT)技术。**
**答案:
全量微调问题:
-
计算和存储成本高:需要更新LLM所有数十亿的参数,需要大量GPU内存和时间。
-
灾难性遗忘:可能会破坏预训练模型中原有的通用知识。
-
模型管理困难:为每个下游任务都要保存一份完整的模型副本,非常笨重。
-
PEFT技术:
-
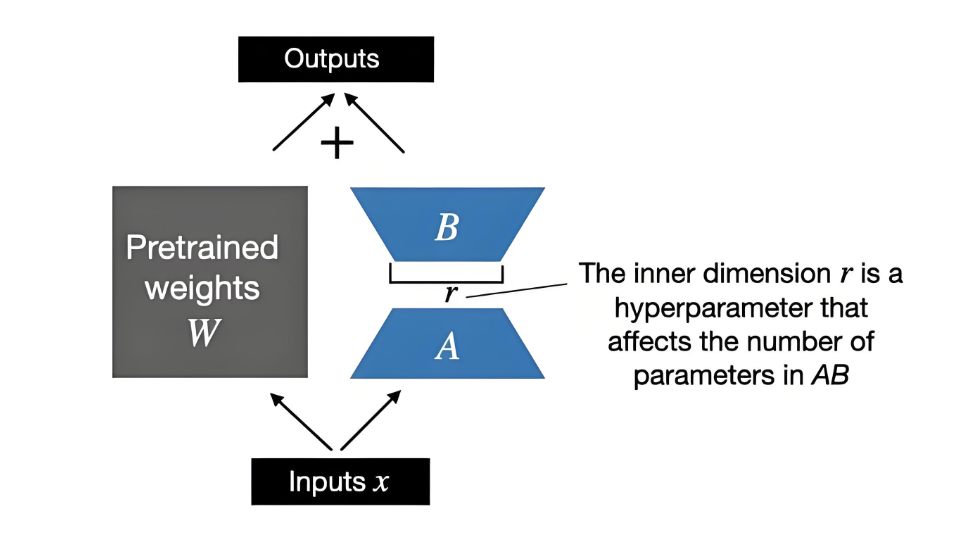
LoRA(Low-Rank Adaptation):核心思想是假设模型微调过程中的参数更新是低秩的。它冻结预训练模型权重,向模型注入可训练的低秩分解矩阵(A和B),只训练这些新增的参数。大大减少了可训练参数量(通常<1%)。
-
Prompt Tuning:冻结整个预训练模型,只在输入序列前添加一段可学习的软提示(Soft Prompts) 向量,通过训练这些提示向量来引导模型适应下游任务。比LoRA更轻量。
LoRA示意图:
Q10: 大模型推理阶段有哪些常见的优化技术?
****答案:
***** •
量化(Quantization):将模型权重和激活值从高精度(如FP32)转换为低精度(如INT8/INT4),减少内存占用和计算延迟。如GPTQ、AWQ等。
-
•
模型剪枝(Pruning):移除模型中不重要的权重或连接,减少模型大小。
-
•
知识蒸馏(Knowledge Distillation):用一个大模型(Teacher)来指导一个小模型(Student)学习,让小模型在性能损失不大的情况下获得更快的推理速度。
-
•
推理框架优化:使用专用推理框架如TensorRT、vLLM等,它们做了大量内核优化、算子融合、连续批处理(Continuous Batching)等,极大提升吞吐量。
Q11: 如果给你一个文本分类任务,但标注数据非常少(比如每类只有几十个样本),你会如何设计解决方案?
答案:
这是一个典型的小样本学习(Few-shot Learning) 场景。方案如下:
-
首选方案 - 大模型提示工程:直接使用ChatGPT/GPT-4等API,通过精心设计提示(Prompt)(如提供任务描述和少数几个示例),让其进行零样本/少样本推理。这是最快、成本最低的方案。
-
次选方案 - 微调大模型:如果API调用效果不佳或数据敏感,选择一个开源的基础模型(如LLaMA 3)。
-
•
使用PEFT技术(如LoRA) 在少量标注数据上进行高效微调。
-
•
利用数据增强技术生成更多训练样本(如回译、同义词替换)。
-
传统方案 - 微调小模型:如果计算资源极其有限,可以选用BERT等较小的预训练模型,在其上添加分类层并进行全量微调。但效果可能不如方案1和2。
-
评估:务必保留一个可靠的测试集来客观评估不同方案的效果。
Q12: 在设计一个面向用户的大模型应用(如聊天机器人)时,除了模型本身,还需要考虑哪些工程和技术问题?
答案:
这是一个系统设计问题,考察工程全局观。
-
•
1. 性能与延迟:如何优化推理速度(如模型量化、使用高性能推理框架)以满足用户对响应时间的期待。
-
•
2. 成本控制:如何管理API调用成本或自建模型的GPU推理成本。考虑缓存、异步处理、负载均衡等策略。
-
•
3. 可用性与可扩展性:如何设计后端服务架构(如微服务)以保证高可用性,并能进行水平扩展以应对流量高峰。
-
•
4. 数据与提示工程:如何构建和管理高质量的提示模板,如何利用检索增强生成(RAG) 技术接入外部知识库,以避免模型幻觉并提升回答质量。
-
•
5. 安全与合规:如何对用户输入和模型输出进行内容过滤,防止生成有害、有偏见或不合规的内容。如何保障用户数据隐私。
-
•
6. 监控与评估:建立完善的监控系统,跟踪API调用次数、延迟、错误率等指标。建立模型效果的线上评估体系(如收集用户反馈、A/B测试)。
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一直在更新,更多的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
01.大模型风口已至:月薪30K+的AI岗正在批量诞生
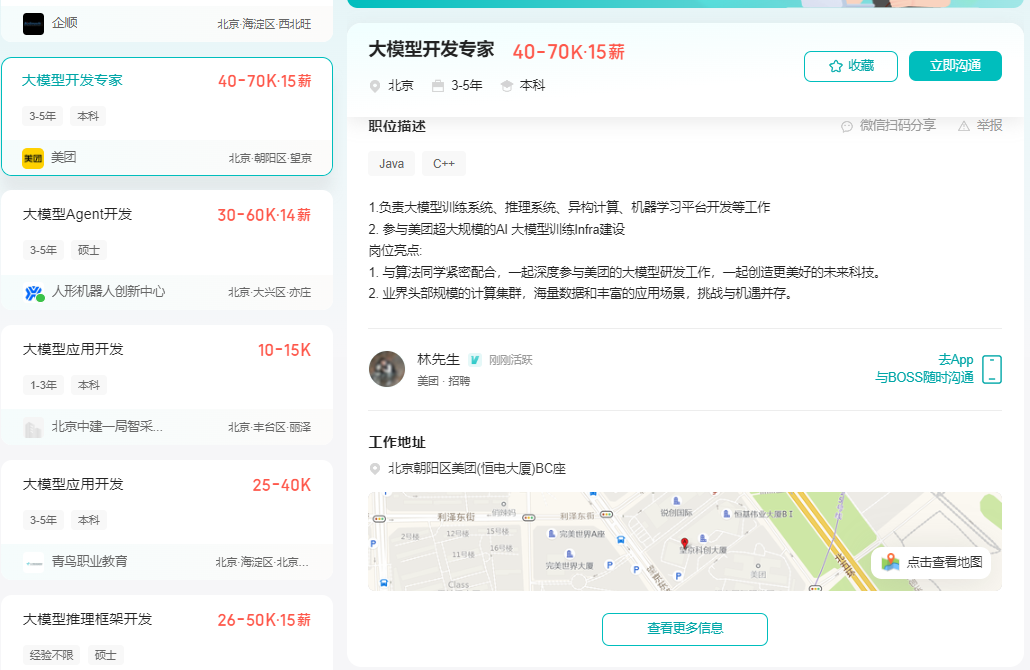
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K(数据来源:BOSS直聘报告)
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!
02.大模型 AI 学习和面试资料
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
更多推荐


 27
 0
- 0


 已为社区贡献500条内容

所有评论(0)