
大模型算法面试真题,秋招必刷~
是时候准备实习和面试了。
不同以往的是,当前职场已不再是那个双向奔赴时代了。求职者在变多,HC 在变少,岗位要求还更高了。
最近,我们又陆续整理了很多大厂的面试题,帮助一些球友解惑答疑,分享技术面试中的那些弯弯绕绕。
总结链接如下:

喜欢本文记得收藏、关注、点赞。更多实战和面试交流,加入我们
01
主流开源模型体系
目前主流的开源大语言模型体系大致分为三类:
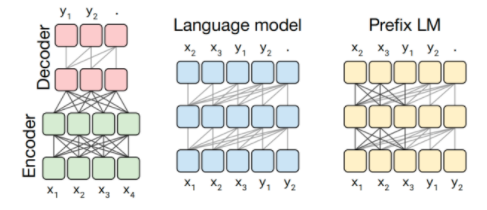
Prefix Decoder 系:
-
输入端:双向注意力(类似 Encoder)
-
输出端:单向注意力(类似 Decoder)
-
代表模型:ChatGLM、ChatGLM2、U-PaLM
-
特点:prefix 部分 token 互相可见,属于 Encoder-Decoder 折中方案
-
缺点:训练效率低
Causal Decoder 系:
-
注意力:严格自回归单向注意力,即从左到右
-
代表模型:LLaMA 系列及衍生物
-
特点:预训练和下游任务完全一致,zero-shot 表现最好
-
优点:训练效率高、zero-shot 能力强,具备涌现能力
-
缺点:输入语义理解能力相对不足
Encoder-Decoder 系:
-
输入端:双向注意力(更充分的语义理解)
-
输出端:单向注意力(生成时遵循因果性)
-
代表模型:T5、Flan-T5、BART
-
特点:在理解类任务表现好
-
缺点:长文本生成表现差,训练效率低
02
Attention Mask 的区别
设输入序列长度为 n,attention mask 矩阵 M ∈ ℝⁿˣⁿ:
(1)Encoder(双向注意力)
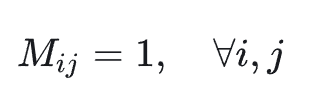
所有 token 都能互相看到,语义理解。
(2)Causal Decoder(单向注意力)
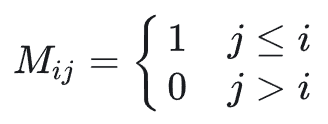
当前位置只能看到自身与之前的 token,因果律。
(3)Prefix Decoder(折中)
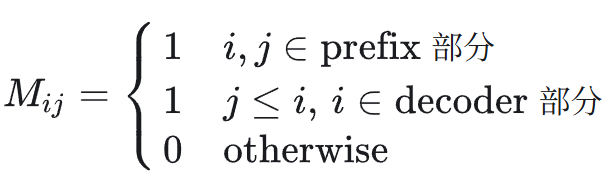
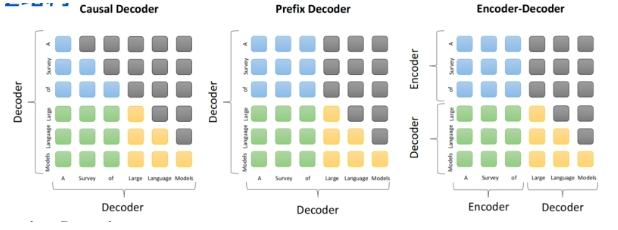
03
大模型训练目标
(1)最大似然估计(MLE)
根据已出现的 token,预测下一个 token(作文):
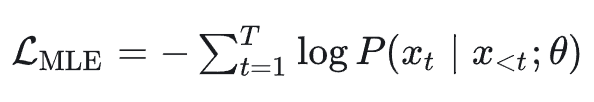
如下:
-
Causal Decoder:在所有 token 上计算损失
-
Prefix Decoder:仅在输出部分计算损失
(2)去噪自编码器(Denoising Autoencoder)
随机替换/打乱文本段,让模型恢复原始文本(完形):
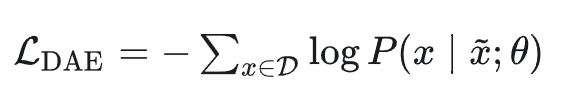
如下:
-
其中 x̃ 表示被随机破坏的输入
-
代表模型:T5、GLM-130B
-
难点:实现更复杂,训练效率更低
04
涌现能力的原因(猜测)
复杂任务由多个子任务组成,子任务性能随模型规模平滑提升,但整体任务指标可能出现“跳变”,表现为涌现能力。
模型容量与表示能力的非线性增强,随着参数量增加,模型可能跨越某种“能力门槛”。
比如我们假设某个任务 T 有 5 个子任务 Sub-T 构成,每个 sub-T 随着模型增长,指标从 40% 提升到 60%,但是最终任务的指标只从 1.1% 提升到了 7%,也就是说宏观上看到了涌现现象,但是子任务效果其实是平滑增长的。
05
为何大多数 LLM 采用 Decoder-only 结构?
原因如下:
-
Zero-shot 能力强:无需大量标注数据,也能在自监督学习下发挥最好性能。
-
训练效率高:与下游推理完全一致,工程更简洁。
-
理论上更优:Encoder 的双向注意力在生成任务中可能引入低秩问题,削弱表达能力。
-
参数利用效率:同等参数量下,Encoder-Decoder 结构分摊了参数;Decoder-only 全部用于生成,更高效。
06
Layer normalization
(1)Layer Norm
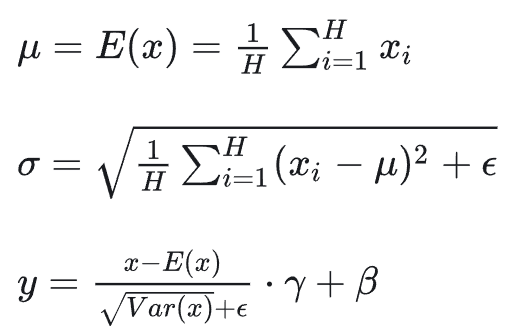
如下:
-
μ:特征的均值
-
σ:标准差,归一化的缩放因子
-
γ:可训练的缩放参数
-
β:可训练的偏移参数
-
ε:防止除零的小常数
Layer Norm 会对输入的每个 token 向量 按维度标准化,使其均值为 0、方差为 1,然后再通过 γ,β 学习恢复合适的分布。
(2)RMS Norm
RMSNorm 移除了均值项,只保留均方根 (Root Mean Square):
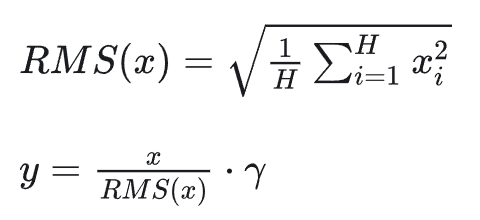
如下:
-
无 β 偏移项
-
只保留缩放参数 γ
-
计算更快,对训练稳定性也有帮助
RMS Norm 只控制输入的 尺度(scale),不调整均值,因此更轻量,常用于大型模型(如 GPT-3 变体、PaLM)。
RMS Norm 简化了 Layer Norm ,去除掉计算均值进行平移的部分。对比 LN,RMS Norm 的计算速度更快。效果基本相当,甚至略有提升。
(3)Deep Norm
Deep Norm 主要是为了解决训练非常深的 Transformer 时梯度不稳定的问题(比如 100+ 层):
-
执行 Layer Norm 之前,up-scale 了残差连接(alpha>1);
-
初始化阶段 down-scale 了模型参数(beta<1)
残差形式:
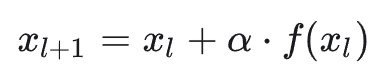
其中 α = 1/√(2N),N 为层数。在层与层之间的残差路径上控制信息流强度。这样可以避免残差累加过大导致梯度爆炸。
import torch.nn as nn
def deepnorm_init(w):
    if any(name in w.name for name in ['ffn', 'v_proj', 'out_proj']):
        nn.init.xavier_normal_(w, gain=math.sqrt(2.0))
    elif any(name in w.name for name in ['q_proj', 'k_proj']):
        nn.init.xavier_normal_(w, gain=1.0)
LN 在 LLMs 中的不同位置区别?
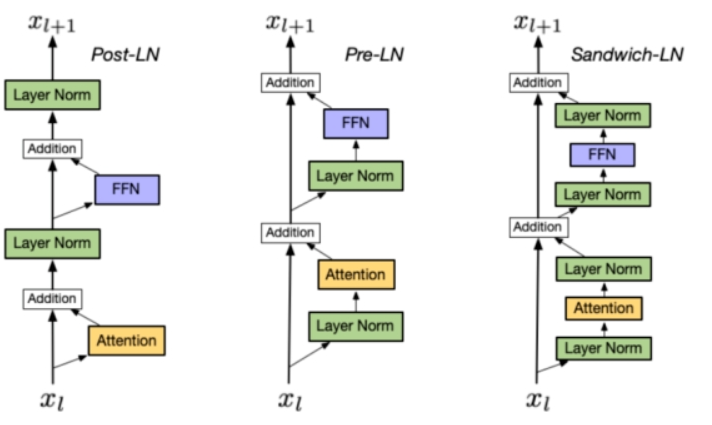
Post-LN:
-
位置:layer norm 在残差链接之后
-
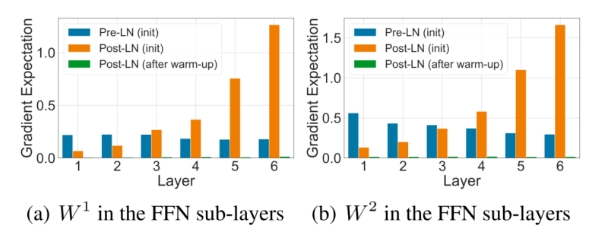
缺点:Post-LN 在深层的梯度范式逐渐增大,导致使用 post-LN 的深层 transformer 容易出现训练不稳定的问题
-
输出质量高,深层训练难
Pre-LN:
-
位置:layer norm 在残差链接中
-
优点:相比于 Post-LN,Pre-LN 在深层的梯度范式近似相等,所以使用 Pre-LN 的深层 transformer 训练更稳定,可以缓解训练不稳定问题
-
缺点:相比于 Post-LN,Pre-LN 的模型效果略差
-
深层稳定,略牺牲输出质量
Sandwich-LN:
-
位置:在 pre-LN 的基础上,额外插入了一个 layer norm
-
优点:Cogview 用来避免值爆炸的问题
-
缺点:训练不稳定,可能会导致训练崩溃。
-
极深防爆,普通训练易崩
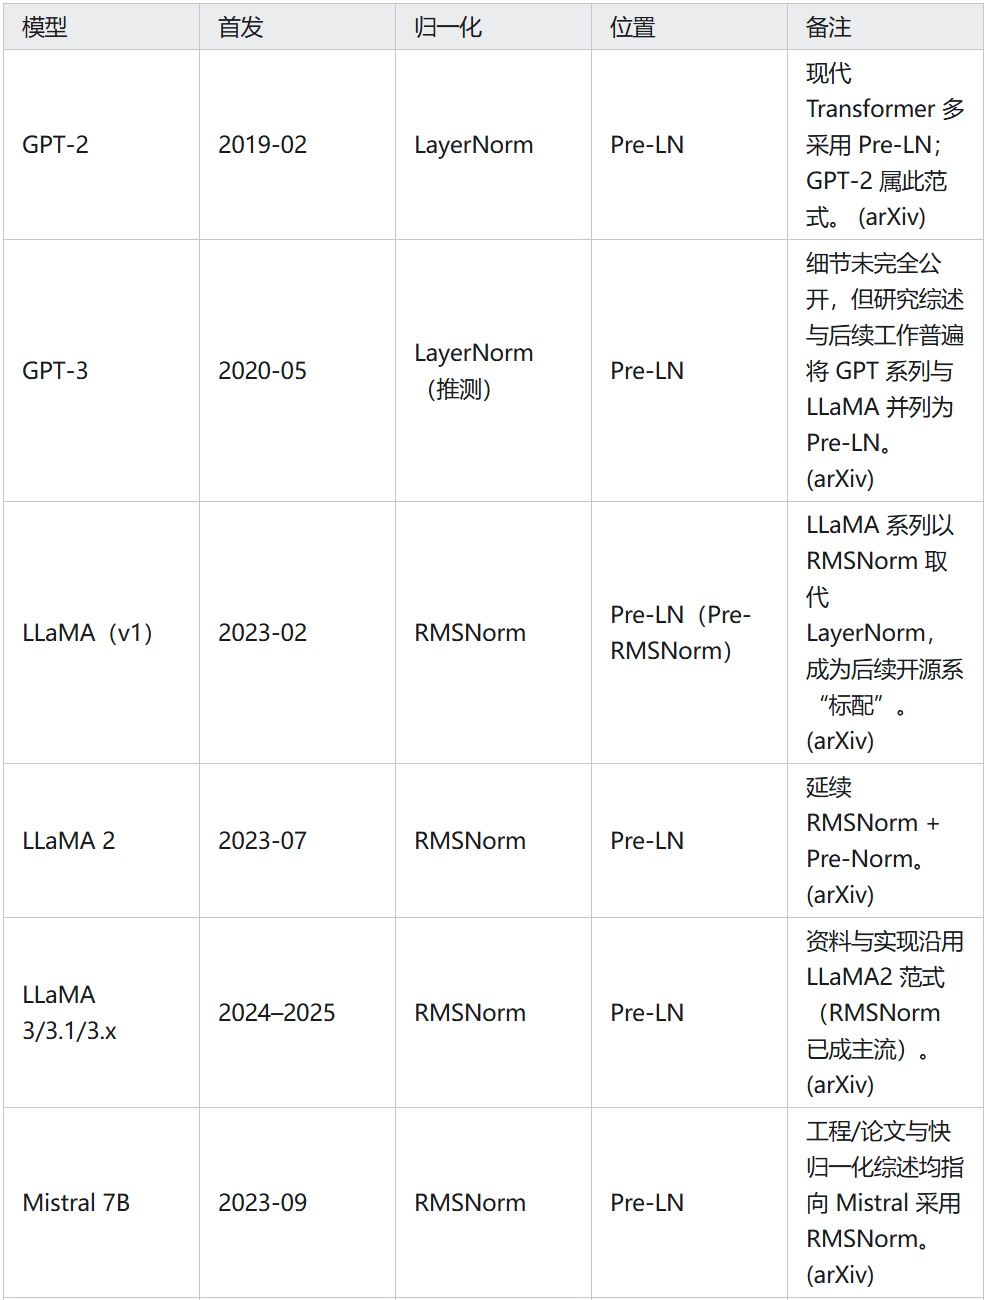
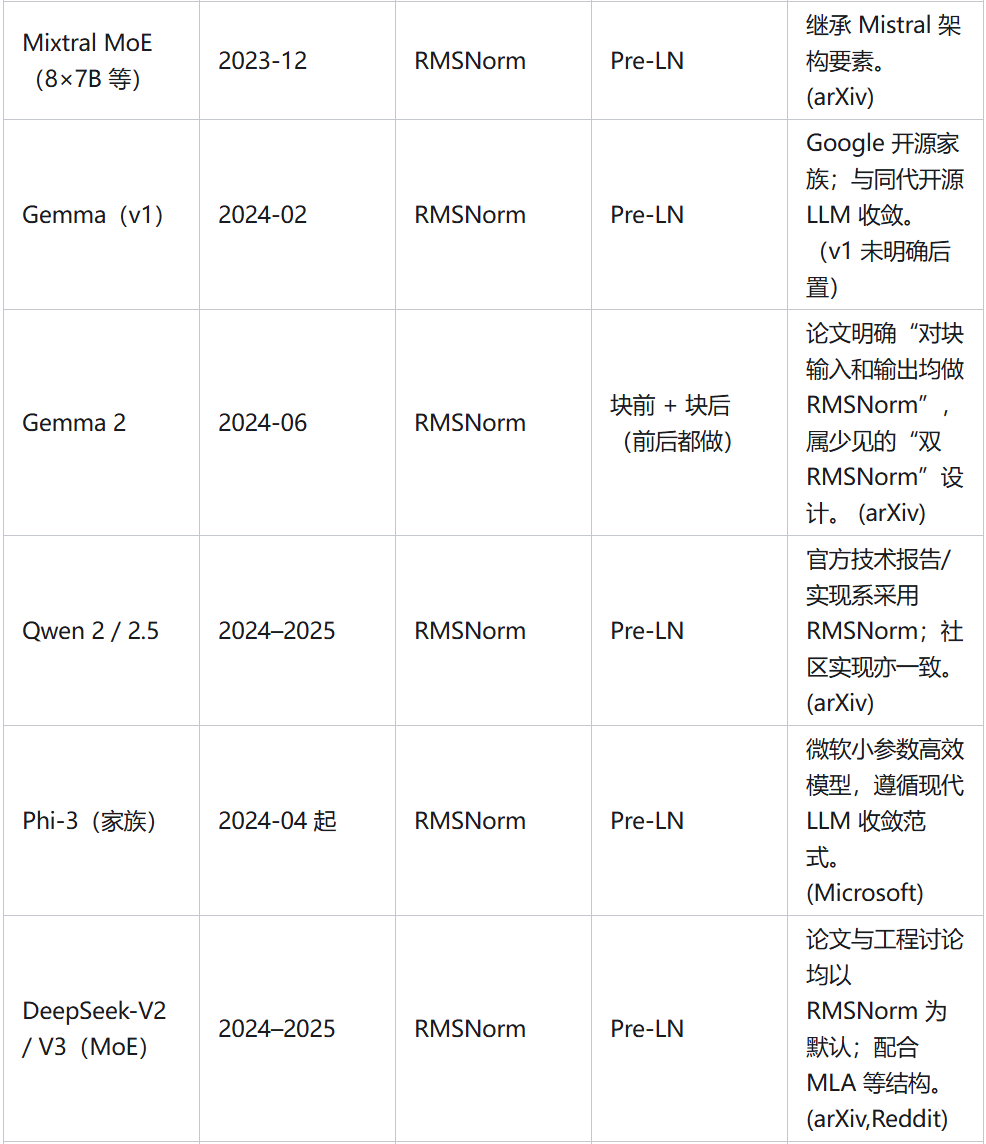
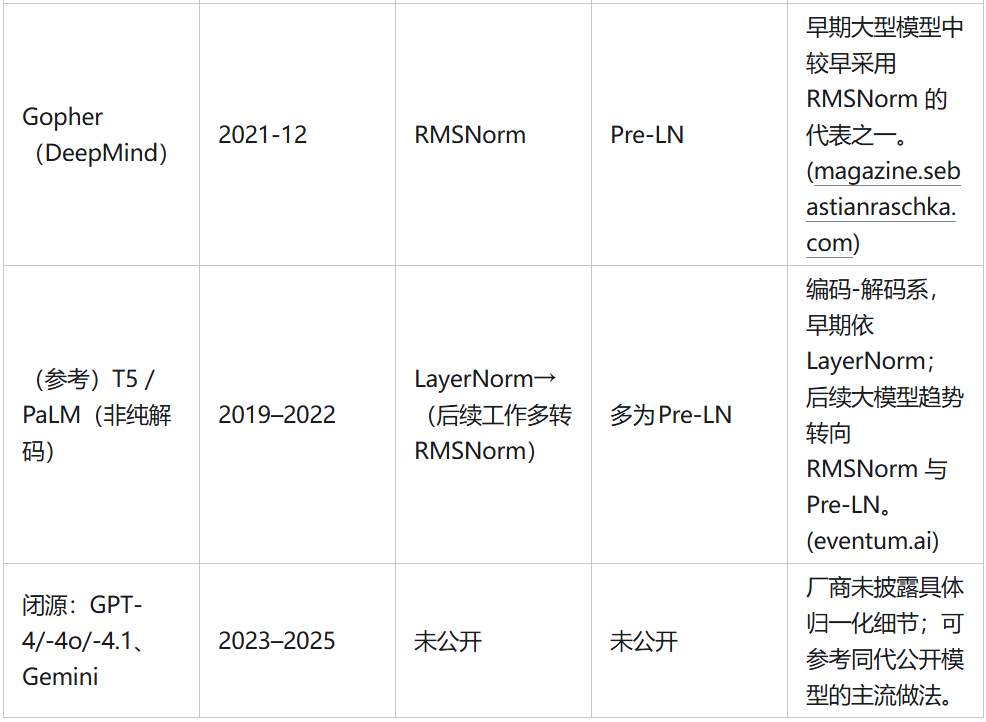
LLMs 各模型分别用了哪种 Layer normalization?
07
LLMs 激活函数
FFN(前馈层)基本计算公式:
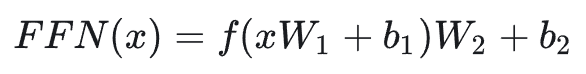
如下:
-
输入:向量 x ∈ ℝᵈ
-
权重:
-
W₁ ∈ ℝᵈˣᵈᶠᶠ
-
W₂ ∈ ℝᵈᶠᶠˣᵈ
-
偏置:b₁, b₂
-
激活函数:f(·) 可以是 ReLU / GeLU / Swish 等
-
中间维度:dᶠᶠ = 4d(通常 Transformer 默认 4 倍扩展)
FFN 是在每个 token 上独立应用的两层 MLP。先升维(扩展到更高维度空间),再激活,再降维回去。
GeLU 激活函数:
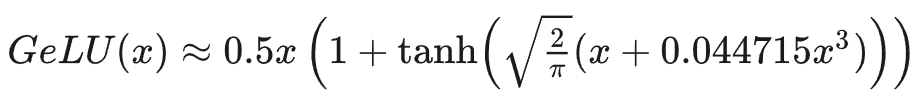
如下:
-
特点:平滑版本的 ReLU,不是硬性截断,而是概率化地保留输入。
-
效果:对小值衰减,对大值接近线性。让模型既保留微弱信号,又对强信号线性响应,从而提高表达力和训练稳定性。
-
应用:BERT、GPT 系列广泛采用 GeLU。
Swish 激活函数:
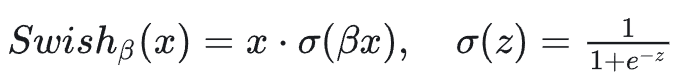
如下:
-
特点:平滑、非单调激活函数,比 ReLU/GeLU 更灵活。
-
效果:根据输入大小平滑放大或抑制信号,使信息流更灵活且梯度传播更稳定。
-
特殊情况:当 β=1 时就是常见的 Swish。
-
应用:在 EfficientNet、部分 LLM 变种中使用。
GLU(门控线性单元):
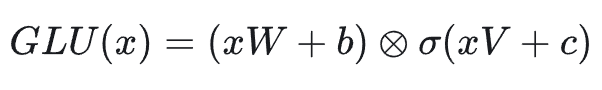
如下:
-
⊗ 表示逐元素乘法
-
W, V ∈ ℝᵈˣᵈᶠᶠ
-
输出由“值部分”和“门控部分”组合而成。
用 GLU 替换 FFN 的写法:
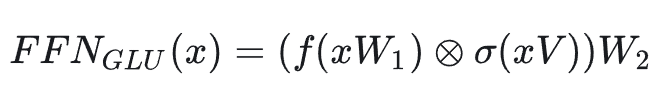
引入门控机制可以选择性地传递信息,类似 LSTM 的思想。允许重要信息通过,提高表达能力同时控制计算冗余。
GeLU-GLU 变体:
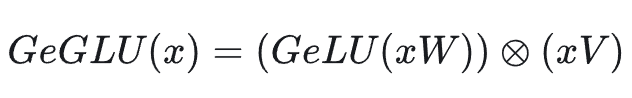
如下:
-
值路径:xW 经过 GeLU 激活
-
门路径:xV 直接作为调制因子
-
应用:T5(Google 的大规模预训练模型)采用 GeGLU。
-
把平滑激活和门控结合,在 FFN 中既筛选重要特征,又可调节信息流,让模型表达力增强且训练稳定。
Swish-GLU 变体:
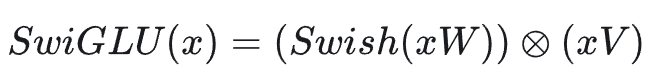
如下:
-
值路径:xW 经过 Swish 激活
-
门路径:xV 直接作为调制因子
-
应用:PaLM(Google 超大规模 LLM)采用 SwiGLU。
-
将柔性调节(Swish)与门控结合,使 FFN 在保留细微信号的同时有选择性地传递信息,优化梯度流和训练稳定性,尤其适合超大模型。
参数量比较:
-
标准 FFN:2 个权重矩阵(W₁, W₂),中间维度通常是 4d。
-
GLU 变体:需要 3 个权重矩阵(W, V, W₂),为了控制参数量,中间维度通常改为 (2/3) · 4d = 8/3 d。这样总体参数和计算量与标准 FFN 大致持平。
LLMs 中常用的激活函数选择:
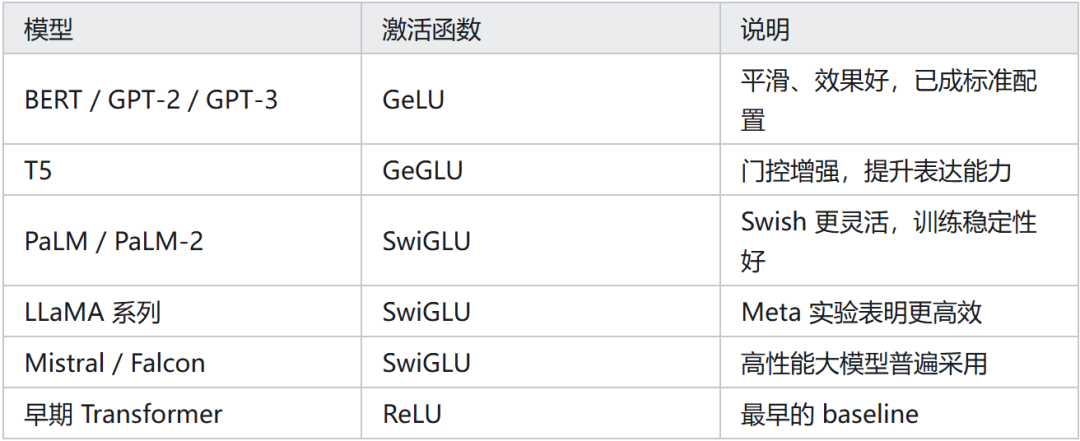
08
Attention
传统 Attention 存在哪些问题?
-
传统 Attention 存在 上下文长度 约束问题;
-
传统 Attention 速度慢,内存占用大;
Attention 优化方向:
-
提升上下文长度
-
加速、减少内存占用
Attention 变体有哪些?
-
稀疏 attention。将稀疏偏差引入 attention 机制可以降低了复杂性;
-
线性化 attention。解开 attention 矩阵与内核特征图,然后以相反的顺序计算 attention 以实现线性复杂度;
-
原型和内存压缩。这类方法减少了查询或键值记忆对的数量,以减少注意力矩阵的大小;
-
低阶 self-Attention。这一系列工作捕获了 self-Attention 的低阶属性;
-
Attention 与先验。该研究探索了用先验 attention 分布来补充或替代标准 attention;
-
改进多头机制。该系列研究探索了不同的替代多头机制。
Multi-head Attention 存在什么问题?
-
训练:不会显著影响训练过程,训练速度不变,会引起非常细微的模型效果损失;
-
推理:反复加载 KV cache , 导致内存开销大,性能是内存受限;
介绍 Multi-Query Attention?
Multi-Query Attention 在所有注意力头上共享 key 和 value。
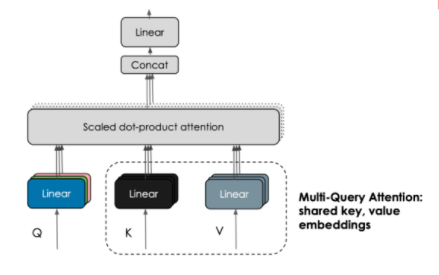
对比 Multi-head Attention 和 Multi-Query Attention?
-
Multi-head Attention:每个注意力头都有各自的 query、key 和 value。
-
Multi-query Attention:在所有的注意力头上共享 key 和 value。
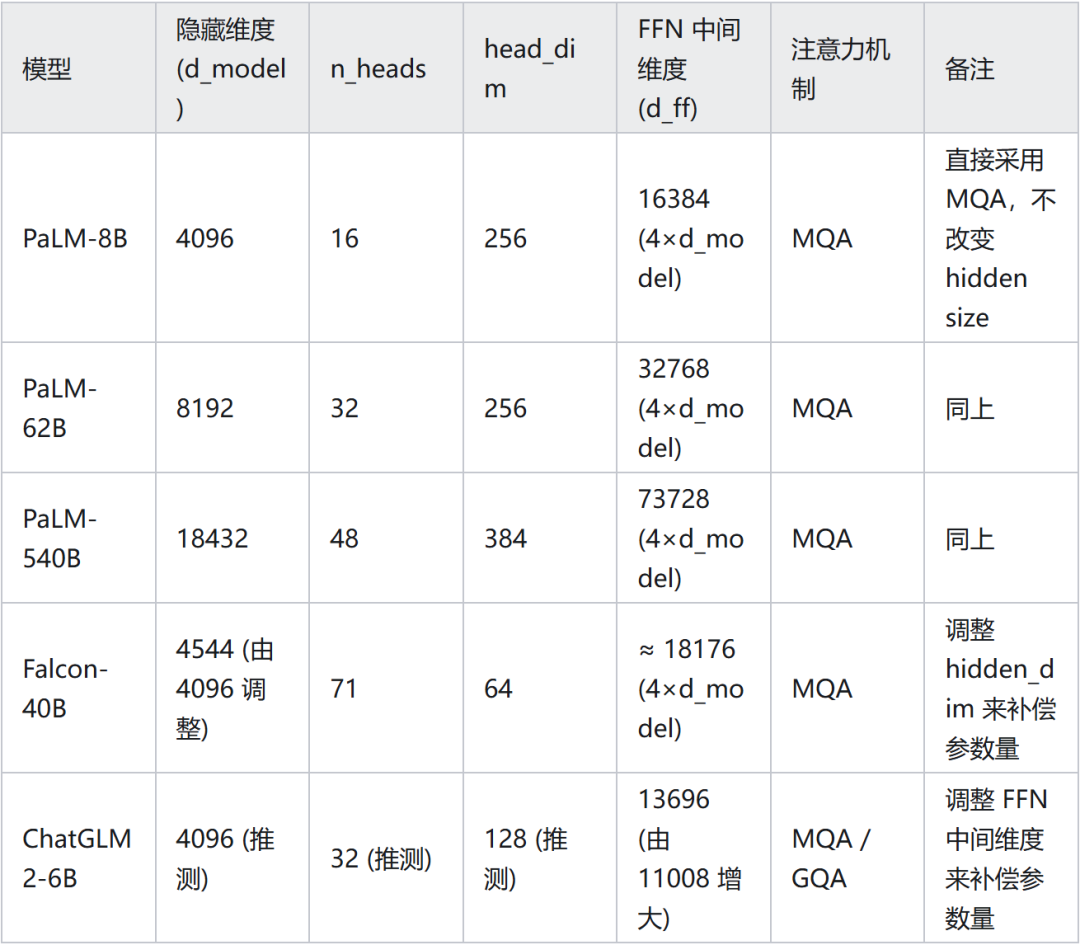
PaLM:直接使用 Multi-query Attention,保持 hidden size 和 FFN 结构 不变。
Falcon:为了保持总参数量一致,将隐藏维度从 4096 增大到 4544,多余参数分配给 Attention 和 FFN。
ChatGLM2-6B:采用 MQA / GQA 混合策略,将 FFN 中间维度从 11008 增加到 13696,多余参数分配给 FFN。
Multi-Query Attention 这样做的好处是什么?
减少 KV cache 的大小,减少显存占用,提升推理速度。
有哪些模型是使用 Multi-Query Attention?
代表模型:PaLM、ChatGLM2、Falcon 等
什么是 Grouped-query Attention?
介于 multi head 和 multi query 之间,多个 key 和 value。
有哪些大模型使用 Grouped-query Attention?
ChatGLM2,LLaMA2-34B/70B 使用了 Grouped query attention。
FlashAttention:
-
核心:用分块 softmax 等价替代传统 softmax
-
优点:节约 HBM,高效利用 SRAM,省显存,提速度
-
代表模型:Meta 推出的开源大模型 LLaMA,阿联酋推出的开源大模型 Falcon 都使用了 Flash Attention 来加速计算和节省显存
-
关键词:HBM、SRAM、分块 Softmax、重计算、Kernel 融合。
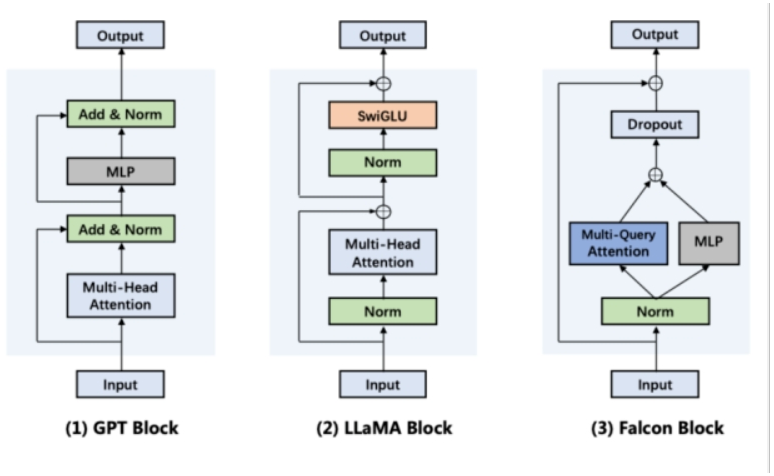
并行 transformer block:
-
用并行公式替换了串行,提升了 15%的训练速度。
-
在 8B 参数量规模,会有轻微的模型效果损失;在 62B 参数量规模,就不会损失模型效果。
-
Falcon、PaLM 都使用了该技术来加速训练
更多推荐
 36
 0
- 0


 已为社区贡献1条内容

所有评论(0)