
基于spark+hadoop基于大数据的人口普查收入数据分析与可视化系统
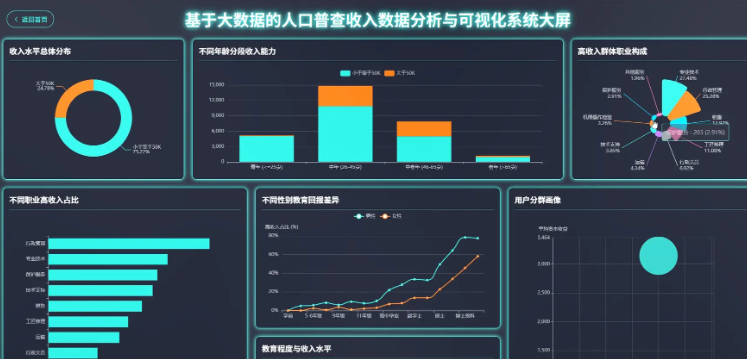
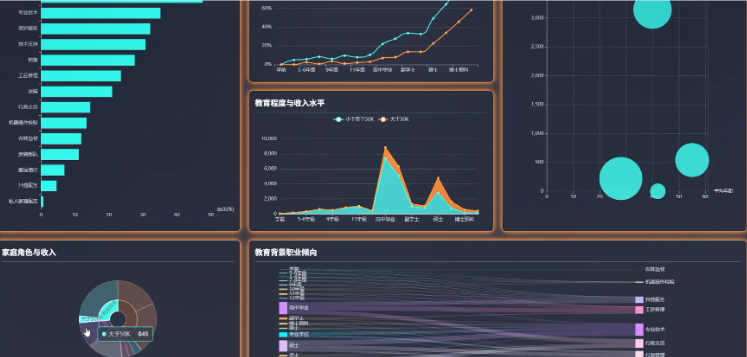
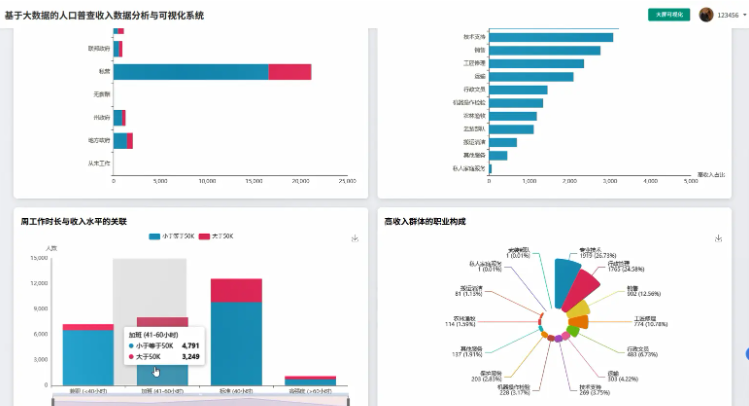
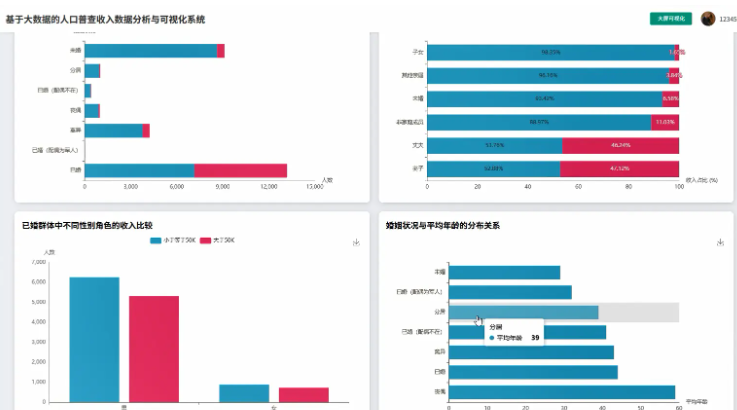
随着国家统计工作的不断完善和大数据时代的到来,人口普查数据作为反映社会经济发展状况的重要指标,其数据量呈现爆发式增长趋势。传统的数据分析方法在面对包含数百万甚至上千万条记录的人口普查数据时,往往存在处理效率低下、分析维度单一、结果展示不够直观等问题。与此同时,政府部门、研究机构以及企业组织对于人口收入分布规律、影响因素关联性、群体特征差异等深层次信息的需求日益增长,需要更加强大和灵活的数据分析工具来支撑决策制定。大数据技术的快速发展为解决这些挑战提供了新的思路,Hadoop生态系统的成熟应用证明了分布式计算在处理海量数据方面的巨大优势,而Spark作为新一代内存计算引擎,在数据处理速度和分析能力方面都有了显著提升。在这样的技术背景下,开发一个专门针对人口普查收入数据的大数据分析与可视化系统,既是对现有技术能力的实际应用,也是满足实际业务需求的有效尝试。本课题的研究和实现具有多方面的实际价值和学习意义。从技术角度来看,通过构建完整的大数据处理链路,能够深入理解Hadoop、Spark、Hive等核心技术的工作原理和协同机制,掌握从数据存储、计算处理到结果展示的全流程开发经验,这对于提升大数据技术的实际应用能力很有帮助。从应用角度来看,人口普查数据分析是社会科学研究和政策制定的重要工具,通过多维度的收入影响因素分析,可以为相关研究人员提供数据支撑,虽然作为一个毕业设计项目,其分析深度和应用范围相对有限,但仍然能够展示大数据技术在社会统计领域的应用潜力。从学习价值来看,这个项目涵盖了前后端开发、大数据处理、数据可视化等多个技术领域,有助于建立完整的技术知识体系。另外,通过实际的数据处理和分析过程,能够培养数据敏感性和统计思维能力,这些技能在未来的职业发展中都会很实用。当然,作为一个学习性质的项目,我们也要认识到其局限性,它更多的是一次技术实践和能力培养的机会,而不是要解决什么重大的社会问题。
大数据框架:Hadoop+Spark(本次没用Hive,支持定制) 开发语言:Python+Java(两个版本都支持) 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持) 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy 数据库:MySQL
更多推荐


 3
 0
- 0


 已为社区贡献31条内容

所有评论(0)