
大模型中的KVCache是什么
目录
写在前面
小伙伴们肯定发现了,现在的大模型推理速度越来越快,甚至有的文本大模型已经可以实现“腹泻式”输出。其实优化速度的手段有很多,其中一个就是KVCache 。
KVCache 是一种用于加速大模型自回归生成(逐词输出)过程的关键技术。它通过缓存之前所有计算过的键(Key)和值(Value)向量,避免在生成每个新词时都对整个历史序列进行重复计算,从而将推理速度提升数倍。
KVCache就像是给大模型一个“记忆便签”,让它不用在说长句子时,反复回想前面已经说过的每一个字。
一、自回归生成与注意力机制
要理解 KVCache,首先需要了解大模型是如何工作的:
1.自回归生成
像 GPT、LLaMA 这样的大模型,在生成文本时是一个词一个词(或一个 token 一个 token)地进行的。当它生成第 t 个词时,它需要将前面生成的 t-1 个词作为输入。
输入: [词1, 词2, ..., 词t-1]
输出: 词t
2.自注意力机制
模型的核心是 Transformer 的自注意力层。在自注意力中,每个输入 token 都会生成三个向量:
Query:用于“询问”其他 token 的信息。
Key:用于“回答”其他 token 的询问,代表自己的身份标识。
Value:包含该 token 的实际信息内容。
注意力分数的计算方式是:。简单来说,就是当前 token 的 Q 与序列中所有 token 的 K 进行匹配,得到一个权重分布,然后用这个权重对所有 token 的 V 进行加权求和。
二、没有 KVCache 时的计算浪费
假设我们正在生成一句话:“我今天下午想去公园散步”。
生成第 1 个词 "我":
输入序列长度 = 1 ([“我”])。
模型为 "我" 计算 Q, K, V。注意力只在 "我" 自身进行。
生成第 2 个词 "今天":
输入序列长度 = 2 ([“我”, “今天”])。
模型需要为 "我" 和 "今天" 重新计算 所有层的 K 和 V。
但请注意,"我" 的 K 和 V 在第一步已经计算过了!这里进行了重复计算。
生成第 3 个词 "下午":
输入序列长度 = 3 ([“我”, “今天”, “下午”])。
模型再次为 "我", "今天", "下午" 重新计算 所有 K 和 V。
"我" 和 "今天" 的 K, V 又被重复计算了。
随着生成序列的增长,这种重复计算的开销会变得巨大,因为计算量大致与序列长度的平方(O(n²))相关。这非常低效。
三、引入 KVCache
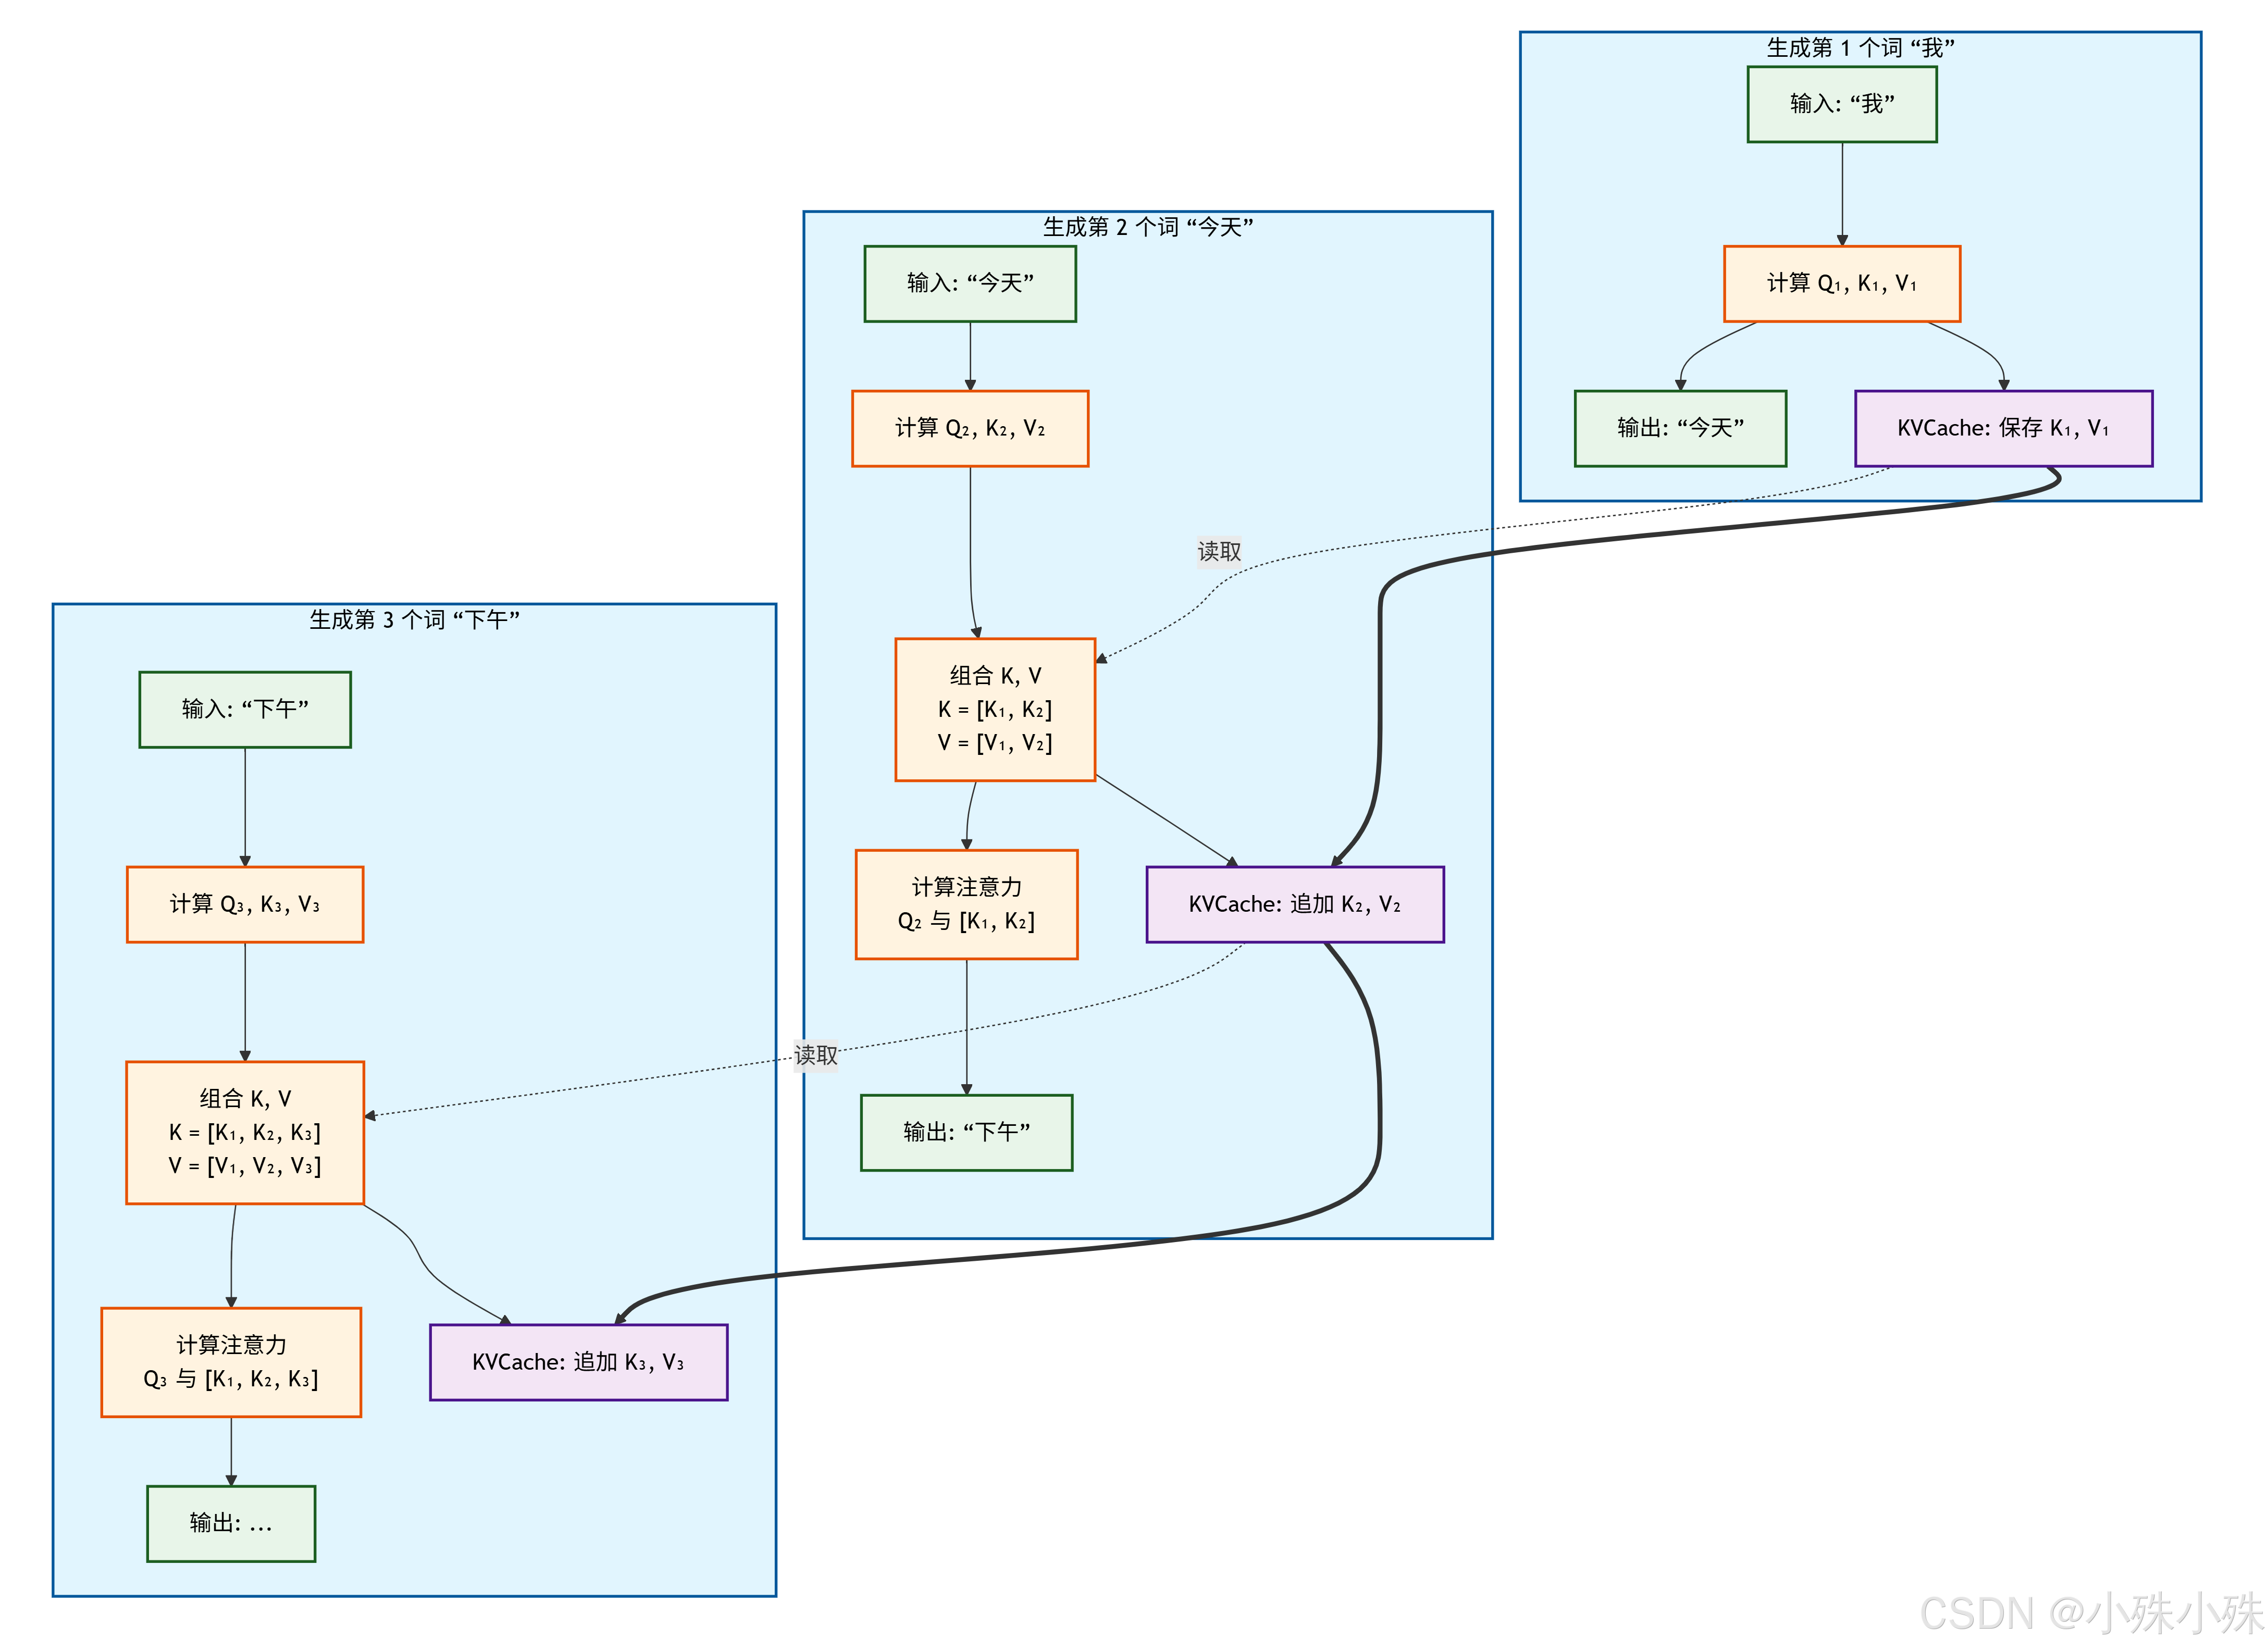
KVCache 的思想非常直观:既然历史 token 的 K 和 V 在之前的步骤中已经计算过了,那就把它们缓存起来,下次生成时直接复用。
我们来看引入 KVCache 后同样的生成过程:
生成第 1 个词 "我":
输入序列: [“我”]。
模型计算 "我" 的 Q₁, K₁, V₁,并输出 "今天"。
同时,将 K₁ 和 V₁ 存入 KVCache。
生成第 2 个词 "今天":
输入序列: [“我”, “今天”]。但实际上,模型只看到最新的 token “今天”。
模型只计算新 token “今天” 的 Q₂, K₂, V₂。
从 KVCache 中读取之前缓存的 K₁ 和 V₁。
现在,用于注意力计算的完整 K 和 V 是:K = [K₁, K₂], V = [V₁, V₂]。
计算 Q₂ 与完整的 K 的注意力,输出 “下午”。
将 K₂ 和 V₂ 追加到 KVCache 中。 现在 Cache 里有 [K₁, K₂] 和 [V₁, V₂]。
生成第 3 个词 "下午":
输入序列: [“我”, “今天”, “下午”]。模型只看到最新的 token “下午”。
模型只计算新 token “下午” 的 Q₃, K₃, V₃。
从 KVCache 中读取之前缓存的 [K₁, K₂] 和 [V₁, V₂]。
用于注意力计算的完整 K 和 V 是:K = [K₁, K₂, K₃], V = [V₁, V₂, V₃]。
计算 Q₃ 与完整的 K 的注意力,输出下一个词。
将 K₃ 和 V₃ 追加到 KVCache 中。
这个过程可以清晰地用下图表示:
四、KVCache 带来的好处与代价
1.好处
(1)极大提升推理速度:这是最主要的目的。避免了 O(n²) 的重复计算,每次生成只计算新 token 的 QKV 和注意力,推理速度通常可以提升 2-10 倍,序列越长,效果越明显。
(2)降低计算开销:节省了大量的 FLOPs(浮点运算次数),降低了延迟。
2.代价
(1)巨大的内存占用:KVCache 是空间换时间的典型例子。对于一个拥有 80B 参数、批处理大小为 512 的模型,KVCache 可能需要占用 几十个 GB 的显存。这对于部署来说是一个巨大的挑战。
内存占用公式:batch_size * num_layers * 2 * seq_length * hidden_size * bytes_per_param (2 代表 K 和 V)。
(2)限制了最大生成长度:由于显存有限,你必须预先设置 KVCache 的大小,这实际上就限制了模型一次性能生成的最大 token 数量(例如 2048 或 4096)。
五、总结
KVCache 是现代大模型推理引擎(如 vLLM, TensorRT-LLM)的标配和优化核心。 没有它,大模型的实时对话、长文本生成等应用几乎无法实现。
当前的研究和工程优化也大量集中在 KVCache 上,例如:
压缩 KVCache:通过量化、剪枝、稀疏化等技术减少其内存占用。
动态 KVCache:根据重要性动态淘汰或保留缓存中的内容。
分组查询注意力:通过让多个注意力头共享同一组 K, V 来减小 Cache 大小。
好了,KVCache就介绍到这里!
关注不迷路(*^▽^*),暴富入口==》 https://bbs.csdn.net/topics/619691583
更多推荐



 29
 0
- 0


 已为社区贡献5条内容

所有评论(0)