
前沿重器[76] | 让小BERT学会思考——美团大模型蒸馏新框架
前沿重器
栏目主要给大家分享各种大厂、顶会的论文和分享,从中抽取关键精华的部分和大家分享,和大家一起把握前沿技术。具体介绍:仓颉专项:飞机大炮我都会,利器心法我还有。(算起来,专项启动已经是20年的事了!)
2024年文章合集最新发布!在这里:再添近20万字-CS的陋室2024年文章合集更新
往期回顾
蒸馏在现在大模型比较流行的环境下,是一个非常极致的降本选择,要是能让小模型学到大模型的能力,那绝对是非常赚的。
最近留意到一篇南航、美团、武大的论文,以电商搜索的query-service为背景,提出一种两阶段推理蒸馏框架,一阶段构造领域自适应推理LLM,二阶段用对比推理蒸馏,成功将大模型学到的领域知识注入到小模型中,并取得了明显提升,今天就给大家讲讲这篇论文。
论文:From Reasoning LLMs to BERT: A Two-Stage Distillation Framework for Search Relevance
链接:https://arxiv.org/abs/2510.11056
整体思路
文章是以电商搜索为背景去做的研究,搜索现在的大部分系统仍旧并非端到端的生成式,而且搜索场景本就要求高并发高返回,如果仍旧使用大模型,这个性能肯定非常差,小模型在做线上推理肯定是最优解,所以既要享受大模型的红利,又要应对在线高并发的要求,那大模型蒸馏到小模型就是非常关键的一种技术手段了。
这里文章提出了两阶段框架,一阶段主要针对的是大模型的领域适配,二阶段则聚焦把微调好的领域适配大模型蒸馏到小模型上。
一阶段,分成3步来进行训练,首先是使用大规模任务数据(主要来自日志)对开源基座模型进行微调以注入平台所需的知识,然后用高质量人工标注的推理数据进行微调,初步具备推理能力,最后再构造奖励函数,进行强化学习优化。
二阶段则是开始蒸馏,使用的是对比蒸馏的方案,一方面要求分类(相似度任务)尽可能准,另一方面要求学生模型的输出表征要和教师模型的输出表征要尽可能拉近。
大体思路聊完,来展开聊每一步具体是怎么做的。
方案细节
一阶段-领域自适应教师模型
值得关注的是,即使是大模型,也并不能很好地对现实任务有充分的理解,因此做领域适配是非常有必要的。在这里,作者把这个问题拆解成了3个部分。
领域知识缺乏。
推理能力未对齐。
输出不可靠。
而只要解决了这些问题,我们就能让这个大模型很好地解决实际问题。
领域适配的继续预训练
领域适配的放在了最早的预训练阶段,此处作者利用日志数据构建了一个大规模的、多任务搜索相关性语料库,任务类型分成了7种,确保知识的广度和多样性。
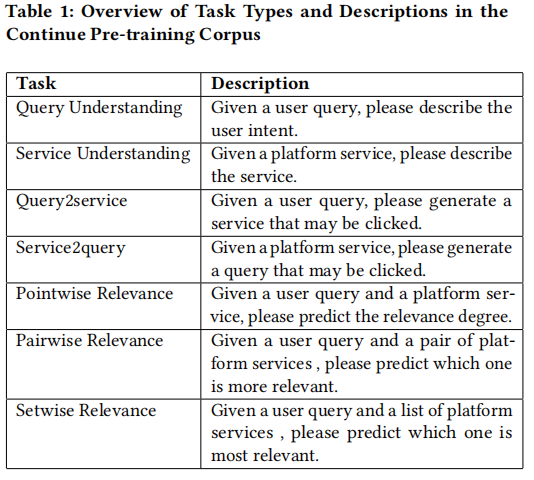
预训练阶段损失之类的细节我暂未在文章中找到,目前暂且认为就是最基础的预训练吧。
SFT
这一步的核心目标是激发大模型的推理能力。此处使用的是经过人工标注的高质量数据集,每个包含(query, services)的样本对,还有人工标注的推理链,训练模型生成(reason, answer)的能力,此处作者简单地给了公式,使用的是交叉熵的方式来训练的。
基于多维奖励模型的偏好优化
仅靠sft可能会出现因为偶然性和错误的逻辑得到正确的答案,因此对推理过程也要有所约束。此处引入的是这几个方向的评分(0-4)。
query理解。是否能够理解用户的搜索意图。
service理解。这里的service是指物料了,能准确描述物料的核心信息。
业务逻辑遵从。推理过程符合平台业务逻辑。
推理正确性。推理逻辑自洽,支持最终答案。
答案正确性。生成答案和真实标签匹配。
奖励模型是使用上面sft后的模型初始化的,然后会被用来训练成奖励函数,目前测试结果有89.77%的一致率。
为了学习推理能力,此处的强化学习使用的是GRPO,奖励函数使用的是过程奖励和答案奖励的加权求和(82开),过程奖励就是前面5个维度奖励模型的均分,后面的答案评分是验证最终答案的正确性。
试验运行上,强化学习用的VERL框架。
二阶段-推理蒸馏阶段
这部分的核心目标就是把大模型学到的具有领域自适应能力和推理能力高效整流到小模型的过程,这里的小模型,使用的是6层的bert模型,毕竟bert模型具有非常强大的速度和成本优势。
此处,作者分析蒸馏的核心难点是教师(Decoder-only LLM)和学生(Encoder-only BERT)在模型结构和表征空间上存在巨大差异,在特征层面对齐会有困难。
此处作者提出了一种双目标的框架,将推理路径作为辅助推理信号,从而能让推理思路也学到模型内部。
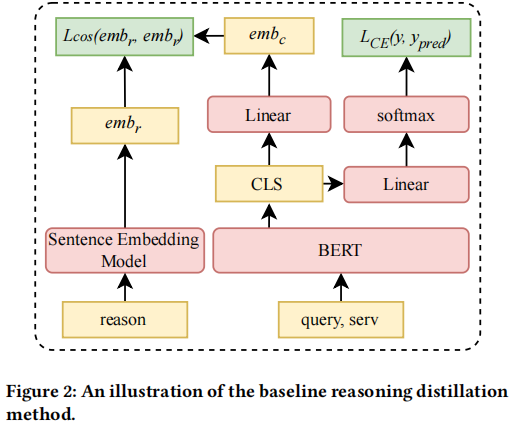
一般的,流程如下。
将教师模型生成的推理路径,用较好的预训练句子表征模型(在实验中有提到用的是BGE-M3),转为推理向量。
轻量级BERT模型处理标准的 (query, service)对,产生[CLS]表征。
双任务学习:一个是主分类任务学习,直接用交叉熵损失,另一个是经过变换后的CLS表征和推理向量进行进行余弦损失,两个任务加权求和。
这种方式的核心难题就是前面有所提及的,让BERT的表示去对齐一个来自外部、独立训练的句子编码器的表示,只能学到表面,并非内部逻辑的内化,作者提出了对比推理自蒸馏来解决这个问题(Contrastive Reasoning Self-Distillation, CRSD)。
此处给出一个假设。
if a model learns to process a reasoning-augmented input <query, service, reason> during training, this acquired reasoning pattern can be internalized into the model’s parameters through a suitable mechanism. Ultimately, even when given only the standard input <query, service>, the model can spontaneously apply these logics, achieving a transition from "explicit reliance on reasoning" to "implicit autonomous reasoning."
倘若一个模型在训练过程中学会了处理推理增强的输入 <查询, 服务, 推理路径>,那么这种习得的推理模式便可以通过一种合适的机制内化到模型的参数中。最终,即使仅提供标准输入 <查询, 服务>,该模型也能自发地运用这些逻辑,从而实现从“显式依赖推理”到“隐式自主推理”的转变。
整体思路如下图所示。
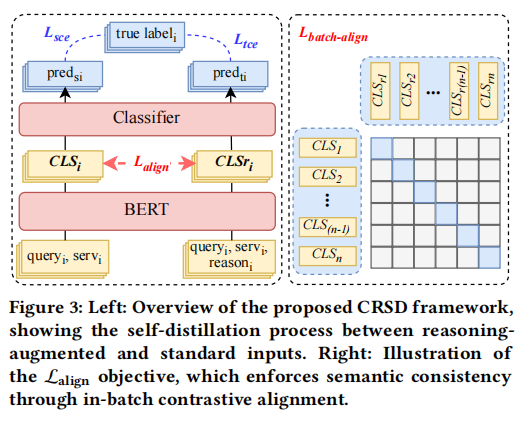
表征上,教师模型侧,将推理增强信息进行表征(query、service、reason),学生侧则是简单的(query、service)对信息。然后进行损失函数的计算。
分类损失,学生和教师模型都需要,两者求和,教师模型的权重低一些也可以。分别是 和 。
对比损失,使用的是InfoNCE(这损失太常青树了啊),要求学生和教师的cls要对齐。此处注意回看图,分类损失是要经过分类器的,但是对比损失不需要,记为
于是最终合并的损失就是。
和 通常都是比较小的值,毕竟过大会让模型忽略掉核心的主任务(实验中均设为0.01)。
启示
实验的关键细节已经穿插在前面的讲解里面了,至于实验结果,不出意外的,基本都是提升,包括在线的AB实验对比,所以就不赘述了,此处直接跳到最后一步,对我们的启示。
首先是对于高并发高性能要求的场景,大模型的直接应用还是有些压力。暂且把这事归结到算力瓶颈上(可能这个归结有些不严谨),小模型,或者说蒸馏到小模型,可能是个非常必要的手段。
领域适配训练的模式,这篇文章给出的方案是知识学习靠预训练、任务适配靠stf,最终用RL来强化推理的可靠性,这个模式可以参考。
RL损失分成的5个维度,还是值得参考的,query/service的理解、业务逻辑遵从性、推理正确性和答案正确性。这个拆分模式本身还挺适合用来做搜推方面的强化学习的。
二阶段的蒸馏,实质上就是让小模型既要学会答案,又要学会推理的思路,两个损失都要考虑。
文章给出的是推理和实际应用向量的对齐思路,目前其实还是偏朴素的输出直接用对比学习拉齐,还不算复杂,应该还有一些提升空间。
对比损失仍旧是向量匹配的重要学习工具,仍旧可以持续用。

更多推荐

 27
 0
- 0


 已为社区贡献6条内容

所有评论(0)