
机器学习之其他监督学习算法:朴素贝叶斯,决策树,SVM支持向量机,集成学习
一、朴素贝叶斯
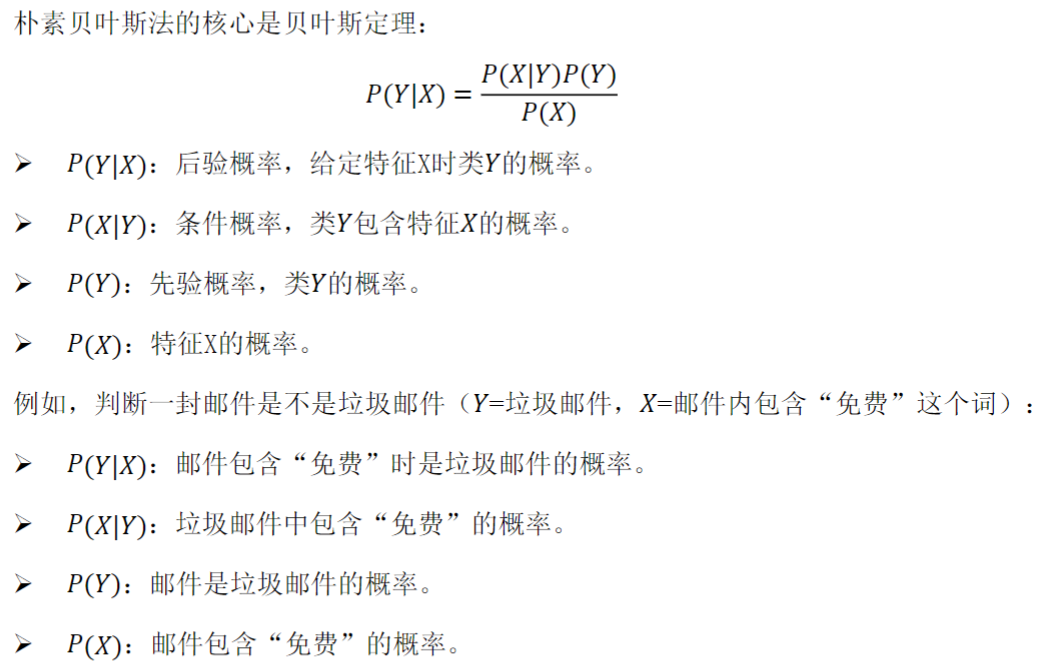
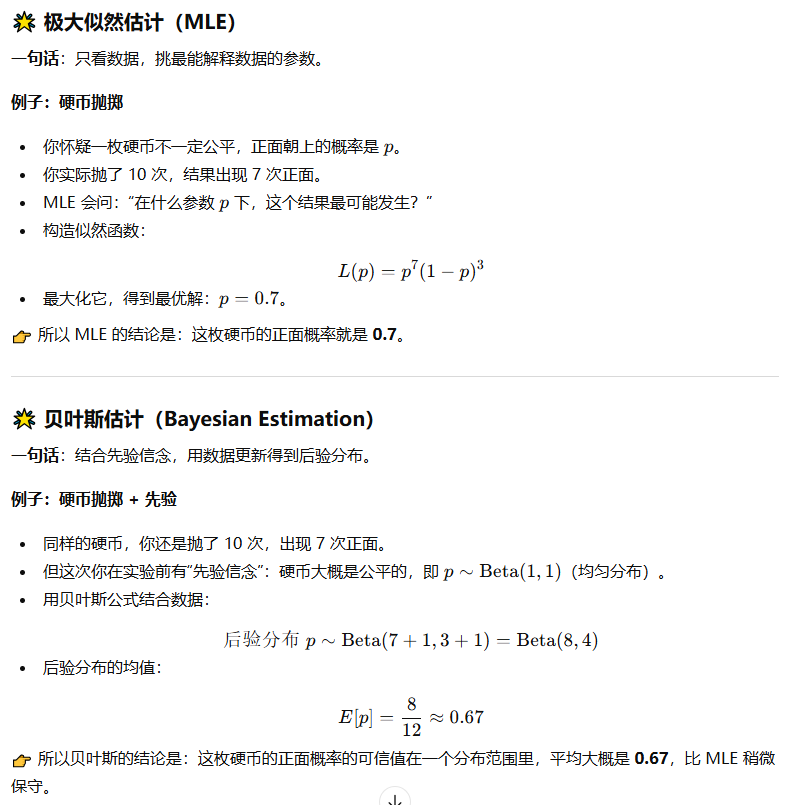
朴素贝叶斯是一种基于概率的机器学习算法,基于贝叶斯定理,并假设特征之间相互独立(这是朴
素的来源)
二、决策树
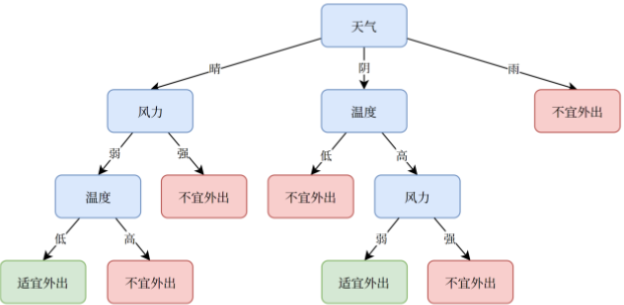
Decision Tree,是一种基于树形结构的算法,决策树适用于需要规则化、可解释性和快速决策的场
景,尤其在数据特征明确、样本量适中的情况下表现良好。在复杂任务中,它常作为基础模型,与
集成学习结合(如随机森林、梯度提升树)以提升性能。
1、决策树的工作过程
决策树的学习通常包括3个步骤:特征选择、决策树的生成和决策树的剪枝。剪枝是为了防止过拟合,使其具有更好的泛化能力,决策树的生成只考虑局部最优,剪枝考虑全局最优。
2、特征选择与决策树生成
信息熵(Entropy)是表示随机变量不确定性的度量,值越小,一件事情就越确定。
信息增益(Information Gain)与ID3,决策树学习应用信息增益准则选择特征。
信息增益率与C4.5
基尼指数与CART
CART回归树
3、剪枝
决策树出现过拟合的原因在于学习时过多的考虑如何提高对训练数据的正确分类,从而构建出过于
复杂的决策树。为了避免过拟合,可以对已生成的决策树进行剪枝,从决策树上裁掉一些子树或叶
节点,并将其根节点或父节点作为新的叶节点,从而简化模型。
三、支持向量机
Support Vector Machine,是一种二分模型其核心目标是寻找一个“间隔最大”的超平面将不同类别
的数据点分隔开。这个超平面在二维空间中是一条直线,在三维空间中是一个平面,在更高维空间
中则是一个超平面。
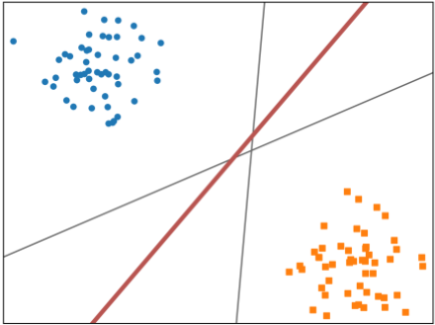
这个意思就是,之前的感知机,是找一条直线,把两个不同的类分开,但是其实这样的直线有无数
条,支持向量机做的就是找那条间隔最大的直线。
1、线性可分支持向量机——硬间隔
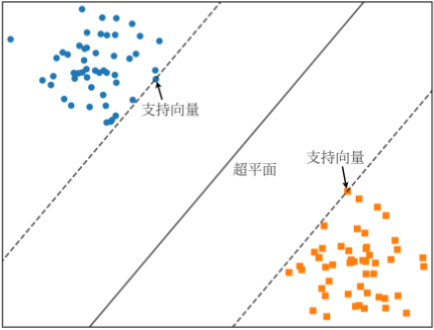
当训练样本线性可分时,此时可以通过最大化硬间隔来学习线性可分支持向量机。硬间隔是指超平
面能够将不同类的样本完全划分开。距离超平面最近的几个样本点称为支持向量,他们直接决定
超平面的位置和方向。
2、线性支持向量机——软间隔
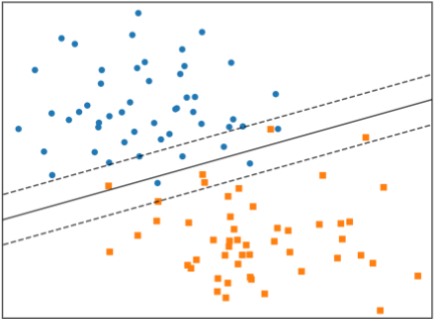
先前我们假定训练样本在样本空间中线性可分,但现实中很可能并非如此,此时我们无法找出一个
合适的超平面将所有样本点完全正确划分。通常训练数据中会有一些特异点,如果将这些特异点去
掉,剩下大部分样本点是线性可分的。这时我们可以放宽条件,允许某些样本分错,为此我们引入
软间隔。
3、非线性支持向量机——核函数
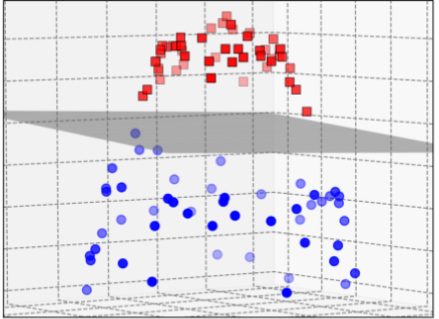
通过核函数将数据从原始空间映射到高维特征空间,使得数据在高维特征空间线性可分,将原本的
非线性问题转换为线性问题。
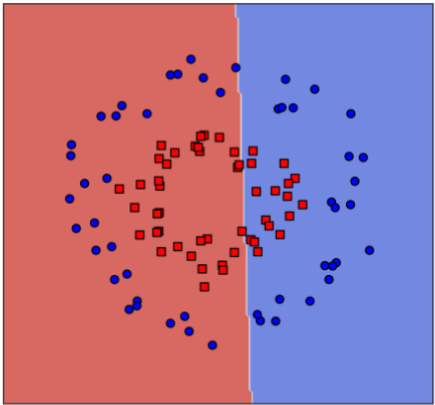
核函数的选择也是支持向量机最大的变数,若核函数选择不合适,意味着将样本映射到了一个不合
适的特征空间,很可能导致性能不佳。
四、集成学习Ensemble Learning
三大经典方法:Boosting(提升方法),Bagging(自助聚合),Stacking(堆叠)
Boosting(提升方法)按顺序训练模型,每个模型关注前一个模型的错误,通过加权调整来优化整体预测。如 AdaBoost 通过给错分的样本更大的权重,逐步改进;梯度提升树用梯度下降法优化损失函数;XGBoost 和 LightGBM 是高效的梯度提升树变种。Boosting 主要关注于降低偏差。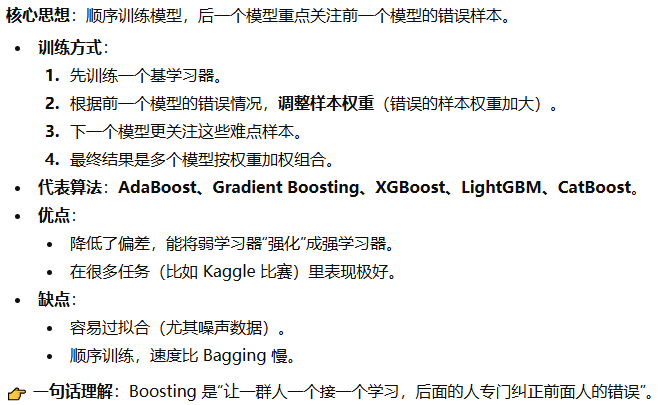
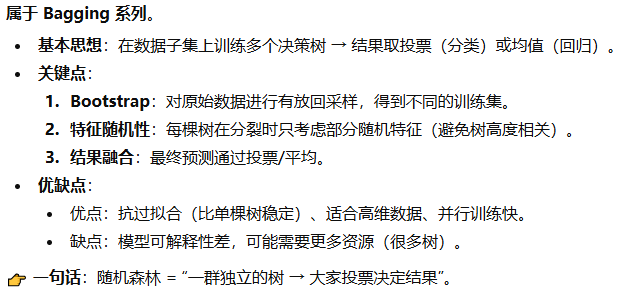
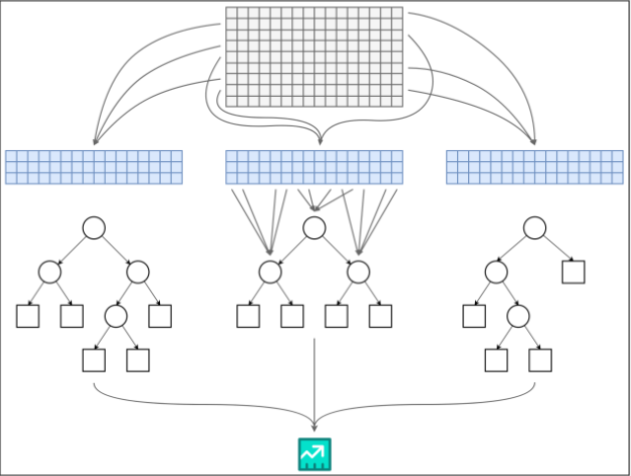
Bagging(Bootstrap Aggregating,自助聚合)从原始数据集中通过有放回的对样本采样生成多个子数据集,分别训练多个独立模型,最后通过投票(分类)或平均(回归)得到结果。随机森林则是在 Bagging 基础上随机选择特征子集训练每棵树。Bagging 主要关注于降低方差。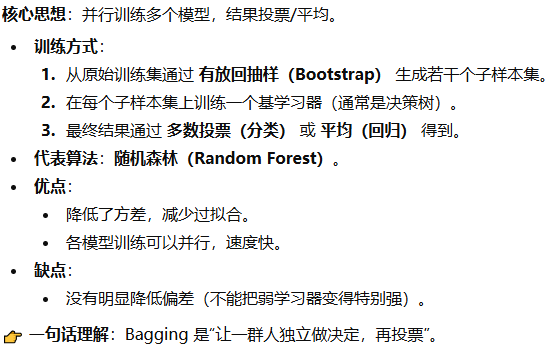
Stacking(堆叠)训练多个不同类型的个体学习器,之后使用一个元模型综合多个个体学习器的预测。灵活性强,能结合多种模型的优势。
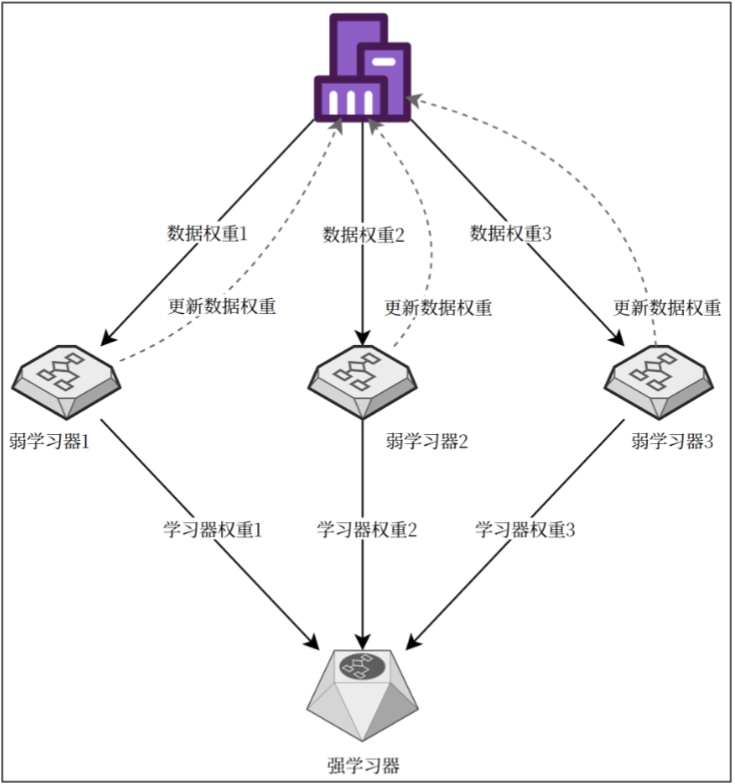
1、AdaBoost
大多数 Boosting 都是改变训练数据的概率分布(权重分布),针对不同的训练数据分布调用弱学
习算法学习一系列弱分类器。AdaBoost(Adaptive Boosting,自适应提升)的做法是提高被前一
轮弱分类器错误分类的样本的权重,降低被正确分类的样本的权重。这样一来后一轮弱学习器会更
加关注那些没有被正确分类的数据。同时采用加权多数表决
2、随机森林RF
更多推荐

 1
 0
- 0


 已为社区贡献9条内容

所有评论(0)