
如何解决大模型的胡说八道?(检索增强生成(RAG))
随着大模型应用的逐渐热门,各类AI聊天软件层出不穷,你是否曾发现AI聊天框中的联网搜索按钮或者知识库呢?
每当你想让大模型回答问题的时候,如果没有打开这个按钮,那么模型讲述的可能是比较过时的方法以及内容,甚至有时大模型在胡说八道,就像吃了毒蘑菇一样,一会东一会西,就是说不对重点。
但是当你选择上了联网搜索或者知识库按钮后,大模型瞬间化身专业教师,对你的问题对答如流,其实这是个按钮的背后蕴藏着一个强大巧妙的技术(检索增强生成(RAG))。
说到这里是不是很想了解这里面的原理是什么,嘿嘿,我们今天就来讲解讲解大模型的检索增强生成。
检索增强生成到底是什么?
概述是这样说的:
检索增强生成(Retrieval Augmented Generation,RAG)是一种面向大语言模型(LLM)的生成式 AI 方法,通过将大语言模型链接到外部资源使生成式 AI 应用输出更准确的回答。
嘿嘿,我们来通俗的理解下吧,其实就是把结合检索技术和生成式模型来增强生成内容准确性和相关性的技术。传统的生成式模型中,模型根据训练数据生成回答,但这种方式有时会导致生成的内容不够准确或不符合实际需求。RAG 通过引入外部知识库或数据库的数据,动态检索相关信息,然后结合大语言模型(LLM)生成更加精准的回答。
再通俗点,其实就是开卷考试,还是那种没有任何难度的(你问的问题它的外部知识库里都有答案的)哈哈哈哈。
RAG与传统大语言模型输出的区别
大语言模型利用机器学习和自然语言处理(NLP)技术来理解和生成人类语言,以实现 AI 推理。AI 推理是 AI 的运行阶段,在这一阶段,模型能够将其在训练过程中所学到的内容应用于现实场景中。
大语言模型在通信和数据处理方面极具价值,但也有一些缺点:
• 大语言模型是通过常规可用的数据进行的训练,但其中可能不包括我们希望其引用的特定信息,例如我们的企业组织的内部数据集。
• 大语言模型也有知识截止日期,这意味着模型的训练数据只包含在特定日期之前的数据和内容。因此,这些来源材料可能会变得过时,不再适用于当前的需求。
• 大语言模型往往被设计为尽力满足用户的需求,这意味着它们有时会提供虚假或过时的信息,又称“幻觉”。
在基于大语言模型的问答系统中实施RAG架构,可以让大语言模型利用外部知识源来获取更广泛、更准确的信息,并将这些信息整合到其回答中,从而提升问答系统的质量和准确性。大语言模型能够交叉引用和补充其内部知识,从而为用户提供更可靠、更准确的查询结果。
通俗理解就是,假如我是一个主持人,那么大模型就是1年前的我(什么资料都在停止在一年前),那个时候的我还不知道什么今年的春晚都有啥节目,那个时候的我也没背过今年的春晚节目单,我只知道去年的,但是你现在要那个我回答今年节目单的问题,我回答不了,所以我只能胡说八道,然后你给我一张今年的节目单,我通过我的思考,结合这个节目单再次回答你的问题,而这张今年节目单就是通过RAG技术给我的,所以区别是不是一目了然。
RAG工作原理的讲解
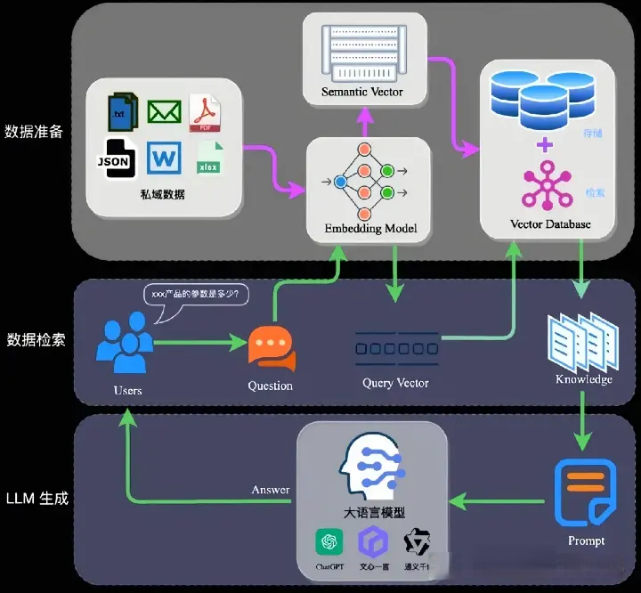
说了这么多RAG的概念,是不是还是不太明白呢,我们把下图拆开理解:
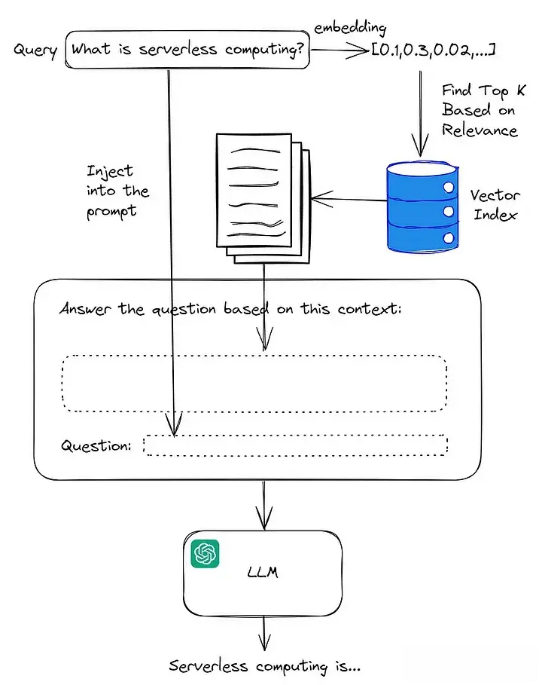
RAG 架构的工作原理是从外部来源检索数据,将其处理到大语言模型的语境中,然后基于组合来源生成回答。该过程包括三个主要阶段:数据准备、检索和生成。
第 1 步:数据准备(用于检索)
源文档和加载文档:识别并获取要与大语言模型共享的源文档,并确保这些文档采用大语言模型能够理解的格式,通常是文本文件、数据库表或 PDF 格式。无论源格式如何,在嵌入向量数据库之前,每份文档都需要转换为文本文件。该过程也称为 ETL 阶段:提取(Extract)、转换(Transform)和加载(Load)。ETL 可确保对原始数据进行清理和整理,使数据为存储、分析和机器学习做好准备。
转换:进行“文本分割”或“分块”,使文档为检索做好准备。这意味着对更新后的文档进行解析,然后根据不同的特征以目录的形式将其编入相关的“块”。例如,按段落编排的文档可能比按表格和图表编排的文档更易于模型搜索和检索。
分块可以基于语义、句子、标记、格式、HTML 字符或代码类型等因素。许多开源框架都可以协助进行文档注入,其中包括 LlamaIndex 和LangChain。
嵌入:嵌入使用专门的机器学习模型(向量嵌入模型)将数据转换为数值向量,使计算机能够应用数学运算来评估数据之间的相似性和差异性。借助嵌入功能,将文本(或图像)转换为向量,从而捕获内容的核心含义,同时丢弃不相关的细节。嵌入过程可为数据块分配一个数值(例如 [1.2,-0.9,0.3]),并在向量数据库这种更大的系统中为其添加索引。
在向量数据库中,此数值帮助 RAG 架构指示内容块之间的关联,并对数据进行整理以优化检索。这种索引方式旨在对向量进行结构化处理,从而将相似的概念存储在相邻的坐标中。例如,“咖啡”和“茶”的位置会离得很近。“热饮”也会离它们很近。“手机”、“电视”等不相关概念的位置则会离它们很远。两个向量点之间的距离或接近程度有助于模型确定对哪些信息进行检索并使其包含在用户查询的输出中。
存储:来自多个来源(选择的外部文档及大语言模型)的组合数据会被存储在中央存储库中。
第 2 步:检索
将数据编入向量数据库后,算法便会搜索并检索与用户提示词和查询相关的信息片段。LangChain 等框架支持许多不同的检索算法,其中包括基于语义、元数据和父文档等数据相似性的检索。
在开放域使用者设置中,信息检索来自互联网上已添加索引的文档,通过信息源的 API 对这些文档进行访问。在封闭域的企业设置中,信息需要保持私密性且不受外部来源的影响,通过 RAG 架构进行检索可以保持本地状态并提高安全性。
最后,将检索到的数据注入提示符中并发送给大语言模型进行处理。
第 3 步:生成
输出:将响应呈现给用户。如果 RAG 方法按预期发挥作用,用户就会获得基于所提供的源知识的准确回答。
我们举一个通俗的例子吧:
反例(没有RAG):
提问:“昨天北京的天气怎么样?”
传统大语言模型(训练时间截止到前天)输出:模型会根据它训练时(前天)的数据来生成一个回答,但它无法实时获取或更新最新的天气信息,所以它可能会提供一个过时或不准确的回答,比如:
“北京的天气通常是温和的,春季气温大约在15到20摄氏度之间。”
(这个回答是基于模型的训练数据生成的,但没有考虑到实时天气,答案可能不准确。)
正例(有RAG):
提问:“昨天北京的天气怎么样?”
传统大语言+RAG模型输出:模型会通过查询实时天气数据源来获得最新的信息,并生成一个准确的回答。比如:
“昨天北京的天气是阴天,气温大约在10摄氏度左右,昨天下午有小雨。”
(这个回答不仅是基于模型预训练的知识,还通过动态检索实时数据来生成,更加准确和及时。)
正例过程:
前置操作:我们已经将昨天全球的天气情况通过embedding模型转成向量放入了数据库中,其中北京天气的关键向量表达式是【1,1,0,1,1】。
用户输入:昨天北京的天气怎么样?这句话通过embedding模型转成查询向量【1,1,0,1,0】,也因此通过算法embedding等从向量数据库查询到了北京的数据【1,1,0,1,1】
此时,将北京的数据和用户的提问以及模型提示词同时输入到大模型中进行推理,大模型在开卷的模式下,给出了准确的答案:昨天北京的天气是阴天,气温大约在10摄氏度左右,昨天下午有小雨。
RAG与其他数据训练和处理方法的本质差别
了解数据训练方法与 RAG 架构之间的差异有助于我们根据需求确定部署哪项 AI 资源。接下来我们将介绍一些常见的数据处理方法和流程,并将它们与 RAG 进行比较。
RAG(检索增强生成模型)与提示词工程的对比
提示词工程是与大语言模型(比如 ChatGPT)互动时的最基本方式。简单来说,它就是通过给模型“提示”或“指令”来引导模型生成特定的回答。比如,我们可以告诉模型:“请用简单的语言解释量子力学。”这就是一个典型的提示词工程。
优点:简单、成本低、实现容易。我们只需要在现有的大语言模型上使用提示词,就能得到一些预期的回答。
缺点:模型的回答质量依赖于我们给的提示词。如果提示词不够清晰,模型的回答可能会变得不一致,甚至是错误的。并且,提示词工程无法根据最新的或不断变化的信息进行更新,模型只能基于它预训练时的数据生成回答。
相比之下,RAG(检索增强生成)是一种更为复杂的方法,它不仅依赖于模型预训练时获得的知识,还能够实时从外部数据库或文档中检索最新的信息,帮助模型生成更加准确和及时的回答。RAG的核心优势在于它可以动态地访问新的信息,而不仅仅是依赖于模型训练期间的数据。
所以如果我们只需要简单的信息并且不关心最新的内容,提示词工程是一个不错的选择;如果我们需要基于最新信息的回答,RAG更为适合。
RAG与语义搜索的对比
语义搜索是对搜索引擎的一种升级,它不仅仅是根据关键词来寻找结果,还能够理解查询的“意图”和“上下文”。比如,假设我们搜索的是“梦想假期”,传统的搜索可能会返回与“梦想”相关的内容,而语义搜索会理解我们其实是想查找与理想假期相关的信息,结果可能是海滨度假、温暖的旅游目的地等。
语义搜索的优势在于它通过自然语言处理(NLP)技术理解查询背后的意义,从而提供更精确的搜索结果。
RAG会利用语义搜索技术来帮助从外部数据库中检索信息,结合当前的上下文生成更有意义的回答。所以,语义搜索是RAG的一部分,它帮助RAG在检索过程中获取更符合用户意图的信息。
所以语义搜索注重理解查询意图,RAG则是通过结合外部信息检索与生成,提供更加丰富和准确的回答。
RAG与预训练的对比
预训练是指在训练大语言模型时,通过大量的文本数据帮助模型学习语言的结构、语法和常见的知识。这个过程是大语言模型学习的“初步训练”阶段。
预训练让模型有了对语言和一般知识的广泛理解,但它不会专门针对某些任务或者领域进行深入学习。
相对于RAG,预训练的成本非常高,因为它需要大量的计算资源和时间进行训练。我们通常需要大规模的GPU集群和大量的数据来进行预训练。
与之不同,RAG是利用预训练的模型,并通过从外部数据库动态检索信息来增强生成回答的过程。RAG可以弥补预训练模型在知识时效性上的不足。
所以如果我们的任务需要大规模的知识学习,且能够承受较高的计算成本,预训练是一个选择;如果我们只需要根据最新的信息动态生成答案,RAG更适合。
RAG与微调的对比
微调是指在一个已经经过预训练的大语言模型基础上,使用一些特定领域的小数据集进行再训练,使得模型在某些任务上表现更好。它通常会让模型变得更适应特定的应用场景,比如医疗、法律等领域。
微调需要大量的计算资源和数据,而且过程通常比RAG更加复杂。微调可以让模型在特定领域表现得更精准,但它的适用性通常较窄。
相比之下,RAG是一种更轻量级的方法,可以从一个特定的文档或数据源中检索信息,不需要对整个模型进行再训练。RAG能够有效减少模型的“幻觉”(即生成不准确或虚构的信息)。
所以微调适用于对特定领域有深入需求的场景,而RAG则更适合需要快速获取并结合最新数据的场景。
具体应用(知识体系)
问答系统:如智能客服、知识库问答,通过检索和生成相结合,提供更精确的答案。
文档生成:如自动撰写报告或内容,模型可以根据实时信息生成更加丰富和专业的文档。
个性化推荐:结合用户的历史数据或外部内容资源生成个性化建议或推荐。
RAG的结合方式不仅限于纯检索和纯生成模型的结合,它也可以在特定领域进行定制化调整,以便适应更多专业性强的应用场景。
其实,不论上述的应用形式如何变化,我们都可以使用RAG实现一个知识管理体系,然后定期更新相关的数据文档的内容,来达到满足我们要求的LLM功能模型,因此检索增强生成不仅提高了生成式AI的实际应用能力,还能够在面对信息快速变化或需要特定领域知识时,保持较高的准确性和时效性。
零基础入门AI大模型必看
陆陆续续也整理了不少资源,希望能帮大家少走一些弯路!
无论是学业还是事业,都希望你顺顺利利 !
1️⃣ 大模型入门学习路线图(附学习资源)
2️⃣ 大模型方向必读书籍PDF版
3️⃣ 大模型面试题库
4️⃣ 大模型项目源码
5️⃣ 超详细海量大模型LLM实战项目
6️⃣ Langchain/RAG/Agent学习资源
7️⃣ LLM大模型系统0到1入门学习教程
8️⃣ 吴恩达最新大模型视频+课件
以上大模型资料包的内容都整理在了我的gzh里,【小灰熊大模型】回复【6】自动掉落,都是🈚️尝分享,可以自取~

更多推荐

 9
 0
- 0


 已为社区贡献5条内容

所有评论(0)