
大模型落地全栈指南:从技术实现到商业价值创造
大模型技术正从实验室快速走向产业实践,据Gartner预测,到2025年70%的企业将部署至少一种生成式AI应用。然而,从基础模型到行业价值的转化存在显著鸿沟——通用大模型准确率不足(平均仅65-75%)、领域知识缺失、响应不可控等问题,使得直接应用面临挑战。本文系统拆解大模型落地的四大核心路径:微调技术(模型适配专业领域)、提示词工程(零样本/少样本场景优化)、多模态融合(跨模态信息处理)及企业级解决方案(工程化部署与价值闭环),并提供可直接复用的技术框架与商业实践案例。
大模型微调:让通用智能适配专业领域
大模型微调是通过在特定领域数据上继续训练,使基础模型习得专业知识的技术。与提示工程相比,微调能将领域知识内化为模型参数,显著提升复杂任务表现(尤其在推理深度超过提示长度限制时)。当前主流微调范式包括全参数微调(效果最佳但成本极高)、参数高效微调(PEFT,如LoRA、QLoRA等)及指令微调(Instruction Tuning),企业需根据数据规模(建议至少1000+高质量样本)、计算资源(A100级GPU通常是起点)和实时性要求选择最优策略。
参数高效微调技术原理与实现
参数高效微调(PEFT)通过冻结基础模型95%以上参数,仅更新少量适配器(Adapter)参数实现领域适配,显存消耗可降低10-100倍。以当前最流行的LoRA(Low-Rank Adaptation)为例,其核心思想是在Transformer注意力层的Query和Value矩阵旁插入低秩分解矩阵(秩通常取8-32),训练时仅更新这些低秩矩阵,推理时合并参数实现零额外延迟。QLoRA则进一步结合4-bit/8-bit量化技术,使7B模型可在单张消费级GPU(如RTX 3090)上微调,13B模型在24GB显存设备上运行。
以下是基于Hugging Face peft库实现的金融问答模型微调代码,使用QLoRA技术在医疗数据集上适配Llama-2模型:
from peft import LoraConfig, get_peft_model from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments import torch from datasets import load_dataset # 1. 加载基础模型与分词器 model_name = "meta-llama/Llama-2-7b-chat-hf" tokenizer = AutoTokenizer.from_pretrained(model_name) tokenizer.pad_token = tokenizer.eos_token # 加载4-bit量化模型(节省90%显存) model = AutoModelForCausalLM.from_pretrained( model_name, load_in_4bit=True, device_map="auto", quantization_config=BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_use_double_quant=True, bnb_4bit_quant_type="nf4", bnb_4bit_compute_dtype=torch.bfloat16 ) ) # 2. 配置LoRA参数(金融领域经验值) lora_config = LoraConfig( r=16, # 低秩矩阵维度,金融领域推荐16-32 lora_alpha=32, # 缩放因子 target_modules=["q_proj", "v_proj"], # Llama架构关键注意力层 lora_dropout=0.05, bias="none", task_type="CAUSAL_LM" ) model = get_peft_model(model, lora_config) model.print_trainable_parameters() # 应显示"trainable params: 0.1-0.5%" # 3. 数据预处理(金融问答示例) dataset = load_dataset("json", data_files="financial_qa_data.json") def format_prompt(sample): return f"""<s>[INST] {sample['question']} [/INST] {sample['answer']} </s>""" tokenized_dataset = dataset.map( lambda x: tokenizer(format_prompt(x), truncation=True, max_length=512), batched=True ) # 4. 训练配置(单GPU优化参数) training_args = TrainingArguments( per_device_train_batch_size=4, gradient_accumulation_steps=4, # 等效16 batch size learning_rate=2e-4, # LoRA推荐较高学习率 num_train_epochs=3, logging_steps=10, output_dir="./llama-finance-lora", optim="paged_adamw_8bit", # 8-bit优化器节省显存 lr_scheduler_type="cosine", warmup_ratio=0.1 ) # 5. 启动训练 trainer = transformers.Trainer( model=model, args=training_args, train_dataset=tokenized_dataset["train"] ) trainer.train() # 6. 模型合并与推理 merged_model = model.merge_and_unload() inputs = tokenizer("[INST] 解释什么是量化宽松政策? [/INST]", return_tensors="pt").to("cuda") outputs = merged_model.generate(**inputs, max_new_tokens=200) print(tokenizer.decode(outputs[0], skip_special_tokens=True))
微调效果评估与优化策略
微调质量取决于数据质量(标注准确率、领域覆盖度)、训练策略(学习率调度、早停机制)及评估体系(不能仅依赖BLEU等自动指标)。建议构建包含客观指标(如金融问答准确率、医疗诊断精确率)和主观评估(领域专家评分)的混合评价体系。某券商实践显示,在5万条财报分析数据上微调的Llama-2-13B模型,金融术语准确率从基础模型的62%提升至89%,但需注意过拟合风险——当验证集性能不再提升时应立即停止训练,可通过增加数据多样性(如加入边缘案例)和正则化(Dropout、权重衰减)缓解。
提示词工程:零样本场景的智能优化器
提示词工程(Prompt Engineering)通过精心设计输入文本结构,引导模型在不修改参数的情况下完成特定任务。该技术在数据稀缺(<100样本)、领域快速迭代(如热点事件分析)或低延迟要求场景(无法等待微调)中不可替代。有效的提示设计遵循清晰指令(明确任务目标)、上下文构建(提供必要背景)、思维链引导(Chain-of-Thought, CoT)三大原则,研究表明优质提示可使GPT-4在复杂推理任务上性能提升30-50%。
提示工程核心模式与模板库
经过数千次实验验证,以下四种提示模式在企业场景中适用性最广:
| 提示模式 | 核心原理 | 适用场景 | 性能提升 | 示例模板 |
|---|---|---|---|---|
| 零样本指令 | 直接描述任务要求 | 简单分类、摘要 | 基础模型→+20% | 将以下文本分类为积极/消极/中性:{text} |
| 少样本示例 | 提供3-5个高质量示例 | 实体识别、格式转换 | 零样本→+35% | 示例1: 文本="股价上涨5%" → 情绪=积极\n示例2: 文本="亏损扩大" → 情绪=消极\n现在处理: {text} → 情绪= |
| 思维链提示 | 引导模型分步推理 | 财务分析、风险评估 | 直接回答→+45% | 问题: 某公司营收增长10%但利润下降5%,原因可能有哪些?\n让我们逐步分析:\n1. 首先检查成本结构...\n2. 其次考虑非经常性损益...\n结论: |
| 角色设定提示 | 赋予模型专业身份 | 法律咨询、医疗诊断 | 通用回答→+30% | 假设你是拥有10年经验的注册会计师,请分析以下财报异常:{financial_data}\n分析应包含:1. 异常指标识别 2. 潜在原因 3. 审计风险等级 |
思维链提示(CoT)尤其适用于企业复杂决策场景。例如在供应链风险评估中,传统提示直接输出结果准确率仅58%,而采用"逐步推理+专业框架"的增强CoT后准确率提升至82%:
【供应链风险评估专家】请使用SCOR模型分析以下供应商风险:
供应商A:原材料交付延迟率从5%升至15%,同时质检合格率从99%降至95%。

分析步骤:
1. 识别受影响的SCOR维度(交付可靠性、质量一致性)
2. 计算影响程度:延迟率上升10个百分点→订单履行周期延长3-5天
3. 根因分析:可能原因包括①供应商产能不足 ②物流受阻 ③质量控制松懈
4. 传导风险:生产计划延误→客户订单违约→潜在罚款200万/月
5. 缓解措施:①启动备选供应商 ②增加安全库存 ③派驻质量监督员

最终风险等级:高(建议72小时内启动应急预案)
企业级提示管理系统设计
当企业内部提示词数量超过50个时,需构建提示词管理系统实现版本控制、A/B测试和效果追踪。某互联网巨头的提示工程平台包含四大模块:①提示模板库(按业务线分类)、②性能监控看板(实时追踪各提示准确率/耗时)、③用户反馈系统(人工标记错误案例)、④自动优化引擎(基于反馈数据迭代提示模板)。该系统使客服意图识别准确率从76%提升至91%,同时将新业务适配周期从2周缩短至1天。
提示词管理系统架构
注:因展示限制使用占位图,实际架构应包含模板管理、版本控制、效果分析、权限管理四大核心模块
多模态大模型:打破信息形式边界
人类70%以上信息通过视觉获取,企业数据中80%是非结构化内容(图像、文档、音视频等)。多模态大模型(如GPT-4V、LLaVA、Fuyu)通过统一架构处理文本、图像、音频等模态,实现跨模态理解与生成,在智能制造(缺陷检测+原因分析)、智能医疗(影像诊断+报告生成)等场景释放巨大价值。当前技术路线分为模态拼接(独立编码器+共享解码器)和统一编码器(如CLIP类模型)两类,后者在跨模态检索任务上表现更优。
多模态企业应用案例与实现
工业质检场景中,传统机器视觉系统仅能检测缺陷但无法分析原因,多模态模型可同时处理产品图像(视觉模态)和生产参数(文本模态),实现"缺陷定位→根因分析→解决方案"闭环。以下是基于LLaVA模型的工业质检系统实现框架:
from transformers import LlavaProcessor, LlavaForConditionalGeneration import cv2 import numpy as np # 加载多模态模型(13B参数版本需24GB+显存) processor = LlavaProcessor.from_pretrained("llava-hf/llava-1.5-13b-hf") model = LlavaForConditionalGeneration.from_pretrained( "llava-hf/llava-1.5-13b-hf", torch_dtype=torch.float16, device_map="auto" ) def industrial_inspection(image_path, production_params): # 1. 图像预处理(工业相机通常2048×2048,需降采样) image = cv2.imread(image_path) image = cv2.resize(image, (800, 800)) # 平衡分辨率与速度 image = cv2.cvtColor(image, cv2.COLOR_BGR2RGB) # 2. 构建多模态提示(包含视觉标记和文本参数) prompt = f"""<image> 作为资深工业工程师,请分析以下产品图像和生产参数: - 生产参数:{production_params} - 检测要求:识别表面缺陷,分析可能原因,并提出解决方案 回答格式: 缺陷描述:[具体缺陷] 严重程度:[高/中/低] 可能原因:[1. ... 2. ...] 解决建议:[1. ... 2. ...]""" # 3. 模型推理 inputs = processor(prompt, image, return_tensors="pt").to("cuda") outputs = model.generate( **inputs, max_new_tokens=512, temperature=0.3 # 降低随机性,提高结果稳定性 ) return processor.decode(outputs[0], skip_special_tokens=True) # 实际调用示例 result = industrial_inspection( image_path="product_defect.jpg", production_params="温度=180℃, 压力=2.5MPa, 速度=15m/min, 材料批号=A2309" ) print(result)
文档智能处理是另一高价值场景。传统OCR+NLP方案难以处理复杂格式文档(如带表格的财务报告、公式密集的技术手册),多模态模型可直接解析PDF文档的视觉布局+文本内容。某会计师事务所使用多模态模型处理年报审计,将表格信息提取准确率从68%提升至94%,人工复核时间减少70%。
多模态模型部署优化
多模态模型计算成本显著高于纯文本模型(GPT-4V API价格约为纯文本的3倍),企业部署需注意:①模态选择:非必要时避免传递高分辨率图像(建议工业场景控制在800×800px以内);②模型选型:小参数模型(如LLaVA-7B)可本地部署,复杂任务再调用API;③缓存策略:对高频查询的标准图像(如常见缺陷样本)缓存推理结果。某汽车零部件厂商通过这些优化,将质检系统单次推理成本从降至0.03,达到量产可行性。
企业级解决方案:从技术验证到商业价值
大模型技术落地的最大挑战往往不在算法而在工程化与商业化。企业级解决方案需构建全生命周期能力:数据治理(高质量数据集构建)、模型管理(版本控制与性能监控)、工程部署(低延迟高并发服务)及价值闭环(ROI可量化)。根据麦肯锡调研,成功落地大模型的企业中,83%建立了专属AI中台,71%实现了与现有业务系统的深度集成(如ERP、CRM)。
工程化部署架构与关键组件
企业级大模型服务架构需满足三高要求:高可用性(99.9%以上SLA)、高并发处理(支持每秒数百至数千请求)、低延迟响应(通常要求<500ms)。以下是经过验证的部署架构:
[用户层] → API网关(负载均衡、鉴权)→ [应用层] → 大模型服务集群
                                          ↓
[数据层] ← 模型监控系统(性能/偏差/漂移检测)← 推理引擎(vLLM/TGI)← 模型仓库(Hugging Face Hub/内部)
                                          ↓
                                    向量数据库(FAISS/Milvus)← 知识工程模块(RAG)
推理引擎优化是性能关键。开源方案中,vLLM(基于PagedAttention技术)和Text Generation Inference(TGI)支持连续批处理(Continuous Batching)和预编译(TensorRT-LLM),可将 throughput(吞吐量)提升3-5倍。以下是使用vLLM部署企业级API服务的代码示例:
# 服务端:高性能推理服务部署(vLLM) from vllm import LLM, SamplingParams from fastapi import FastAPI, Request import uvicorn app = FastAPI() # 加载模型(支持Llama/OPT/Bloom等主流架构) llm = LLM( model_path="./llama-finance-lora", # 本地微调模型 tensor_parallel_size=2, # 多GPU并行 gpu_memory_utilization=0.9, # 显存利用率 quantization="awq", # AWQ量化比GPTQ速度更快 max_num_batched_tokens=4096 # 批处理令牌上限 ) sampling_params = SamplingParams(temperature=0.7, max_tokens=512) @app.post("/financial_analysis") async def analyze(request: Request): data = await request.json() prompts = [f"<s>[INST] {data['query']} [/INST]"] outputs = llm.generate(prompts, sampling_params) return {"result": outputs[0].outputs[0].text} # 启动服务(生产环境建议配合Nginx和Supervisor) if __name__ == "__main__": uvicorn.run("service:app", host="0.0.0.0", port=8000, workers=4)
知识增强检索(RAG) 是企业应用的必备组件。通过将私有知识库(如内部文档、客户案例)向量化存储于FAISS/Milvus,推理时动态检索相关知识注入提示,可解决大模型"幻觉"问题(事实性错误)和知识时效性问题。某银行客服系统通过RAG架构,将回答准确率从72%提升至93%,知识更新周期从季度缩短至实时。
商业价值评估与典型案例
企业引入大模型需清晰定义价值衡量指标:①效率提升(如客服响应时间缩短、文档处理速度加快);②成本节约(人力替代、错误减少);③收入增长(新业务机会、客户满意度提升)。以下是三个行业的ROI分析:
- 金融服务:某券商财富管理部门部署投资顾问大模型,客户问题自动解答率达78%,人工客服效率提升40%,6个月收回投资成本
- 制造业:某重工企业质检系统改造后,缺陷漏检率从12%降至0.8%,年减少返工成本$320万
- 医疗健康:三甲医院放射科引入辅助诊断系统,CT影像初筛时间从平均45分钟缩短至8分钟,诊断准确率提升15%
成功案例的共同特征是:①明确的KPI指标(如成本降低百分比、准确率提升点数);②小步快跑策略(从试点场景开始,3个月内看到初步成效);③人机协同模式(而非完全替代人工)。某保险公司的核保系统采用"AI初核+人工复核"模式,既将处理效率提升3倍,又通过人工监督控制风险,最终实现NPS(净推荐值)提升28分。
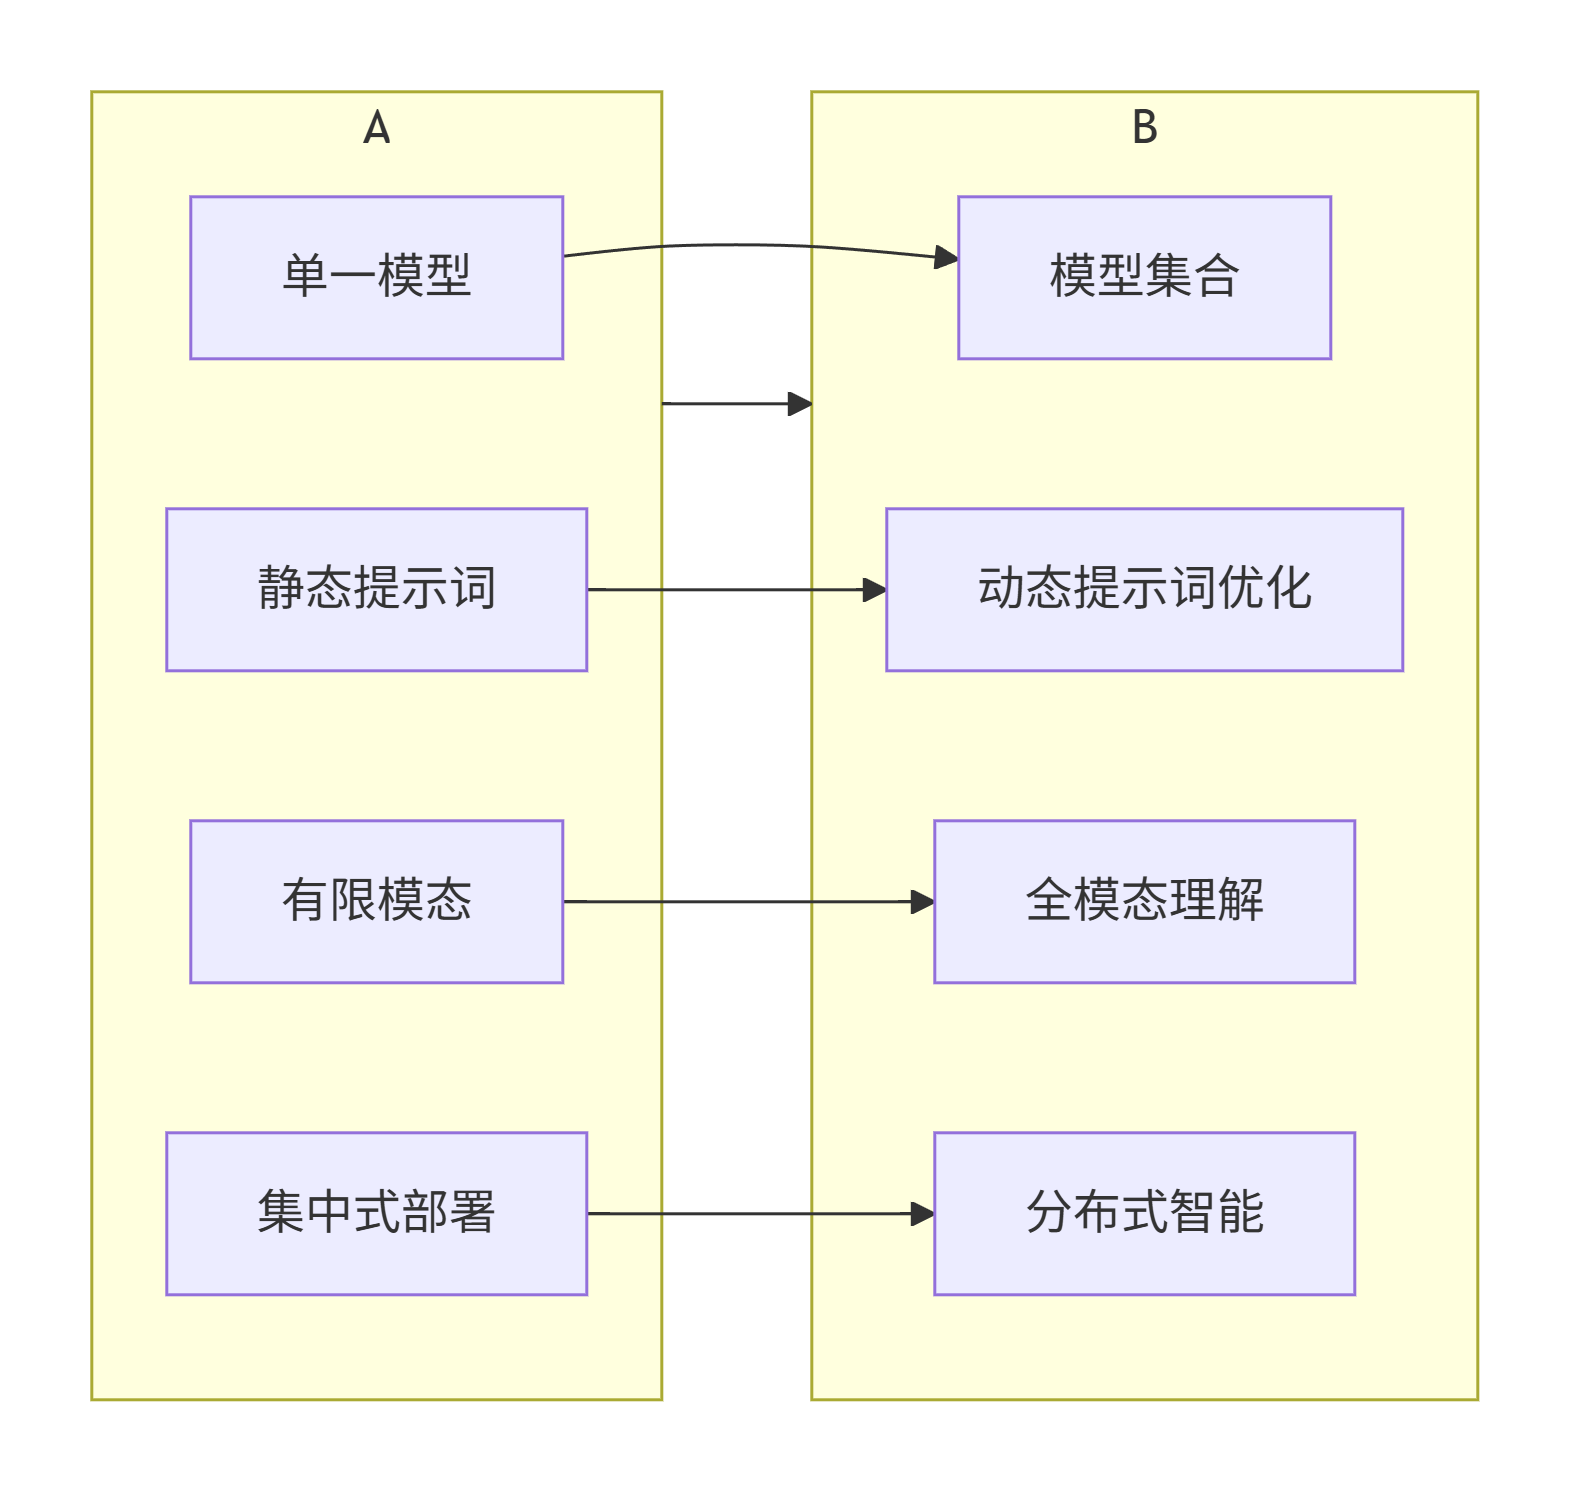
未来发展方向
graph LR
    A[当前状态] --> B[未来趋势]

    subgraph A
        C[单一模型]
        D[静态提示词]
        E[有限模态]
        F[集中式部署]
    end

    subgraph B
        G[模型集合]
        H[动态提示词优化]
        I[全模态理解]
        J[分布式智能]
    end

    C --> G
    D --> H
    E --> I
    F --> J
结语:大模型落地的三大关键成功要素
大模型技术正从实验室快速渗透到企业核心业务,但成功落地需要超越技术本身的系统性思考。本文阐述的四大路径中,微调与提示工程是当前性价比最高的切入点(ROI通常<6个月),多模态融合代表中长期技术方向,而企业级工程化能力则是价值转化的最后一公里。
企业决策者需关注三个关键问题:①数据战略:是否已构建领域高质量数据集(而非盲目追求模型规模)?②人才结构:是否组建"算法工程师+领域专家+产品经理"的铁三角团队?③价值闭环:能否清晰量化大模型带来的具体业务提升?正如某位CIO所言:"大模型不是银弹,但在数据充分、场景明确的领域,它正在重新定义企业的效率边界与竞争优势。"
未来12-18个月,随着开源模型性能持续逼近闭源API(如Llama 3、Qwen系列),以及算力成本下降(Moore定律在AI芯片领域仍有效),大模型落地门槛将显著降低。那些提前布局技术能力、积累行业数据、构建工程化体系的企业,正将今日的技术投入转化为明日的商业壁垒。
更多推荐



 14
 0
- 0


 已为社区贡献53条内容

所有评论(0)