
AI核心知识十——多模态大模型(精华版)
“多模态大模型”就是在文本单模态 基础上,把图像、音频、视频、传感器数据等其他信息类型也一起塞进同一个大模型里,让它“看、听、说、写” 同步完成。换句话说,模型输入/输出的 token 不再只是文字,还可能是图片块、音频频段、视频帧等。
转化图:
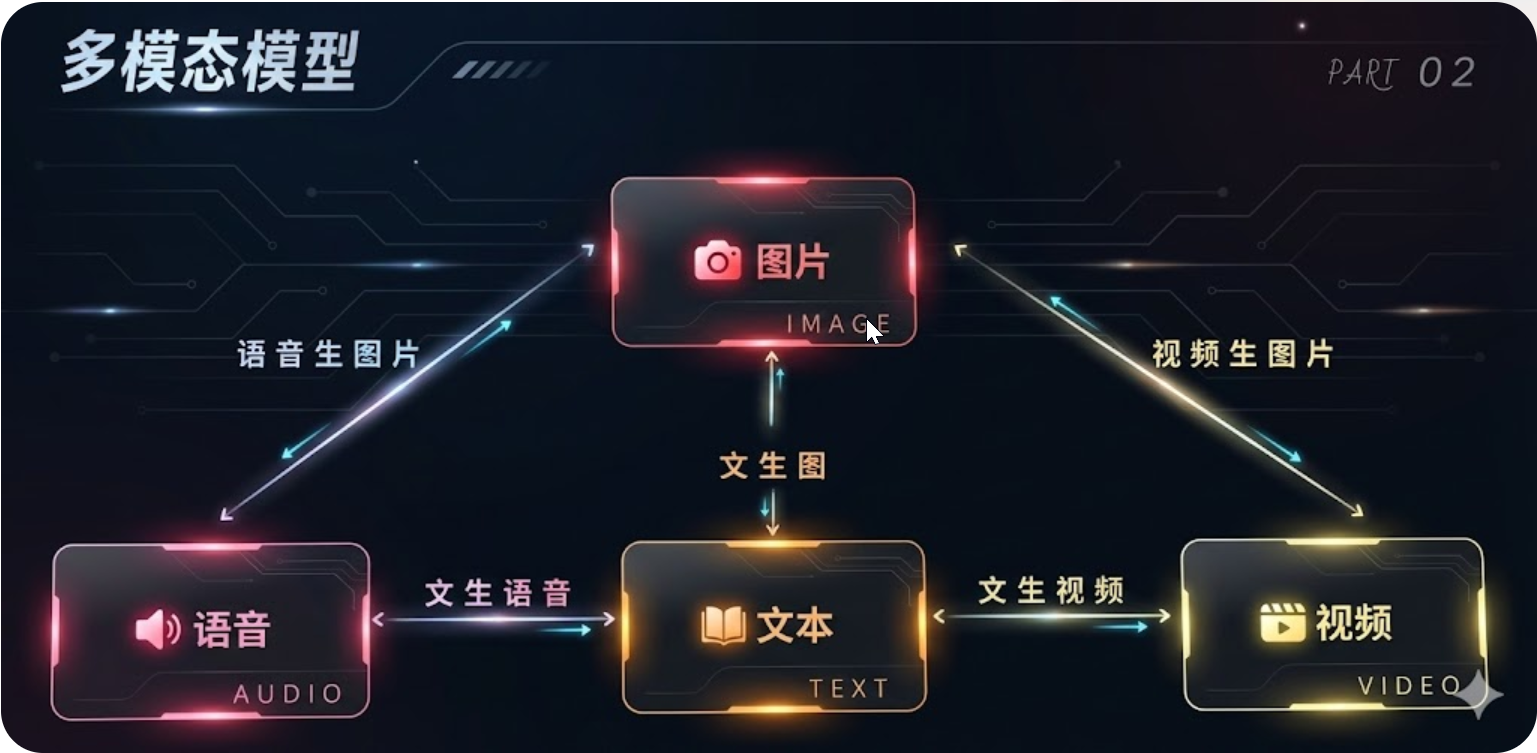
1. 为什么叫“模态”
|
模态 |
示例 |
离散化方法 |
|
文本 |
句子 |
BPE / SentencePiece |
|
图像 |
照片 |
Vision Transformer 把图切 14×14/16×16 块 → patch token |
|
音频 |
语音 |
16 kHz 采样 → 梅尔频谱 → 音频 token |
|
视频 |
电影 |
关键帧+光流 → 时空 patch token |
2. 核心思想(1 张图 2 句话)
① “把一切都变成 token”
② “同一份 Transformer 参数,共同注意力”
图文音 token 拼接成一条长序列,一起过自注意力,让“图-文”关系一次性学成。
3. 训练流程(简化版)
-
大规模单模态预训练:文本 LLM + 视觉 ViT + 音频 encoder 分别热身
-
对齐阶段:用图文对(Alt-text)或语音-转录做对比学习,把各模态映射到同一语义空间
-
联合微调:指令跟随 + 多模态对话数据,让模型学会“看图说话、听声写字、视频问答”
4. 能力举例
-
看图聊天:上传一张餐桌照片 → 模型输出“卡路里估算+菜谱”
-
语音对话:直接说话提问,模型用语音回答,同时给出文字字幕
-
视频理解:丢进 2 小时电影 → 询问“主角第 3 次冲突发生在几分几秒?”
-
跨模态创作:一句歌词 → 生成伴奏+封面图+MV 脚本
5. 代表模型
|
模型 |
输入 |
特点 |
|
GPT-4o |
文本+图像+音频 |
原生端到端,延迟 232 ms |
|
Gemini 1.5 Pro |
文本+图像+音频+视频 |
1 M token 长多模态 |
|
Claude 3.5 Sonnet |
文本+图像 |
强 OCR 与 UI 理解 |
|
国内通义千问-VL、豆包·视觉、Kimi-Vision |
文本+图像 |
中文图表、古籍、手机截图场景优化 |
6. 技术挑战
-
序列爆炸:图+音 token 比文字长 10×,注意力 O(n²) 成本飙升
-
对齐噪声:Alt-text 常敷衍,需重新 captioning
-
幻觉叠加:文本幻觉 + 视觉幻觉一起出现,更难纠偏
-
评估缺失:单模态有 BLEU、ROUGE,多模态缺乏统一指标
7. 一句话总结
多模态大模型 = “把图、音、视频全部 token 化,与文本共享同一个 Transformer” ,从而做到看一张图、听一段音、播一段视频后,都能用自然语言即时交互 ,是迈向通用人工智能(AGI)的关键台阶。
更多推荐

 15
 0
- 0


 已为社区贡献4条内容

所有评论(0)