
大模型微调核心解密:PPO算法原理与应用技巧!
随着大模型能力不断提升,单纯依赖监督微调难以满足复杂的人类偏好需求。强化学习,尤其是 PPO(Proximal Policy Optimization),成为调优模型生成行为、提升输出质量和对齐性的关键技术。
阅读本文时,请带着这三个问题思考:
1.PPO 为什么成为强化学习中的主流算法?
2.PPO 的核心原理和算法流程是什么?
3.在大模型微调中如何有效应用 PPO?
一、PPO 背景与意义
强化学习通过奖励信号优化策略,适合训练生成模型以符合复杂目标。然而传统强化学习算法如 TRPO 复杂难调,训练不稳定。
PPO是OpenAI 2017年提出的一种强化学习算法,简化了约束策略更新的方式,保证训练稳定且高效,广泛应用于大模型的 RLHF 微调阶段。
二、PPO 的核心原理与流程
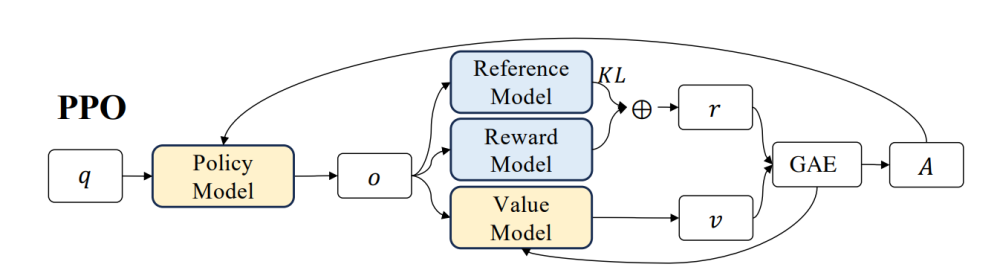
我们在上学的时候,如果老师采取非常极端的教学方式,有时候极度表扬,有时候又极度训斥,是不是容易让我们产生厌学的情绪,一个好的老师是会使用温和的教学方式,每次指导学生进步一点点。PPO的核心思想也就类似温和的老师,它认为在更新模型的生成策略时,更新的步伐不应该过大。
1. 代理策略与旧策略
PPO 维护两个策略:当前策略(agent)和旧策略。
 训练时用采集的数据估计策略改变量,限制新旧策略的差异,防止训练“跳变”过大导致性能崩溃。
为了在不重复交互的前提下评估新策略表现,引入概率比率
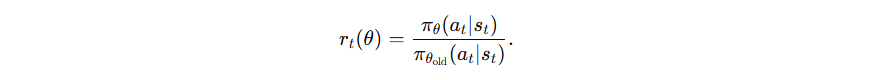
这个比率告诉我们:在新策略下,样本中这些动作“应不应该被更鼓励”。
2. 剪切目标函数(Clipped Objective)
PPO 引入剪切函数限制策略概率比率(ratio)在 [1-ε, 1+ε] 之间波动,平衡探索与稳定。
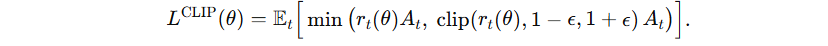 目标函数为 clipped surrogate objective,避免更新幅度过大。
3.优势函数
优势 At 衡量“该动作比平均策略好多少”。PPO 通常用 GAE(λ):
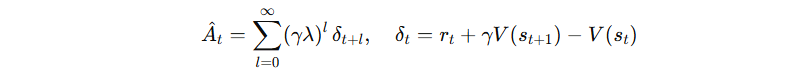
·γ:折扣因子(长期回报权重)
·λ:偏差-方差折中(0 更“短视”、1 更“长视”)
·实操里对 A^ 做均值方差归一化,提升数值稳定。
4. 算法步骤
·采集行为数据(模型生成文本及奖励)
·计算优势函数(Advantage Estimate)
·优化 clipped 目标函数更新策略参数
·多次迭代,确保策略逐步提升
三、PPO 的示例代码
# 初始化 policy πθ 和 value function Vϕ
for iteration in training_steps:
trajectories = collect_data(policy=πθ, env=environment)
# 计算优势函数 A(s, a)
advantages = compute_advantages(trajectories, Vϕ)
# PPO 目标函数
ratio = πθ(a|s) / πθ_old(a|s)
clipped = clip(ratio, 1 - ε, 1 + ε) * advantages
loss_policy = -min(ratio * advantages, clipped)
# 更新策略和价值函数
θ = θ - lr * ∇loss_policy
ϕ = update_value_function(trajectories, Vϕ)
四、PPO 的优势与挑战
优势
·训练稳定,收敛快,易于实现。
·适应性强,能处理复杂的连续动作空间。
·成为强化学习领域标配,社区支持丰富。
挑战
·超参数较多,需要精细调优。
·计算资源消耗较大,训练成本高。
·训练过程对奖励模型质量依赖强。
五、PPO使用技巧
·合理选择剪切阈值 ε 和 KL 惩罚系数,保证训练平滑。
·结合监督预训练模型进行初始化,提升训练效率。
·监控训练指标,防止奖励过拟合和模式坍缩。
·配合高质量人类偏好数据,确保训练信号有效。
最后我们回答一下文章开头提出的三个问题:
1.PPO 为什么成为强化学习中的主流算法?
因为它设计了简单而有效的策略更新约束,平衡了训练稳定性和性能提升,解决了传统算法难调的难题。
2.PPO 的核心原理和算法流程是什么?
通过剪切目标函数限制策略更新步幅,采用优势函数估计,多轮迭代优化策略,稳健提升性能。
3.在大模型微调中如何有效应用 PPO?
利用奖励模型作为反馈,结合 KL 散度约束,细致调参和监控,确保模型生成更符合人类期望。
六、如何系统的学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
一直在更新,更多的大模型学习和面试资料已经上传带到CSDN的官方了,有需要的朋友可以扫描下方二维码免费领取【保证100%免费】👇👇
01.大模型风口已至:月薪30K+的AI岗正在批量诞生
2025年大模型应用呈现爆发式增长,根据工信部最新数据:
国内大模型相关岗位缺口达47万
初级工程师平均薪资28K(数据来源:BOSS直聘报告)
70%企业存在"能用模型不会调优"的痛点
真实案例:某二本机械专业学员,通过4个月系统学习,成功拿到某AI医疗公司大模型优化岗offer,薪资直接翻3倍!
02.大模型 AI 学习和面试资料
1️⃣ 提示词工程:把ChatGPT从玩具变成生产工具
2️⃣ RAG系统:让大模型精准输出行业知识
3️⃣ 智能体开发:用AutoGPT打造24小时数字员工
📦熬了三个大夜整理的《AI进化工具包》送你:
✔️ 大厂内部LLM落地手册(含58个真实案例)
✔️ 提示词设计模板库(覆盖12大应用场景)
✔️ 私藏学习路径图(0基础到项目实战仅需90天)

第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】
更多推荐

 18
 0
- 0


 已为社区贡献457条内容

所有评论(0)