
当大模型被按下“追问键”:可解释机器学习正在重塑AI范式
从 ProtoPNet 到 Concept Bottleneck,再到大语言模型的机制解释与统一评测基准,可解释机器学习正从事后画热力图,走向可干预、可验证、可对话的结构化解释。本期精选来自 NeurIPS、ICML、CVPR 等顶会顶刊的 20 篇论文,涵盖概念瓶颈、原型网络、梯度归因、因果消融与 LLM 可解释等方向,帮你快速把握这一领域的核心思路与最新突破。
Language Guided Concept Bottleneck Models for Interpretable Continual Learning
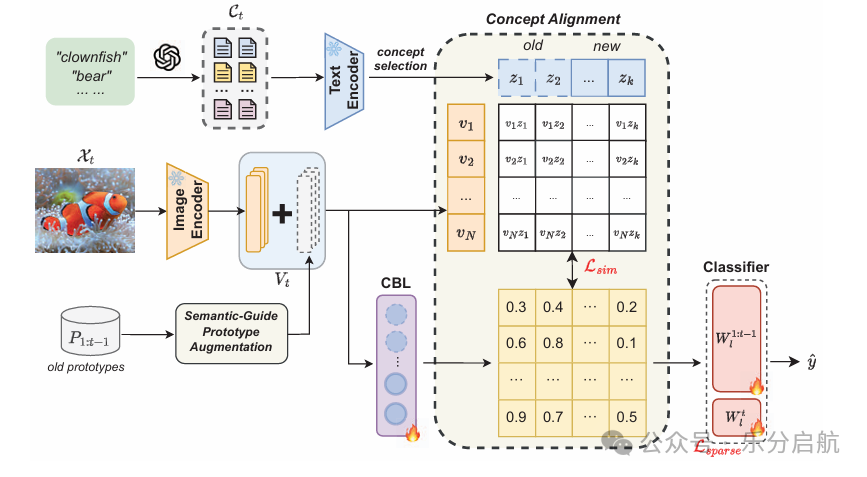
【要点】本文提出了一种融合语言指导的概念瓶颈模型,解决了连续学习中知识保持与模型可解释性的双重挑战。
【方法】通过引入概念瓶颈层并与CLIP模型对齐语义一致性,学习能够跨任务泛化的人类可理解概念。
【实验】在多个数据集上验证了方法的有效性,其中在ImageNet-subset数据集上,最终平均准确度较现有最佳方法提高了3.06%。同时,提供了模型预测的概念可视化,加深了对可解释连续学习的理解。
Hybrid Concept Bottleneck Models
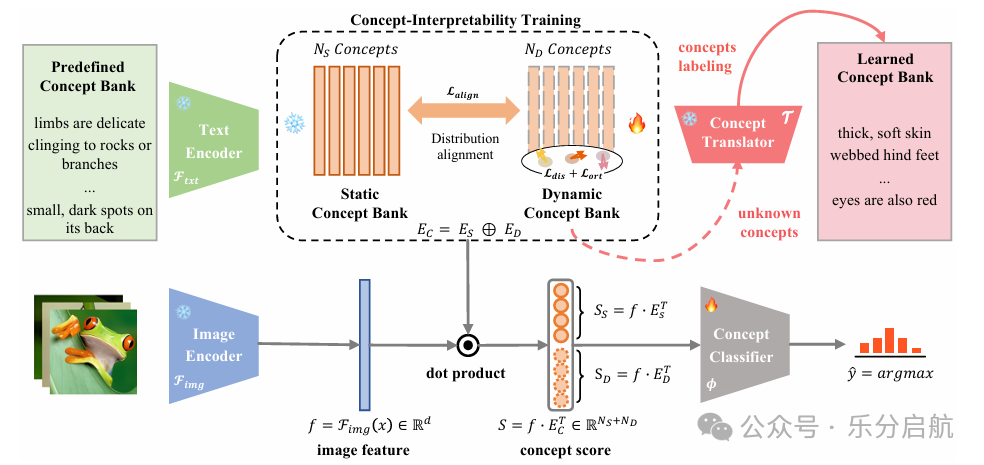
【要点】本文提出了一种Hybrid Concept Bottleneck Model(HybridCBM),通过结合静态概念库和动态概念库来解决预定义概念不完整的问题,提升了神经网络的解释性和性能。
【方法】HybridCBM框架包括静态概念库(使用大型语言模型直接构建概念)和动态概念库(使用可学习向量在训练过程中连续捕获补充的重要概念)。
【实验】通过在多个数据集上进行实验,HybridCBM优于现有最先进的CBMs,并与黑盒模型达到可比的性能。实验使用了多个数据集,并提出了新的评价指标来评估学习到的概念质量,结果显示这些指标与预定义概念相当。
Interpretable Generative Models through Post-hoc Concept Bottlenecks
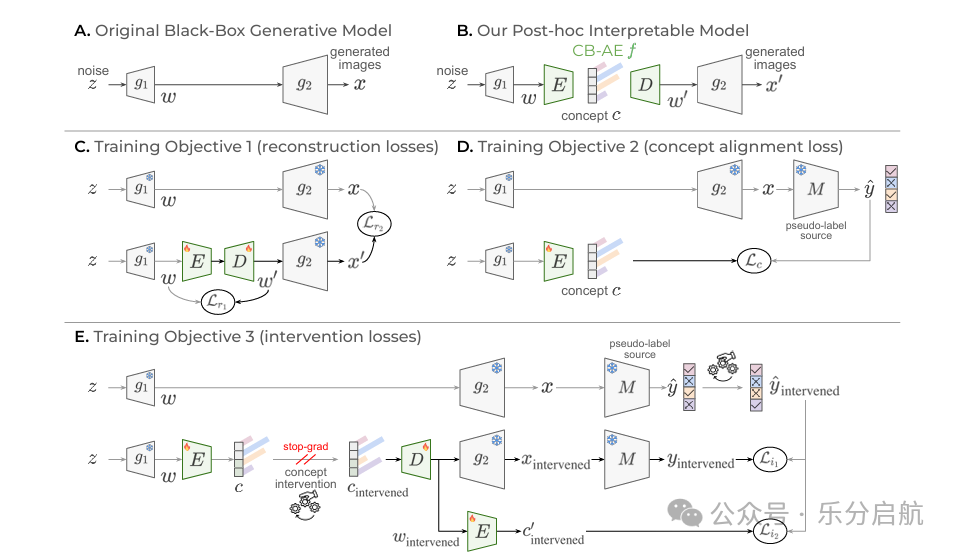
【要点】本文提出了两种新颖的低成本方法(CB-AE和CC),通过后处理技术构建可解释的生成模型,提高了模型的效率和可扩展性,并在多个标准数据集上展示了卓越的解释性和控制性。
【方法】作者通过将概念瓶颈模型(CBM)与自动编码器(CB-AE)和控制器(CC)结合,实现了无需真实数据和最小化概念监督的生成模型训练。
【实验】研究在CelebA、CelebA-HQ和CUB等多个标准数据集上进行,结果显示了平均25%的解释性和控制性提升,并通过大规模用户研究验证了方法的实际效果。
Optimal Ablation for Interpretability
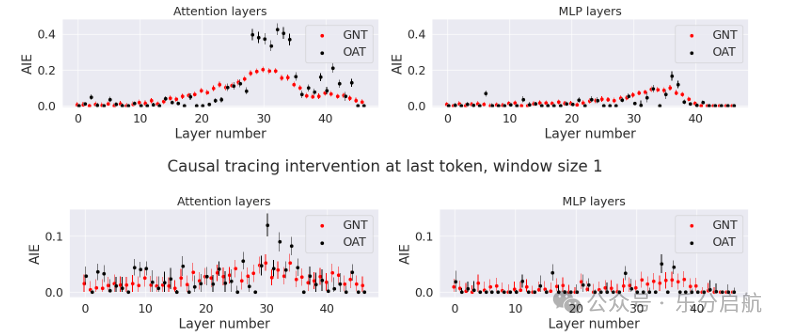
【要点】论文提出了一种新的最优消融(OA)方法,用于提高机器学习模型解释性,并通过理论分析和实验验证了其在多个解释任务中的优势。
【方法】通过测量禁用模型特定组件时对任务性能的影响来量化组件的重要性,最优消融(OA)方法旨在找到对任务影响最大的组件。
【实验】作者在多个解释性任务上测试了OA方法,包括电路发现、事实回忆定位和潜在预测,使用的数据集未在摘要中明确提及,但实验结果证明了OA方法在提高解释性方面的有效性。
更多推荐

 3
 0
- 0


 已为社区贡献5条内容

所有评论(0)