
大数据分析与应用:从理论到实践的全栈指南
大数据分析与应用:从理论到实践的全栈指南
一、引言:大数据时代的核心驱动力
随着5G、物联网、人工智能技术的爆发,数据已成为与土地、资本、劳动力同等重要的生产要素。据IDC预测,到2025年全球数据圈将增长至175ZB,其中蕴含的商业价值与社会价值亟待通过专业的分析技术挖掘。本文将从"理论框架-技术工具-实战案例-应用落地"四个维度,带大家全面掌握大数据分析的核心能力。
二、大数据分析核心理论:从基础到体系
2.1 大数据的4V特征
-
Volume(海量):数据规模从GB级跃升至PB级甚至EB级,传统数据库难以承载
-
Velocity(高速):数据产生速度呈实时性特征,如电商平台每秒数万笔交易数据
-
Variety(多样):包含结构化数据(数据库表)、半结构化数据(JSON/XML)、非结构化数据(图片/文本/音视频)
-
Value(低密价值):数据价值密度低,需通过专业分析从海量噪声中提取有效信息
2.2 大数据分析核心流程
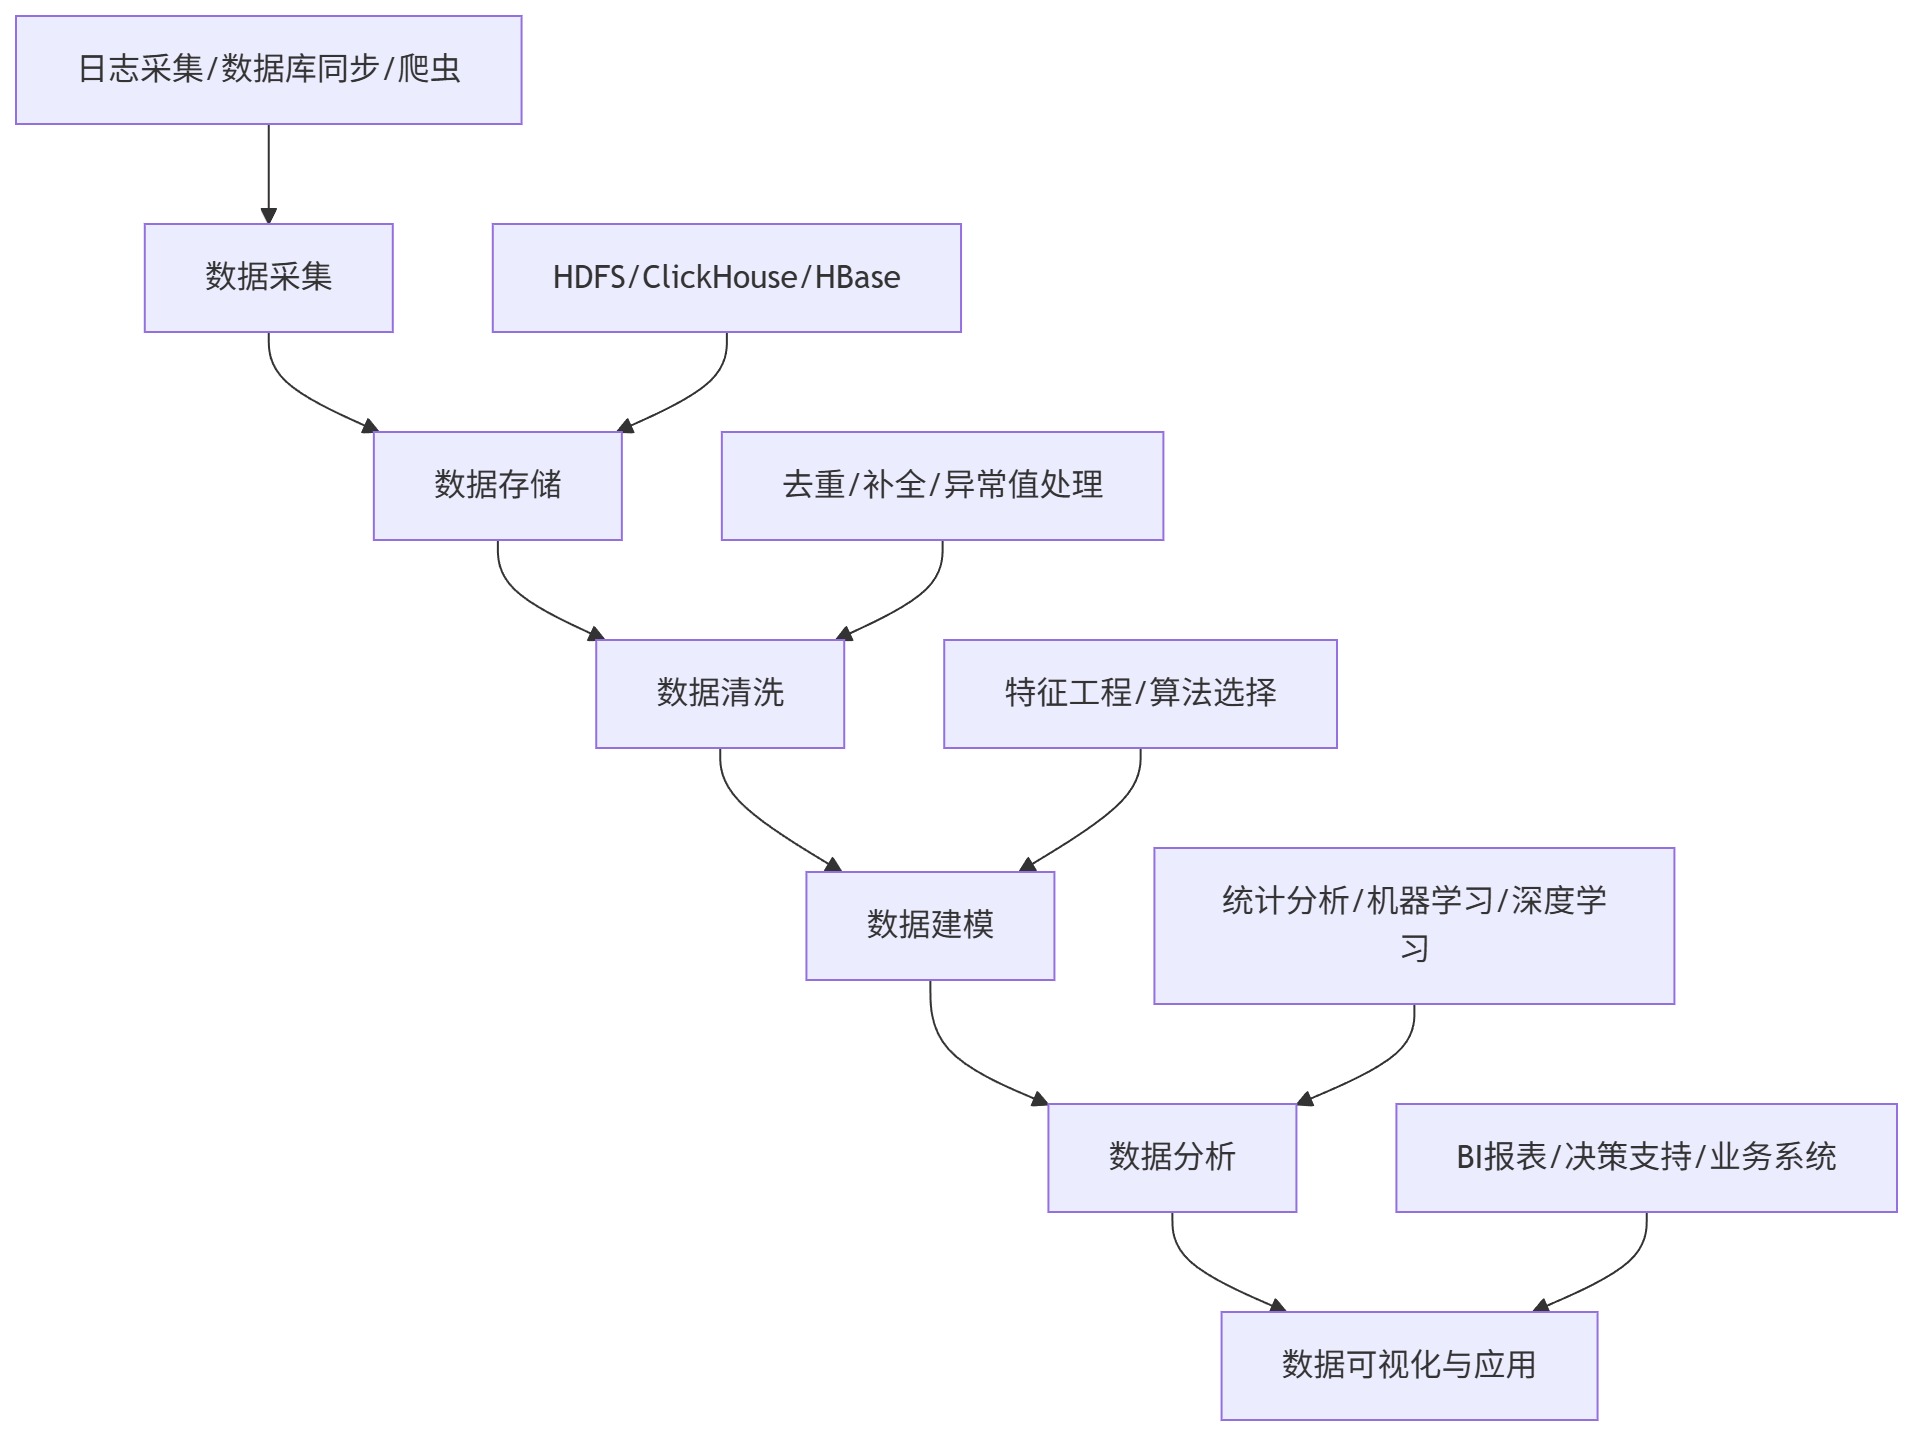
大数据分析并非单一技术,而是一套完整的技术体系,核心流程可分为6个环节,以下是各环节的目标与核心任务:
三、核心技术栈:工具与框架选型指南
3.1 数据采集工具
|
工具名称 |
核心优势 |
适用场景 |
|---|---|---|
|
Flume |
高可靠、高并发、分布式 |
日志数据采集 |
|
Sqoop |
与关系型数据库高效同步 |
MySQL/Oracle数据导入Hadoop |
|
Scrapy |
灵活可定制、爬虫效率高 |
互联网公开数据爬取 |
3.2 核心计算框架
大数据计算框架分为离线计算与实时计算两大类,需根据业务响应要求选型:
-
离线计算:Hadoop MapReduce - 适用于批量处理海量数据,如每日用户行为统计,优势是稳定性强、成本低
-
实时计算:Spark Streaming/Flink - 适用于实时推荐、风控等场景,Flink基于事件驱动,延迟可达毫秒级
3.3 分析工具:Python生态为主
Python因丰富的库支持成为大数据分析首选语言,核心库包括:
-
数据处理:Pandas(结构化数据)、PySpark(分布式数据)
-
数值计算:NumPy(矩阵运算)
-
可视化:Matplotlib(基础绘图)、Seaborn(统计绘图)、Plotly(交互式绘图)
-
机器学习:Scikit-learn(传统算法)、TensorFlow/PyTorch(深度学习)
四、实战案例:电商用户购买行为分析
4.1 需求背景
某电商平台需分析用户浏览-加购-下单的转化路径,识别高价值用户特征,为精准营销提供数据支撑。数据包含用户ID、浏览时间、商品类别、加购状态、下单状态等字段。
4.2 技术选型
数据规模1000万条,采用"Pandas+Matplotlib"进行离线分析,流程如下:数据加载→数据清洗→转化漏斗分析→用户特征分析→结果可视化。
4.3 完整代码实现
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
# 1. 数据加载(模拟1000万条电商用户行为数据)
np.random.seed(42) # 保证结果可复现
user_ids = np.random.randint(10000, 99999, size=10000000)
view_times = pd.date_range(start='2025-11-01', end='2025-11-30', freq='min', periods=10000000)
categories = np.random.choice(['电子产品', '服装', '食品', '家居', '美妆'], size=10000000)
# 模拟加购和下单状态(加购率约20%,下单率约5%)
add_cart = np.random.choice([0, 1], size=10000000, p=[0.8, 0.2])
order = np.where((add_cart == 1) & (np.random.random(size=10000000) < 0.25), 1, 0)
# 构建DataFrame
df = pd.DataFrame({
'user_id': user_ids,
'view_time': view_times,
'category': categories,
'add_cart': add_cart,
'order': order
})
# 2. 数据清洗(去重、异常值处理)
# 去重:同一用户同一时间的重复记录
df_clean = df.drop_duplicates(subset=['user_id', 'view_time'])
# 异常值处理:排除浏览时间异常的记录
df_clean = df_clean[(df_clean['view_time'] > '2025-11-01') & (df_clean['view_time'] < '2025-11-30')]
# 3. 转化漏斗分析
total_view = df_clean['user_id'].nunique() # 总浏览用户数
add_cart_user = df_clean[df_clean['add_cart'] == 1]['user_id'].nunique() # 加购用户数
order_user = df_clean[df_clean['order'] == 1]['user_id'].nunique() # 下单用户数
# 计算转化率
add_cart_rate = add_cart_user / total_view * 100
order_rate = order_user / add_cart_user * 100
total_conversion = order_user / total_view * 100
# 4. 高价值用户特征分析(下单用户的商品类别偏好)
high_value_user = df_clean[df_clean['order'] == 1]
category_prefer = high_value_user['category'].value_counts(normalize=True) * 100
# 5. 结果可视化
plt.rcParams['font.sans-serif'] = ['SimHei'] # 解决中文显示问题
plt.figure(figsize=(12, 5))
# 子图1:转化漏斗
ax1 = plt.subplot(1, 2, 1)
funnel_data = [total_view, add_cart_user, order_user]
funnel_labels = ['浏览用户', '加购用户', '下单用户']
colors = ['#3498db', '#2ecc71', '#e74c3c']
bars = ax1.bar(funnel_labels, funnel_data, color=colors)
# 在柱状图上添加数值标签
for bar, data in zip(bars, funnel_data):
height = bar.get_height()
ax1.text(bar.get_x() + bar.get_width()/2., height + 1000,
f'{data:,}', ha='center', va='bottom')
ax1.set_title('电商用户转化漏斗', fontsize=14)
ax1.set_ylabel('用户数量')
# 子图2:高价值用户商品偏好
ax2 = plt.subplot(1, 2, 2) wedges, texts, autotexts = ax2.pie(category_prefer.values, labels=category_prefer.index, autopct='%1.1f%%', colors=colors, startangle=90)
ax2.set_title('高价值用户商品类别偏好', fontsize=14)
plt.tight_layout()
plt.savefig('ecommerce_user_analysis.png', dpi=300, bbox_inches='tight')
plt.close() # 输出核心结论 print(f"1. 转化漏斗核心指标:")
print(f" - 总浏览用户数:{total_view:,}")
print(f" - 加购转化率:{add_cart_rate:.2f}%")
print(f" - 加购到下单转化率:{order_rate:.2f}%")
print(f" - 整体转化(浏览到下单):{total_conversion:.2f}%")
print(f"\n2. 高价值用户商品偏好TOP3:")
for idx, (category, rate) in enumerate(category_prefer.head(3).items(), 1):
print(f" {idx}. {category}:{rate:.2f}%")
4.4 结果解读
1. 转化漏斗:通过代码运行可得到,浏览用户约830万,加购转化率20.1%,加购到下单转化率24.8%,整体转化5.0%,需重点优化加购环节的用户留存;
2. 用户偏好:高价值用户中,电子产品占比35.2%,服装占28.1%,是核心营销品类,可针对这两类商品设计专属优惠券;
3. 行动建议:对仅浏览未加购的用户推送"限时折扣",对加购未下单的用户发送"库存预警"提醒,提升转化效率。
五、主流应用场景:技术落地的行业实践
5.1 金融行业:风险控制与智能投顾
银行通过分析用户征信数据、交易流水、行为数据,构建风控模型识别欺诈交易,如信用卡盗刷检测;基金公司利用大数据分析宏观经济、行业数据及用户风险偏好,提供个性化投顾建议,如蚂蚁财富的智能推荐功能。
5.2 医疗行业:疾病预测与精准医疗
通过分析电子病历、基因数据、影像数据,实现疾病早期预测(如肺癌影像AI诊断);结合患者基因特征与药物反应数据,为癌症患者制定个性化治疗方案,提升治疗效果。
5.3 交通行业:智能调度与路况预测
滴滴、高德等平台通过实时采集车辆位置、路况、天气数据,预测拥堵情况并优化派单路线,降低司机空驶率;城市交通部门利用大数据制定潮汐车道、信号灯时长调整方案,提升通行效率。
六、未来趋势:大数据与AI的深度融合
-
实时化:Flink等实时计算框架普及,从"T+1"离线分析转向"秒级"实时决策,如直播电商的实时推荐
-
智能化:AI与大数据深度融合,从"描述性分析"(发生了什么)转向"预测性分析"(将发生什么)和"处方性分析"(该怎么做)
-
轻量化:边缘计算与大数据结合,在物联网设备端实现数据预处理,降低云端传输压力,如工业设备的实时故障诊断
-
隐私化:联邦学习、差分隐私技术成熟,在保护数据隐私的前提下实现多机构数据协同分析,解决医疗、金融等行业的数据孤岛问题
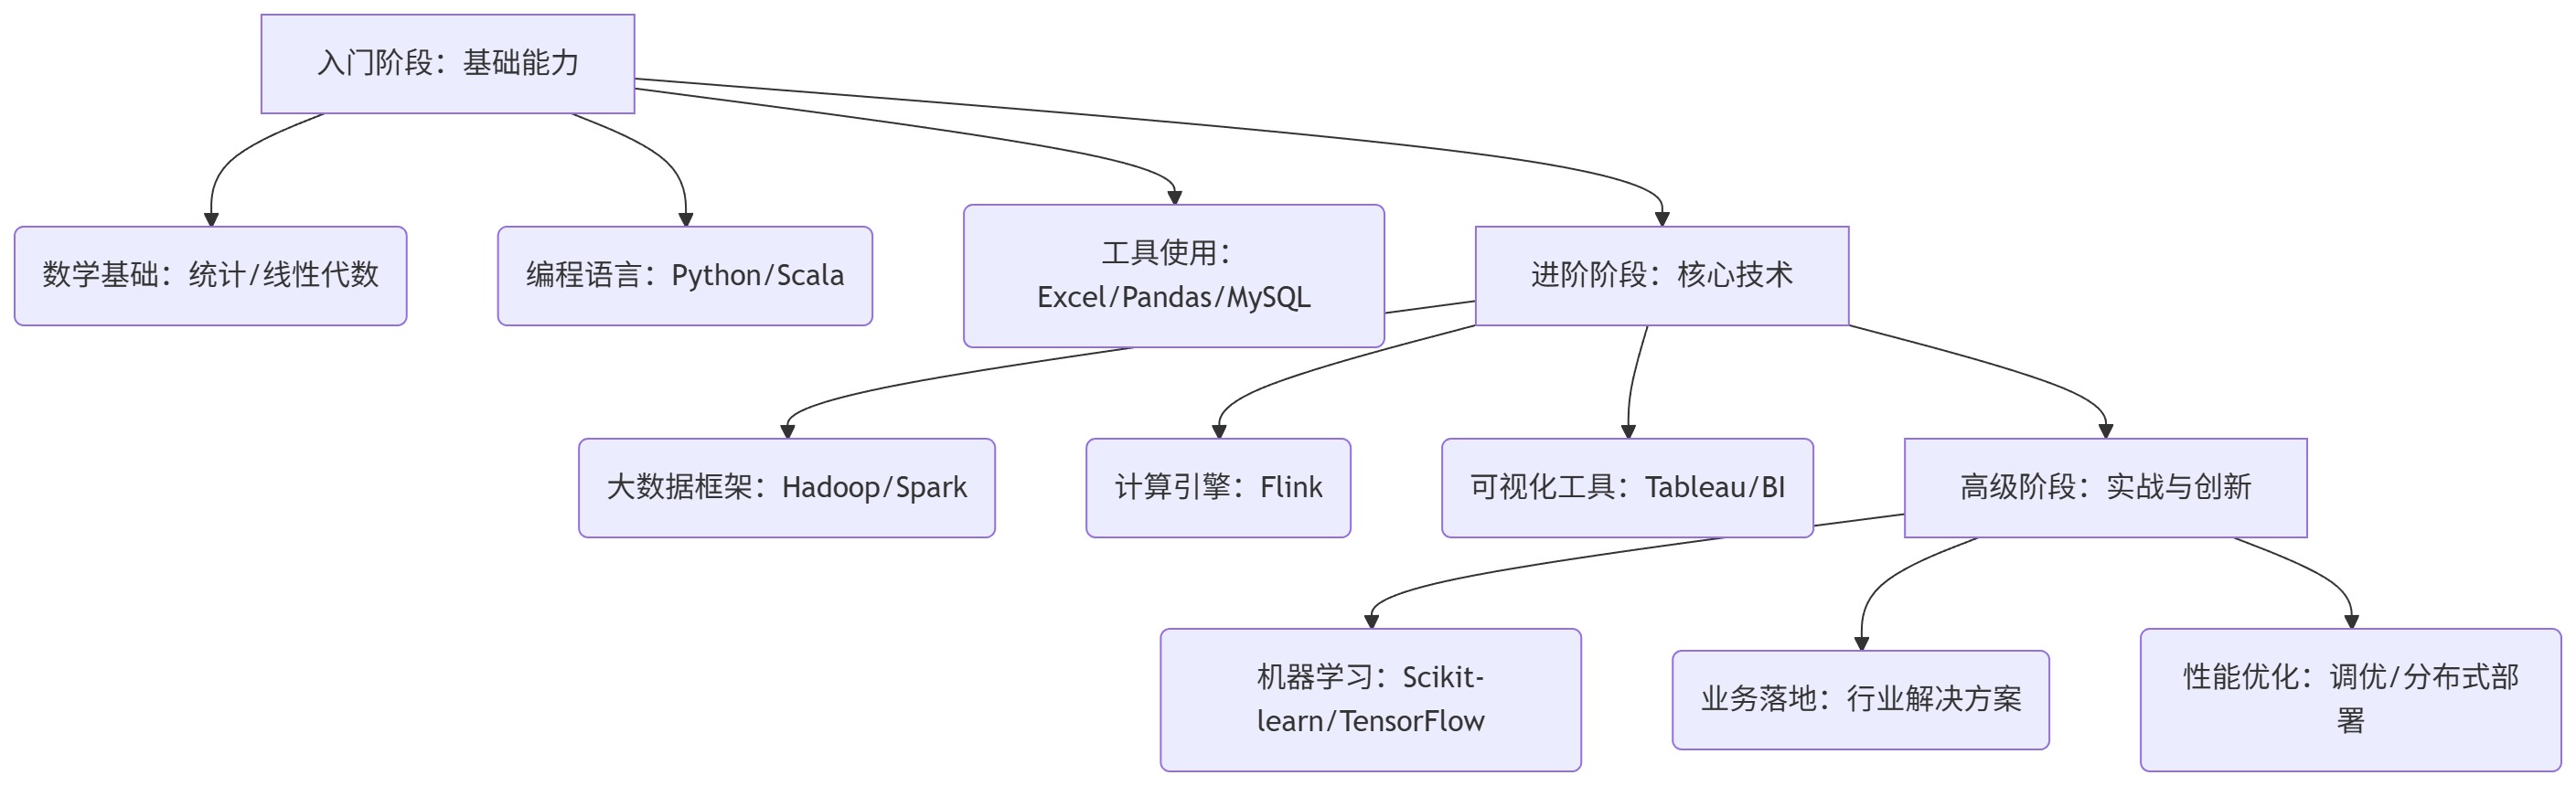
七、学习路径:从入门到进阶的成长指南
八、总结
大数据分析的核心价值在于"从数据中提取洞察,驱动业务决策"。本文从理论框架出发,通过电商实战案例展示了技术落地的完整流程,涵盖数据处理、建模分析、可视化等关键环节。随着AI技术的发展,大数据分析将从辅助决策工具升级为核心生产力,掌握其核心能力将成为开发者的重要竞争力。
更多推荐

 13
 0
- 0


 已为社区贡献12条内容

所有评论(0)