
[大模型项目实践]基于 LangGraph1.0 的 RAG 系统实现详解
·
1. 简介
本项目实现了一个基于 LangGraph 的高级检索增强生成(Advanced RAG)系统。与标准 RAG 不同,该系统基于LangGraph1.0 中的图(Graph)编排的能力来编排复杂的工作流,具备自我修正(Self-Correction)和自适应路由(Adaptive Routing) 能力。
传统 RAG 存在以下痛点:
- 检索质量差:检索到的文档可能与问题无关。
- 幻觉问题:模型可能生成与检索内容不符的答案。
- 知识盲区:本地知识库无法回答时,系统缺乏外部搜索能力。
- 问题模糊:用户原始问题可能难以检索,需要优化。
2. 系统架构
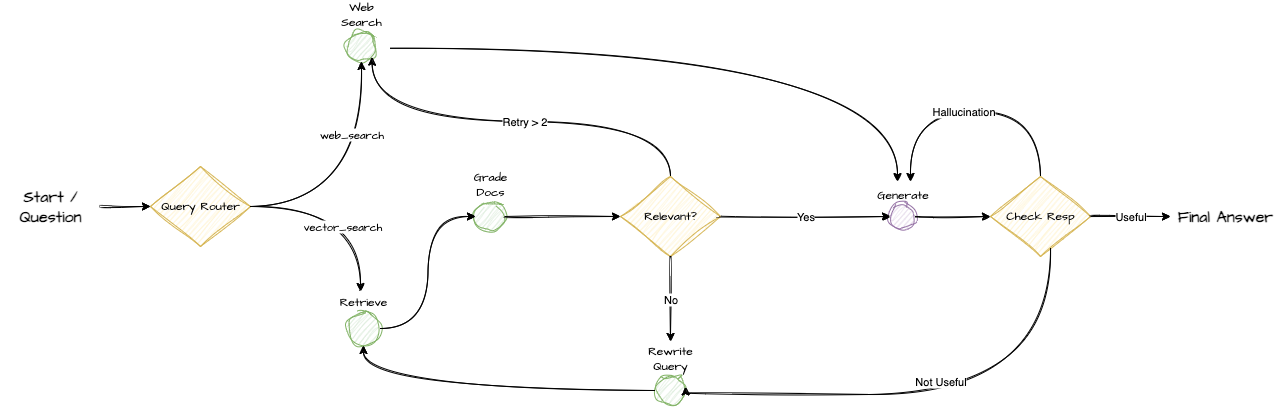
本系统构建了 StateGraph工作流,将 RAG 流程拆分为多个节点(Nodes),通过边(Edges)和条件边(Conditional Edges)连接。
2.1 核心流程图
3. 核心策略与模式
本项目融合了以下三种高级 RAG 模式:
3.1 Adaptive RAG (自适应 RAG)
- 在流程开始时,分析用户问题的意图。如果问题涉及即时信息或常识(适合搜索引擎),则直接路由到
web_search;如果涉及特定领域知识,则路由到retrieve(向量库)。
3.2 Corrective RAG (CRAG - 修正性 RAG)
- 对检索回来的文档进行打分筛选(grade)。
- 如果没有合格文档,系统不会强行生成,而是进入修正流程:调用
transform_query重写问题并重新检索。 - 降级策略:如果重写次数超过阈值(例如 2 次),则放弃本地检索,转而使用
web_search兜底。
3.3 Self-RAG (自我反思 RAG)
- 生成答案后,进行两轮检查:
- 幻觉检查 (Hallucination Check): 答案是否忠实于检索到的文档?如果不忠实(有幻觉),则重新生成 (
generate)。 - 有用性检查 (Answer Relevance Check): 答案是否回答了用户问题?如果不相关,则认为检索方向错误,进行问题重写 (
transform_query)。
- 幻觉检查 (Hallucination Check): 答案是否忠实于检索到的文档?如果不忠实(有幻觉),则重新生成 (
4. 详细实现说明
4.1 状态管理 (State Management)
使用 [GraphState]在各节点间传递上下文数据:
class GraphState(TypedDict):
    messages: Annotated[list[BaseMessage], add_messages] # 聊天历史
    query: str                # 当前处理的问题(可能会被重写)
    docs: list[Document]      # 检索或搜索到的文档列表
    generation: str           # LLM 生成的答案
    transform_count: int      # 问题重写计数器(防止死循环)
4.2 关键节点 (Nodes)
| 节点名称 | 对应函数 | 功能描述 |
|---|---|---|
| retrieve | [retrieve_node] | 从 Milvus/VectorStore 检索相关文档。 |
| grade_documents | [grade_documents_node] | 使用 LLM 评估每个文档的相关性,过滤掉无关文档。 |
| web_search | [web_search_node] | 调用搜索引擎(如 Tavily/Google)获取外部信息。 |
| transform_query | [transform_query] | 将用户问题重写为更利于检索的形式,并将重试计数器 +1。 |
| generate | [multi_doc_generate] | 基于 docs 和 query 生成最终回答。 |
4.3 关键路由 (Routers)
4.3.1. Generate Router
决定检索后是生成还是重试。
- 有文档 ->
generate - 无文档且次数 <= Threshhold ->
transform_query - 无文档且次数 > Threshhold ->
web_search(转网页搜索)
B. Grade Response Router
决定生成结果是否合格。
- 有幻觉 -> 重试生成
- 无幻觉但无用 -> 重写问题
- 无幻觉且有用 -> 结束
5. 代码实现片段 (LangGraph 构建)
# 初始化图
builder = StateGraph(GraphState)

# 添加节点
builder.add_node("web_search", web_search_node)
builder.add_node("retrieve", retrieve_node)
builder.add_node("grade_documents", grade_documents_node)
builder.add_node("generate", multi_doc_generate)
builder.add_node("transform_query", transform_query)

# 定义入口路由
builder.add_conditional_edges(START, query_path_router, {
    "web_search": "web_search",
    "vector_search": "retrieve"
})

# 定义检索后的评估路由
builder.add_conditional_edges("grade_documents", generate_router, {
    "web_search": "web_search",
    "generate": "generate",
    "transform_query": "transform_query"
})

# 定义生成后的反思路由
builder.add_conditional_edges("generate", grade_generated_resp_router, {
    "not supported": "generate",
    "useful": END,
    "not useful": "transform_query"
})

# 形成闭环
builder.add_edge("transform_query", "retrieve")

graph = builder.compile()
6. 总结
该 Advanced RAG 架构通过引入反馈循环(Feedback Loops),显著提高了系统的鲁棒性。它不再是一条从检索到生成的单行道,而是一个能够自我纠错的智能网络。虽然这增加了 Token 消耗和延迟,但对于要求高准确率和高召回率的复杂知识问答场景。
更多推荐

 34
 0
- 0


 已为社区贡献7条内容

所有评论(0)