
机器学习(2)
·
认识数据
数据集 dataset、样本 sample、特征 feature、类别标签 label、向量 vector、矩阵 matrx
IRIS鸢尾花数据集
研究问题:如何根据花的外形特征判断花的种类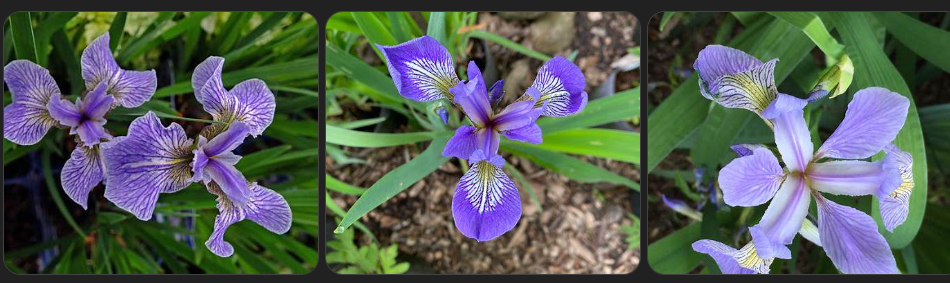
1️⃣ 一共有多少数据?
-
150 条样本(数据行)
-
每一条样本 = 一朵鸢尾花
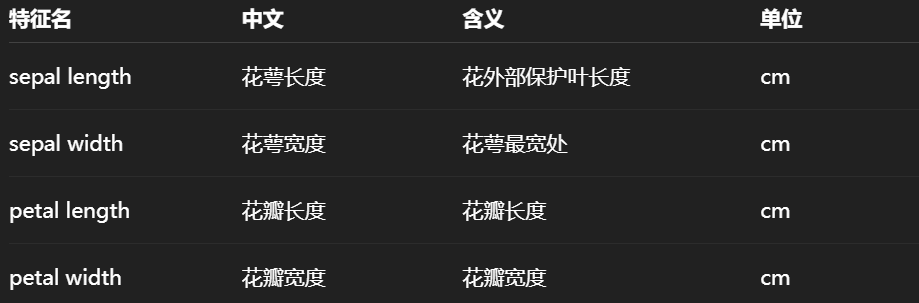
2️⃣ 有哪些特征?
每一朵花都有 4 个数值特征(输入 x,需要一个高维特征空间(feature space)):
3️⃣ 有哪些类别?
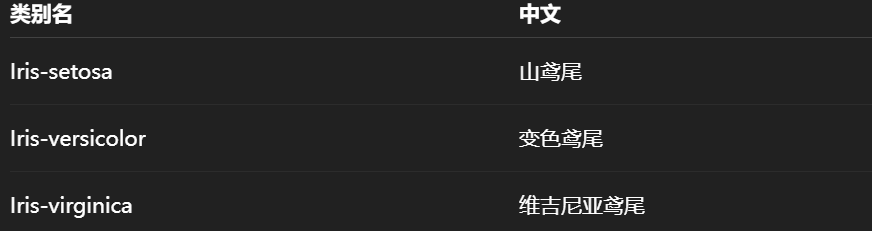
IRIS 有 3 个类别(输出 y):
机器学习的目标就是:
给你前 4 个数字(花的数值特征),让模型自动判断它属于哪一类鸢尾花(类别) 🌸
结构化数据和非结构化数据
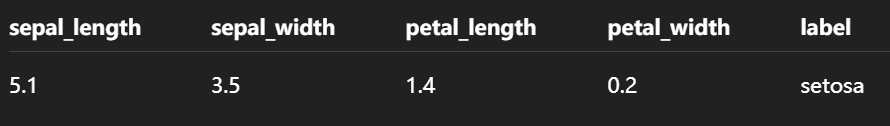
结构化数据 = 能放进“表格”的数据
- 🌸 IRIS 数据集就是结构化数据
非结构化数据 = 不能直接放进表格的数据
- 图片、文本、音频数据
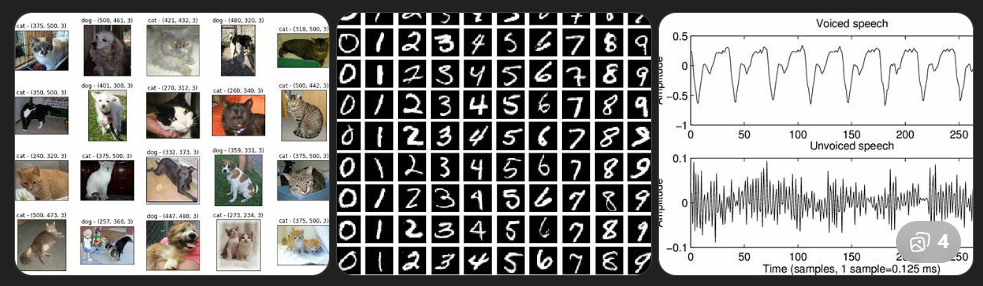
机器学习的主要任务
分类
- 根据已知样本特征判断样本的类别
- 二分类、多分类、多标签分类
- 二分类:猫狗识别、垃圾邮件的识别(0/1)
- 多分类:鸢尾花的识别、人脸识别、手写体识别(0--N)
- 多标签分类:电影类型标注(盗梦空间属于动作、科幻类)、图片多标签识别(一个图片里有狗、人、车)
回归
- 根据已知样本特征,预测一个“连续数值”
- 线性回归
- 多项式回归
- 一个因变量
- 一个或多个自变量
- 任何函数都可以用多项式逼近
- 逻辑回归
监督学习
监督学习 = 学一个函数 f(x)
-
分类:f(x) → 类别
-
回归:f(x) → 数值
机器学习的分类
是否有人类监督
- 监督学习
- 分类和回归
- 训练的数据有标记
- 无监督学习
- 训练数据未经标记
- 聚类(例:商品推荐可以基于不同的类型的客户:企业客户、家庭客户)
- K均值算法
- 密度聚类
- 最大期望算法
- 降维(不丢失数据的情况下大量简化数据,把多个特征合并为一个特征)
- 主成分分析
- 核方法
- 关联规则学习(啤酒和尿布的故事,泡面加卤蛋🍜)
- 挖掘特征间关联关系
- Apriori方法
- Eclat方法
- 半监督学习
- 少量标记数据
- 大量无标记数据
- 强化学习(训练小狗🐕)
- 观测环境
- 估计状态
- 执行操作
- 获得回报或惩罚
数据的使用方式
- 批量学习
- 先训练再使用
- 需要大量的时间和计算资源
- 通常都是离线完成
- 在线学习
- 循序渐进
- 边学边用
模型的泛化
- 基于实例
- 先记住训练实例
- 相似度计算
- 基于模型
- 先构建模型
- 再预测
机器学习的误区和局限
- 数据并不是越多越好的
- 模型的可信度(深度学习是一个黑盒子,可解释性)
- 随机和确定性的问题
- 小样本集怎么使用
更多推荐

 22
 0
- 0


 已为社区贡献20条内容

所有评论(0)