
ubuntu 中检验 docker 容器内部能否使用 GPU
·
一、参考教程
docker 如何检验能调用GPU
该教程的逻辑可以,但是操作起来不是那么顺畅(不能无脑跟着做),因此在此基础上改了一版。
二、检验步骤
-
首先确保 ubuntu 已经安装好 nvidia 驱动和 nvidia-container-toolkit 。
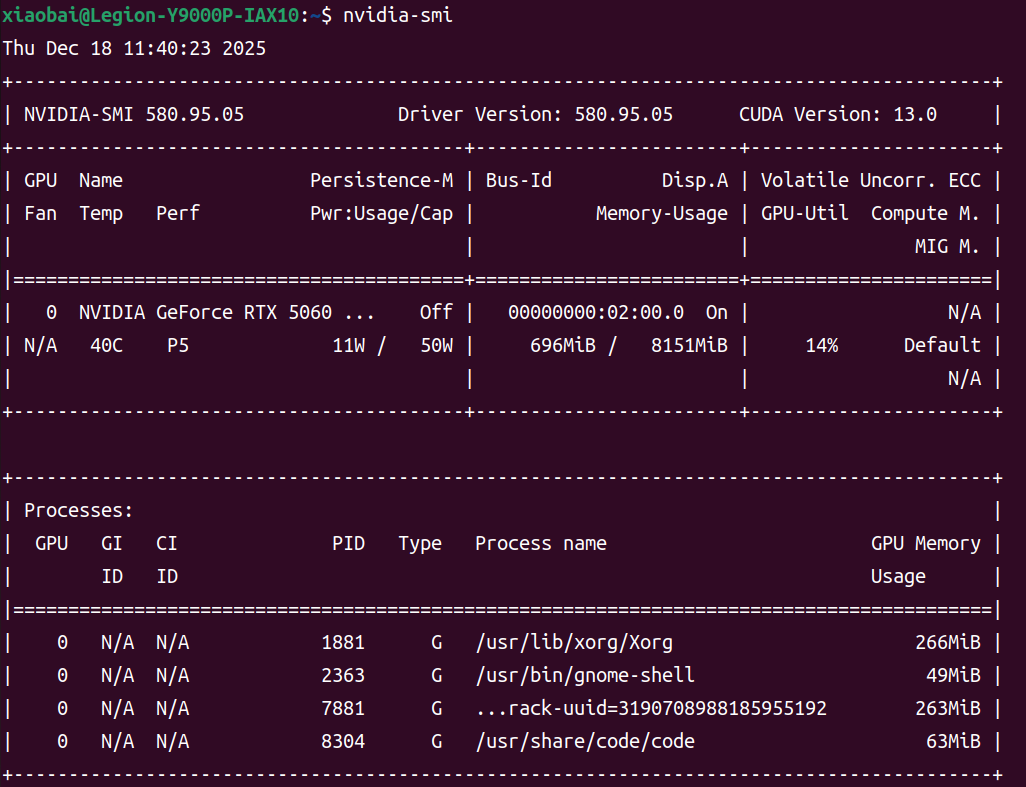
通过nvidia-smi检查最高支持的 cuda 版本,如下图中最高支持 13.0 的 cuda,因此后续使用的 cuda 都必须小于 13.0 版本。
-
拉取 nvidia 提供的 cuda 镜像
sudo docker pull nvidia/cuda:12.8.1-cudnn-devel-ubuntu22.04注意,需要拉取 devel 版本,因为 runtime 和 base 版本不包含 nvcc 和 CUDA 头文件。
-
创建容器
sudo docker run --gpus all --name gpu-test -it nvidia/cuda:12.8.1-cudnn-devel-ubuntu22.04 /bin/bash接下来的测试过程就是在这个容器内进行的。
-
创建测试文件
# 创建文件
touch vector_add.cu
cat > vector_add.cu << 'EOF' #include <stdio.h> #include <cuda.h> #define N 1000 __global__ void vectorAdd(float *A, float *B, float *C) { int i = threadIdx.x; if (i < N) C[i] = A[i] + B[i]; } int main() { float *A, *B, *C; float *d_A, *d_B, *d_C; A = (float *)malloc(N * sizeof(float)); B = (float *)malloc(N * sizeof(float)); C = (float *)malloc(N * sizeof(float)); for (int i = 0; i < N; i++) { A[i] = i; B[i] = i; } cudaMalloc(&d_A, N * sizeof(float)); cudaMalloc(&d_B, N * sizeof(float)); cudaMalloc(&d_C, N * sizeof(float)); cudaMemcpy(d_A, A, N * sizeof(float), cudaMemcpyHostToDevice); cudaMemcpy(d_B, B, N * sizeof(float), cudaMemcpyHostToDevice); vectorAdd<<<1, N>>>(d_A, d_B, d_C); cudaMemcpy(C, d_C, N * sizeof(float), cudaMemcpyDeviceToHost); for (int i = 0; i < N; i++) printf("%f + %f = %f\n", A[i], B[i], C[i]); cudaFree(d_A); cudaFree(d_B); cudaFree(d_C); free(A); free(B); free(C); return 0; } EOF补充:vector_add.cu 是一个CUDA向量加法程序,用于演示GPU并行计算的基本流程。
-
运行测试程序
# 编译 cuda 程序
nvcc -o vector_add vector_add.cu
# 执行程序
./vector_add
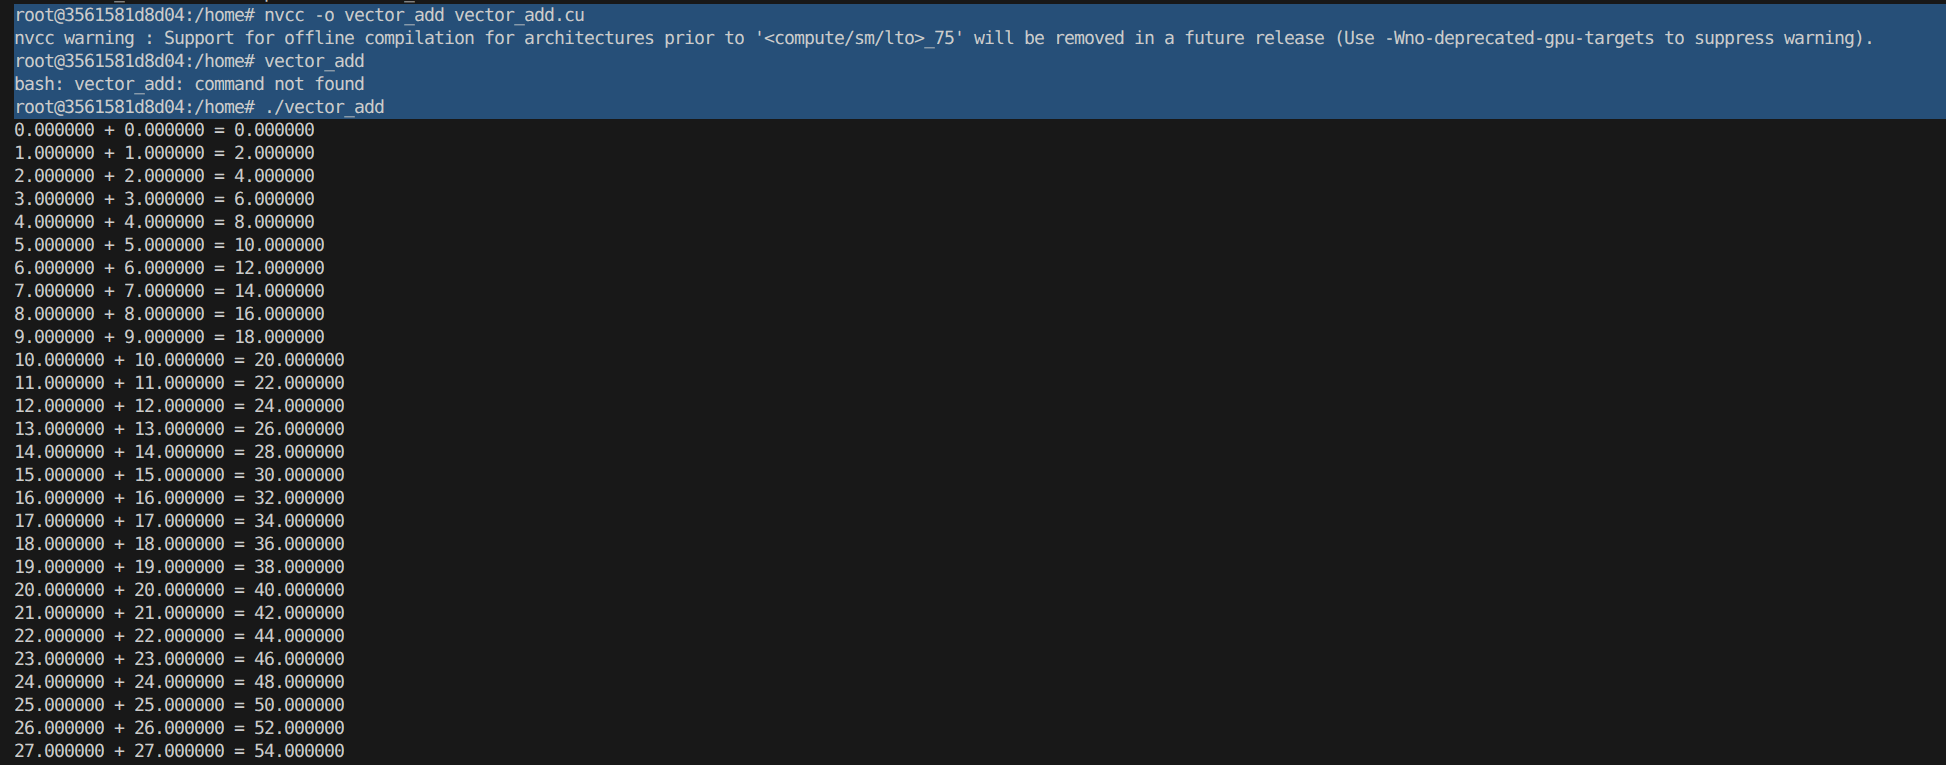
显示结果如下图,则说明 docker 容器可以使用 GPU
更多推荐



 21
 0
- 0


 已为社区贡献3条内容

所有评论(0)