
机器学习(6-2)
模型误差
偏差(Bias) - 预测结果的准确程度
高偏差原因:
- 模型本身不适合
- 例:线性模型拟合非线性数据
- 欠拟合
- 模型未收敛(射击手只在室内练习没在室外练习过)
方差(Variance) - 预测结果的集中程度
高方差原因:
- 模型过于复杂
- 例:特征太多(射击手心理活动过多:没吃饱)
- 过拟合
- 噪声数据影响(错误的肌肉记忆)
噪声(Noise) - 当前任务期望误差下界
原因:
- 观测误差
- 计算机精度误差
- 方法误差
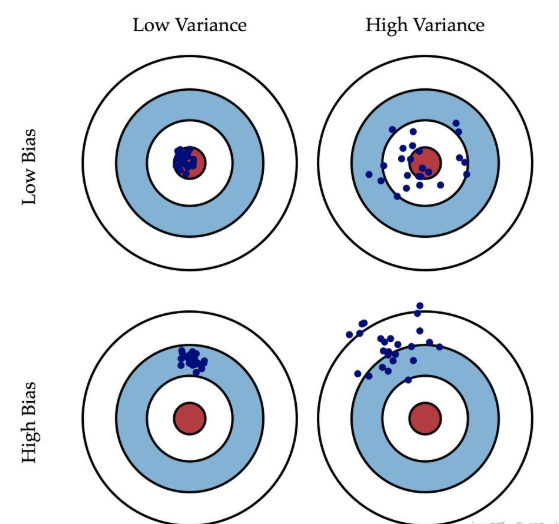
模型误差的组成
- 偏差:算法的拟合能力
- 方差:数据扰动影响力
- 噪声:任务期望误差的下界
偏差和方差的关系(相互冲突)
- 偏差降低则方差会提高
- 方差降低则偏差会提高
偏差、方差和模型复杂度的关系
- 不同算法有不同偏差和方差
- 非参数方程方差高,如KNN
- 参数方程偏差高,如回归算法
- 偏差方差通常可以调整
降低偏差:
- 寻找更好的特征
- 增加更多的特征
- 提高模型复杂度
降低方差:
- 尽量选择复杂度模型
- 尽可能增加样本数
- 尽可能减少数据维度
- 使用验证集
- 使用正则化
正则化
用约束换稳定,降低方差,防止过拟合
L1范数(LASSO回归)
L2范数(岭回归)
LASSO和岭回归
LASSO回归
-
会把部分参数压成 0(删除某些特征)
-
自动特征选择
-
稀疏模型
岭回归
-
参数变小但不为 0(所有特征都保留,只是权重变小)
-
模型更平滑、稳定
-
最常用
数据准备
import numpy as np
from sklearn import datasets
import matplotlib.pyplot as plt
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import PolynomialFeatures
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
import warnings
warnings.filterwarnings("ignore")

import pandas as pd
boston = (pd.read_csv('./BostonHousing.csv')).to_numpy()
x = boston[:,12]
y = boston[:,-1]
x = x[y<50]
y = y[y<50]

from sklearn.model_selection import train_test_split

np.random.seed(666)
x_train,x_test,y_train,y_test = train_test_split(x.reshape(-1,1),y)


def show_plot(model):
    plt.scatter(x,y)
    X_plot = np.linspace(0,40,100).reshape(100,1)
    y_polt = model.predict(X_plot)
    plt.plot(X_plot[:,0],y_polt,color='red')
    plt.axis([0,40,0,50])
    plt.show()
LASSO回归代码实现
from sklearn.linear_model import Lasso

def LassoRegression(degree,alpha):
    return Pipeline([
        ("poly",PolynomialFeatures(degree=degree)),
        ("std_scale",StandardScaler()),
        ("lasso_reg",Lasso(alpha=alpha))
    ])

lasso_reg = LassoRegression(20,1)
lasso_reg.fit(x_train,y_train)
y_predict = lasso_reg.predict(x_test)
mean_squared_error(y_test,y_predict)

show_plot(lasso_reg)
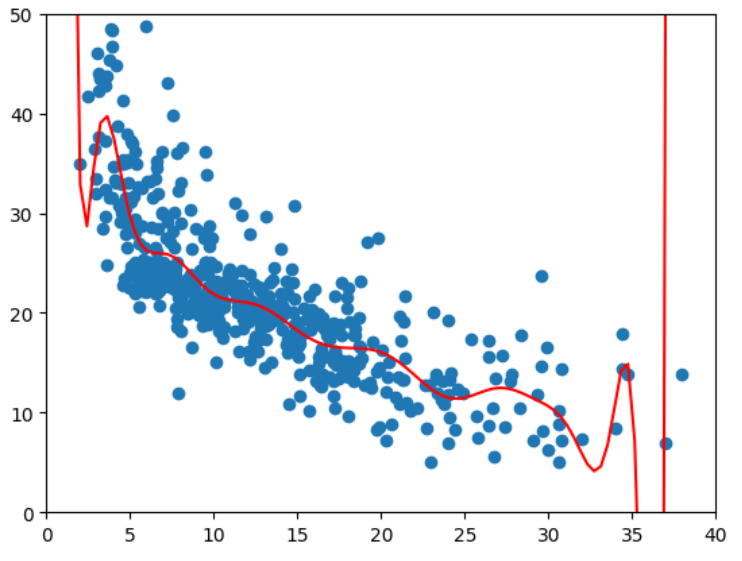
岭回归代码实现
from sklearn.linear_model import Ridge

def RidgeRegression(degree,alpha):
    return Pipeline([
        ("poly",PolynomialFeatures(degree=degree)),
        ("std_scale",StandardScaler()),
        ("ridge_reg",Ridge(alpha=alpha))
    ])

ridge_reg = RidgeRegression(20,100)
ridge_reg.fit(x_train,y_train)
y_predict = ridge_reg.predict(x_test)
mean_squared_error(y_test,y_predict)

show_plot(ridge_reg)
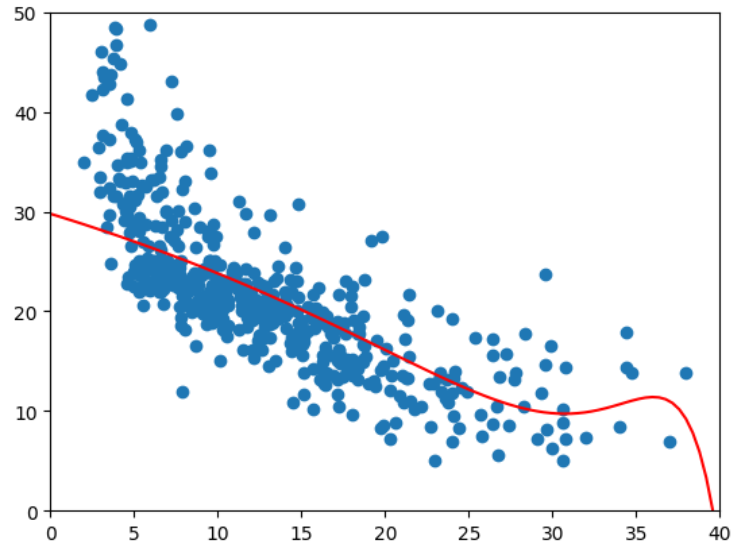
模型泛化
机器学习算法对于新鲜样本的适应能力(比如使用美颜照片训练模型,当面对无美颜的照片时能否测试准确)
泛化理论:衡量模型复杂度
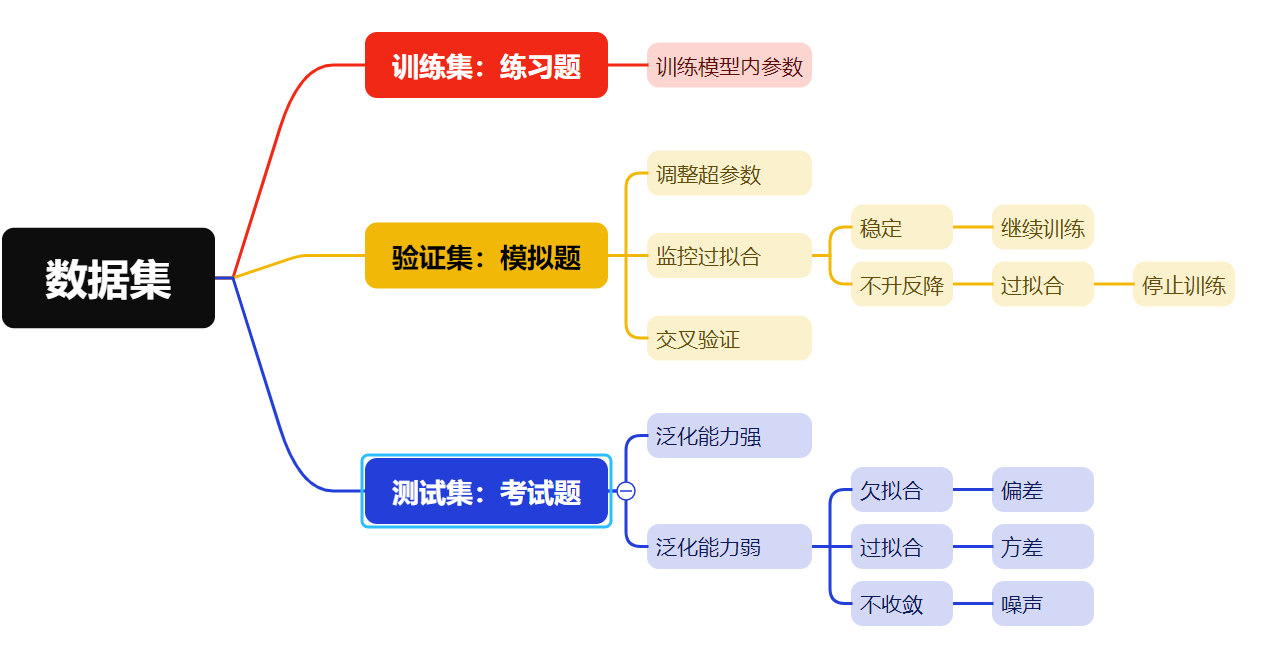
评价指标
混淆矩阵
| 实际 \ 预测 | 预测为正 | 预测为负 |
|---|---|---|
| 实际为正 | TP | FN |
| 实际为负 | FP | TN |
精确度(Precision):预测为正的里面,有多少是真的
召回率(Reccall):真正的正样本,被找回了多少
准确率(Accuracy):整体预测对了多少
F1Score
PR曲线
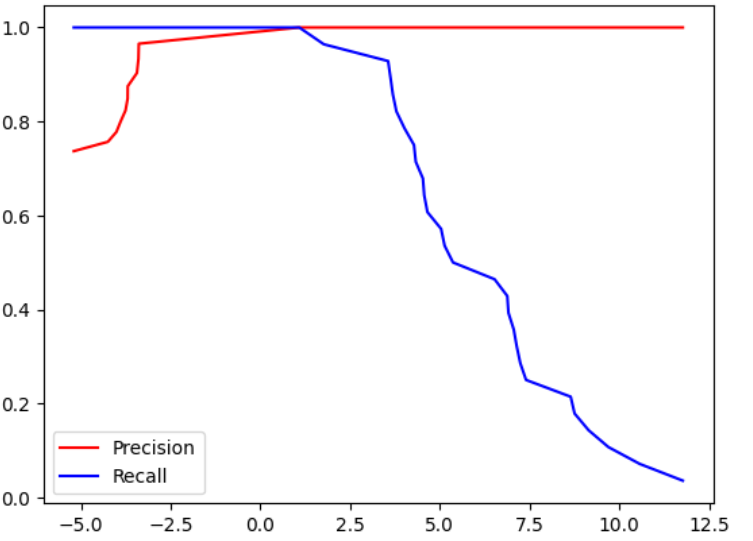
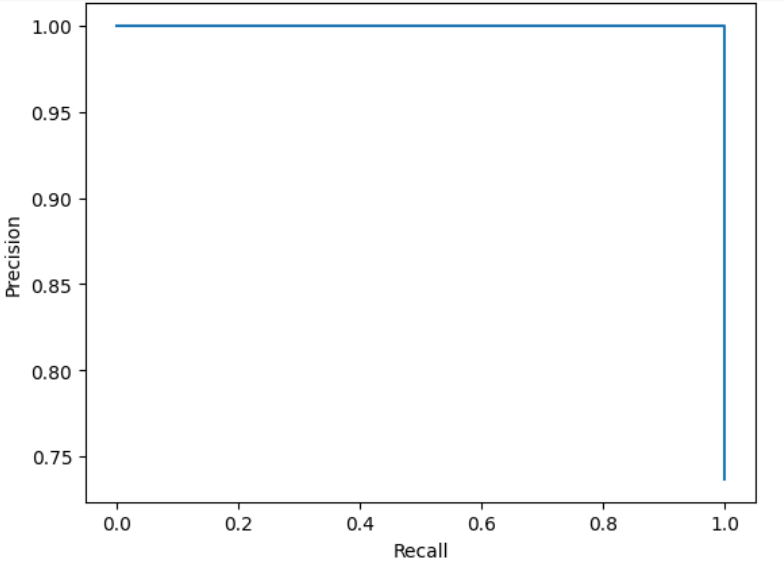
在不同分类阈值(thresholds)下,观察“预测为正的质量”和“找全正样本能力”之间的权衡
输入:
-
y_test -
decision_scores
# 让逻辑回归模型给每个测试样本算一个“决策分数”
decision_scores = log_reg.decision_function(X_test)
输出:
-
横轴:Recall(召回率)
-
纵轴:Precision(精确率)
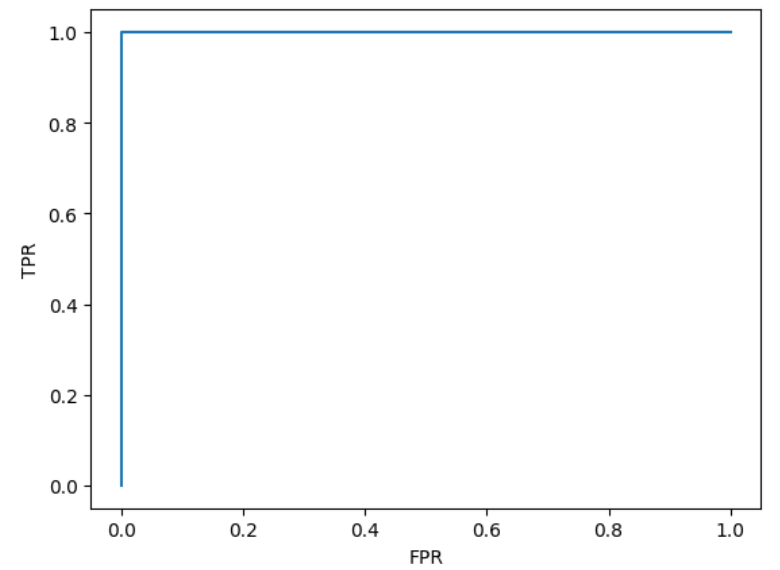
ROC曲线
输入:
-
y_test -
decision_scores
输出:
-
横轴:FPR
-
纵轴:TPR
TPR(所有真正的正样本中,被模型抓住了多少,Recall)
FPR(所有真实负样本中,被误判成正的比例)
AUC(ROC 曲线下面积)
AUC 衡量的是:随机抽一个正样本和一个负样本,模型把正样本排在前面的概率
-
AUC = 1:完美排序
-
AUC = 0.5:随机猜
-
AUC < 0.5:反着猜
ROC VS PR
| 对比 | ROC | PR |
|---|---|---|
| 纵轴 | TPR | Precision |
| 横轴 | FPR | Recall |
| 关注点 | 排序能力 | 正类质量 |
| 类别不平衡 | 一般 | 更敏感 |
数据准备
import numpy as np
import matplotlib.pyplot as plt
from sklearn import datasets

# 加载鸢尾花数据集
iris = datasets.load_iris()
x = iris.data
y = iris.target.copy()
# 转为二分类问题
y[y!=0] = 1
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression

X_train,X_test,y_train,y_test = train_test_split(x,y,random_state=666)

log_reg = LogisticRegression()
log_reg.fit(X_train,y_train)
y_predict = log_reg.predict(X_test)
混淆矩阵、Precision、Recall、F1 Score
# 手动实现
TN = np.sum((y_predict==0)&(y_test==0))
TP = np.sum((y_predict==1)&(y_test==1))
FP = np.sum((y_predict==1)&(y_test==0))
FN = np.sum((y_predict==0)&(y_test==1))

confusion_matrix = np.array([
    [TN,FP],
    [FN,TP]
])

precision = TP/(TP+FP)
recall = TP/(TP+FN)
f1_score = 2*precision*recall/(precision+recall)

# sklearn实现
from sklearn.metrics import precision_score,recall_score,f1_score,confusion_matrix
confusion_matrix(y_test,y_predict)
precision_score(y_test,y_predict)
recall_score(y_test,y_predict)
f1_score(y_test,y_predict)
PR曲线、ROC曲线、AUC
# 让逻辑回归模型给每个测试样本算一个“决策分数”
decision_scores = log_reg.decision_function(X_test)

from sklearn.metrics import precision_score,recall_score

precision_scores,recall_scores =[],[]
# 阈值列表
thresholds = np.sort(decision_scores)
for threshold in thresholds:
    y_predict = np.array(decision_scores>=threshold,dtype='int')
    precison = precision_score(y_test,y_predict)
    recall = recall_score(y_test,y_predict)
    precision_scores.append(precison)
    recall_scores.append(recall)

plt.plot(thresholds,precision_scores,color='r',label='Precision')
plt.plot(thresholds,recall_scores,color='b',label='Recall')
plt.legend()
plt.show()

plt.plot(recall_scores,precision_scores)
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.show()

# sklearn实现PR曲线
from sklearn.metrics import precision_recall_curve
# 注意:precision_scores,recall_scores比thresholds多出来一个值
precision_scores,recall_scores,thresholds = precision_recall_curve(y_test,decision_scores)
plt.plot(thresholds,precision_scores[:-1],color='r',label='Precision')
plt.plot(thresholds,recall_scores[:-1],color='b',label='Recall')
plt.legend()
plt.show()
plt.plot(recall_scores,precision_scores)
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.show()

# ROC曲线
from sklearn.metrics import roc_curve

fpr,tpr,thresholds = roc_curve(y_test,decision_scores)
plt.plot(fpr,tpr)
plt.xlabel("FPR")
plt.ylabel("TPR")
plt.show()

# AUC
from sklearn.metrics import roc_auc_score

auc = roc_auc_score(y_test,decision_scores)
auc
更多推荐

 31
 0
- 0


 已为社区贡献20条内容

所有评论(0)