
《用 STAR 法则讲大模型项目,面试官直接给 Pass 卡!》
引言
“你是不是也遇到过这种情况:简历上写满了大模型项目,但一到面试就卡壳,明明做了很多工作,却讲得干巴巴,面试官听完毫无波澜?
别再让你的技术经历‘躺在简历里睡大觉’了!大模型项目的技术细节复杂、术语密集,想让面试官快速 get 到你的亮点,光说‘我做了 DPO 对齐’‘我复现了 R1-Zero’远远不够。
今天我就用 STAR 这个面试‘万能公式’,把两个硬核大模型项目拆成完整的故事线:从‘中文对齐场景下的算力瓶颈’到‘单卡 RTX 5080 跑出 68% 胜率’,从‘无人工标注复现推理能力’到‘省 50% 显存的 GRPO 优化’。看完这篇,下次面试再讲大模型项目,你也能像讲故事一样让面试官拍案叫绝。”
一、STAR 面试法则的定义
STAR 法则是一种结构化的回答技巧,常用于行为面试(Behavioral Interview)中,帮助面试者逻辑清晰、有条理地讲述自己的经历。它由四个部分组成:
-
S (Situation) 情境:描述任务背景、你面临的问题或挑战。
-
T (Task) 任务:明确你在该情境下的目标或职责。
-
A (Action) 行动:(重点) 你具体做了什么?采取了哪些步骤?使用了什么工具或方法?
-
R (Result) 结果:最终的成果是什么?最好用量化的数据(如提升了多少百分比、节约了多少时间)来证明。
二、通过项目解析STAR法则
下图是两个关于大模型的项目:
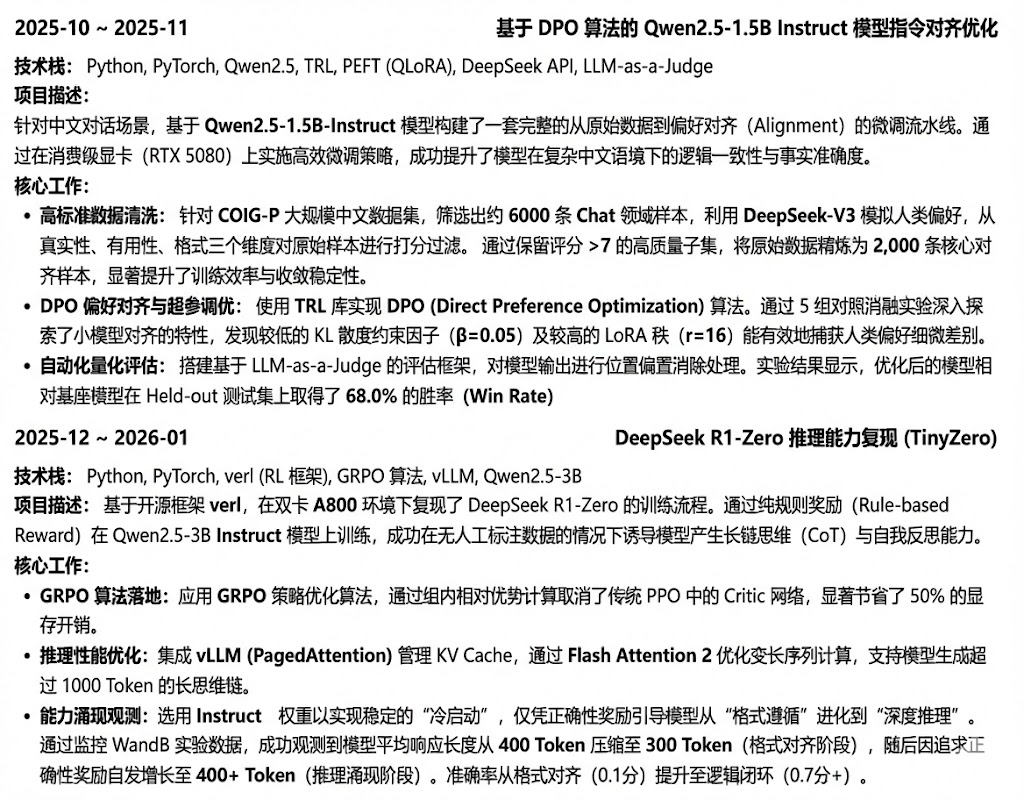
以下内容是将这两个硬核的 AI 项目拆解为标准的 STAR 表达。
三、项目一:基于 DPO 算法的 Qwen2.5 指令对齐优化
S & T (背景与目标)
针对中文对话场景,需要在资源有限的消费级显卡(RTX 5080)上,通过指令对齐(Alignment)微调,提升 Qwen2.5-1.5B 模型的逻辑一致性与事实准确度。
A (行动)
-
高标准数据清洗:从 COIG-P 数据集筛选 6000 条样本,利用 DeepSeek-V3 模拟人类偏好,从真实性、有用性、格式三维度打分,仅保留评分 >7 的 2000 条核心样本。
-
DPO 算法实现与调优:使用 TRL 库,通过 5 组消融实验探索出最佳超参数组合(
,
),有效捕捉人类偏好的细微差别。
-
自动化评估框架:搭建 LLM-as-a-Judge 评估体系,并进行位置偏置(Position Bias)消除处理,确保评估公正。
R (结果)
-
成功在单卡 RTX 5080 上完成高效微调,模型在 Held-out 测试集上的胜率(Win Rate)达到 68.0%。
四、项目二:DeepSeek R1-Zero 推理能力复现 (TinyZero)
S & T (背景与目标)
在没有人工标注数据的情况下,目标是通过强化学习复现 DeepSeek R1-Zero 的推理能力,在 Qwen2.5-3B 上诱导出长链思维(CoT)与自我反思能力。
A (行动)
-
算法架构落地:在双卡 A800 环境下,基于 verl 框架应用 GRPO 算法。通过组内相对优势计算取消了传统的 Critic 网络,节省了 50% 的显存开销。
-
性能与架构优化:集成 vLLM (PagedAttention) 与 Flash Attention 2,支持模型生成超过 1000 Token 的长思维链。
-
冷启动与训练监控:仅凭正确性奖励引导模型,通过 WandB 监控“能力涌现”过程(观察到响应长度先缩后增的典型 V 型曲线)。
R (结果)
-
成功诱导出深度推理能力,准确率从格式对齐阶段的 0.1 分提升至逻辑闭环阶段的 0.7 分以上,模型生成质量显著进化。
五、总结
💡 面试官视角的加分项建议
这两段经历技术含金量很高(尤其是 GRPO 和 DeepSeek-V3 的应用)。在实际面试中,你可以准备好回答以下细节:
-
为什么选择
-
GRPO 相比 PPO 的核心优势?(除了省显存,还有训练稳定性)
-
如何解决 LLM-as-a-Judge 的偏置问题?(你提到了位置偏置,具体是怎么做的?)
更多推荐


 8
 0
- 0


 已为社区贡献6条内容

所有评论(0)