
Transformer 大模型架构深度解析(4)详解 Transformer 架构
目录
文章目录
Transformer 架构

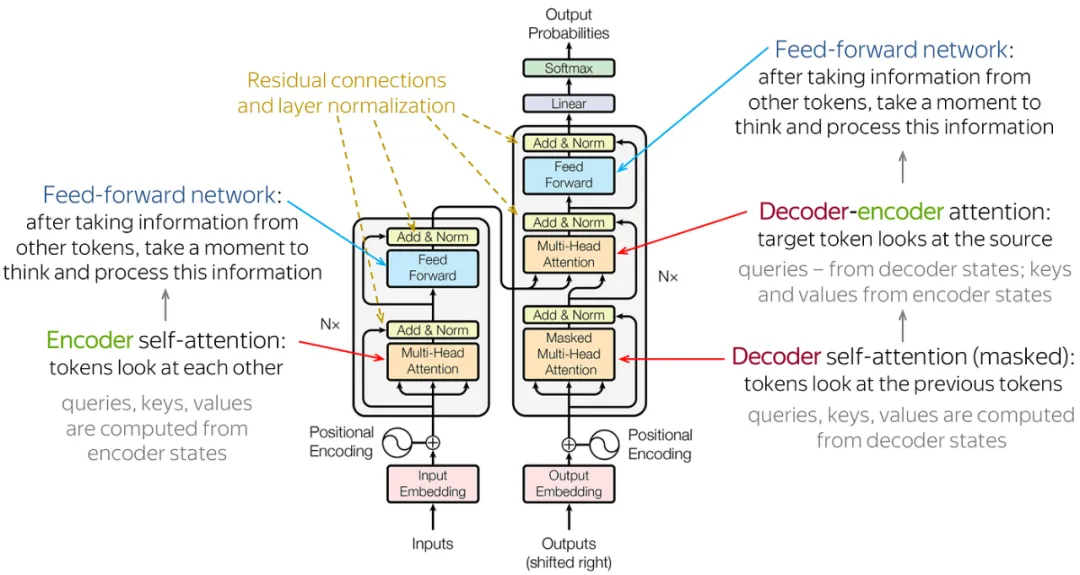
Transformer 架构的重点可以总结为 3 句话:
- Transformer 延续了 Encoder-Decoder 架构,所以它可以轻松处理长度不一致的输入序列和输出序列;
- Transformer 的 Encoder-Decoder 完全由 Attention 机制构成,所以它没有 RNN 的长距离依赖问题以及串行计算问题,可以轻松处理超长文本和使用多机多卡并行计算;
- Transformer 的 Encoder 采用了 Self-Attention 机制,Decoder 采用了 Self-Attention 和 Cross-Attention,所以它既实现了输入序列的自关联特征捕捉(Self-Attention),又实现了两个序列之间的联合对齐(Cross-Attention),是一个通用 Seq2Seq 框架,不仅仅适配 MT 任务场景。
下面我们逐一展开 Transformer 架构的细节。


Input Embedding
在 NLP 任务中,往往需要将自然语言的输入转化为机器可以处理的向量。在深度学习中,承担这个任务的组件就是 Embedding 层。Encoder 的 Inputs 是一个文本序列,首先需要进行 Embedding(词嵌入)操作,根据词汇表,将本文中的每个词转化为词向量表示。
以下是 Embedding 阶段的关键概念:
- document:训练场景中,可以将数据集文件(例如 jsonl 或 bin)中的一行/一句理解为一个 document,包含多个 word,每个 document 的长度可能不一样,有长有短。
- tokenize:token 化,根据词汇表将 document 转换为一个个 token。如下图。
- token:词汇表中定义的最小单位,可以是字、词、子词。

- token ID:词汇表中,每个 token 都有一个 ID。
- vocab_size:词汇表的大小(Vocabulary Size),往往高达数万~数十万,例如:128000 的词表大小已经覆盖主流国际语言和专业领域术语(如代码、医学词汇)。

- embedding:(动作)根据词汇表,将每个 token ID 转化为词向量。
- embedding_dim:词向量的维度(长度)。值越大表示每个 token 能编码的语义信息越丰富。

- hidden_size:数字等于 embedding_dim。但含义不同,hidden_size 描述隐藏层输入(x)的大小,和隐藏层矩阵(Self-Attention、FFN)的输入/输出维度相同。
- batch_size:一次性读取的 document 的数量(多少句话),用于同一个 Step 的训练。
- seq_len:表示 document 的合法输入长度,进行向量化之前模型会对输入的文本进行裁剪,将段落等裁剪成短文本。以此来约束输入的长度。

在 Input Embedding 阶段,会执行以下关键步骤:
- 对输入的文本进行裁剪:将长文本裁剪成长度为 seq_len 的短文本。
- 对文本进行分词(tokenize):采用 BPE 等 tokenizer(分词器)将连续的文本转换成一个个 token。包括:
- 规范化(Normalization):对文本进行必要的清理工作,例如清理特殊符号、格式转换、过滤停用词、Unicode 标准化等。
- 预分词(Pre-tokenization):将输入拆分为 token。
- 后处理(Post-processing):添加分词器的特殊 token、生成注意力掩码等等。
- Token Index 索引化:构建形状为 [batch_size, seq_len] 的矩阵,将每个 “格子” 中的 token 转换为一个 token ID(计算机更容易处理)。
- Word Embedding:输入矩阵 [batch_size, seq_len] 经过 Embedding 权重矩阵 [vocab_size, hidden_size]。然后通过 token ID 的匹配,最终得到 Input Tensor,形状为 [batch_size, seq_len, hidden_size](PyTorch、TensorFlow、HuggingFace 等框架中的主流),再进入到后续的 Tensor(张量计算)的环节。
- head_size:多头注意力的头数,在 MHA 中每个 head 计算的 d_k 等于 hidden_size / head_size。

- sample:训练场景中,表示一个数据样本。在采样过程中,每条 document 的长短各不相同,为了按照 seq_len 大小来取出出相同大小的 sample,可以将各个 document 拼在一起,形成一条很长的 token 序列,然后按照 seq_len 截取得到长度一致的 sample。这样可以避免数据空间浪费。
Positional Encoding
序列模型处理序列数据的前提是 “位置”,在 RNN 中,输入序列会沿着语句本身的顺序被依次递归处理,因此输入序列的顺序提供了极其重要的信息,这也和自然语言的本身特性非常吻合。但正如前文提到过,Transformer 没有 RNN 结构,Self-Attention 又本身不感知词的时序顺序,所以需要结合 Positional Encoding(位置编码)来提供时序能力,即:捕捉序列中词汇的位置信息,使得模型能够理解单词之间的相对顺序。
Positional Encoding 可以根据序列中 token 的相对位置对其进行编码,再将位置编码加入到词向量编码中。具体而言,Positional Encoding 会为 Input Tensor [batch_size, seq_len, hidden_size] 中不同位置的 token 分配一个唯一的位置向量,并将这个位置向量与词向量相加,使得词向量的特征既包含语义信息,又包含了位置信息。
位置编码的方式有很多:
- 绝对位置编码:思路是为序列中每个位置生成一个唯一的编码,代表该位置在整个序列中的固定 “绝对” 位置。
- 相对位置编码:没有计算每个位置的编码,而是在算 Attention 的时候考虑当前位置与被 Attention 的位置的相对距离,由于自然语言一般更依赖于相对位置,所以相对位置编码通常也有着优秀的表现。
- 旋转位置编码(RoPE):是目前 LLM 的主流编码。
绝对位置编码
Transformer 采用的是正余弦函数(sin/cos)绝对位置编码,公式如下:

pos 为 token 在句子中的位置,2i 和 2i+1 则指示了词向量 index 是奇数位置还是偶数位置,从上式中可以看出对于奇数 index 和偶数 index 的元素,Transformer 采用了不同的函数(sin/cos)进行编码。如下图所示,用 X_d*n 表示,d 为 token 数量,n 为词向量的维度。
得到位置编码矩阵之后,再和输入矩阵进行相加,就最终得到了包含位置信息的 Input Tensor 了。

旋转位置编码(RoPE)
RoPE 的目标是让 Transformer 模型在计算 Query 和 Key 的内积时,自然地包含相对位置信息,而无需引入额外的相对位置偏置。它通过对 Query 和 Key 向量进行位置相关的旋转操作,使得不同位置的向量在进行点积时,其结果能够反映出 token 之间的相对距离。通过三角函数计算位置信息,支持任意长度的上下文窗口,优于传统固定长度的位置编码。θ=500,000 是控制位置编码周期的超参数,值越大,模型对 “长距离位置差异” 的区分能力越强(适合超长文本处理)。

Encoder
点积(Dot Product)计算词向量相似度
从数学的角度有多种不同的度量方法可以用来衡量两个(词)向量之间的距离(相似度):
- 基于距离的方法:欧几里得距离、曼哈顿距离、切比雪夫距离等。
- 基于方向的方法:余弦相似度。
- 考虑距离和方向的混合:点积法。点积(Dot Product)运算表征一个向量在另一个向量上的投影。投影值越大,说明两个向量的相关性越高,如果两个向量的夹角为 90 度,则这两个向量线性无关,完全没有相关性。

所以,向量点积法(Dot-Product)来衡量 2 个词向量之间的相似性,根据词向量的定义,语义相似的两个词对应的词向量的点积应该大于 0,而语义不相似的词向量点积应该小于 0。如下为 2 个向量的点积计算公式。
基于效率和建模能力的考虑,Transformer 选择了点积的方式来计算词向量之间的相似度。

Scaled Dot-Product Attention
Scaled Dot-Product Attention(缩放点积注意力)则是 Attention 的具体算法,其数学公式如下图所示。

假设 1 条序列的长度都为 seq_len、词向量的维度为 d_k,那么经过 Input Embedding 之后 Q、K、V 矩阵的形状如下:
- Q:[1, seq_len, d_k]
- K:[1, seq_len, d_k]
- V:[1, seq_len, d_k]
它们之间的 Attention 计算的步骤入如下:
-
求 Q 和 K 的语义相似度: Q 矩阵和 K 矩阵的转置相乘(并行向量点积计算),结果得到 “相似度矩阵 X”,形状为 [seq_len, seq_len],其中元素 X_ij 表示 Q 中第 i 个词和 K 中第 j 个词的相似程度。值越大,关联度越高。

-
缩放,防止梯度消失:还需要注意的是,在上一个公式中,如果 Q 和 K 对应的 d_k 维度比较大,那么 QK^T 的数值会被拉得很大。因为向量点积结果与 d_k 维度成正比(d_k = hidden_size / head_size),维度越大,乘积累加的数值就越大(+)或越小(-)。这会导致下一步的 softmax 归一化后的权重值会极端化,例如:少数正相关接近 1,大部分负相关接近 0。此时 softmax 的梯度会趋近于 0(梯度消失),导致模型训练无法收敛低 Loss。因此,我们还需要对 Q 和 K 乘积的结果做一次缩放,Q、K 点积后再除以根号 d_k,使得 softmax 结果的方差稳定在 1 附近,避免数值极端化,保证 Softmax 有正常的梯度。这样也就得到了最终的 Attention 计算公式。

-
将相似度得分转化为注意力权重:相似度矩阵 X 再通过 Softmax 得到注意力权重矩阵 A,形状为 [1, seq_len, seq_len],其中元素 A_ij 表示 Q 中第 i 个词和 K 中第 j 个词的注意力权重,取值范围在 0~1 之间。且对于 Q 中第 i 个词而言,每一行的权重和为 1,相似度越高,占比权重也越大。

-
加权融合计算 Attention 输出:注意力权重矩阵 A 和 V 矩阵相乘,得到最终 Attention 输出矩阵 O,形状为 [1, seq_len, d_k],其中向量 O_i 表示 Q 中第 i 个词 “加权融合” 了全序列所有上下文的动态特征,是 Query 检索中获取匹配到的 Key 的实际 Value 信息。

根据上述过程,就得到了完整的注意力计算公式了,下面再给出具体的代码实现:

def attention(query, key, value, dropout=None):
    '''
      query : 查询矩阵
        key : 匹配键矩阵
      value : 真值矩阵
    '''

    # d_k = hidden_size / head_size
    d_k = query.size(-1)

    # key.transpose(-2, -1) 将 K 进行转置
    # torch.matmul(query, key.transpose(-2, -1)) 求 Q、K 的点积
    # math.sqrt(d_k) 根号 d_k
    # scores 是 Q、K 的点积除以根号 d_k 的结果
    scores = torch.matmul(query, key.transpose(-2, -1)) / math.sqrt(d_k)

    # Softmax 归一化
    p_attn = scores.softmax(dim=-1)

    # 采样
    if dropout is not None:
        p_attn = dropout(p_attn)

    # 加权融合,得到最终的语义单元
    return torch.matmul(p_attn, value), p_attn
Self-Attention
Self-Attention 是 Transformer Encoder 的核心,负责处理 Input Sequence(输入序列),目的是要理解序列中每个词的时序和语义。所谓 “语义” 就是找对词与词之间的上下文关系,并通过权重值来表示关系的深浅。下面以句子 “我吃了苹果,它很甜” 为例。
- 找关系 Q·K:Self-Attention 并行扫描每个词和其他词之间的关系,比如 “苹果” 和 “它” 语义最相关,和 “甜” 次之,和 “很” 几乎没有关系。这些 “关系” 的远近是由词汇表中的高维词向量空间模型距离计算公式得到的。
- 加权重 softmax(Q·K):为每个词和其他词之间的关系远近分配一个 “注意力权重”,比如 “苹果” 和 “它” 语义最相关,权重值最大(比如 0.8),和 “很” 几乎没关系,权重值最小(比如 0.00001)。注意力权重是软注意力的特性之一。
- 融信息 softmax(Q·K)·V:把每个词和其他词的信息进行 “加权融合”,比如把 “苹果” 的原始信息和 “它” 的信息进行融合(其他词权重太低,几乎不融信息),最终得到一个 “语义单元”。
如此的,Self-Attention 令每句话中的每个词都成为了带着全句上下文信息的语义单元。后续,将这些 “语义单元” 传递到 Decoder 之后,Decoder 就可以根据每个 “语义单元” 进行对齐翻译输出序列了。例如:句子 The animal didn’t cross the street because it was tired,其中 it 和 animal 的关联必然最大,其权重也最大,it 的语音单元必然包含 animal 的信息,如此的 Decoder 就知道了代词 it 指代的是名称 animal 而不是其他词,翻译为 “动物”。
并且,因为 Self-Attention 处理的 Input Tensor 中已经包含了 Positional Encoding,不再依赖 RNN,所以 Self-Attention 没有 RNN 的缺陷:
- 不依赖定长向量 C 来传递上下文语义,所以不管序列有多长,Self-Attention 都能建立序列中所有词相互之间的关系。
- 由于 Self-Attention 计算序列中每一个词的过程都是相互独立的,所以可以应用多机多卡的并行计算。

具体而言,经过 Embedding 和 Positional Encoding 之后的 Input Tensor 进入 Encoder 时,首先会和 W_k、W_q、W_v 权重矩阵(训练的静态产出)进行点积计算,得到用于 Self-Attention 计算的 Q、K、V。

- Input Tensor 形如 [batch_size, seq_len, d_k],其中 batch_size=1(一句话),d_k=hidden_size/head_size(词向量维度除以多头注意力的头数)。
- 这句话的 Q 就是一个形如 [seq_len, d_k] 的矩阵,每行表示一个 q 词向量。
- 这句话的 K 也是一个形如 [seq_len, d_k] 的矩阵,每行表示一个 k 键向量。
- 这句话的 V 还是一个形如 [seq_len, d_k] 的矩阵,每行表示一个 v 值向量。

通过 Self-Attention 计算之后,最终输出矩阵 O(Hidden States),作为动态的隐藏层计算结果。计算公式如下:

O_i 表示第 i 个词的输出 = Q 中第 i 个词对 K 中所有词的自注意力权重向量(A_ij,j=1~seq_len) 乘以 V 中所有词的值向量(V_j,j=1~seq_len),然后再求和。例如:Q_它 = 0.9×V_苹果 + 0.05×V_我 + 0.05×V_甜,让 “它” 的隐藏特征里 90% 都是 “苹果” 的语义,这样 Encoder 就知道 “它” 指代 “苹果” 了。
可见,在 Self-Attention A_ij 中可以找到一段文本中每一个词与其他所有词的相关度大小,所以 O_i 蕴含着该元素与序列中所有元素之间的关系,即:把上下文的信息融入当前元素之中,借助 “上下文” 来理解这个元素,从而捕捉序列内部的依赖关系。所以被称之为 “加权融合” 计算。
值得一提是的 Self-Attention 的并行计算特性(多个词向量一起计算),如下图并行化处理序列数据,避免了诸如 RNN 的串行时序依赖(一个一个词向量计算)。

Multi-Head Attention
Self-Attention 存在一个局限性 —— 单头一次只能拟合一种相关关系,即:单头只有一套 Q/K,只能算出一种相似度(每个词只得到一组注意力权重)。所以,单头只能捕捉 “语法层面” 的关联,或者只能捕捉 “指代层面” 的关联,但却无法一次拟合序列中可能存在的多种相关关系。(简而言之,一套 Q/K = 一种相似度标准 = 一种相关关系)
因此,Transformer 中使用的其实是 Multi-Head Attention(MHA,多头自注意力),h 个 Attention Head(注意力头)的含义是拥有 h 套独立的 Q/K/V,输出 h 个注意力权重结果。以此来拟合不同的相关关系,例如:
- 有的 Head 关注语法依赖:比如 I love China 中,love 与 I(主语)、China(宾语)的语法关联;
- 有的 Head 关注语义指代:比如前面的 it 与 animal 的指代关联;
- 有的 Head 关注词序 / 标点:比如逗号、连词前后的词关联。
在 Transformer 论文中,作者也通过实验证实了 MHA 每个不同的 Head 能够拟合语句中的不同信息。如下图所示,单头自注意力(红色)和多头自注意力(绿色)相比较,显然后者更加关注 “全局信息”。

MHA 让模型能同时捕捉序列的多维度特征,比单头自注意力的特征表达能力强得多。
目前主流 LLM 的多头数量通常为 12/16/32 或更多(如 GPT-3 是 96 头),在模型的 config.json 里通过 num_attention_heads(Q 的头数)和 num_key_value_heads(GQA/MQA 里 K/V 的头数)记录。头数在训练时就固定死了,推理框架不能修改,因为 head_num 直接决定了权重矩阵的形状和 Q/K/V 的切分方式。

具体而言,MHA 的处理流程如下,假设采用 h 个 Attention Head:
-
通过 3 个 Linear 线性变换层进行投影计算,把 Input 投影成 Q/K/V,并顺带拆分为 h 组独立的 Sub-Q/K/V,且每个头的维度 d_k = hidden_size / head_num。
-
h 组 Sub-Q/K/V 分别做独立的 Self-Attention 计算,得到 h 个独立的自注意力权重和 Hidden Status 特征输出;
-
将 h 组的特征输出通过 Concat 拼接起来。Concat 就是把 h 个头的输出向量,沿特征维度首尾接起来。它是纯粹的内存拼接,没有任何计算。
-
最后再通过一个 Linear(多头信息融合 + 维度还原)做融合,得到最终的多头注意力特征输出。这个 Linear 可以学习如何最好地组合来自不同 Head 的信息。
MHA 中有 2 处 Linear(线性层),作用不同:
- 输入端投影,3 个 Linear(W_Q/K/V):把 Input 投影成 Q/K/V,并顺带切成多头。
- 输出端混合特征,1 个 Linear(W_O):在多头 Concat 之后,把拼起来的向量融合,变回 hidden_size。作用是怎么把 8 个头的结果最好地组合起来。
注:投影,也称为线性变换(区别于非线性函数计算)。使用一个矩阵(W)乘一个向量(x 词向量),把 x 从一个空间线性映射到另一个空间,线性变换计算公式为 y = x·Wᵀ + b,所以称之为 Linear 层。投影计算的目的是改变矩阵的形状或拆分矩阵,例如:通过 W 的列数,可以转换 x 的列数。


Feed Forward Neural Network(前馈神经网络)
Transformer 由 2 大组件构成,MHA 和 FNN,它们之间是互补的关系。
- MHA:关注全局 token 之间的关联关系。
- FFN:关注单一个 token 的特征精修。
如果将 Transformer 比喻成拼图,MHA 就是要找到许多快拼图之间的关系进行拼接,而 FFN 则是对单一块拼图进行 “放大、修图、加细节”,让图片变得更清晰、更丰富,让人们可以理解拼接起来之后的图画的实际含义。
非线性函数与万能近似定理
深度学习的强大不仅仅因为层数多,而是因为 “多层线性变换 + 非线性激活” 的组合。如果没有 “非线性函数”,无论叠加多少层全连接层,本质上都可以被简化成一层计算,多层没有意义。
- 线性函数:y = Wx + b,本质是 “加权求和”,无论输入 x 是什么,都用同一套 W、b 系数去乘和加。它只会按比例缩放和上下移动,画出来永远是直线或平面,没有拐弯。所以线性函数无法拟合和表达 y=x²、sin(x) 这种拐弯的函数。
- 非线性函数:ReLU(x) 等激活函数,支持分情况、有条件地处理拐弯。

1989 年,乔治·西本科提出万能近似定理(Universal Approximation Theorem),从理论证明了,一个包含足够多隐含层神经元的、具有非线性变换激活函数的 FFN 能以任意精度逼近任意复杂度的函数。简而言之,理论上 FFN 可以解决世界上任何问题,其表达力与图灵机等价。万能近似定理,从根本上消除了对神经网络表达力的质疑。
FFN 三层计算过程
语言的语义是高度 “非线性” 的,例如一词多义:“苹果” 在 “吃苹果” 里是水果、在 “苹果手机” 里是品牌,同一个输入 “苹果” 要映射到不同含义。相对的,线性计算是固定输入固定输出的,无法 “根据上下文来选择语义”。所以,语言的语义理解必须靠非线性函数。具体而言,MHA 是针对 “关联关系” 的非线性计算(softmax),而 Transformer 还需要引入 FNN 对每个 token 词向量进行非线性计算,使得 Transformer 能建模现实世界的复杂规律。
如下图所示,Transformer 中的 FFN 由下列 3 个层及其 2 个权重矩阵 W1、W2 组成。其中 W1、W2 矩阵用于收敛非线性特征。

1. 升维线性变换层(Linear)
假设,MHA 输入到 FFN 的 Input Tensor 形状为 [batch_size, seq_len, hidden_size]、Linear 的升维系数 d_ffn 为 4(Transformer 论文的经验值),那么 W1 权重矩阵形状为 [hidden_size , 4 * hidden_size],用于将每个 token 的 hidden_size 特征维度(词向量维度)进行升维,输出 Tensor 形状为 [batch_size, seq_len, 4 * hidden_size]。
注:d_ffn(FFN Dimension)是 FFN 中间层的维度,训练时固定了 W1、W2 的形状,推理时无法修改,表示为 config.json 中的 intermediate_size。训练时把 d_ffn 设大,那 FFN 表达能力更强但也更耗参数/算力,设小则相反。d_ffn 通常是 hidden_size 的 2~4 倍。FFN 负责对 Self-Attention 输出的 “上下文向量” 进行非线性变换,维度越大,表示模型的非线性表达能力越强。
注:hidden_size 和 d_model 是同一个量的两个名字,都是指模型里 token 词向量维度。前者是代码变量名,后者是论文数学记号名。
2. 非线性变换激活函数层(ReLU)
升维后,每个 token 词向量被映射到更高的维度,拥有了更强的特征表达能力。并且,在高维空间可以做到更精细的非线性特征变换,让更加不可分的细微的特征结构也能暴露在激活函数面前。最理想的情况当然是在无限维空间去展开所有的特征,在无限维空间中,任何复杂的非线性关系都可以被完美地展开、整理和分离。

FFN 采用 ReLU 激活函数,对 token 词向量中的每个元素都会经过 ReLU 的非线性变换,输入、输出 Tensor 形状均为 [batch_size, seq_len, 4 * hidden_size]。
在高维空间中进行非线性计算,使得 token 词向量特征之间的关系可以被更充分地展开和重组,例如:ReLU 函数会将一部分元素置 0,相当于做了一次筛选,去掉不相关的信息。

ReLU 是 2017 年深度学习领域最主流的激活函数,在效果、效率、工程实现上达到了最优平衡。后续 BERT、GPT 等 Transformer 变体将 ReLU 替换为 GELU,它针对 NLP 任务的效果进行了优化。
ReLU 的数学公式如下,本质就是 “负数置 0”,极其简单的计算使得其具有 3 个关键优势:
- 低损耗:仅做了一次 “比较 + 取值”,没有任何复杂的指数、对数、三角函数计算,GPU 硬件可极致优化,计算耗时几乎可以忽略。相较于 sigmoid、tanh 等需要 e^z 指数运算,它们的计算量是 ReLU 的数倍,且指数运算易产生数值精度问题,如浮点数下溢 / 上溢。
- 适用高维场景:高维特征下,ReLU 的低计算量优势会被放大,若用 sigmoid、tanh,高维逐元素的指数运算会让 FFN 计算效率大幅下降。
- 缓解梯度消失:ReLU 相比 sigmoid、tanh,从激活函数层面大幅缓解了梯度消失问题,配合 Transformer 的残差连接 + 层归一化,让深层 Transformer 可以稳定训练。


3. 降维线性变化层(Linear)
经过 ReLU 的筛选,需要再次通过一个降维 Linear 回到原来的维度,因为需要 Transformer 的残差连接要求输入输出的维度必须一致。
W2 权重矩阵形状为 [4 * hidden_size , hidden_size],计算后的 Tensor 形状还原为 [batch_size, seq_len, hidden_size]。每个 token 的 hidden_size 特征维度进行降维,相当于把之前过滤的重要特征组合进行了浓缩。
计算例子,设 Input Tensor 为 [3, 4, 8],那么:
- W1 升维运算 [3, 4, 8] * [8, 8 * 4] = [3, 4, 8 * 4]
- W2 降维运算 [3, 4, 8 * 4] * [8 * 4, 8] = [3, 4, 8]

经过升维、非线性计算、降维之后,token 词向量的特征空间的局部表达能力就得到了很大的提升。最后,还可选的加入了一个 Dropout 层来防止过拟合。
代码示例
class MLP(nn.Module):
    '''前馈神经网络'''
    def __init__(self, dim: int, hidden_dim: int, dropout: float):
        super().__init__()
        # 定义第一层线性变换,从输入维度到隐藏维度
        self.w1 = nn.Linear(dim, hidden_dim, bias=False)
        # 定义第二层线性变换,从隐藏维度到输入维度
        self.w2 = nn.Linear(hidden_dim, dim, bias=False)
        # 定义 dropout 层,用于防止过拟合
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):
        # 前向传播函数
        # 首先,输入 x 通过第一层线性变换和 RELU 激活函数
        # 最后,通过第二层线性变换和 dropout 层
        return self.dropout(self.w2(F.relu(self.w1(x))))
Residual Connection(残差连接)
由于 Transformer 模型结构较复杂、Layer 层数较深,为了避免模型退化,Transformer 采用了 Residual Connection(残差连接)的思想来连接每一个 Layer —— 下一层的输入不仅是上一层的输出,还包括上一层的输入。每个 Layer 的输出与输入相加,形成残差连接,这有助于解决深层网络中的梯度消失问题。

例如,在 Encoder 的第一个子层 MHA 中,残差连接层即接受 MHA 的输出,还接受 MHA 的原输入,然后将 MHA 的输出和原输入相加(Add),再进行标准化。所以在 Transformer 架构中使用 “Add 和 2 条连线” 表示残差连接。

Layer Normalization(层归一化)
层归一化核心是为了让不同层输入的取值范围或者分布能够比较一致。由于深度神经网络中每一层的输入都是上一层的输出,因此多层传递下,对网络中较高的层,之前的所有神经层的参数变化会导致其输入的分布发生较大的改变。也就是说,随着神经网络参数的更新,各层的输出分布是不相同的,且差异会随着网络深度的增大而增大。但是,需要预测的条件分布始终是相同的,从而也就造成了预测的误差。
因此,在深度神经网络中,往往需要归一化操作,将每一层的输入都归一化成标准正态分布。神经网络主流的归一化一般有两种:
- 批归一化(Batch Norm)
- 层归一化(Layer Norm)
Transformer 架构采用的是效果更好的 Layer Norm,相较于 Batch Norm 在每一层统计所有样本的均值和方差,Layer Norm 在每个样本上计算其所有层的均值和方差,从而使每个样本的分布达到稳定。
Transformer 在每个 Layer(Self-Attention、FFN)之后,都会进行层归一化操作,这有助于模型的训练稳定性。
class LayerNorm(nn.Module):
    ''' Layer Norm 层'''
    def __init__(self, features, eps=1e-6):
        super().__init__()
        # 线性矩阵做映射
        self.a_2 = nn.Parameter(torch.ones(features))
        self.b_2 = nn.Parameter(torch.zeros(features))
        self.eps = eps

    def forward(self, x):
        # 在统计每个样本所有维度的值,求均值和方差
        mean = x.mean(-1, keepdim=True) # mean: [bsz, max_len, 1]
        std = x.std(-1, keepdim=True) # std: [bsz, max_len, 1]
        # 注意这里也在最后一个维度发生了广播
        return self.a_2 * (x - mean) / (std + self.eps) + self.b_2
Decoder
自回归生成模型
Decoder 采用自回归(Autoregressive)的方式逐一生成任意长度输出序列的元素,每一步的生成结果,都送给下一步作为输入,如下图所示。
- Encoder 接收一个中文句子的输入。
- Encoder 将一个中文句子的 token 编码为 Hidden States(K/V 值)输出给 Decoder 的 Cross-Attention 作为 “翻译对齐” 使用。
- Decoder 接收第一个标识符
<Begin>,进入 MMHA 模块,进行 Self-Attention(自注意力)计算,输出 Output Sequence 作为 Q。 - Decoder 将 Q 输入到 MHA 模块,进行 Cross-Attention(交叉注意力)计算,Decoder 的 Q 和 Encoder 的 K/V 进行对齐。
- Decoder 输出一个概率分布(Output Probabilities),表示模型所采用的词汇表中每个 token 作为下一个输出的概率,并依据某种策略输出一个最可能的单词。假设生成第一个单词为 I。
- Decoder 进入自回归,把生成的第一个单词 “I” 作为 Decoder 的输入(Outputs),再次进入 Decoder 解码生成出第二个单词 ate。
- Decoder 重复上述步骤,直到遇见停止符
<End>。


Multi-Head Attention(Cross-Attention)
Decoder 作为序列的生成器,继承了 Bahdanau Attention 的 “源-目标词语义对齐” 思想。使得 Decoder 生成每个目标词时,都可以精准对齐源语言的相关词。
- MHA 使用 Encoder 的输出作为 Key 和 Value,接受源语言特征。
- MHA 使用 MMHA 的输出作为 Query,接受目标语言特征。

Masked Multi-Head Attention(Self-Attention)
Transformer 采用的是 CLM 预训练任务,即:根据上文生成下一个词,所以为了防止模型作弊(文本当前位置看到后文的信息),需要引入 Masked 掩码运算 —— Decoder 使用 Masked Multi-Head Attention(MMHA,掩码多头自注意力)。
MMHA 很符合语言生成的时序性(只能从左到右生成,不能提前看到后面的词),对目标语言序列的自注意力做掩码处理,屏蔽当前词之后的所有词,让模型只能基于前面的词生成下一个词。例如:待学习的文本序列是 the cake was sour,进行 Masked 处理之后,在每一行输入中,Decoder 仍然是只看到前面的词,并预测下一个词。

掩码(Mask)的作用是遮蔽一些特定位置的词。具体而言,掩码会被应用到 Q·K 点积后的结果上,将右上角位置的值设置为一个非常大的负数(如负无穷),这样在做 softmax 计算时,这些位置的权重会接近于零,从而忽略对某些位置的学习。


观察上述的例子,可以发现 Masked Attention 其实就是一个和 Input Sequence 等长的上三角矩阵。可以通过创建一个与输入序列等长的上三角矩阵作为注意力掩码,再使用掩码来遮蔽掉输入序列的矩阵即可。也就是说,当 Input Tensor 维度为 [batch_size, seq_len, hidden_size] 时,Mask 矩阵的维度一般为 [1, seq_len, seq_len]。
输出概率分布
最终输出 token 之前还需要进行一次输出概率分布计算,从模型采用的词汇表中选出最终真正输出的 token。
步骤如下:
- 线性层(Linear):将 Output 的每个 token 词向量乘以词汇表矩阵,得到一个长度为词汇表大小的概率分布向量。表示每一个 token 作为真正输出的概率大小。例如:[1, embed_size] * [embed_size,vocab_size ] => [1, vocab_size]。
- Softmax:将概率分布向量进行归一化计算,得到最终的 % 概率值(Output Probabilities)。
Layer
Transformer 由 Encoder 和 Decoder 组成,而 Encoder 和 Decoder 都会由多个相同的 Layer 堆叠而成。层数越多,模型能学习到的逻辑推理链越长,例如:复杂数学题、多步骤任务等,在深度推理上更强,但也更难训练(易过拟合、梯度消失)。
如下图,Input Tensor 进入 Encoder 进行编码,到 Encoder Layer 的最顶层再将编码结果 Hidden States(K、V)同时输出给 Decoder Layer 的每一层,通过 Decoder 解码后就可以得到 Output Probabilities。

Transformer 的 Nx Layer 堆叠结构,使得每层 MHA 计算得到的中间状态还可以在下一层继续做 MHA,这样一层层做下去。每前进一层,实质都是在更大的范围内交融序列中的各个 token、解析其间的关系,这样的结构使得 Transformer 能够捕获多种不同的相关关系。最终就能够得到表示着整个序列的总体特征的向量了。
多层注意力的运算效果:随着 layer 层数叠加,可以看到注意力运算愈发集中都某几个词:
- 黄色表示注意力得分高,相似度高。
- 这是一个 Mask 的注意力得分,因此上三角为得分为 0。
- 一个词对自己的关注度是最高的,因此注意力得分的黄色集中在对角线上。
- 一个词和周围上下文的关注度也很大,因此多层运算中会慢慢出现 Localized Attention(本地化)的三角格式。
- 经过多层的 Attention 运算之后,注意力得分集中在相似度最高的词之间。

计算矩阵形状小结
假设 batch_size = 1 时。

Transformer 模型结构的变体

Encoder-Decoder 和 Decoder-only 的区别
最初的 Encoder-Decoder 结构是设计前提是 “处理两条不同的序列:一条输入、一条输出(翻译场景)”。但随后人们发现一个事实:几乎所有 NLP 应用场景都可以采用 “接着往下写” 的语言生成模型,即:将输入(prompt)和输出(续写)作为同一条序列(拼成同一条流)。例如:
- 翻译场景:中译英 “我爱中国” => 续写 “I love China”;
- 摘要场景:总结这段话 “<长文>” => 续写 “<摘要>”;
- 问答场景:问 “珠峰多高?” => 续写 “8848米”;
因此,实际上 Decoder-only 都可以满足上述 NLP 应用场景的需求。好处:
- 结构极简:Encoder-Decoder 有两套 Stack 多种注意力类型;而 Decoder-only 只有一套 Stack、一种注意力(Masked Self-Attention)、一个训练目标(CLM 预测下一个词)。
- 数据集直接有效:Encoder-Decoder 是 “双向” 的,训练数据集要求配对;而 Decoder-only 是 “CLM(因果)” 的,所以整个互联网的无标注文本都可以直接拿来训练。
- 少样本学习(few-shot)自然涌现:因为是 “续写同一条流”,所以可以把少量示例直接塞进 prompt 里,模型把 “问题+示例+答案” 当成一条连续的流接着写。GPT-3 的上下文学习能力就是这么自然长出来的。而 Encoder-Decoder 无法做到。
- 生成 K/V Cache 干净利落:decoder-only 的自回归生成 + KV Cache 复用非常合理。

Decoder-only 和 Encoder-only 的区别
两者的核心区别在注意力层上,Decoder-only 采用 MMHA,Encoder-only 采用 MHA,这一个差别决定了 Decoder-only 擅长 “生成”,Encoder-only 擅长 “理解”。
Encoder-only(BERT):
- 文本分类、情感分析,例如:这条评论是正面还是负面?
- 命名实体识别、抽取式问答(从原文里划答案)
- 句向量 / 语义检索(把整句压成一个向量,算相似度),RAG 里的 embedding 模型很多是这类
Decoder-only(GPT):
- 什么都能干(续写):对话、续写、补全、翻译、摘要…
- few-shot / 上下文学习

GPT-2 Decoder-Only 模型架构
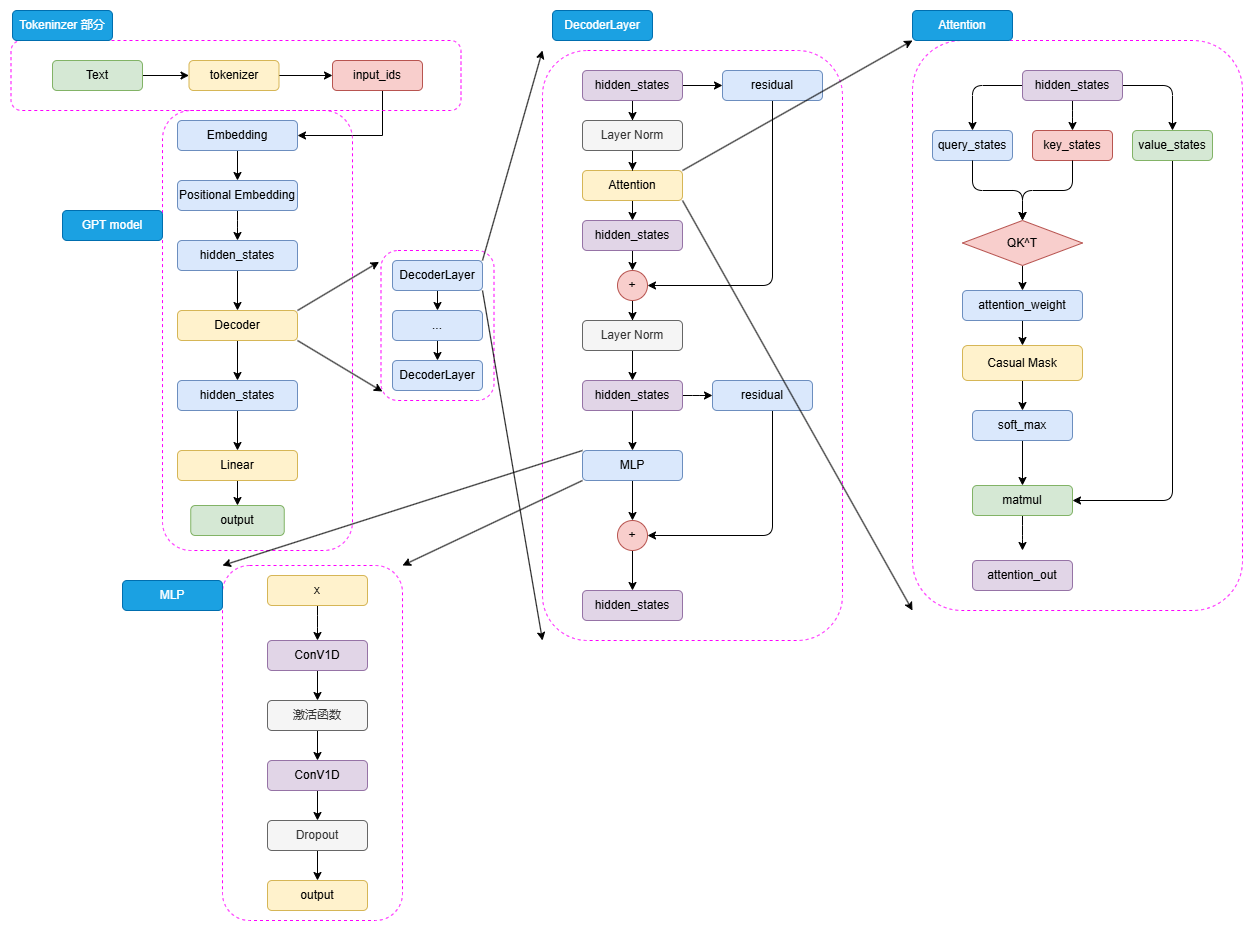
如上图,GPT-2 的模型结构和 GPT-1 大致相同,主要是扩大了模型参数规模、同时将 Post-Norm 改为了 Pre-Norm,即:先进行 LayerNorm 计算,再进入注意力层计算。这些改动的核心原因是由于模型层数增加、体量增大,梯度消失和爆炸的风险也不断增加,为了使模型梯度更稳定对上述结构进行了优化。
模型的运行步骤如下:
- 对于一个自然语言文本的输入,先通过 tokenizer 进行分词并转化为对应词典序号的 input_ids。
- 输入的 input_ids 首先通过 Embedding 层,再经过 Positional Embedding 进行位置编码。沿用了 Transformer 的经典 Sinusoidal 位置编码,即通过三角函数进行绝对位置编码。
- 通过 Embedding 层和 Positional Embedding 层编码成 hidden_states 之后,就可以进入到 Decoder。
- 由于不再有 Encoder 的编码输入,Decoder 仅保留了一个 Masked MHA(Self-Attention),并且将 LayerNorm 放到了 MMHA 之前。所以 hidden_states 会先进行 LayerNorm,再进行掩码注意力计算,然后经过残差连接和再一次 LayerNorm 进入到 MLP。
- MLP 层没有选择线性矩阵来进行特征提取,而是选择了两个一维卷积核来提取,不过,从效果上说这两者是没有太大区别的。
- 通过 N 个 Decoder 层后的 hidden_states 最后经过线性矩阵映射到词表维度,就可以转化成自然语言的 token,从而生成我们的目标序列。
主流 Decoder-only 模型

参考文档
https://medium.com/@vmirly/tutorial-on-scaled-dot-product-attention-with-pytorch-implementation-from-scratch-66ed898bf817
https://poloclub.github.io/transformer-explainer/
更多推荐

 20
 0
- 0


 已为社区贡献4条内容

所有评论(0)