
计算机基础·cs336-现代Transformer架构和实现
现代Transformer架构
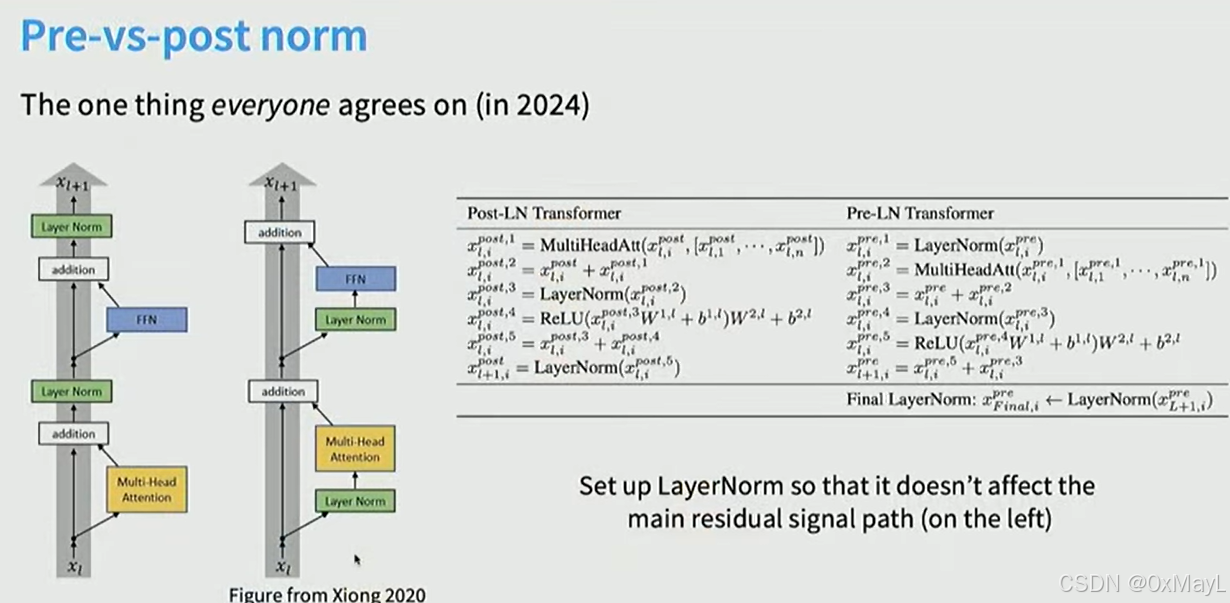
PreNorm vs PostNorm
- 在计算残差前就进行归一化 vs 在残差后进行归一化
- 大部分LLM都采用计算前归一化
- 个人理解:计算残差前归一化可以确保残差部分的数值稳定,进而与原始值相加时数值也能保持稳定。
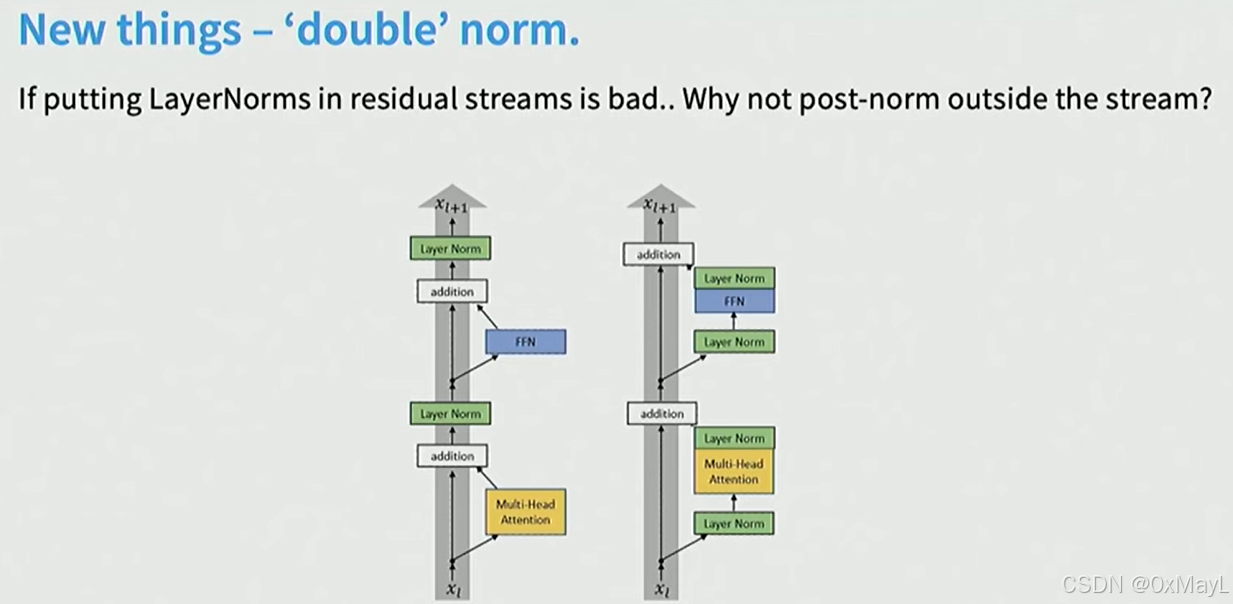
doubleNorm
- 残差前后都进行归一化处理
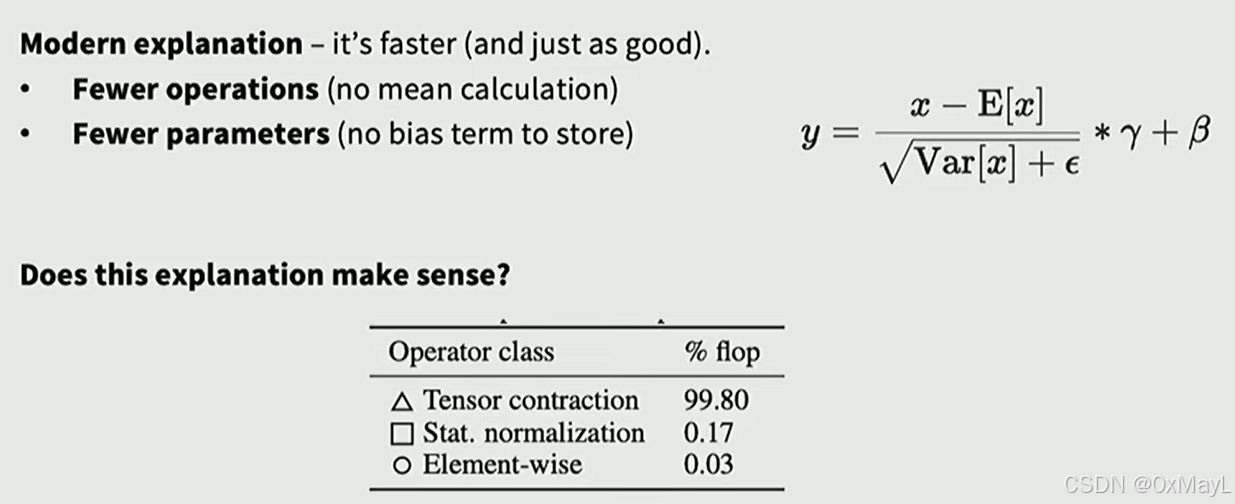
LayerNorm vs RMSNorm
- LayerNorm和RMSNorm本质上对于性能的影响都不大。
- 但是RMSNorm的计算操作更少,效率有一定提升,便于并行化。

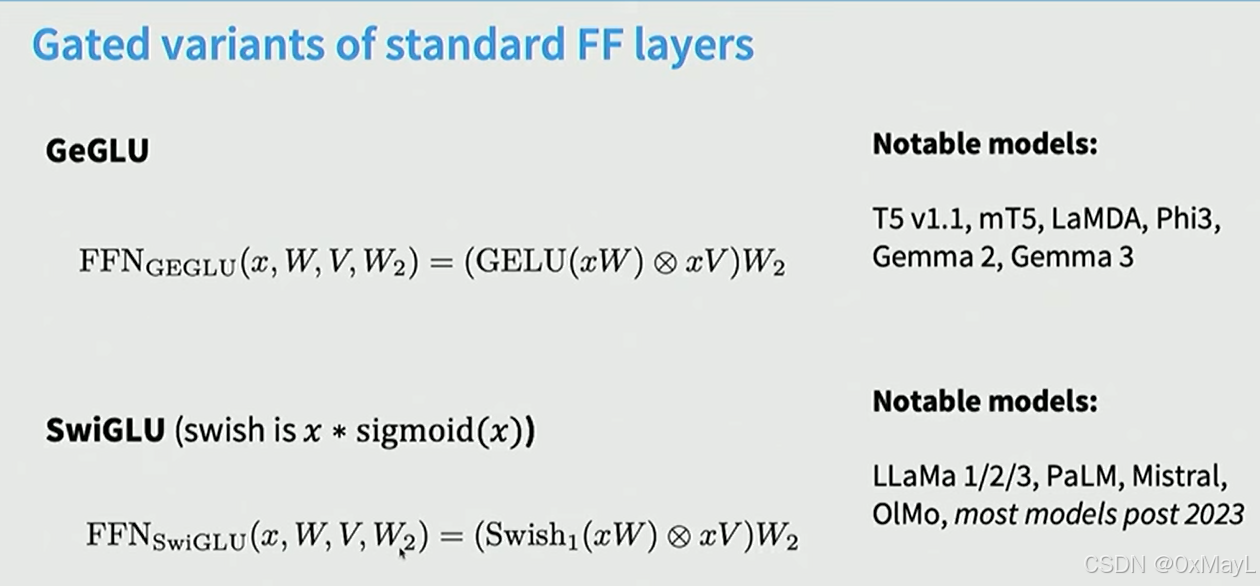
FFN vs SwiGLU
- Swish函数:
torch.SELU()等价于sigmoid(x)*x - GLU:表示门控,使用学习单独的门控映射矩阵V,与激活值进行逐元素乘法。
-
8/3 原则:引入门控矩阵带来额外的参数,为了确保参数量仍然保持一致,FFN中的线性层维度从4倍d_model缩小为8/3倍d_model(同时保持64的倍数)。
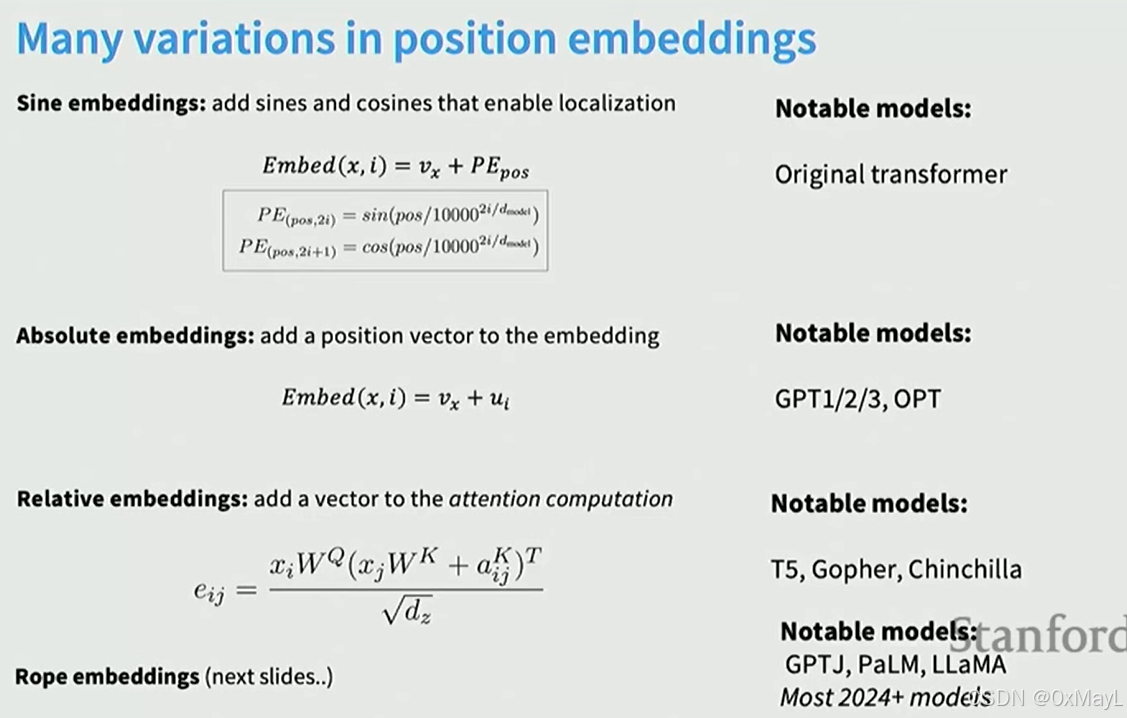
绝对位置编码 vs 相对位置编码
- 绝对位置编码:在获得语义嵌入后就计算位置编码与嵌入值相加
- 相对位置编码(ROPE):在计算注意力操作的QK运算时,将相对位置编码与Q和K叠加在一起。
torch实现
前置操作
nn.Parameter vs nn.Register_buffer:
- nn.Parameter:可训练参数,参与反向传播,优化器会更新;属于模块参数列表,会出现在 state_dict(作为参数)。
- register_buffer:非训练状态(缓冲区),不参与梯度计算与优化器更新;不在 parameters() 中,但默认也出现在 state_dict(作为缓冲区),随 to()/cuda() 迁移设备。
nn.init.trunc_normal_(self.w,std=1,mean=0,a=-3,b=3)
- 使用均值为0,方差为1进行归一化,然后截断不在[a,b]范围内的初始值。
torch.tril(A,diagonal=0):保留下三角矩阵。
scores.masked_fill(mask==False,float('-inf')):将矩阵值为1/True的地方填充为指定值
- 我们得到的掩膜False值是要省略的,因此需要手动转换
mask==False。
线性层
- 计算机为行存储优先,因此将W定义为(out,in)矩阵存储在前向过程中效率更高( x W T xW^T xWT而不是 x W xW xW。)。
class Linear(nn.Module):
    def __init__(self,input_dim,output_dim,device=None,dtype=None):
        super().__init__()
        self.input_dim=input_dim
        self.output_dim=output_dim

        # initialize it in GPUs and define type
        factory_kwargs = {'device': device, 'dtype': dtype}

        # row-major storage
        self.w=nn.Parameter(torch.empty((output_dim,input_dim),**factory_kwargs))
        # no bias for modern LLM

        # truncated normal initialization
        std=math.sqrt(2.0/(input_dim+output_dim))# [a,b] truncate value
        nn.init.trunc_normal_(self.w,std=std,mean=0,a=-3*std,b=3*std)

    def forward(self,x):
        # x.shape:b,input_dim
        y=torch.einsum('b i,o i->b o',x,self.w)# einsum product
        return y
EmbeddingLayer
- 嵌入层就是将token(此时为0~255的数字)映射为一个d_model长度的向量
- 可以简单用一个W来表示这种映射(vocab_size,d_model)
class Embedding_Layer(nn.Module):
    def __init__(self,vocab_size,embedding_dim,device=None,dtype=None):
        super().__init__()
        self.vocab_size=vocab_size
        self.w=nn.Parameter(torch.empty(vocab_size,embedding_dim,device=device,dtype=dtype))
        nn.init.trunc_normal_(self.w,std=1,mean=0,a=-3,b=3)

    def forward(self,x):
        # x:b,l
        return self.w[x]
ROPE旋转位置编码
核心思想
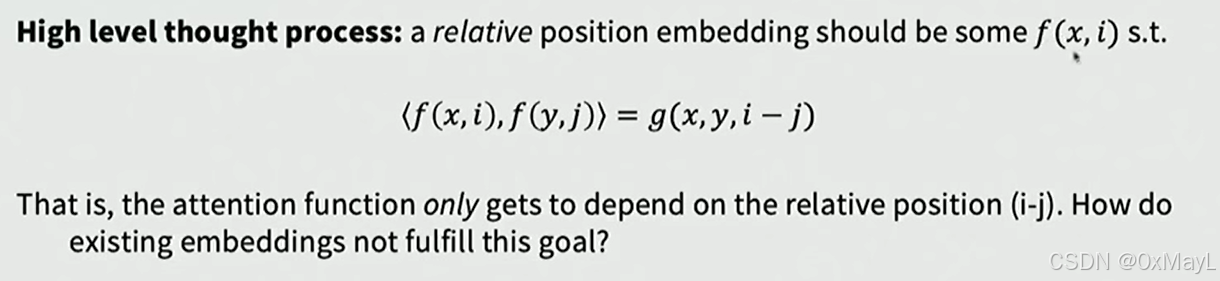
- 我们需要让 Q m Q_m Qm和 K n K_n Kn进行注意力操作的结果与它们的相对位置有关(m-n),我们可以使用旋转矩阵的性质来满足这一点
- 首先我们只考虑二维度的情况,假设 Q m ′ Q_m' Qm′= R ( m θ ) Q m R(m\theta)Q_m R(mθ)Qm, K n ′ = R ( n θ ) K n K_n'=R(n\theta)K_n Kn′=R(nθ)Kn,R是旋转矩阵,旋转角度与它们的位置有关。
- 此时 Q ′ T K ′ = Q m R ( m θ ) R ( n θ ) K n Q'^TK'=Q_mR(m\theta)R(n\theta)K_n Q′TK′=QmR(mθ)R(nθ)Kn,然后我们利用一些旋转矩阵的性质,得到 Q ′ T K ′ = Q m R ( ( m − n ) θ ) K n Q'^TK'=Q_mR((m-n)\theta)K_n Q′TK′=QmR((m−n)θ)Kn
计算公式
- 旋转矩阵R是一个2x2的矩阵(我们现在只对2维的情况考虑),假设有n个维度,我们可以构造n/2个旋转矩阵R组成的对角矩阵(将n个维度拆分为n/2个组,每个组单独考虑)。
- 每一个2D旋转矩阵的公式该token的相对位置i和处于第k个组共同决定。
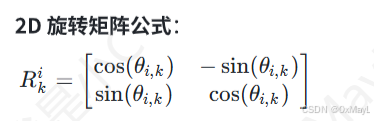
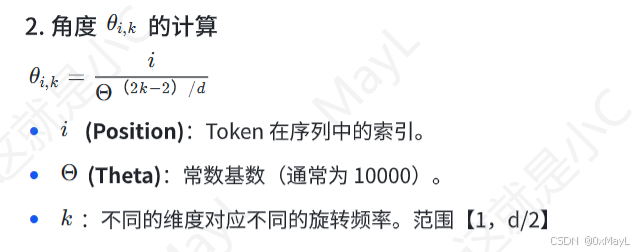
- 特点:第一组的旋转弧度最大,后面的组得到的旋转弧度迅速递减
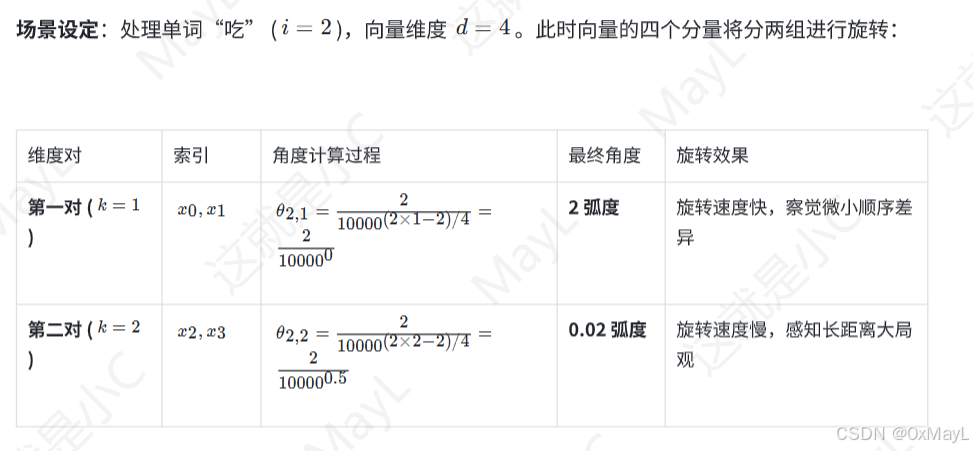
实现
- 只考虑第d个token,我们发现其特征维度叠加ROPE位置编码的公式有这样的特点
- 下标从0开始,对于偶数位:
output[...,0::2]=self.cos*x_even-self.sin*x_odd - 下标从0开始,对于奇数位:
output[...,1::2]=self.cos*x_odd+self.sin*x_even - 旋转角度
θ
\theta
θ和token位置与组数有关,因此提前处理即可
theta_matrix=torch.outer(seqs,thetas)# [l,d_k/2]。
R Θ , m d x = ( x 0 x 1 x 2 x 3 ⋮ ) ⊗ ( cos m θ 1 cos m θ 1 cos m θ 2 cos m θ 2 ) + ( − x 1 x 0 − x 3 x 2 ⋮ ) ⊗ ( sin m θ 1 sin m θ 1 sin m θ 2 sin m θ 2 ⋮ ) \boldsymbol{R}_{\Theta,m}^d\boldsymbol{x}= \begin{pmatrix} x_0 \\ x_1 \\ x_2 \\ x_3 \\ \vdots \\ \end{pmatrix}\otimes \begin{pmatrix} \cos m\theta_1 \\ \cos m\theta_1 \\ \cos m\theta_2 \\ \cos m\theta_2 \\ \end{pmatrix}+ \begin{pmatrix} -x_1 \\ x_0 \\ -x_ 3\\ x_2 \\ \vdots \\ \end{pmatrix}\otimes \begin{pmatrix} \sin m\theta_1 \\ \sin m\theta_1 \\ \sin m\theta_2 \\ \sin m\theta_2 \\ \vdots \\ \end{pmatrix} RΘ,mdx= x0x1x2x3⋮ ⊗ cosmθ1cosmθ1cosmθ2cosmθ2 + −x1x0−x3x2⋮ ⊗ sinmθ1sinmθ1sinmθ2sinmθ2⋮
class RotaryPositionEmbedding(nn.Module):
    def __init__(self,d_k,bigo,max_seq_len,device=None):
        super().__init__()
        self.d_k=d_k # n h l d

        # For dimension
        thetas=1/(bigo**(torch.arange(0,d_k,2,device=device)/d_k))

        # For sequence length
        seqs=torch.arange(0,max_seq_len,device=device)
        theta_matrix=torch.outer(seqs,thetas)# [l,d_k/2]

        self.register_buffer('cos',theta_matrix.cos(),persistent=False)
        self.register_buffer('sin',theta_matrix.sin(),persistent=False)

    def forward(self,x):
        # x: b h l d
        x_even=x[...,0::2]
        x_odd=x[...,1::2]
        output=torch.empty_like(x)
        output[...,0::2]=self.cos*x_even-self.sin*x_odd
        output[...,1::2]=self.cos*x_odd+self.sin*x_even
        return output
Attention机制
缩放点积
- 除以
d_k的原因:如果不除以,注意力分数的均值和方差会比较大,导致softmax结果趋向于0-1编码(所有的值都趋于1或者趋于0),在这种情况下,softmax的梯度会几乎消失! - 建议使用爱因斯坦乘机,兼容多头注意力
('... n d,...m d->...n m',q,k)
def scaled_dot_product(q,k,v,mask=None):
    d=q.size(-1)
    # 最好省略b维度,兼容多头注意力
    scores=torch.einsum('... n d,...m d->...n m',q,k)
    scores=scores/math.sqrt(d)
    if mask is not None:
        # masked_fill填充mask为True的位置!
        scores=scores.masked_fill(mask==False,float('-inf'))

    # torch.softmax() == nn.functional.softmax()
    attn_weights=torch.softmax(scores,dim=-1)
    output=torch.einsum('...n m,... m d->... n d',attn_weights,v)

    return output,attn_weights
注意力机制
- 兼容交叉注意力
- 建议使用
einops中的rearrange操作避免转置等改变矩阵维度的操作。
from einops import rearrange# 建议使用
class Attention(nn.Module):
    def __init__(self,d_model,num_heads,bigo=10000,max_seq_len=None,device=None,dtype=None):
        super().__init__()

        self.d_model=d_model
        self.d_k=d_model//num_heads
        self.num_heads=num_heads
        factory_kwargs = {'device': device, 'dtype': dtype}
        self.q_proj=nn.Linear(d_model,d_model,**factory_kwargs)
        self.k_proj=nn.Linear(d_model,d_model,**factory_kwargs)
        self.v_proj=nn.Linear(d_model,d_model,**factory_kwargs)


        # 注意力块还有一个输出投影层
        self.o_proj=nn.Linear(d_model,d_model,**factory_kwargs)

        # rope
        if max_seq_len is not None:
            self.rope = RotaryPositionEmbedding(self.d_k,bigo,max_seq_len,device=device)
        else:
            self.rope = None

    def forward(self,q,k,v,mask=None):
        # x:b,l,d_model
        b,l,d=x.size()
        q= self.q_proj(q)
        k= self.k_proj(k)
        v= self.v_proj(v)

        # 多头
        q= rearrange(q,' ... l (h d)-> ... h l d',h=self.num_heads,d=self.d_k)
        k= rearrange(k,' ... l (h d)-> ... h l d',h=self.num_heads,d=self.d_k)
        v= rearrange(v,' ... l (h d)-> ... h l d',h=self.num_heads,d=self.d_k)

        if self.rope is not None:
            q = self.rope(q)
            k = self.rope(k)

        output,attn_weights=scaled_dot_product(q,k,v,mask=mask)
        output = rearrange(output,'... h l d -> ... l (h d)',h=self.num_heads,d=self.d_k)
        output=self.o_proj(output)
        return output,attn_weights
注意力掩码
- 因果掩膜:为了避免当前token偷看后面的token,所以是下三角矩阵
A= torch.arange(1,10).view(3,3)
L= torch.tril(A,diagonal=0)
L
SwiGLU
SwiGLU的计算公式如下:
S
w
i
G
L
U
=
(
σ
(
x
W
1
T
)
⋅
x
W
2
T
)
⋅
W
3
T
SwiGLU=(\sigma(xW_1^T)\cdot xW_2^T)\cdot W_3^T
SwiGLU=(σ(xW1T)⋅xW2T)⋅W3T
from torch.nn import functional as F
# torch.sigmoid==F.sigmoid
def silu(x):
    return x*F.sigmoid(x)# == nn.SELU
class ModernFFN(nn.Module):
    def __init__(self,d_model,d_ff,device=None,dtype=None):
        super().__init__()
        factory_kwargs = {'device': device, 'dtype': dtype}
        self.fc1=nn.Linear(d_model,d_ff,**factory_kwargs)
        self.gate=nn.Linear(d_model,d_ff,**factory_kwargs)
        self.fc2=nn.Linear(d_ff,d_model,**factory_kwargs)
    def forward(self,x):
        o1=silu(self.fc1(x))
        o_gate=self.gate(x)
        o=self.fc2(o1*o_gate)
        return o
LayerNorm
- LayerNorm=高斯标准化进行缩放+偏差
L a y e r N o r m ( x ) = x − E ( x ) V A R ( x ) ⋅ γ + β LayerNorm(x)=\frac{x-E(x)}{\sqrt{VAR(x)}}\cdot \gamma+ \beta LayerNorm(x)=VAR(x)x−E(x)⋅γ+β - γ \gamma γ和 β \beta β都是可学习的参数,维度为(d_model,)
class LayerNorm(nn.Module):
    def __init__(self,d_model,device=None,dtype=None,eps=1e-5):
        super().__init__()
        self.d_model=d_model
        self.eps=eps
        factory_kwargs = {'device': device, 'dtype': dtype}
        self.gamma=nn.Parameter(torch.ones(d_model,**factory_kwargs))# d_model,
        self.beta=nn.Parameter(torch.zeros(d_model,**factory_kwargs))# d_model,
    def forward(self,x):
        # x:b l d
        x_mean=x.mean(dim=-1,keepdim=True)# b l 1
        x_var=x.var(dim=-1,keepdim=True,unbiased=False)# b l 1

        # boardcast [b l 1]->[b l d]
        x_norm=(x-x_mean)/(torch.sqrt(x_var+self.eps))*self.gamma+self.beta
        return x_norm
- 细节:
keepdim=True:保留一个维度,方便广播
RMSNorm
RMSNorm的公式:
x
R
M
S
(
x
)
+
ϵ
⋅
γ
\frac{x}{RMS(x)+\epsilon}·\gamma
RMS(x)+ϵx⋅γ
- 其中 RMS代表x的均方根, R M S ( x ) = ∑ i d x i 2 d RMS(x)=\sqrt{\frac{\sum_i^d{x_i^2}}{d}} RMS(x)=d∑idxi2
- γ \gamma γ代表RMSNorm的参数,维度为(d_model,)。
class RMSNorm(nn.Module):
    def __init__(self,d_model,device=None,dtype=None,eps=1e-8):
        super().__init__()
        self.d_model=d_model
        self.eps=eps
        factory_kwargs = {'device': device, 'dtype': dtype}
        self.gamma=nn.Parameter(torch.ones(d_model,**factory_kwargs))# d_model,
    def forward(self,x):
        # x:b l d
        x_rms=torch.sqrt(torch.mean(x**2,dim=-1,keepdim=True)+self.eps)# b l 1
        x_norm=x/(x_rms)*self.gamma
        return x_norm
TransformerBlock
- 采取PreNorm范式:在进行ffn和attention操作前就进行归一化操作
- 输入和输出维度为(b,l,d_model)
class TransformerBlock(nn.Module):
    def __init__(self,d_model,num_heads,d_ff,bigo,max_seq_len,device=None,dtype=None):
        super().__init__()
        factory_kwargs = {'device': device, 'dtype': dtype}
        self.ln1 = RMSNorm(d_model,**factory_kwargs)
        self.ln2 = RMSNorm(d_model,**factory_kwargs)
        self.ffn = ModernFFN(d_model,d_ff,**factory_kwargs)
        self.attention = Attention(d_model,num_heads,bigo,max_seq_len,**factory_kwargs)
    def forward(self,x,token_positions,mask=None):
        # pre-norm
        # x:b l d
        x_norm_1 = self.ln1(x)
        x_attn, attn_weights = self.attention(x_norm_1,x_norm_1,x_norm_1,mask=mask) # output,score
        x_1 = x + x_attn # output,score
        x_norm_2 = self.ln2(x_1)
        x_ffn = self.ffn(x_norm_2)
        x_2 = x_1 + x_ffn
        return x_2
完整的语言模型
- 输入:(b,l),编码后的结果
- 输出:(b,l,vocab_size),每一个词的输出概率。
class TransformerLM(nn.Module):
    def __init__(self,vocab_size,n_layers,d_model,d_ff,num_heads,bigo,max_seq_len,device=None,dtype=None):
        # 默认为prenorm
        # transformer block的最后一层输入前还有一层RMSnorm
        super().__init__()
        factory_kwargs = {'device': device, 'dtype': dtype}
        self.embedding = Embedding_Layer(vocab_size,d_model,**factory_kwargs)
        self.transformer_blocks= nn.ModuleList(
            TransformerBlock(d_model,num_heads,d_ff,bigo,max_seq_len,**factory_kwargs)
            for _ in range(n_layers)
        )

        self.ln_f = RMSNorm(d_model,**factory_kwargs)
        self.output_head = Linear(d_model,vocab_size,**factory_kwargs)
    def forward(self,x,token_positions=None,mask=None):
            # x:b l
            # attn_weights = []
            x = self.embedding(x)
            for block in self.transformer_blocks:
                x = block(x,mask)
            x = self.ln_f(x)
            x = self.output_head(x)
            return x
更多推荐

 27
 0
- 0


 已为社区贡献12条内容

所有评论(0)