
RAG 入门指南:用外部知识让大模型更靠谱
注 : 本文纯由长文技术博客助手Vibe-Blog生成, 如果对你有帮助,你也想创作同样风格的技术博客, 欢迎关注开源项目: Vibe-Blog.
Vibe-Blog是一个基于多 Agent 架构的 AI 长文博客生成助手,具备深度调研、智能配图、Mermaid 图表、代码集成、智能专业排版等专业写作能力,旨在将晦涩的技术知识转化为通俗易懂的科普文章,让每个人都能轻松理解复杂技术,在 AI 时代扬帆起航.
RAG 入门指南:用外部知识让大模型更靠谱
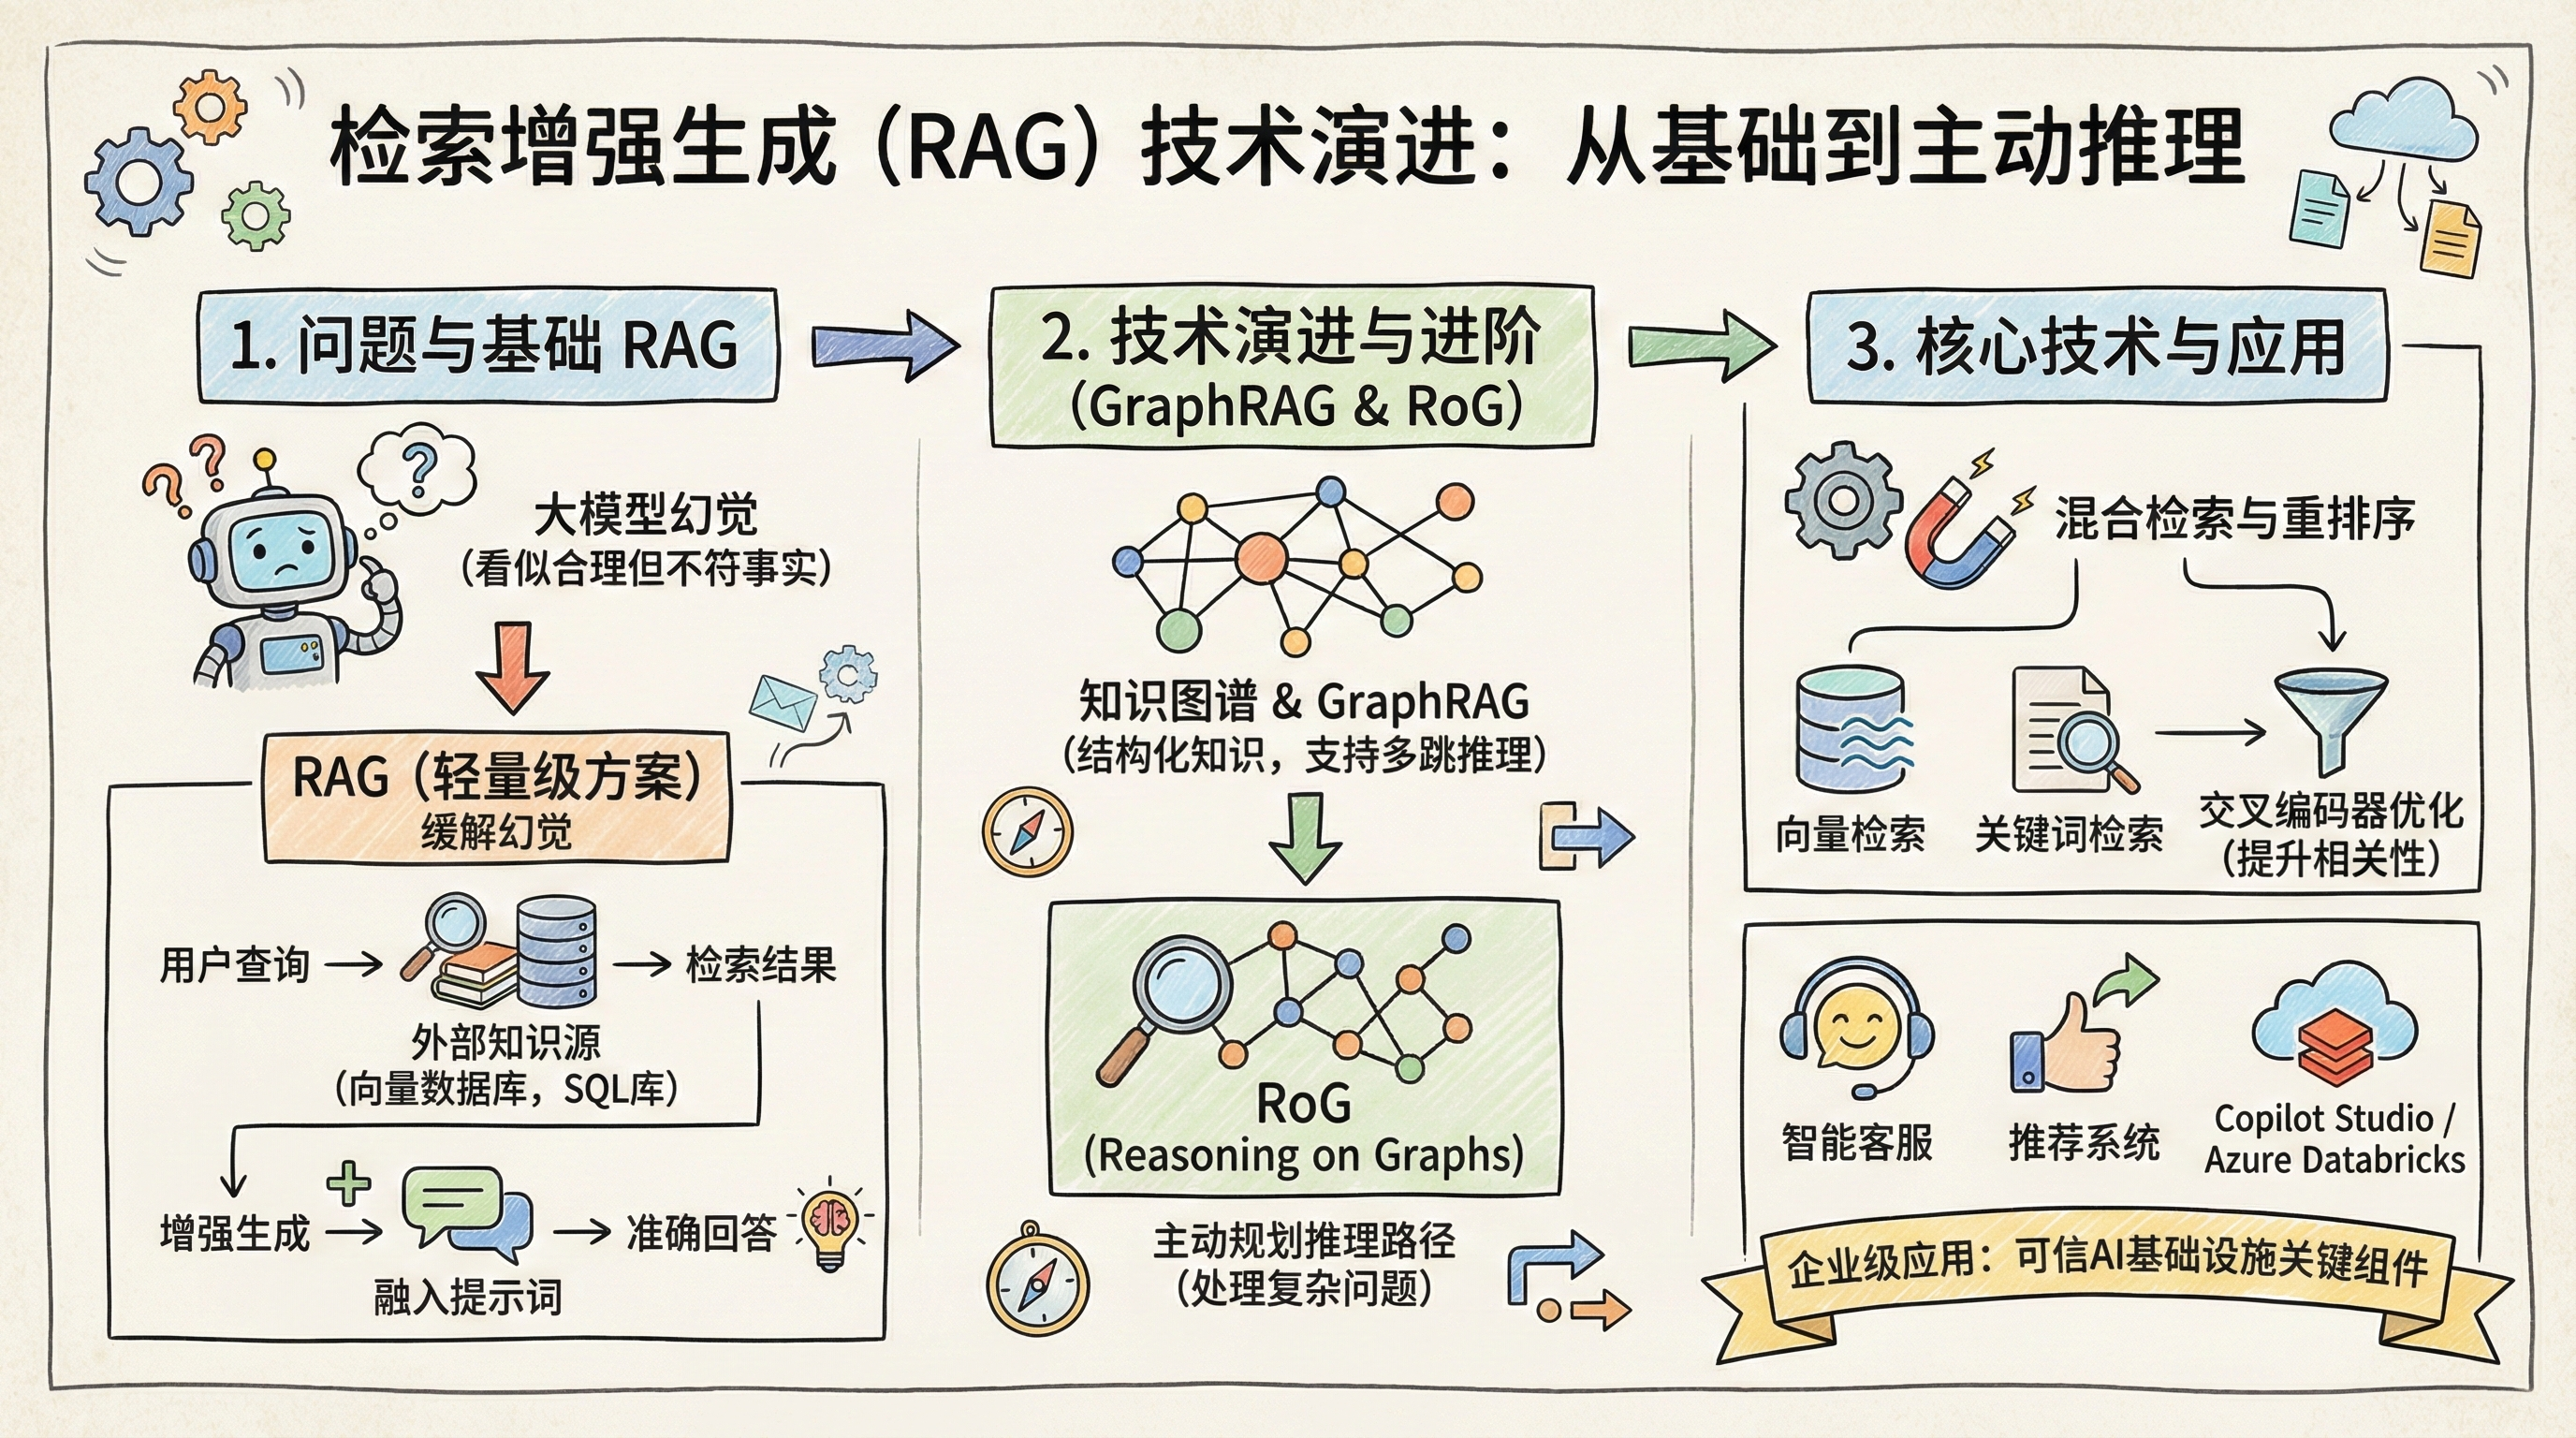
检索增强生成 | 大型语言模型 | 知识图谱 | GraphRAG | RoG
阅读时间: 5 min
RAG通过在生成前检索外部知识,有效解决了大模型的幻觉问题,让AI回答既智能又可靠。
目录
大型语言模型虽然强大,但经常’一本正经地胡说八道’——这就是所谓的’幻觉’问题。当企业需要基于准确事实生成内容时,这种不可靠性就成了致命缺陷。检索增强生成(RAG)正是解决这一痛点的关键技术,它让大模型在回答前先’查资料’,确保输出有据可查。本文将带你快速掌握RAG的核心概念和演进路径。
为什么我们需要RAG:告别大模型幻觉
你是否遇到过大模型自信满满地给出一个完全错误的答案?这种“幻觉”现象——生成看似合理却与事实不符的内容——在客户服务、企业知识管理等高风险场景中可能引发严重后果。传统应对方式如微调模型,不仅成本高昂,还难以跟上知识的快速更新节奏。检索增强生成(RAG)提供了一条轻量级路径:它让大模型在回答前先“查资料”,从外部知识库中获取支持信息,再基于真实上下文生成响应。
RAG让大模型在回答前先’查资料’,从根本上减少幻觉风险。
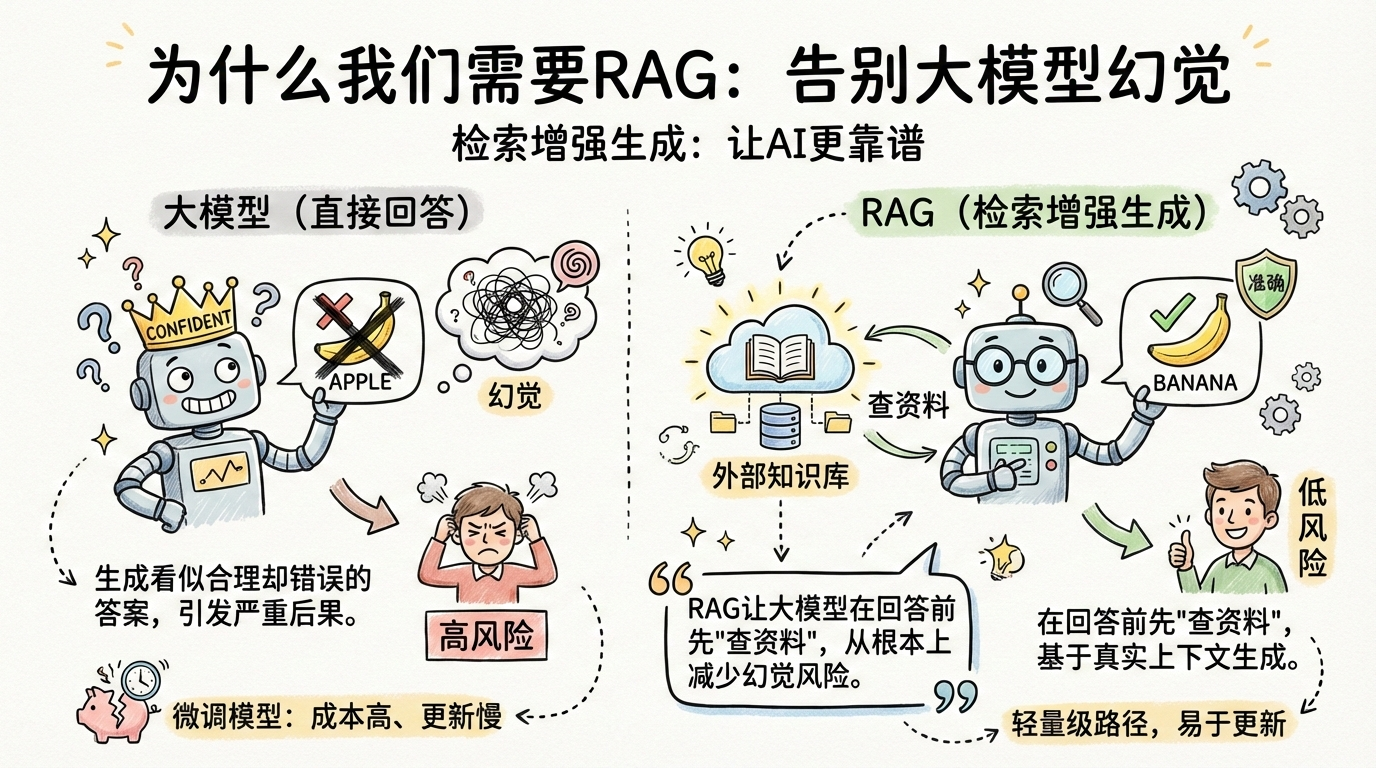
为什么我们需要RAG:告别大模型幻觉
RAG是什么:检索增强生成的核心原理
检索增强生成(Retrieval-Augmented Generation,RAG)是一种将大型语言模型(LLM)与外部知识源结合的技术,旨在提升生成内容的事实准确性并缓解幻觉问题。在最简单的形式下,RAG 代理执行以下工作:检索:用户的请求用于查询外部知识库,例如矢量存储、关键字搜索或 SQL 数据库。目标是获取 LLM 响应的支持数据。
RAG 的工作流程分为两个阶段。首先,在检索阶段,系统根据用户查询从外部知识源中提取相关文档或数据片段。这些知识源可以是向量数据库(基于语义相似性)、传统关键字索引,或是结构化的 SQL 数据库。随后进入生成阶段,系统将检索到的信息与原始查询组合,构建一个增强的提示词(Prompt),引导 LLM 生成有据可查的回答。
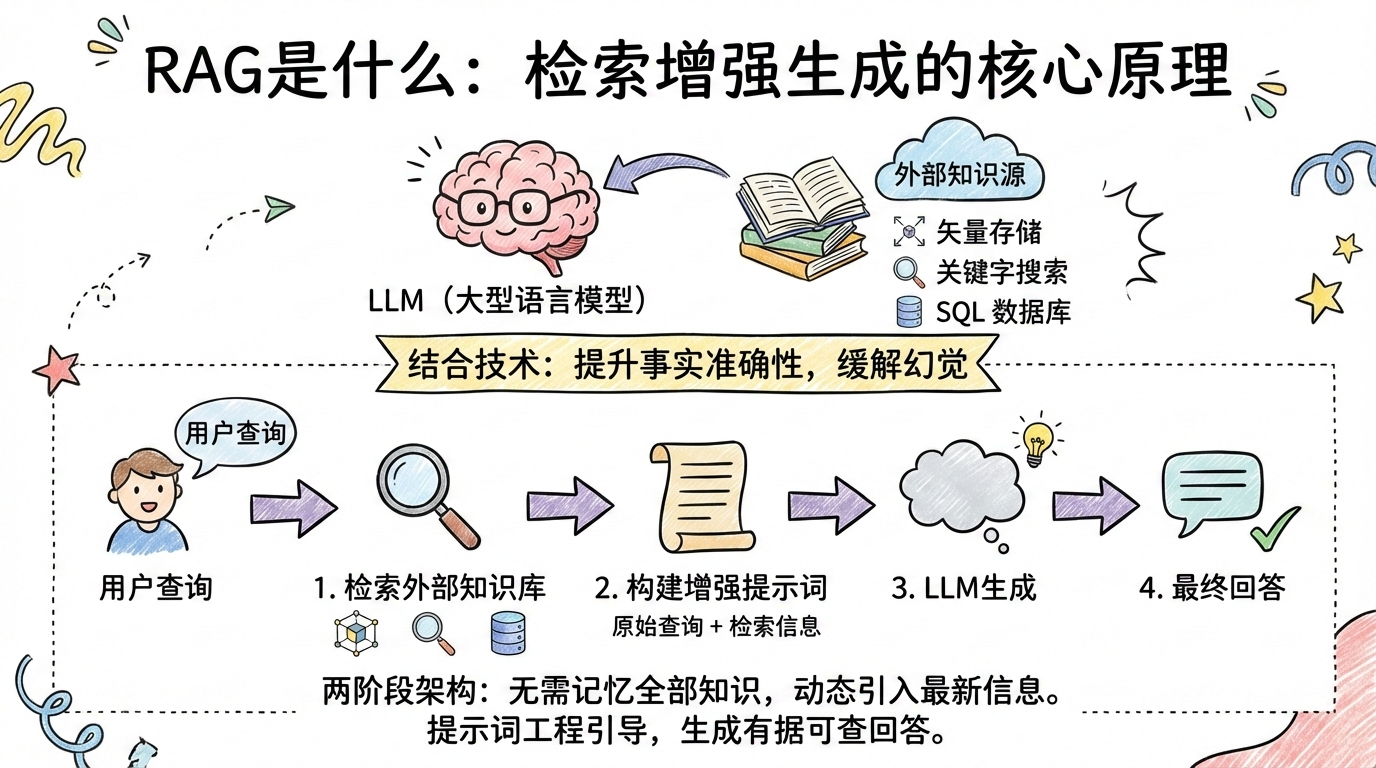
RAG是什么:检索增强生成的核心原理
这种两阶段架构使得模型无需依赖内部参数记忆全部知识,而是动态引入最新、最相关的外部信息。通过精心设计提示词工程,检索结果能有效融入生成上下文,显著提升回答的可靠性与一致性。
在最简单的形式下,RAG 代理执行以下工作:检索 :用户的请求用于查询外部知识库,例如矢量存储、关键字搜索或 SQL 数据库。目标是获取 LLM 响应的支持数据。
RAG的演进:从向量检索到知识图谱
传统RAG架构依赖文本片段的向量嵌入进行相似性匹配,虽然在简单问答任务中表现良好,但在处理需要深层语义关联或多步推理的问题时往往力不从心。例如,当用户询问“某位诺贝尔奖得主的导师是谁,其导师又指导过哪些著名科学家?”这类问题时,仅靠关键词或语义向量匹配难以准确捕获跨越多个实体的关系链。这种局限源于传统RAG将知识视为扁平化文档集合,忽略了知识之间的结构化连接。
为突破这一瓶颈,GraphRAG应运而生。它将外部知识库从非结构化文本升级为结构化的知识图谱,其中节点代表实体(如人物、机构、概念),边则编码实体间的关系(如“师从”、“合作”、“隶属于”)。这种表示方式天然支持拓扑遍历和路径推理。当面对复杂查询时,系统不再仅检索孤立段落,而是沿着图谱中的关系路径进行多跳探索,从而构建完整的推理链条。执行后你会看到,原本无法回答的多跳问题现在能生成连贯且事实一致的答案。
⚠️ 注意:构建高质量知识图谱是GraphRAG成功的关键前提。若图谱覆盖不全或关系标注错误,反而会引入新的噪声,导致推理偏差。
在此基础上,RoG(Reasoning on Graphs)架构进一步提升了RAG的推理能力。RoG的核心机制在于引导大型语言模型主动规划推理路径。具体操作分为三个步骤:首先,针对用户问题,RoG提示LLM生成多个可能的基于知识图谱的关系路径规划;其次,系统依据这些规划在知识图谱中实际检索对应的推理路径;最后,将提取出的结构化推理链作为上下文注入生成阶段,引导模型输出忠实于图谱事实的回答。正如资料所述:“RoG引导大型语言模型生成多个基于知识图谱的规划关系路径。RoG利用这些规划从知识图谱中提取推理路…”。
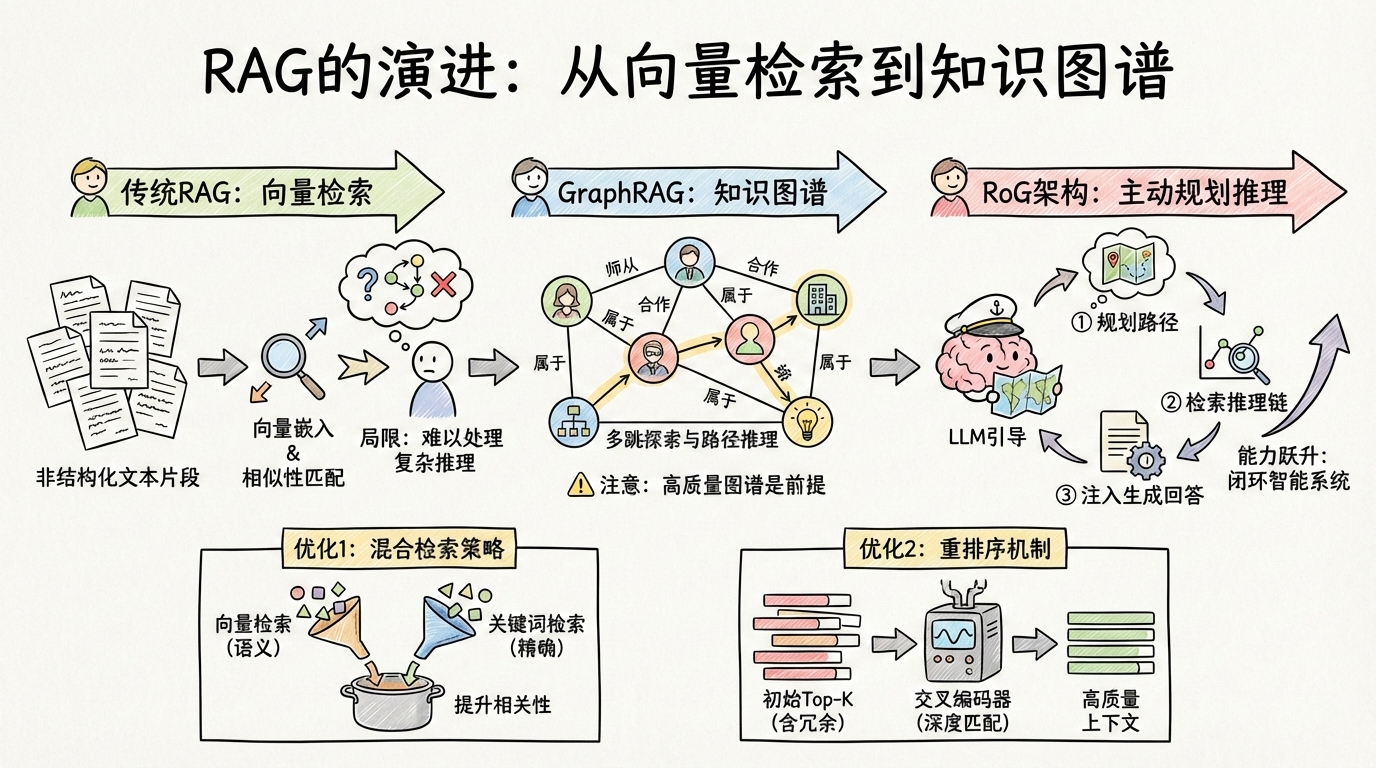
RAG的演进:从向量检索到知识图谱
为了提升检索阶段的召回率与精度,现代RAG系统普遍采用混合检索策略。单一的向量检索虽能捕捉语义相似性,但对专业术语、缩写或罕见实体敏感度不足;而关键词检索则擅长精确匹配。将两者结合——先通过向量检索获取语义相关候选集,再用关键词过滤或重加权——能显著提升结果的相关性。执行后你会看到,混合策略在包含专业术语或长尾实体的查询中表现尤为突出。
然而,即使采用混合检索,初始返回的Top-K结果仍可能包含冗余或次相关信息。为此,重排序(re-ranking)机制成为关键优化环节。该机制通常使用更精细的交叉编码器模型,对初步检索结果与原始查询进行逐对深度语义匹配,重新计算相关性得分并调整顺序。这一步骤虽增加少量计算开销,但能大幅提升最终注入提示词的上下文质量。常见错误是跳过重排序以节省延迟,但这往往导致生成内容偏离核心事实。
RoG等进阶架构的出现,标志着RAG技术正从“检索-生成”的线性流程,转向“规划-检索-推理-生成”的闭环智能系统。这种演进不仅增强了模型处理复杂逻辑的能力,也为企业级知识密集型应用提供了更可靠的基础设施。在社交网络分析、学术关系挖掘、智能客服等场景中,基于图谱的RAG架构已展现出显著优势。
“RoG引导大型语言模型生成多个基于知识图谱的规划关系路径。RoG利用这些规划从知识图谱中提取推理路…”
RAG的实际应用:企业级落地场景
RAG已成为企业构建可信AI应用的基础设施。在智能客服领域,系统通过检索企业知识库生成准确回答,避免模型幻觉;推荐系统则利用用户行为图谱,结合RoG技术规划关系路径,提供个性化建议。Microsoft Copilot Studio和Azure Databricks已集成RAG能力,支持基于私有数据的上下文感知响应。多模态扩展进一步推动RAG应用于图像、文档等异构知识源,如AR-RAG在图像生成中实现逐块检索增强。这些实践表明,RAG不仅提升回答可靠性,更成为知识密集型业务的核心组件。
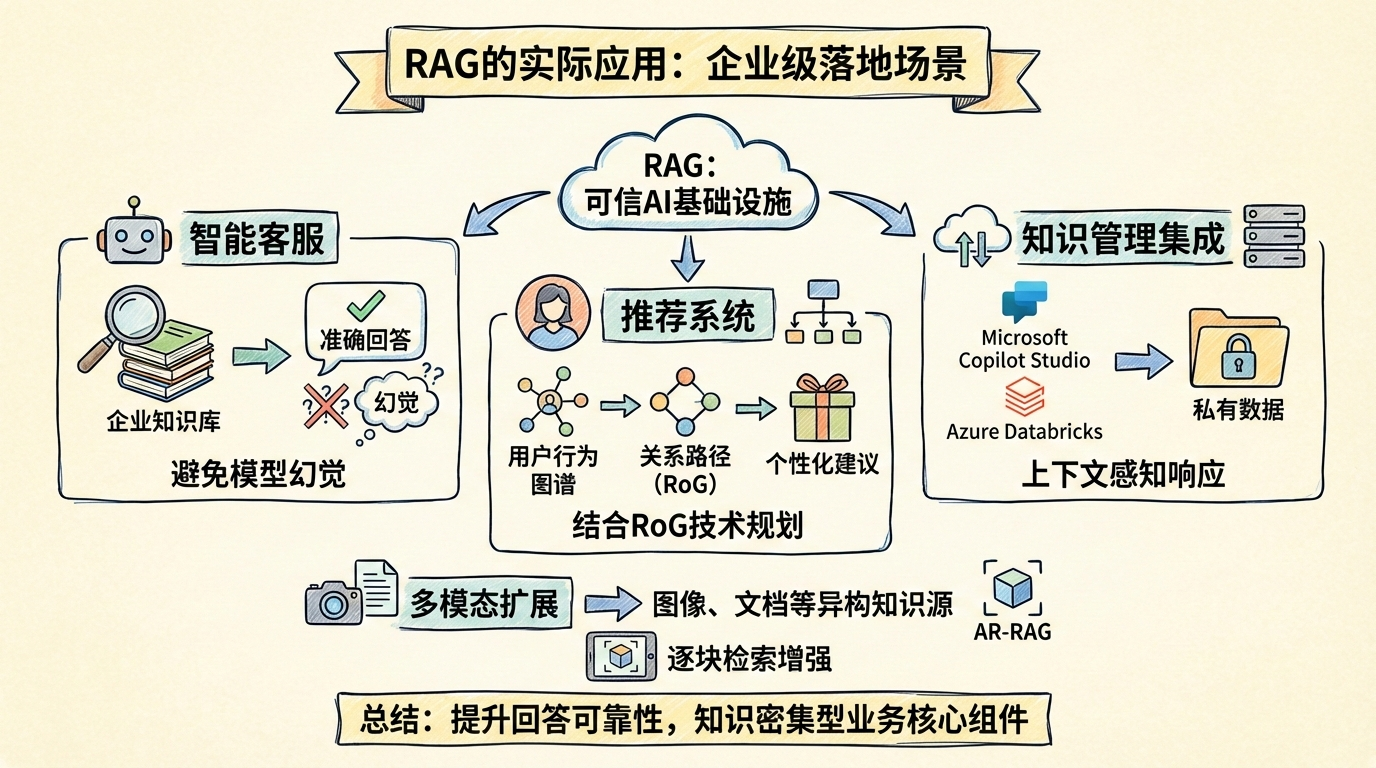
RAG的实际应用:企业级落地场景
RAG已成为企业构建可信AI应用的基础设施。
总结
- RAG通过检索外部知识有效解决了大模型幻觉问题
- 从基础向量检索到GraphRAG,技术不断演进支持更复杂推理
- RAG已在企业级平台广泛落地,成为知识密集型应用的标准方案
延伸阅读
深入了解Azure Databricks上的RAG实现,或探索GraphRAG在特定领域的应用案例
参考资料
🌐 网络来源
- Azure Databricks 上的 RAG(检索增强生成)
- 论文导读 | 基于图的大模型检索增强生成技术
本文由 Vibe-Blog 自动发布
更多推荐

 5
 0
- 0


 已为社区贡献7条内容

所有评论(0)