
大模型学习笔记1——工作流程
·
大模型工作流程
分词化与词表映射
分词化(Tokenization)
分词化(Tokenization)是自然语言处理NLP的重要概念,将段落和句子分割成更小的分词Token的过程。
分词化有不同的粒度分类:
- 词粒度(Word-Level Tokenization)分词化,适用于大多数西方语言,英文等。
- 字符粒度(Character-Level)分词化是中文最直接的分词方法,它是以单个汉字为单位进行分词化。
- 子词粒度(Subword-Level)分词化,它将单词分解为更小的单位,比如词根、词缀等。这种方法对于处理新词(比如专有名词、网络用语等)特别有效,因为即使是新词,其组成部分(子词)很可能已经存在于词表中。
词表映射
每一个token都会通过预先设置好的词表,映射为一个token id,这是token的“身份证”,一句话最终会被表示为一个元素为token id的列表,供计算机进行下一步处理。
文本生成过程
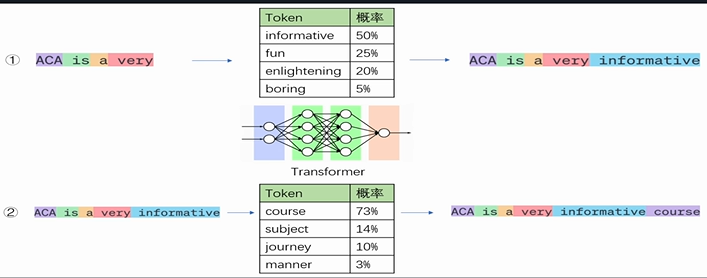
大语言模型的工作概括来说是根据给定文本预测下一个token。对我们来说,看似在对大模型提问,但实际上是给了大模型一串提示文本,让它可以对后续的文本进行推理。
大模型的推理过程不是一步到位的,当大模型进行推理时,它会基于现有的token,根据改了最大原则预测出下一个最有可能的token,然后将该预测的token加入到输入序列中,并将更新后的输入序列继续输入给大模型预测下一个token,这个过程叫自回归。
直到输出特殊token(如< EOS >,end of sentence,专门用来控制推理何时结束)或输出长度达到阈值
更多推荐

 8
 0
- 0


 已为社区贡献2条内容

所有评论(0)