
动手学深度学习(李沐)笔记:自动求导(Autograd)+ PyTorch 实现
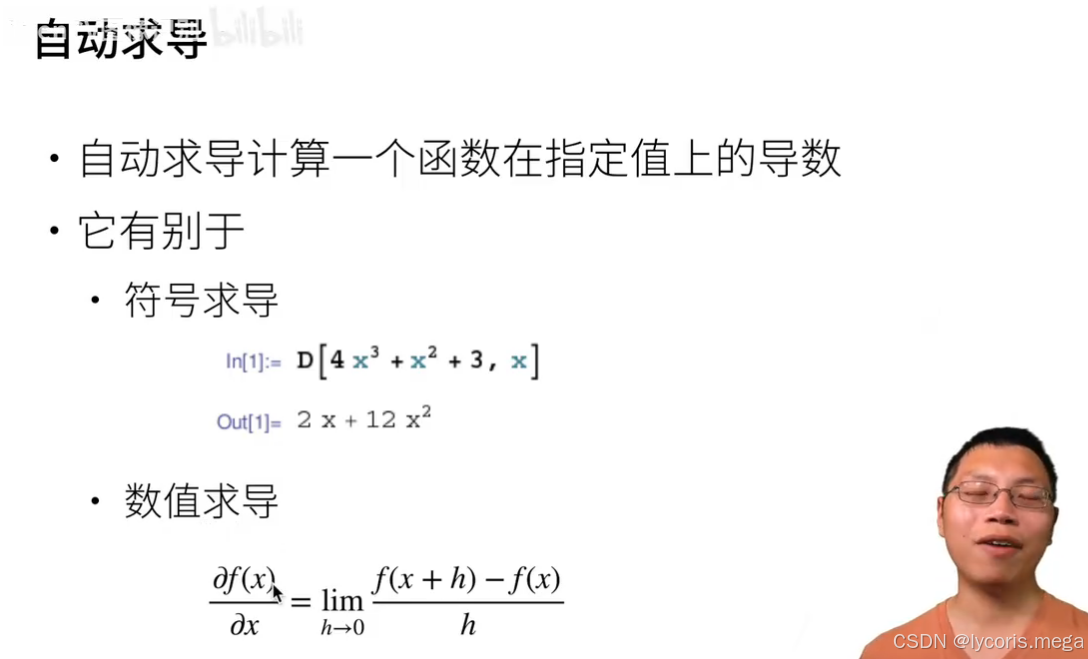
深度学习训练的本质是:选一个损失函数 loss,然后对参数求梯度,用优化算法更新参数。
而“对参数求梯度”这一步,在 PyTorch 里基本靠 autograd 自动完成。
这一节我按李沐的思路讲清楚三件事:
-
什么是自动求导、计算图
-
requires_grad / backward / grad怎么用 -
为什么要
zero_grad、detach、no_grad(最常踩坑)
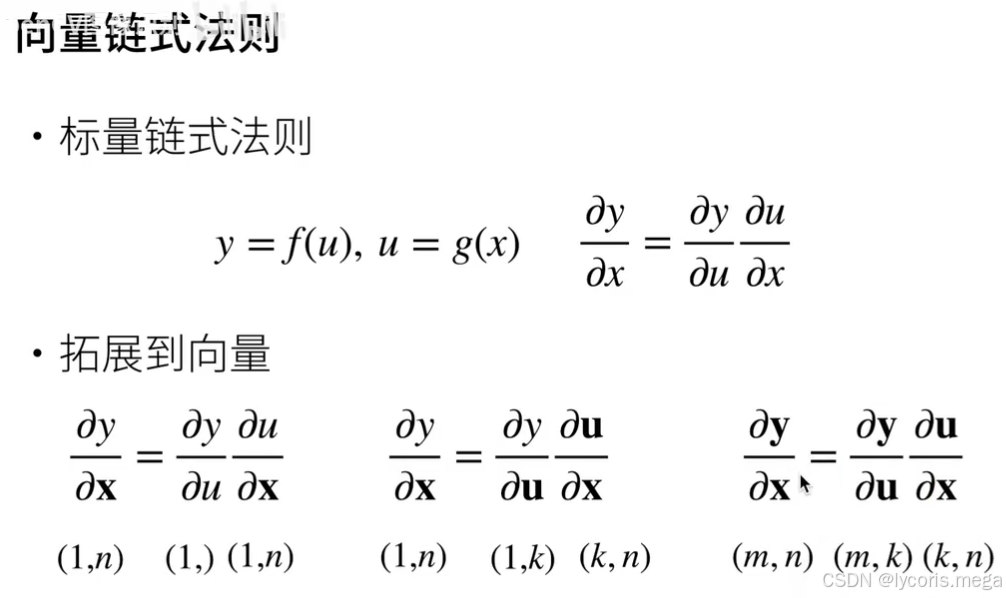
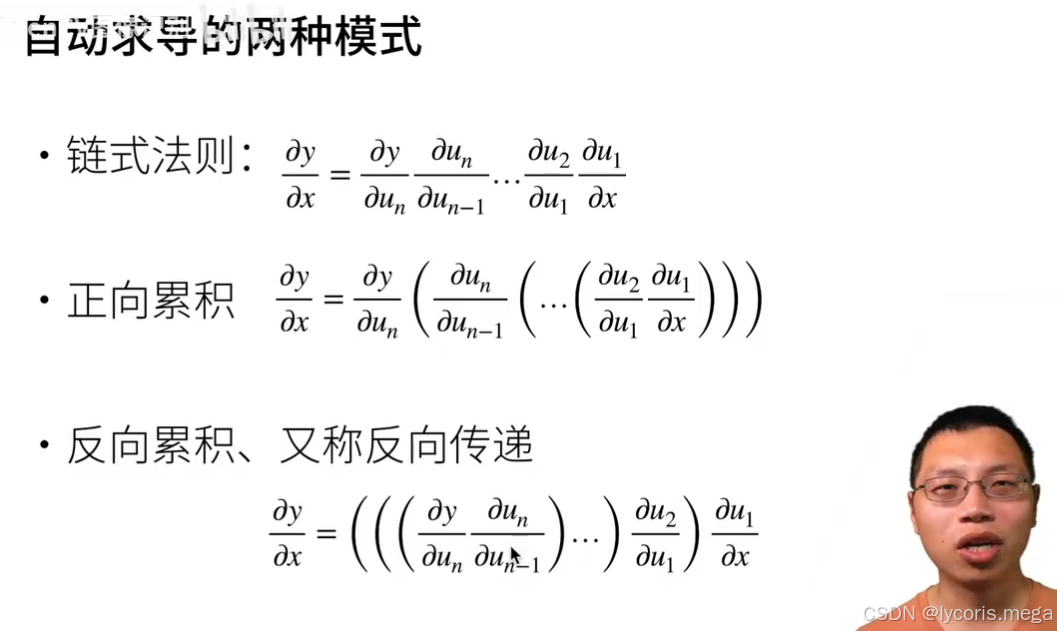
1. 自动求导在干什么:链式法则 + 计算图
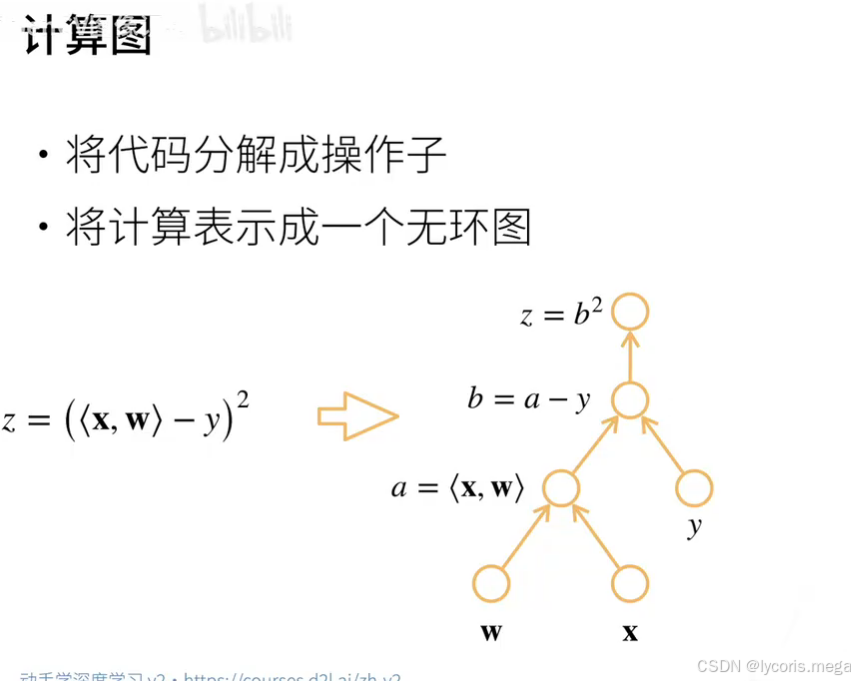
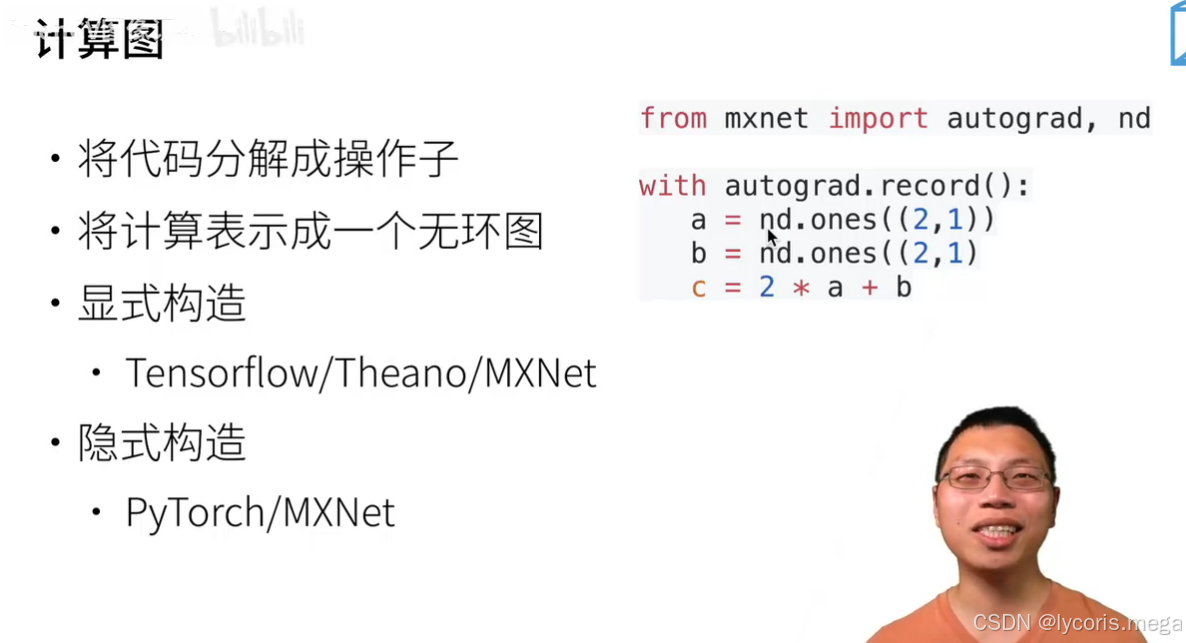
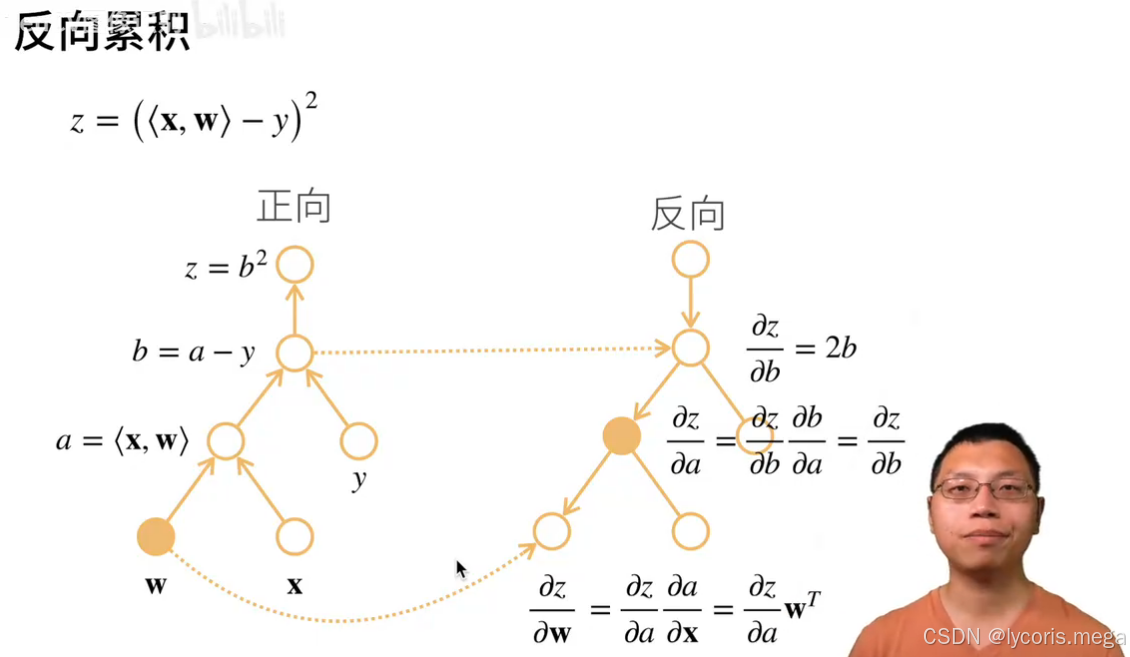
你写的运算(加、乘、matmul、sin…)会被 PyTorch 记录成一张计算图。
当你对某个标量(通常是 loss)调用 backward() 时,PyTorch 会沿图反向传播,用链式法则把梯度一路传回去。
一句话:
loss.backward()= 自动帮你算 (\partial loss / \partial \theta)
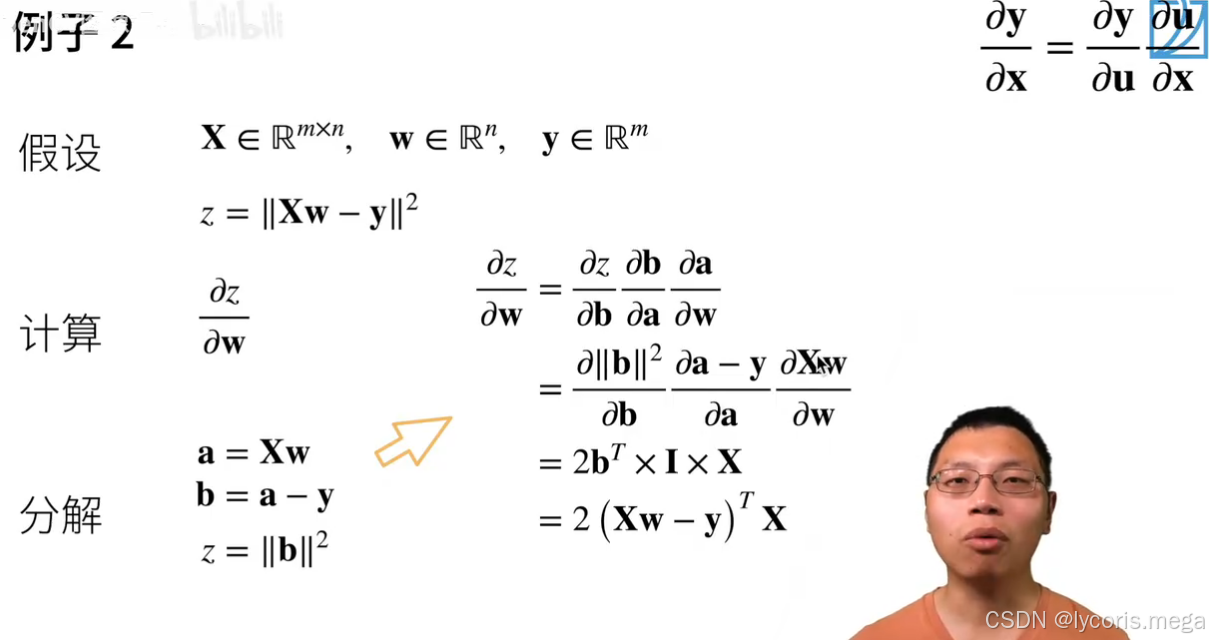
2. 最小例子:从标量到梯度
import torch

x = torch.tensor(3.0, requires_grad=True)  # 告诉框架:我要对 x 求导
y = x * x + 2 * x + 1                      # y = x^2 + 2x + 1
y.backward()                               # dy/dx

print(x.grad)  # 2x + 2 = 8
注意点:
-
requires_grad=True是“追踪梯度”的开关 -
backward()只能对标量直接调用(严格来说是对标量输出最自然)
3. 向量/矩阵的求导:必须让输出变成标量
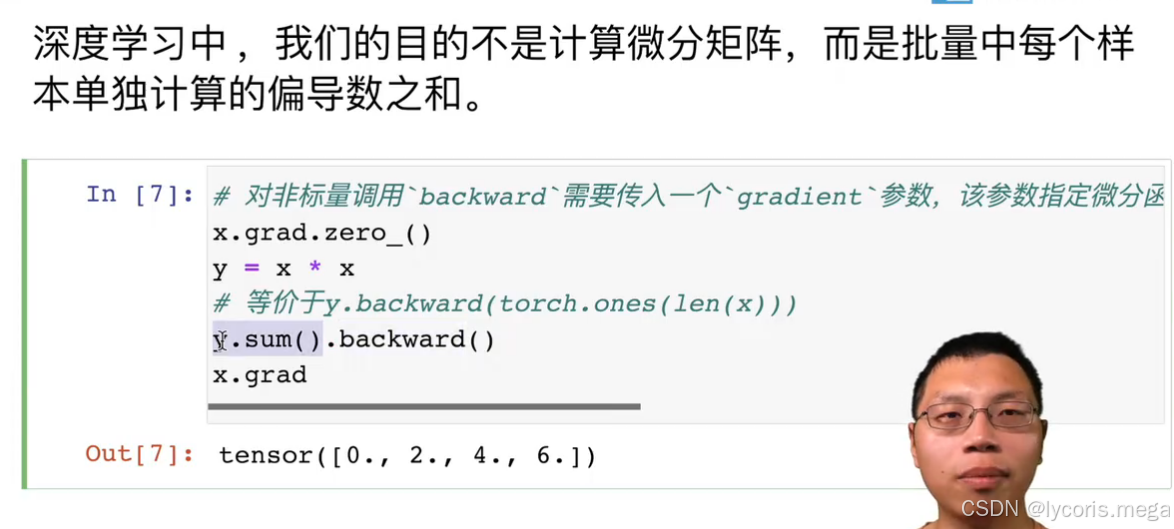
如果 y 不是标量,而是向量/矩阵,PyTorch 不知道你想要哪个方向的梯度,需要你提供一个 “外部梯度” gradient,或者先把它变成标量(常用 sum())。
3.1 用 sum() 变成标量(最常用)
x = torch.arange(4.0, requires_grad=True)  # [0,1,2,3]
y = x * x                                  # 向量

y.sum().backward()                         # 对 sum(y) 求导
print(x.grad)                              # d/dx sum(x^2) = 2x -> [0,2,4,6]
3.2 直接传入外部梯度(理解用)
x = torch.arange(4.0, requires_grad=True)
y = x * x

v = torch.tensor([1.0, 0.1, 0.01, 0.001])   # 外部梯度(相当于加权求和)
y.backward(v)

print(x.grad)  # = v * 2x
直觉:y.backward(v) 相当于对 (\sum_i v_i y_i) 求导。
4. 梯度会累加:必须清零(非常重要)
这是训练时最容易踩的大坑:梯度默认是累加的。
x = torch.tensor(2.0, requires_grad=True)

y = x * x
y.backward()
print(x.grad)  # 4

y = x * x
y.backward()
print(x.grad)  # 8  (累加了!)
训练循环里你必须做:
-
param.grad.zero_()或 -
optimizer.zero_grad()
简化写法(自己写参数时):
x = torch.tensor(2.0, requires_grad=True)

for _ in range(3):
    y = x * x
    y.backward()
    print(x.grad.item())
    x.grad.zero_()
5. detach():切断计算图(让某个张量不再追踪梯度)
有时你希望把某个中间结果当“常量”用,不想让梯度穿过去,就要 detach()。
x = torch.tensor(3.0, requires_grad=True)
y = x * x

u = y.detach()      # u 不在计算图里
z = u * x

z.backward()
print(x.grad)       # dz/dx = u = x^2 = 9(没有 y 对 x 的那条梯度链)
直觉:detach() 就是“把它从图里拽出来”。
6. torch.no_grad():推理/评估时关闭梯度,省显存省时间
训练需要梯度;推理不需要。推理时建议包起来:
x = torch.randn(3, requires_grad=True)

with torch.no_grad():
    y = x * 2
    # y.requires_grad = False
典型场景:
-
验证集评估
-
预测
-
保存中间结果但不想建图
7. 更贴近“模型训练”的例子:对向量参数求导
线性回归会遇到这种形式:(y = Xw),对 (w) 求导。
X = torch.tensor([[1.0, 2.0],
                  [3.0, 4.0]])           # (2,2)
w = torch.tensor([[2.0],
                  [1.0]], requires_grad=True)  # (2,1)

y_hat = X @ w                            # (2,1)
loss = y_hat.sum()                       # 变成标量
loss.backward()

print(w.grad)  # = X^T @ 1  -> 每列求和的形式
这里你能直观看到:梯度就是线性代数结构的体现,后面学反向传播会更顺。
8. 本节最常见坑
-
忘了
requires_grad=True
→grad永远是 None -
对非标量直接
backward()报错
→ 用sum()/mean()变标量,或传gradient -
忘了清梯度,导致训练“越训越离谱”
→ 每步更新前zero_grad -
推理还在建图,显存飙升
→ 用torch.no_grad() -
想断开梯度但没断开
→ 用.detach()或with torch.no_grad()
小结:你现在应该能做到什么?
-
写出
loss.backward()并读懂param.grad -
理解“梯度累加”和“清零”
-
知道什么时候用
detach()/no_grad() -
明白:训练就是“算梯度 → 更新参数”的循环
更多推荐

 5
 0
- 0


 已为社区贡献101条内容

所有评论(0)