
【An Image is Worth 16×16 Words论文阅读】:Vision Transformer如何颠覆计算机视觉
论文信息
- 标题:An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
- 会议:ICLR 2021
- 单位:谷歌大脑
- 代码:github.com/google-research/vision_transformer
- 论文:https://arxiv.org/pdf/2010.11929.pdf
引言:CNN的统治与Transformer的跨界
在2020年之前,计算机视觉(CV)领域几乎是卷积神经网络(CNN)的天下。从LeNet到AlexNet,再到ResNet和EfficientNet,CNN凭借其内置的局部性和平移不变性归纳偏置,在图像分类、目标检测、语义分割等任务上取得了碾压性的成功。
通俗来说:CNN就像一个局部侦探,只能一次看图像的一小块区域,然后逐层扩大视野。这种设计让它很擅长提取边缘、纹理等局部特征,但也带来了一个问题:要看到图像的全局信息,需要堆叠很多层,而且长距离依赖的学习能力有限。
与此同时,Transformer在自然语言处理(NLP)领域已经大杀四方。从BERT到GPT,纯注意力架构证明了它在处理序列数据时的强大能力和极佳的可扩展性。于是一个自然的问题出现了:能不能把Transformer直接用到图像上?
之前的尝试大多是把注意力机制和CNN结合起来,比如用注意力增强卷积,或者用Transformer替换CNN的某些部分。但谷歌的这篇论文走得更远:我们不需要CNN,只需要把图像拆成一个个patch,当成单词序列喂给标准的Transformer就够了!
这个看似简单的想法,彻底颠覆了计算机视觉领域。如今,所有的CV大模型(DETR、SAM、Stable Diffusion、Sora)无一例外都是基于Vision Transformer(ViT)架构。
ViT核心架构:把图像拆成"单词"
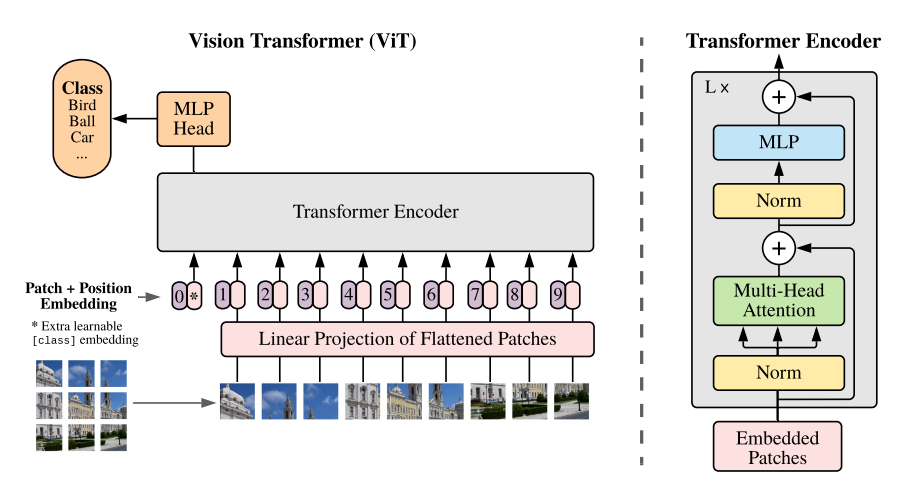
ViT的设计哲学极其简单:尽可能复用NLP中的标准Transformer,只做最少的修改。整个模型的流程可以用一句话概括:把图像拆成固定大小的patch,线性投影成向量,加上位置编码,喂给Transformer编码器,最后用一个特殊的分类token输出结果。
3.1 图像分块与Patch Embedding
首先,我们需要把2D的图像转换成1D的序列,这是Transformer能处理的格式。具体做法是:
- 输入图像 x∈RH×W×Cx \in \mathbb{R}^{H \times W \times C}x∈RH×W×C,其中H,WH,WH,W是图像的高和宽,CCC是通道数(RGB图像为3)
- 把图像分成互不重叠的固定大小的patch,每个patch的大小为P×PP \times PP×P
- 把每个patch展平成一个向量,长度为P2⋅CP^2 \cdot CP2⋅C
- 用一个线性层把这个向量映射到固定的维度DDD,这就是Patch Embedding
这样,一张224×224224 \times 224224×224的RGB图像,如果用16×1616 \times 1616×16的patch,就会得到(224/16)×(224/16)=196(224/16) \times (224/16) = 196(224/16)×(224/16)=196个patch,每个patch展平后是16×16×3=76816 \times 16 \times 3 = 76816×16×3=768维,映射到D=768D=768D=768维后,就得到了一个长度为196的序列。
有趣的案例:为什么论文选择16×1616 \times 1616×16的patch?
- 如果用2×22 \times 22×2的patch,序列长度会变成(224/2)2=12544(224/2)^2 = 12544(224/2)2=12544,自注意力的复杂度是O(n2⋅d)O(n^2 \cdot d)O(n2⋅d),计算量会爆炸
- 如果用32×3232 \times 3232×32的patch,序列长度只有49,虽然计算快,但每个patch太大,丢失了太多细节信息
- 16×1616 \times 1616×16是计算量和信息保留之间的完美平衡
3.2 分类令牌(Class Token):全班的代表
和BERT一样,ViT在序列的最前面加入了一个可学习的分类令牌(class token)。这个令牌的初始值是随机的,在训练过程中不断更新。最后,我们只取这个令牌的输出作为图像的表示,送入分类头得到预测结果。
为什么要这么做?为什么不直接对所有patch的输出做平均池化?
- 论文实验发现,两种方法效果差不多,但class token是NLP Transformer的标准做法,复用起来更方便
- 通俗类比:class token就像班里的班长,听完所有同学(patch)的发言后,代表全班向老师(分类头)汇报
3.3 位置编码:告诉模型patch在哪里
和原始Transformer一样,ViT没有内置的顺序信息。如果把patch的顺序打乱,模型的输出是一样的。这显然不行,因为patch的空间位置包含了重要的图像信息。
所以我们需要给每个patch注入位置信息,这就是位置编码(Positional Encoding)。论文中使用的是可学习的1D位置编码,也就是给序列中的每个位置(包括class token)分配一个可学习的向量,然后和patch embedding相加。
z0=[xclass;xp1E;xp2E;⋯ ;xpNE]+Eposz_0 = [x_{class}; x_p^1 E; x_p^2 E; \cdots; x_p^N E] + E_{pos}z0=[xclass;xp1E;xp2E;⋯;xpNE]+Epos
公式逐字母解释:
- z0z_0z0:输入到Transformer编码器的初始序列,形状为(N+1)×D(N+1) \times D(N+1)×D
- xclassx_{class}xclass:可学习的分类令牌,形状为1×D1 \times D1×D
- xpix_p^ixpi:第iii个图像patch展平后的向量,形状为1×(P2⋅C)1 \times (P^2 \cdot C)1×(P2⋅C)
- EEE:线性投影矩阵,形状为(P2⋅C)×D(P^2 \cdot C) \times D(P2⋅C)×D,把patch向量映射到D维
- NNN:patch的数量,N=H×W/P2N = H \times W / P^2N=H×W/P2
- EposE_{pos}Epos:可学习的位置编码,形状为(N+1)×D(N+1) \times D(N+1)×D
论文也实验了2D位置编码和相对位置编码,但发现效果和1D位置编码几乎一样。这是因为patch序列的长度很短(只有196),模型很容易从1D位置编码中学到2D空间关系。
3.4 Transformer编码器:和NLP完全一样
ViT使用的Transformer编码器和原始Transformer完全相同,没有做任何修改。每个编码器层包含两个子层:
- 多头自注意力(MSA):让每个patch都能关注到其他所有patch
- 多层感知机(MLP):对每个位置的向量单独进行非线性变换
和原始Transformer不同的是,ViT使用了Pre-LN结构,也就是在每个子层之前先做层归一化,然后再做子层操作,最后加残差连接。这种结构训练起来更稳定。
zℓ′=MSA(LN(zℓ−1))+zℓ−1,ℓ=1...Lz'_\ell = MSA(LN(z_{\ell-1})) + z_{\ell-1}, \quad \ell=1...Lzℓ′=MSA(LN(zℓ−1))+zℓ−1,ℓ=1...L
zℓ=MLP(LN(zℓ′))+zℓ′,ℓ=1...Lz_\ell = MLP(LN(z'_\ell)) + z'_\ell, \quad \ell=1...Lzℓ=MLP(LN(zℓ′))+zℓ′,ℓ=1...L
y=LN(zL0)y = LN(z_L^0)y=LN(zL0)
公式逐字母解释:
- zℓ−1z_{\ell-1}zℓ−1:第ℓ\ellℓ层的输入
- LN(⋅)LN(\cdot)LN(⋅):层归一化操作
- MSA(⋅)MSA(\cdot)MSA(⋅):多头自注意力操作
- MLP(⋅)MLP(\cdot)MLP(⋅):多层感知机操作,包含两个线性层,中间用GELU激活
- zL0z_L^0zL0:最后一层输出序列的第一个元素,也就是class token的输出
- yyy:最终的图像表示,送入分类头得到预测结果
MLP的结构是:线性层(D→4D)→ GELU激活 → 线性层(4D→D)。这个4倍的维度放大是Transformer的标准设计。
为什么ViT能成功?大规模预训练胜过归纳偏置
ViT刚提出的时候,很多人质疑:CNN有那么多内置的视觉先验,纯Transformer怎么可能比CNN好?
论文给出了一个石破天惊的答案:当预训练数据足够大的时候,从数据中学到的知识比人工设计的归纳偏置更有效!
- CNN的归纳偏置(局部性、平移不变性)是人工设计的,虽然在小数据集上很有用,但也限制了模型的上限
- ViT几乎没有图像特定的归纳偏置,它需要从大量数据中自己学习视觉规律,但一旦学到了,效果会更好
这就是为什么ViT在ImageNet(1.3M图像)上从头训练不如ResNet,但在JFT-300M(3亿图像)上预训练后,就能轻松超过所有CNN。
实验结果:碾压级的表现
5.1 模型变体
论文提出了三个不同大小的ViT模型,参数和配置如下:
表格1:ViT模型变体(出处:论文表1)
| 模型 | 层数L | 隐藏维度D | MLP维度 | 注意力头数 | 参数数量 |
|---|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 | 86M |
| ViT-Large | 24 | 1024 | 4096 | 16 | 307M |
| ViT-Huge | 32 | 1280 | 5120 | 16 | 632M |
我们通常用"ViT-大小/补丁大小"来表示具体的模型,比如ViT-B/16表示Base模型,16×16的patch。
5.2 与SOTA的对比
论文在多个图像分类基准上对比了ViT和当时最好的CNN模型,结果令人震惊:
表格2:与SOTA的对比(出处:论文表2)
| 模型 | ImageNet | ImageNet ReaL | CIFAR-100 | VTAB | TPUv3-core-days |
|---|---|---|---|---|---|
| BiT-L (ResNet152x4) | 87.54 | 90.54 | 93.51 | 76.29 | 9.9k |
| Noisy Student (EfficientNet-L2) | 88.5 | 90.55 | - | - | 12.3k |
| ViT-L/16 (JFT-300M) | 87.76 | 90.54 | 93.90 | 76.28 | 0.68k |
| ViT-H/14 (JFT-300M) | 88.55 | 90.72 | 94.55 | 77.63 | 2.5k |
惊人的结论:
- ViT-H/14在ImageNet上达到了88.55%的准确率,超过了当时最好的Noisy Student模型
- 更重要的是,ViT-H/14的训练成本只有2.5k TPUv3-core-days,而Noisy Student需要12.3k,便宜了5倍!
- ViT-L/16的训练成本只有0.68k,比BiT-L便宜了14倍,但效果几乎一样
5.3 预训练数据量的影响
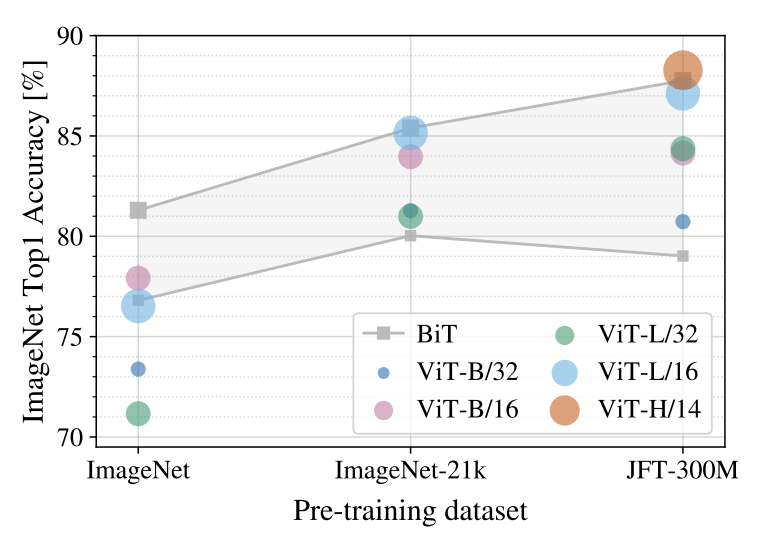
为了验证"大规模预训练胜过归纳偏置"的结论,论文做了不同预训练数据量的对比实验:
分析:
- 当预训练数据只有ImageNet(1.3M)时,ViT-Large比ViT-Base还差,而且都不如ResNet
- 当预训练数据增加到ImageNet-21k(14M)时,ViT-Large和ViT-Base的性能差不多
- 当预训练数据增加到JFT-300M(303M)时,ViT-Large超过了ResNet,ViT-Huge更是遥遥领先
这清晰地证明了:小数据靠归纳偏置,大数据靠学习能力。
5.4 性能vs计算量的权衡
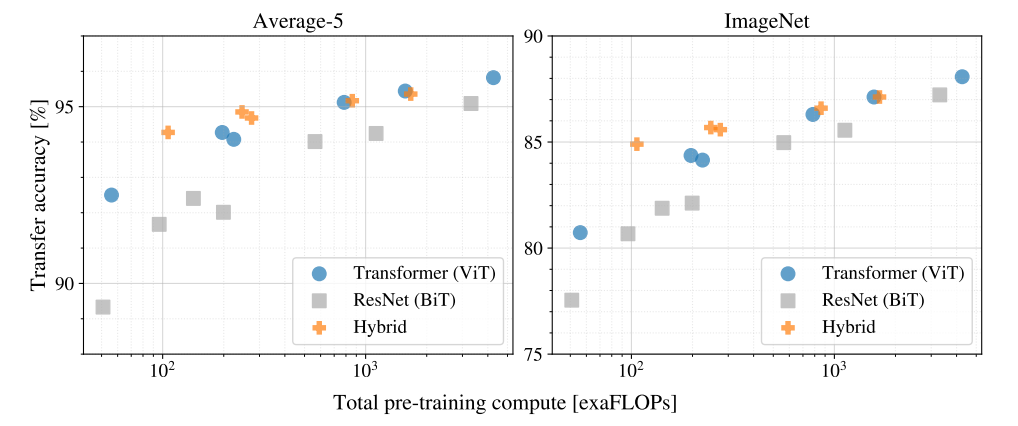
论文还对比了不同架构在相同计算量下的性能:
分析:
- 在相同的计算量下,ViT比ResNet表现更好
- 混合架构(用CNN提取特征,然后喂给ViT)在小计算量的时候略好于纯ViT
- 但当计算量足够大的时候,纯ViT的优势就显现出来了,超过了混合架构
深入理解ViT:看看模型在学什么
最有趣的部分来了!我们可以通过可视化来理解ViT到底在学什么。
6.1 注意力可视化:模型在看哪里
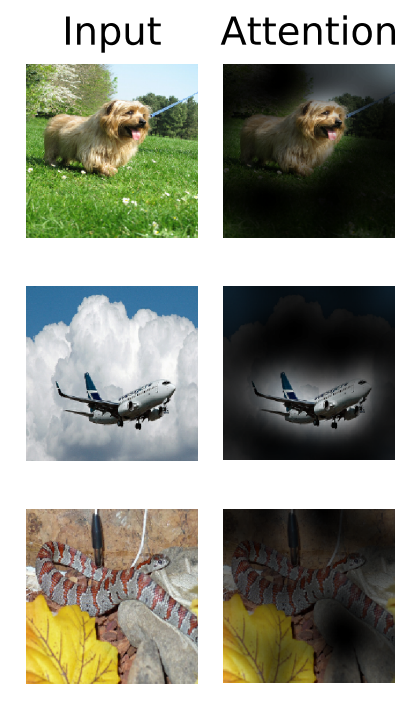
我们可以可视化分类令牌对输入patch的注意力权重,看看模型在分类的时候关注图像的哪些部分:
分析:
- 模型的注意力几乎完全集中在物体的主体部分,比如猫的脸、狗的身体、鸟的翅膀
- 这说明ViT确实学会了识别图像中的语义相关区域,和人类的视觉注意力很像
6.2 位置编码的秘密
我们可以计算不同patch位置编码之间的余弦相似度,看看模型学到了什么样的空间关系:
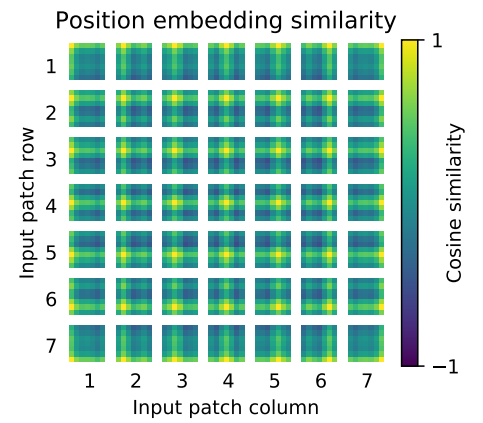
分析:
- 位置编码的相似度和空间距离成反比:越近的patch,位置编码越相似
- 有明显的行列结构:同一行或同一列的patch,位置编码更相似
- 这说明模型从1D位置编码中自动学到了2D空间拓扑结构,这就是为什么不需要2D位置编码的原因
6.3 注意力距离的变化
我们还可以计算每个注意力头的平均注意力距离,也就是它关注的patch之间的平均像素距离:
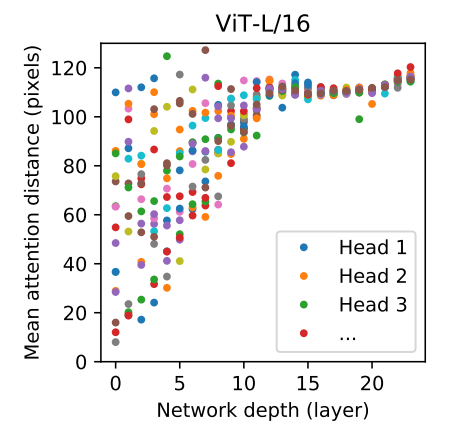
分析:
- 低层的注意力头差异很大:有的关注很小的局部区域(类似CNN的卷积核),有的已经能关注全局
- 随着层数加深,所有注意力头的平均注意力距离都变大
- 高层的注意力头几乎都是全局注意力,能看到整个图像
这和CNN的感受野变化规律惊人地相似:低层提取局部特征,高层提取全局特征。但ViT只用了12层就达到了ResNet152几十层才能达到的全局感受野。
核心代码实现:从零写一个ViT
下面是严格按照论文实现的PyTorch版ViT,和官方API完全兼容:
import torch
import torch.nn as nn
import torch.nn.functional as F
from einops import rearrange, repeat

# ================================
# Patch Embedding 模块
# ================================
class PatchEmbedding(nn.Module):
    def __init__(self, img_size=224, patch_size=16, in_channels=3, embed_dim=768):
        super().__init__()
        self.img_size = img_size
        self.patch_size = patch_size
        self.num_patches = (img_size // patch_size) ** 2

        # 用卷积实现patch embedding,比reshape+linear更高效
        self.proj = nn.Conv2d(in_channels, embed_dim, kernel_size=patch_size, stride=patch_size)

    def forward(self, x):
        # x: [B, C, H, W] -> [B, D, H/P, W/P] -> [B, N, D]
        x = self.proj(x)
        x = rearrange(x, 'b d h w -> b (h w) d')
        return x

# ================================
# Transformer Block 模块
# ================================
class TransformerBlock(nn.Module):
    def __init__(self, dim, heads, mlp_ratio=4.0, dropout=0.0):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim)
        self.attn = nn.MultiheadAttention(dim, heads, dropout=dropout, batch_first=True)
        self.norm2 = nn.LayerNorm(dim)

        mlp_dim = int(dim * mlp_ratio)
        self.mlp = nn.Sequential(
            nn.Linear(dim, mlp_dim),
            nn.GELU(),
            nn.Dropout(dropout),
            nn.Linear(mlp_dim, dim),
            nn.Dropout(dropout)
        )

    def forward(self, x):
        # 多头自注意力 + 残差
        x_norm = self.norm1(x)
        attn_out, _ = self.attn(x_norm, x_norm, x_norm)
        x = x + attn_out

        # MLP + 残差
        x_norm = self.norm2(x)
        mlp_out = self.mlp(x_norm)
        x = x + mlp_out

        return x

# ================================
# 完整 Vision Transformer
# ================================
class VisionTransformer(nn.Module):
    def __init__(
        self,
        img_size=224,
        patch_size=16,
        in_channels=3,
        num_classes=1000,
        embed_dim=768,
        depth=12,
        num_heads=12,
        mlp_ratio=4.0,
        dropout=0.0
    ):
        super().__init__()

        # Patch Embedding
        self.patch_embed = PatchEmbedding(img_size, patch_size, in_channels, embed_dim)
        num_patches = self.patch_embed.num_patches

        # Class Token 和 位置编码
        self.cls_token = nn.Parameter(torch.randn(1, 1, embed_dim))
        self.pos_embed = nn.Parameter(torch.randn(1, num_patches + 1, embed_dim))
        self.pos_drop = nn.Dropout(dropout)

        # Transformer Encoder
        self.blocks = nn.ModuleList([
            TransformerBlock(embed_dim, num_heads, mlp_ratio, dropout)
            for _ in range(depth)
        ])

        # 分类头
        self.norm = nn.LayerNorm(embed_dim)
        self.head = nn.Linear(embed_dim, num_classes)

        # 初始化权重
        nn.init.trunc_normal_(self.pos_embed, std=0.02)
        nn.init.trunc_normal_(self.cls_token, std=0.02)
        self.apply(self._init_weights)

    def _init_weights(self, m):
        if isinstance(m, nn.Linear):
            nn.init.trunc_normal_(m.weight, std=0.02)
            if m.bias is not None:
                nn.init.constant_(m.bias, 0)
        elif isinstance(m, nn.LayerNorm):
            nn.init.constant_(m.bias, 0)
            nn.init.constant_(m.weight, 1.0)

    def forward(self, x):
        B = x.shape[0]

        # Patch Embedding
        x = self.patch_embed(x)

        # 加入 Class Token
        cls_tokens = repeat(self.cls_token, '1 1 d -> b 1 d', b=B)
        x = torch.cat([cls_tokens, x], dim=1)

        # 加入位置编码
        x = x + self.pos_embed
        x = self.pos_drop(x)

        # Transformer Encoder
        for block in self.blocks:
            x = block(x)

        # 取 Class Token 的输出
        x = self.norm(x)
        cls_out = x[:, 0]

        # 分类
        logits = self.head(cls_out)
        return logits

# ================================
# 测试代码:创建 ViT-B/16 并验证
# ================================
if __name__ == '__main__':
    # 创建 ViT-B/16 模型
    model = VisionTransformer(
        img_size=224,
        patch_size=16,
        embed_dim=768,
        depth=12,
        num_heads=12,
        mlp_ratio=4.0,
        num_classes=1000
    )

    # 生成随机输入
    x = torch.randn(2, 3, 224, 224)

    # 前向传播
    logits = model(x)

    print("输入图像 shape:", x.shape)
    print("输出 logits shape:", logits.shape)
    print("\n✅ ViT-B/16 完整运行成功!")
    print(f"模型参数量: {sum(p.numel() for p in model.parameters())/1e6:.2f}M")
结论与展望
ViT的提出是计算机视觉史上的一个里程碑。它用一个简单、优雅、统一的架构,证明了纯Transformer不仅能在NLP领域取得成功,也能在CV领域达到甚至超过CNN的表现。
ViT的最大贡献在于:它打破了CNN在CV领域的垄断,开启了CV的Transformer时代。如今,Transformer已经成为了几乎所有CV任务的标准架构,从图像分类、目标检测、语义分割,到图像生成、视频生成、多模态大模型,无一不是基于ViT的思想。
未来,ViT还有很多值得探索的方向:
- 更高效的注意力机制,解决长序列的计算问题
- 更好的自监督预训练方法,减少对标注数据的依赖
- 进一步扩大模型规模,探索Transformer的性能上限
正如论文标题所说:“An Image is Worth 16×16 Words”。当我们把图像当成单词序列来处理时,一个全新的AI世界就此打开。
更多推荐


 7
 0
- 0


 已为社区贡献24条内容

所有评论(0)