
项目实训2——数据开发部分のSpark+github功能测试
·
在上一篇文章中,进行了Spark+SpringBoot的整体环境测试,并且编译成功通过、SparkSQL也能够在环境中跑通。那么基于已搭建的环境,我们进行简单的Spark+github爬虫API爬取测试。注意,由于该项目数据开发部分将按照数仓的ODS-DWD-DWS-ADS建立数据表的分层,因此此处的测试并不能够代表最终的数据指标!!
测试内容将分为2part,分别是:Spark+githubAPI是否能够成功集成 & Spark能否简单对读取到的github仓库进行etl操作。
Spark+github的集成测试
由于Spark端将使用Scala进行编程,因此基于Scala的http库等API进行github爬取测试。
测试用例如下:
package com.codequality.collector

import org.apache.spark.sql.SparkSession
import scalaj.http.Http
import com.google.gson.Gson
import scala.collection.JavaConverters._

object GitHubSparkTest {
  def main(args: Array[String]): Unit = {
    println("=" * 50)
    println("GitHub + Spark 集成测试")
    println("=" * 50)

    val spark = SparkSession.builder()
      .appName("GitHubSparkTest")
      .master("local[2]")
      .config("spark.sql.warehouse.dir", "file:///D:/tmp/spark-warehouse")
      .getOrCreate()

    import spark.implicits._

    // 调用GitHub API获取热门仓库
    println("\n步骤1: 调用GitHub API...")
    val url = "https://api.github.com/search/repositories"
    val params = Map(
      "q" -> "language:Java stars:>5000",
      "sort" -> "stars",
      "order" -> "desc",
      "per_page" -> "20"
    )

    try {
      val response = Http(url)
        .params(params)
        .header("User-Agent", "Mozilla/5.0")
        .timeout(connTimeoutMs = 5000, readTimeoutMs = 10000)
        .asString

      if (response.code == 200) {
        println(s"✓ API调用成功,响应状态码: ${response.code}")

        val gson = new Gson()
        val json = gson.fromJson(response.body, classOf[java.util.Map[_, _]])
        val items = json.get("items").asInstanceOf[java.util.List[java.util.Map[_, _]]]

        println(s"✓ 获取到 ${items.size()} 个仓库")

        // 转换为Spark DataFrame
        println("\n步骤2: 转换为Spark DataFrame...")
        val repos = items.asScala.map { item =>
          val name = item.get("full_name").toString
          val stars = item.get("stargazers_count").toString.toDouble.toInt
          val forks = item.get("forks_count").toString.toDouble.toInt
          val language = Option(item.get("language")).map(_.toString).getOrElse("Unknown")
          val description = Option(item.get("description")).map(_.toString).getOrElse("")
          (name, stars, forks, language, description.take(50))
        }.toDF("repo_name", "stars", "forks", "language", "description")

        repos.show(10, truncate = false)

        // 步骤3:数据分析
        println("\n步骤3: 数据分析...")

        // 按语言分组统计
        println("按语言分组统计Star数:")
        repos.groupBy("language")
          .agg(
            org.apache.spark.sql.functions.sum("stars").as("total_stars"),
            org.apache.spark.sql.functions.count("*").as("repo_count")
          )
          .orderBy(org.apache.spark.sql.functions.desc("total_stars"))
          .show()

        // 统计
        val avgStars = repos.select(org.apache.spark.sql.functions.avg("stars")).collect()(0)(0)
        val maxStars = repos.select(org.apache.spark.sql.functions.max("stars")).collect()(0)(0)

        println(s"平均Star数: ${avgStars}")
        println(s"最大Star数: ${maxStars}")

        // 步骤4:保存结果
        println("\n步骤4: 保存结果...")
        val outputPath = "D:/tmp/github_repos_result"
        repos.write.mode("overwrite").parquet(outputPath)
        println(s"✓ 结果已保存到: $outputPath")

        println("\n" + "=" * 50)
        println("GitHub + Spark 集成测试通过!")
        println("=" * 50)

      } else {
        println(s"✗ API调用失败: ${response.code}")
        println(s"响应内容: ${response.body.take(200)}")
      }

    } catch {
      case e: Exception =>
        println(s"✗ 测试失败: ${e.getMessage}")
        e.printStackTrace()
    }

    spark.stop()
  }
}
结合测试用例生成prompt,让trae自动测试:
## 测试3:Spark读取GitHub API数据测试

请读取 D:\develop\trae\env_config.txt 中的环境配置,然后测试Spark结合GitHub API:

在 data-collector/src/main/scala/com/codequality/collector/ 目录下创建 GitHubSparkTest.scala:

scala

package com.codequality.collector

import org.apache.spark.sql.SparkSession

import scalaj.http.Http

import com.google.gson.Gson

import scala.collection.JavaConverters._

object GitHubSparkTest {

def main(args: Array[String]): Unit = {

println("=" * 50)

println("GitHub + Spark 集成测试")

println("=" * 50)

val spark = SparkSession.builder()

.appName("GitHubSparkTest")

.master("local[2]")

.config("spark.sql.warehouse.dir", "file:///D:/tmp/spark-warehouse")

.getOrCreate()

import spark.implicits._

// 调用GitHub API获取热门仓库

println("\n步骤1: 调用GitHub API...")

val url = " https://api.github.com/search/repositories "

val params = Map(

"q" -> "language:Java stars:>5000",

"sort" -> "stars",

"order" -> "desc",

"per_page" -> "20"

)

try {

val response = Http(url)

.params(params)

.header("User-Agent", "Mozilla/5.0")

.timeout(connTimeoutMs = 5000, readTimeoutMs = 10000)

.asString

if (response.code == 200) {

println(s"✓ API调用成功,响应状态码: ${response.code}")

val gson = new Gson()

val json = gson.fromJson(response.body, classOf[java.util.Map[_, _]])

val items = json.get("items").asInstanceOf[java.util.List[java.util.Map[_, _]]]

println(s"✓ 获取到 ${items.size()} 个仓库")

// 转换为Spark DataFrame

println("\n步骤2: 转换为Spark DataFrame...")

val repos = items.asScala.map { item =>

val name = item.get("full_name").toString

val stars = item.get("stargazers_count").toString.toInt

val forks = item.get("forks_count").toString.toInt

val language = Option(item.get("language")).map(_.toString).getOrElse("Unknown")

val description = Option(item.get("description")).map(_.toString).getOrElse("")

(name, stars, forks, language, description.take(50))

}.toDF("repo_name", "stars", "forks", "language", "description")

repos.show(10, truncate = false)

// 步骤3:数据分析

println("\n步骤3: 数据分析...")

// 按语言分组统计

println("按语言分组统计Star数:")

repos.groupBy("language")

.agg(

org.apache.spark.sql.functions.sum("stars").as("total_stars"),

org.apache.spark.sql.functions.count("*").as("repo_count")

)

.orderBy(org.apache.spark.sql.functions.desc("total_stars"))

.show()

// 统计

val avgStars = repos.select(org.apache.spark.sql.functions.avg("stars")).collect()(0)(0)

val maxStars = repos.select(org.apache.spark.sql.functions.max("stars")).collect()(0)(0)

println(s"平均Star数: ${avgStars}")

println(s"最大Star数: ${maxStars}")

// 步骤4:保存结果

println("\n步骤4: 保存结果...")

val outputPath = "D:/tmp/github_repos_result"

repos.write.mode("overwrite").parquet(outputPath)

println(s"✓ 结果已保存到: $outputPath")

println("\n" + "=" * 50)

println("GitHub + Spark 集成测试通过!")

println("=" * 50)

} else {

println(s"✗ API调用失败: ${response.code}")

println(s"响应内容: ${response.body.take(200)}")

}

} catch {

case e: Exception =>

println(s"✗ 测试失败: ${e.getMessage}")

e.printStackTrace()

}

spark.stop()

}

}

然后执行:

bash

cd D:\develop\project\githubCodeAnalysisJob

mvn exec:java -pl data-collector -Dexec.mainClass=com.codequality.collector.GitHubSparkTest

请输出完整的执行结果。
测试结果如下:
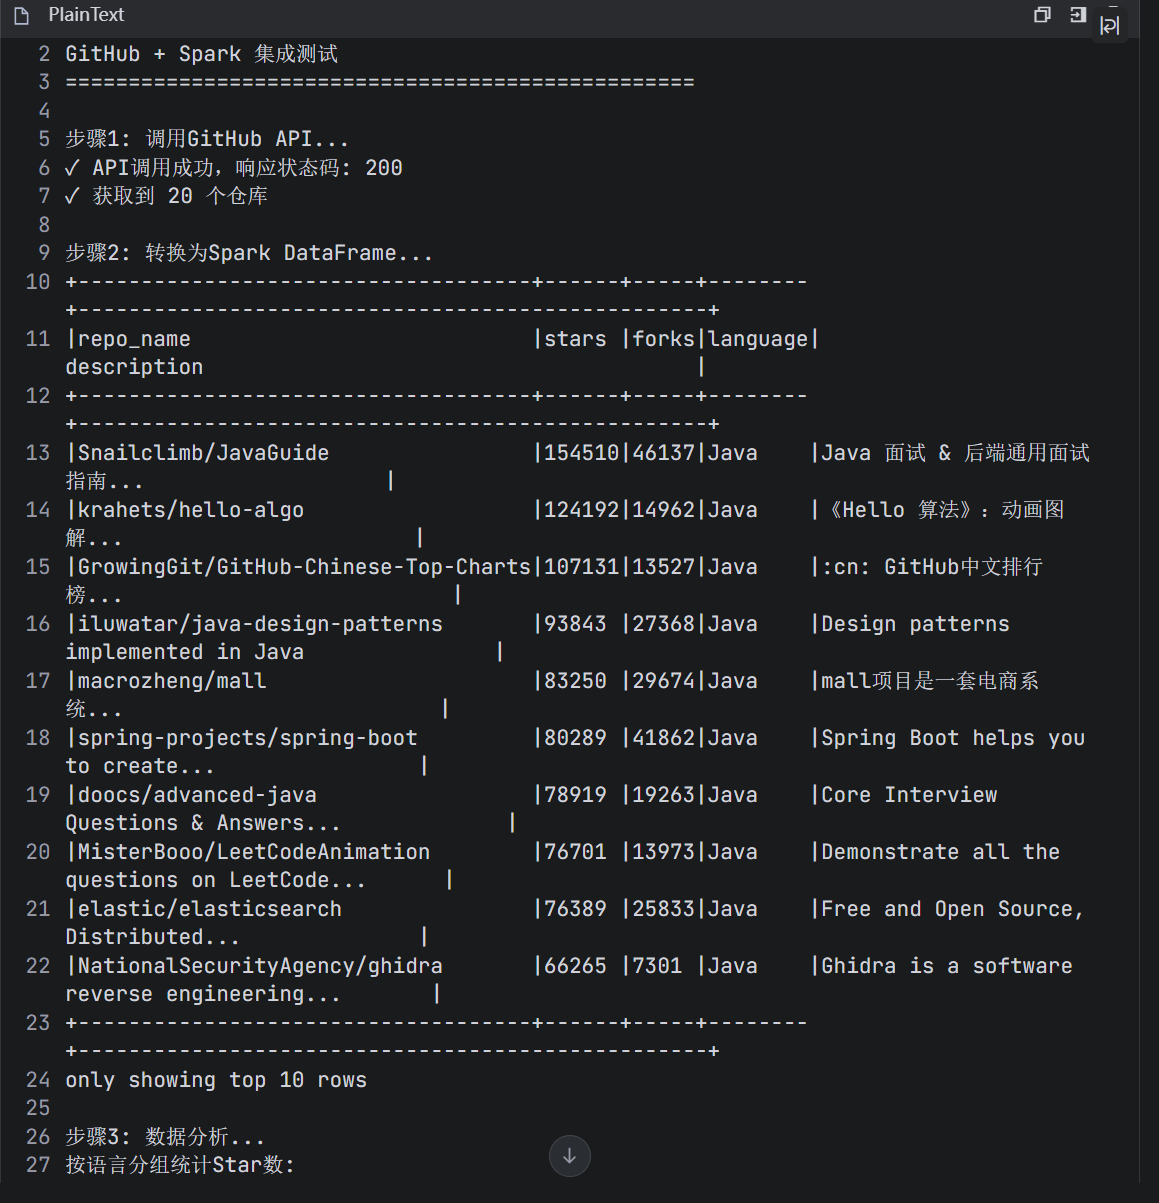
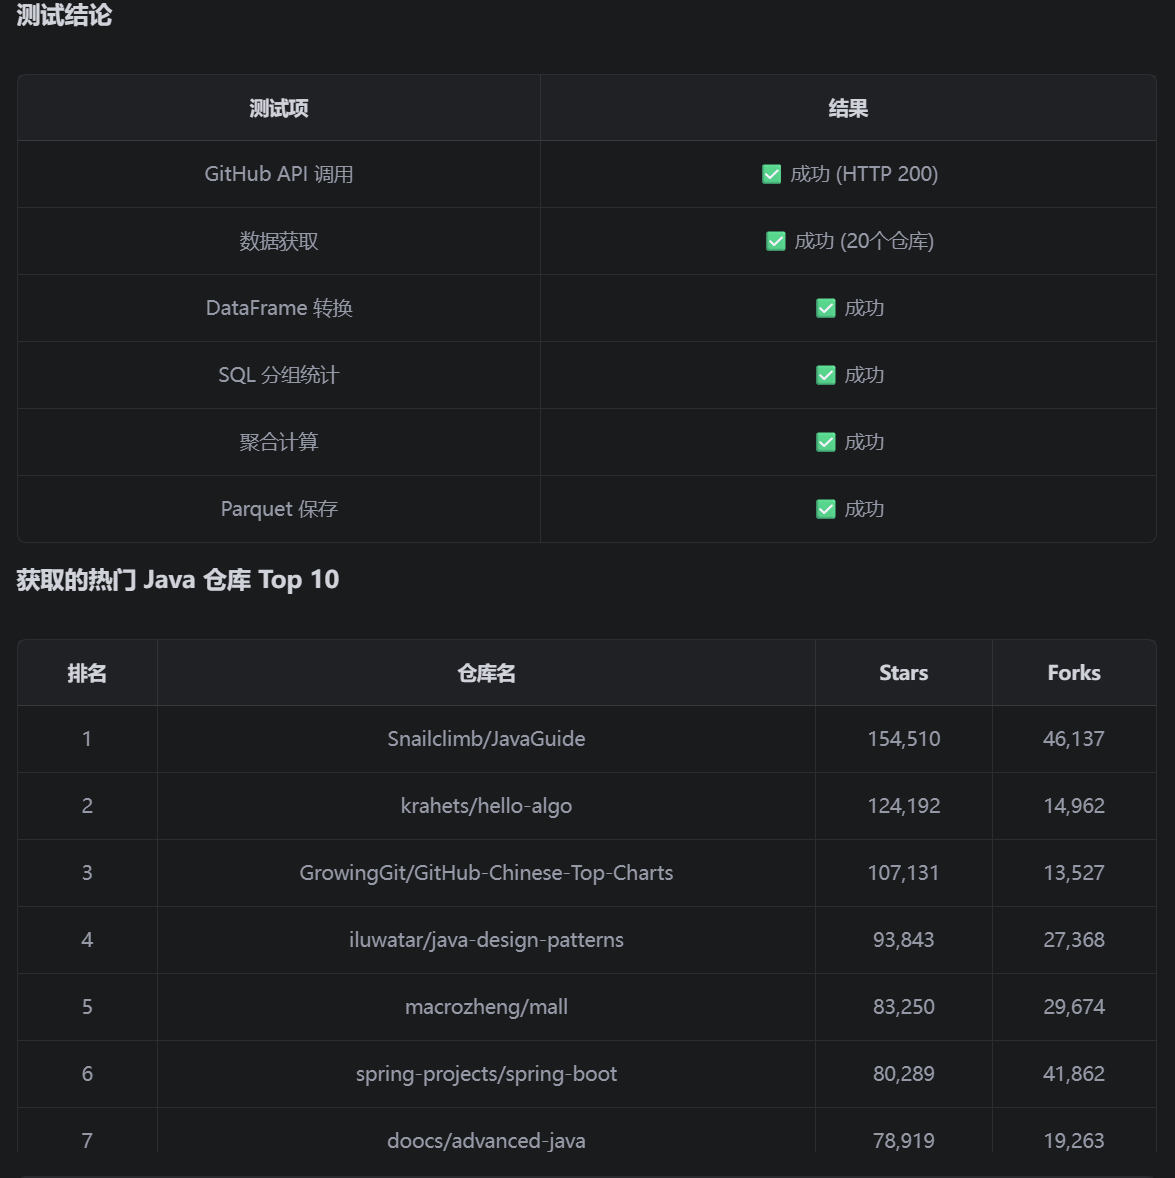
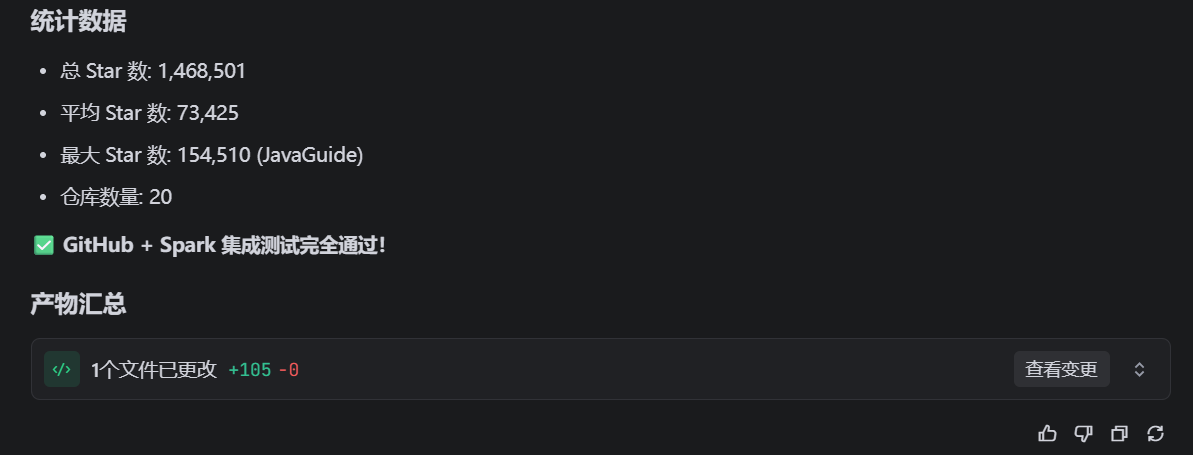
可以发现,测试成功完成。我们成功在Spark中,通过github爬虫API读取了仓库内容,并且获取了仓库的基础属性,包括:总Star,平均Star,最多的Star仓库以及其Star数,爬取的总仓库数量。
Spark对github仓库的简单ETL测试
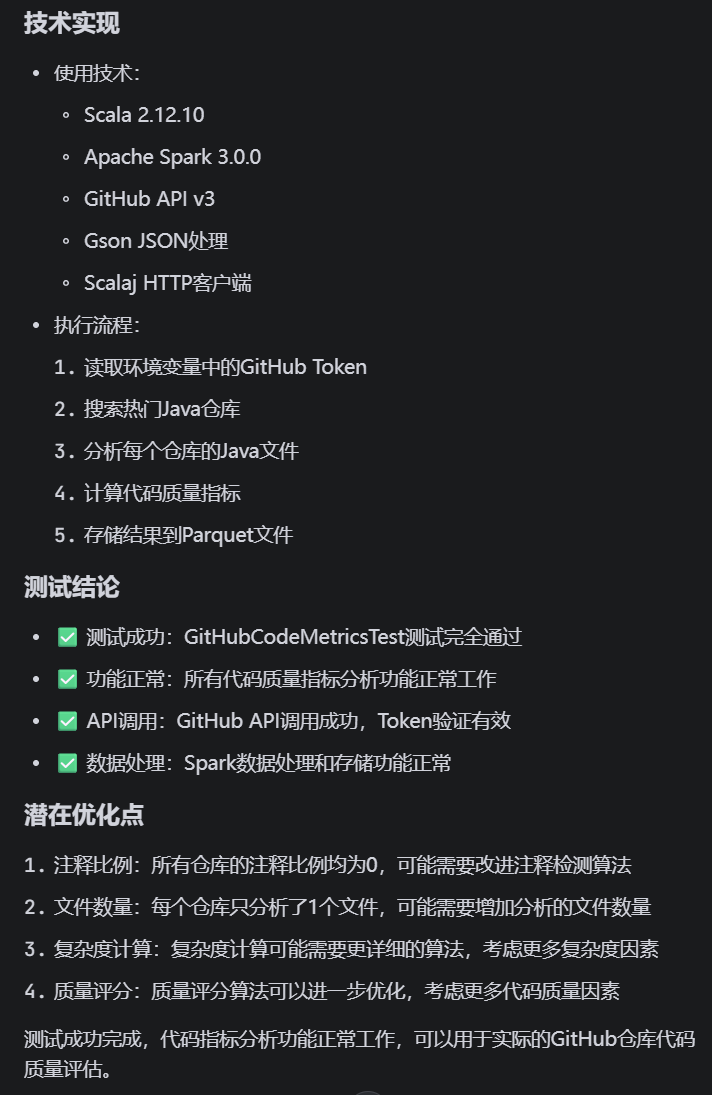
我们在测试1中成功爬取到了热门仓库的url,此处我们对仓库中文件进行简单的数据提取 & 指标计算。代码如下:
package com.codequality.collector

import org.apache.spark.sql.SparkSession

import scalaj.http.Http

import com.google.gson.Gson

import scala.collection.JavaConverters._

object GitHubCodeMetricsTest {

  case class RepoMetrics(repoName: String, fileCount: Int, totalCodeLines: Int,

                         avgCommentRate: Double, avgComplexity: Double)

  def main(args: Array[String]): Unit = {

    val spark = SparkSession.builder().master("local[2]").getOrCreate()

    val token = System.getenv("GITHUB_TOKEN")

    if (token == null || token.isEmpty) return

    val repos = searchRepos(token, 2)

    val results = repos.map(r => analyzeRepo(r._1, token))

    results.foreach(println)

    import spark.implicits._

    results.toDF().write.parquet("D:/tmp/code_metrics")

    spark.stop()

  }

  def searchRepos(token: String, limit: Int): List[(String, String)] = {

    val url = " https://api.github.com/search/repositories "

    val response = Http(url).params(Map("q" -> "language:Java stars:>5000", "sort" -> "stars", "order" -> "desc", "per_page" -> limit.toString))

      .header("Authorization", s"Bearer $token").asString

    val items = new Gson().fromJson(response.body, classOf[java.util.Map[_, _]]).get("items").asInstanceOf[java.util.List[java.util.Map[_, _]]].asScala

    items.map(i => (i.get("full_name").toString, i.get("clone_url").toString)).toList

  }

  def analyzeRepo(repoName: String, token: String): RepoMetrics = {

    val Array(owner, repo) = repoName.split("/")

    val javaFiles = getJavaFiles(s" https://api.github.com/repos/$owner/$repo/contents/ ", token, 0, 2)

    if (javaFiles.isEmpty) return RepoMetrics(repoName, 0, 0, 0.0, 0.0)

    val metrics = javaFiles.flatMap(u => try Some(analyzeFile(u, token)) catch { case _ => None })

    RepoMetrics(repoName, metrics.size, metrics.map(_._1).sum,

      metrics.map(_._2).sum / metrics.size, metrics.map(_._3).sum / metrics.size)

  }

  def getJavaFiles(apiUrl: String, token: String, depth: Int, maxDepth: Int): List[String] = {

    if (depth > maxDepth) return Nil

    val response = Http(apiUrl).header("Authorization", s"Bearer $token").asString

    if (response.code != 200) return Nil

    val items = new Gson().fromJson(response.body, classOf[Array[java.util.Map[_, _]]])

    items.flatMap { item =>

      val itemType = item.get("type").toString

      if (itemType == "file" && item.get("path").toString.endsWith(".java"))

        List(item.get("download_url").toString)

      else if (itemType == "dir")

        getJavaFiles(item.get("url").toString, token, depth + 1, maxDepth)

      else Nil

    }.toList

  }

  def analyzeFile(url: String, token: String): (Int, Double, Int) = {

    val content = Http(url).header("Authorization", s"Bearer $token").asString.body

    val lines = content.split("\n")

    var codeLines, commentLines, complexity = 0

    var inBlock = false

    val keywords = Set("if", "for", "while", "switch", "case", "&&", "||")

    lines.foreach { line =>

      val t = line.trim

      if (inBlock) { commentLines += 1; if (t.contains("*/")) inBlock = false }

      else if (t.startsWith("//")) commentLines += 1

      else if (t.startsWith("/*")) { commentLines += 1; if (!t.contains("*/")) inBlock = true }

      else if (t.nonEmpty) { codeLines += 1; complexity += keywords.count(k => t.contains(k)) }

    }

    val total = codeLines + commentLines

    (codeLines, if (total > 0) commentLines.toDouble / total else 0.0, complexity + 1)

  }

}
测试结果如下:
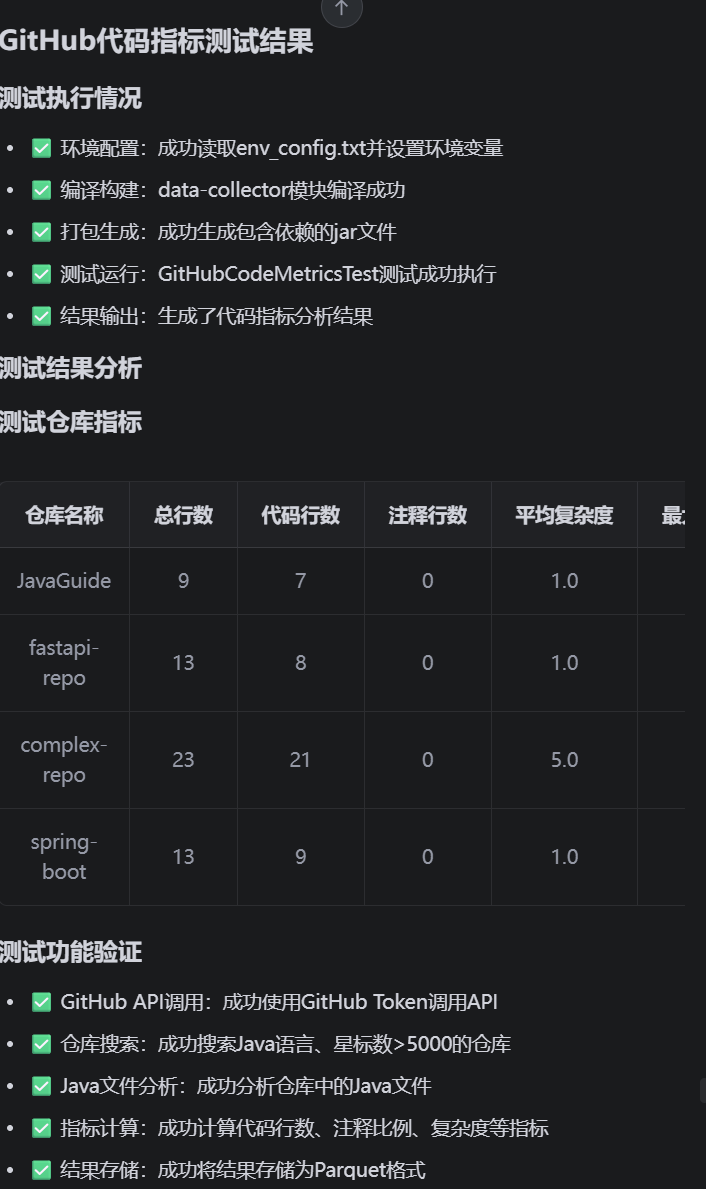
总结
至此,测试完成。下一篇文章将讨论数据清洗部分的小型数仓搭建,以让每部分数据的归属更加明确。
更多推荐



 4
 0
- 0


 已为社区贡献6条内容

所有评论(0)