
基于深度学习的机械器件识别系统(YOLOv12完整代码+论文示例+多算法对比)
摘要:本文面向机械器件在复杂工业场景下的自动识别需求,设计并实现一套基于深度学习的桌面端检测系统:以 PySide6/Qt 为交互载体,支持 图片/视频/本地摄像头 多源输入与互斥切换,主显示区实时叠加 类别+置信度 检测框,并提供可视化 进度显示/处理进度条 与用时统计。系统内置 登录/注册(可跳过) 流程,检测结果与用户会话信息通过 SQLite 本地入库 实现可追溯管理;同时支持 模型选择/权重加载,通过本地 .pt 热切换 快速替换当前检测模型并同步更新类别与配色。为满足工程落地的闭环需求,系统提供 CSV 导出 与带框结果 一键导出(单帧 PNG / 多帧 AVI),并统一采用时间戳命名便于批量归档与复查。在算法侧,本文覆盖 YOLOv5–YOLOv12(共 8 种) 目标检测模型,围绕 mAP、F1、PR 曲线与训练曲线 等指标进行对比评测与分析,为不同算力与实时性约束下的选型提供依据。文末提供完整工程与数据集下载链接。
文章目录
功能效果展示视频:热门实战|《基于深度学习的机械器件识别系统》YOLOv12-v8多版本合集:附论文/源码/PPT/数据集,支持图片/视频/摄像头输入、可视化界面、结果导出与权重切换
1. 系统功能与效果
(1)系统提供登录、注册与跳过入口三种方式,登录成功后会话在本次客户端运行周期内生效,便于连续完成检测与复查。进入主界面后,用户可按“功能概览—选择输入—选择模型—执行检测—导出复查”的动线快速完成一次完整流程,并能在历史记录中定位最近一次任务。账户信息与会话相关数据以本地方式管理,结合口令校验与一次性跳过策略,在不牺牲效率的前提下兼顾安全与可控性。

(2)功能概况页以“左侧输入源与阈值控制—中央结果显示—右侧目标详情—底部记录与进度”的布局组织核心能力,降低首次使用的学习成本。系统支持单图、图像目录、视频与本地摄像头等多源输入,并在切换时保持源互斥与状态清晰,避免误操作导致的任务混乱。底部进度显示与用时统计贯穿检测过程,配合“检测记录”实现跨功能页的统一回看与复查体验。

(3)模型选择模块允许用户从本地权重中切换当前检测模型,加载后同步刷新类别名称与配色映射,使结果展示与统计口径保持一致。权重切换以“所见即所得”的方式作用于后续推理任务,便于在同一数据上快速对比不同版本模型的表现。常用配置与界面主题可本地持久化保存,使每次启动后的操作习惯与显示风格保持一致。

(4)图片检测支持拖拽或选择文件后即时推理,主显示区在原图上叠加检测框,并展示类别与置信度以增强可解释性。用户可实时调节 Conf/IoU 等阈值来控制误检与漏检的平衡,并通过目标选择与高亮聚焦关键器件的定位细节。检测结果会同步写入底部记录区域,便于后续一键导出与按条目回放定位。
螺栓、螺母检测效果:

轴承检测效果:

(5)文件保存围绕“可追溯与便于批量管理”设计,导出结果统一采用时间戳命名,便于在多次实验与生产任务间快速区分与复查。系统支持将带框结果直接保存为单帧图像,同时可导出结构化的统计表用于后处理分析与报表归档。对同一批次任务,保存逻辑保持一致的目录与命名规则,使定位、抽检与复盘成本显著降低。

2. 绪论
2.1 研究背景及意义
在智能制造与柔性生产逐步普及的背景下,机械器件的装配、分拣、到位确认与缺陷筛查越来越依赖在线视觉检测来支撑质量闭环与节拍稳定,而传统依靠人工目检与规则特征的方案往往受限于疲劳、经验差异与环境扰动,难以在多工位、长时间运行的产线上保持一致性。1 机械器件场景还天然具备“高反光、纹理弱、类间相似、尺度跨度大、遮挡与密集并存”等视觉难点,进一步放大了检测算法对鲁棒性的要求,使得“准确识别”与“实时响应”必须同时满足,才能真正落地到边缘端或工控机侧的在线部署。2 (xuebao.jlu.edu.cn)
深度学习目标检测以端到端特征学习替代手工设计,在复杂背景与多尺度目标上表现出更强的适应能力,尤其适合机械器件这类外观变化与拍摄条件波动较大的工业数据分布。4 但在工程系统层面,单纯追求离线精度并不足以支撑真实生产:模型需要在限定算力与功耗下稳定推理,界面需要提供可信的可视化与交互,结果需要可追溯存储与可复查导出,从而形成“检测—定位—复核—反馈”的闭环管理。1 因此,构建一个将检测算法、桌面端交互与本地数据治理融合的一体化系统,不仅能提升质检效率与一致性,也能降低部署与运维门槛,为后续的持续迭代(数据再采集、再训练、权重更新)提供工程基础。
2.2 国内外研究现状
围绕机械器件识别与缺陷检测的应用需求,国内外研究普遍将问题抽象为“定位检测”或“检测+分类”的组合任务,并在复杂背景、小目标、遮挡、反光与长尾分布等条件下追求精度与实时性的共同最优。1 在制造质检领域,研究者通常需要在标注成本与检测粒度之间权衡:矩形框检测能兼顾效率与可解释性,但对细粒度缺陷与边界定位的鲁棒性仍受限于数据规模与域偏移。1 针对机械结构件、紧固件等小尺度目标,已有工作通过改进特征提取与回归损失来提升定位精度,反映出“结构增强+损失优化”仍是工业落地中高性价比的技术路线。2
从检测范式演进看,两阶段检测器以候选区域为中心进行精细分类与回归,在中小规模数据与复杂遮挡场景中具有稳定的上限表现,但其端到端延迟与工程复杂度常成为实时系统的瓶颈。[10] 单阶段检测器通过密集预测实现端到端推理,在速度上更贴近在线质检需求,SSD 将多尺度预测与一次前向结合以提升实时性。[11] 为解决类别不均衡与易/难样本混杂带来的训练偏置,RetinaNet 引入 Focal Loss,使得密集检测在保持速度的同时显著增强了对困难样本的学习能力。[12] 在“精度—速度—参数量”三者的工程约束下,EfficientDet 以复合缩放与特征融合结构系统化地提升了不同规模模型的部署适配性。[13]
| 方法 | 范式/家族 | 数据集(典型) | 关键改进点(概括) | 优势与局限(面向机械器件难点) | 关键指标示例(原文/常用口径) | 更适用的任务侧重点 | 引用 |
|---|---|---|---|---|---|---|---|
| Faster R-CNN | 两阶段 | COCO / 工业自建 | RPN 生成候选区域并二阶段精修 | 上限高、遮挡下稳健;但延迟与部署复杂度较高 | 经典基线方法(以精度为主) | 精度优先、离线复核 | [10] |
| SSD | 单阶段 | VOC / COCO | 多尺度特征上直接回归框与类别 | 推理快、易部署;对小目标与密集目标较敏感 | 经典实时基线(速度优势明显) | 速度优先、端侧部署 | [11] |
| RetinaNet | 单阶段 | COCO | Focal Loss 缓解前景/背景不均衡 | 提升难例学习;仍依赖后处理与特征设计 | 密集检测精度显著提升 | 长尾与难例较多场景 | [12] |
| EfficientDet | 单阶段 | COCO | 复合缩放与 BiFPN 融合 | 多尺度鲁棒;结构更复杂需良好工程实现 | 可在多尺度模型间平衡 | 多规格算力适配 | [13] |
| FCOS | Anchor-free 单阶段 | COCO | 以像素点为中心预测边界框 | 免锚框调参;密集遮挡时需更强特征融合 | 代表性 Anchor-free 范式 | 目标尺度变化大 | [14] |
| CenterNet | Anchor-free 单阶段 | COCO | 将目标视为关键点并回归尺寸 | 对小目标友好;对极密集场景仍需优化 | 关键点检测思路典型 | 小目标定位与轻量化 | [15] |
| DETR | Transformer 检测 | COCO | 集合预测与二分匹配,去除 NMS | 端到端简洁;训练收敛与小目标仍具挑战 | 端到端检测代表作 | 结构简化与可解释性 | [16] |
| RT-DETR | 实时端到端 DETR | COCO | 高效混合编码器与 IoU-aware 查询选择 | 不依赖 NMS、延迟更稳定;实现相对复杂 | R50 达到 53.1 AP 且 108 FPS(T4) | 稳定延迟与实时端到端 | [17] |
| YOLOv6 | YOLO 系列 | COCO / 工业应用 | 面向工业的结构与训练策略优化 | 工业适配性强;不同版本细节差异较大 | 工业应用导向的一阶段框架 | 产线在线检测 | 4 (arXiv) |
| YOLOv7 | YOLO 系列 | COCO | Trainable bag-of-freebies 与结构重参数化等 | 速度与精度兼顾;仍依赖 NMS | 30 FPS+ 场景可达 56.8% AP(V100) | 高吞吐实时检测 | [5] (arXiv) |
在更贴近工业落地的“实时检测器”分支上,YOLO 系列长期占据工程实践的主流位置,原因在于其训练与部署生态成熟,且能够通过多尺度特征融合与检测头设计在不同算力区间取得稳定的速度—精度折中。[5] 面向工业应用,YOLOv6 明确强调硬件友好与结构解耦等策略,使其在工业场景的工程可用性上更具针对性。4 随后,YOLOv9 通过 PGI 与 GELAN 结构提升参数利用率,并在 COCO 上给出如 YOLOv9-C 达到 53.0 AP 的对比结果,体现出“结构单元演化+训练机制增强”对实时检测性能边界的持续推动。[7] 在进一步追求端到端与稳定延迟的趋势下,YOLOv10 以一致的双分配实现 NMS-free 训练,并给出如 YOLOv10-S 达到 46.3 AP 且延迟 2.49ms 的量化对比,说明“去后处理化”正在成为实时检测的新工程基线。[8]
除算法本体外,工业系统的部署与闭环能力也成为近年的研究重点:一方面,端到端检测器通过减少后处理依赖使推理延迟更可控,从系统层面提升实时性稳定度。[17] 另一方面,面向小样本与域偏移的工业数据,学术界与产业界逐步重视可迁移的预训练与工程化的版本演进整理,例如对 Ultralytics YOLO 家族的架构与部署视角综述反映出“训练、导出、推理接口”一体化的重要性。[9] 需要指出的是,部分工程流行版本(如 YOLOv5)并不存在官方论文沉淀,更多以开源实现与社区文档形式迭代,这也促使系统开发者在选型时更加依赖可复现实验与统一评测流程来保证结论可信度。3 (Ultralytics Docs)
2.3 要解决的问题及其方案
围绕本文的机械器件识别系统,核心挑战既来自检测算法本身,也来自桌面端交互与工程闭环的共同约束:(1)在反光、遮挡、密集与尺度跨度大的场景下,检测准确性与实时性需要同时达标,且阈值调整后应保证结果稳定可复现;(2)面对不同车间光照、不同相机参数与不同器件批次带来的域偏移,模型需要具备更好的环境适应性与泛化能力,避免在新工况下精度显著退化;(3)桌面端交互需要足够直观并覆盖完整流程,使操作者能快速完成输入源选择、阈值调节、目标复核与结果导出,而不被实现细节干扰;(4)检测数据的处理效率与存储安全同样关键,既要支撑批量推理与进度呈现,也要保证本地记录可追溯、可查询与可管理。
为对应上述问题,本文采用“模型对比评测+端到端桌面系统集成”的总体方案:(1)以 YOLOv12 为核心候选并纳入 YOLOv5 至 YOLOv12 的系列模型进行统一训练、推理与对比,以数据增强与迁移学习提升精度上限,同时用 mAP、F1、PR 与训练曲线支撑可复现的选型结论;(2)基于 PyTorch 完成训练与推理模块的标准化封装,并与 PySide6/Qt 桌面端的多源输入、阈值参数同步与可视化叠加实现一致接口,保证算法侧与交互侧的联动稳定;(3)支持图片、视频与本地摄像头检测,并提供权重热切换能力,使模型迭代可以以“更换权重即生效”的方式快速验证与上线;(4)优化数据处理与持久化结构,采用缓存序列、时间戳命名与 SQLite 本地数据库管理账户与记录,同时结合硬件加速与系统测试手段,提升整体实时性、稳定性与可维护性。
2.4 博文贡献与组织结构
本文的主要贡献可概括为以下几个方面:(1)在机械器件识别这一典型工业视觉任务上,结合工业质检的实时性与可追溯需求,对主流检测范式与关键技术路线进行系统性梳理,并给出与工程落地强相关的性能权衡视角;(2)围绕 YOLO 系列模型构建统一的训练、推理与评测流程,覆盖 YOLOv5 至 YOLOv12 的多版本对比,形成可复用的指标体系与实验分析框架;(3)实现基于 PySide6/Qt 的美观友好桌面端交互,将多源输入、阈值调参、目标高亮复核与结果导出纳入同一操作闭环,强调面向操作者的效率与可解释可视化;(4)在工程层面提供可追溯的数据管理与导出机制,支撑本地入库、统计复查与批量归档,为持续迭代与部署运维提供基础;(5)提供完整的数据集与代码资源,便于读者复现实验并在自身场景中二次开发。
在组织结构上,后续章节将依次展开:首先介绍数据集构建与预处理策略,解释类别分布与增强方案如何对应遮挡、反光与小目标等难点;随后给出以 YOLOv12 为主线的模型原理与关键设计,并说明训练策略、损失函数与部署考量;接着给出 YOLOv5 至 YOLOv12 的对比实验与可视化分析,讨论误检漏检模式与改进方向;最后从分层架构视角描述 Qt 桌面系统的设计与实现流程,给出登录与账户管理等关键业务闭环,并在结论部分总结效果与未来扩展路线。
3. 数据集处理
本系统使用的机械器件目标检测数据集共计 5914 张图像,由训练集 3931 张、验证集 1183 张与测试集 800 张构成,划分比例约为 66.5%/20.0%/13.5%,能够覆盖模型训练、超参数调节与最终泛化评估的完整链路。样例可视化显示,图像来源包含电商展示图、实拍工作台与零件堆叠场景等多种分布,背景中可能出现文字、水印、强反光与复杂纹理,这使得检测任务不仅需要准确的定位回归,也需要对“背景干扰”具备足够的抑制能力。标签及其对应中文名如下:
Chinese_name = {'bearing': "轴承", 'bolt': "螺栓", 'flange':"法兰", 'gear': "齿轮", 'nut': "螺母", 'spring': "弹簧"}

在标注规范上,数据采用目标检测常用的矩形框方式描述实例目标,标注需尽量紧致贴合主体边界并保持同类目标的一致尺度口径;对于被遮挡目标,以可见部分为准完成标注,避免用过大框把无关背景引入训练信号。结合样例与框分布图可以观察到:目标尺寸跨度较大且小目标占比明显,宽高分布呈现一定长尾特性;同时,同图多实例与局部密集分布较常见,这会放大 NMS 阶段的相互抑制风险,并对特征金字塔的多尺度表达提出要求。因此,在数据清洗环节需要优先排查坐标越界、空标注、异常类别与重复框等问题,并通过一致性校验降低噪声标注对回归分支的上限影响;在数据划分上,建议采用固定随机种子进行可复现划分,并尽量保证三部分数据在来源场景、目标尺度与密集程度上分布相近,从而使验证集能真实反映测试集与线上环境的误差形态。

在预处理与增强策略上,为与后续推理端保持一致,图像通常会进行统一尺寸的缩放与填充以适配网络输入,并在保持长宽比的前提下降低尺度漂移对定位学习的不利影响。针对反光与光照变化,可引入亮度/对比度与色彩扰动、轻度模糊与噪声模拟,提升金属材质在不同曝光与白平衡下的鲁棒性;针对遮挡与密集目标,可采用随机裁剪、遮挡模拟与多图拼接类增强,使模型更早看到“部分可见”的困难样本并提高召回;针对尺度差异,可通过随机缩放与多尺度训练扩大有效样本空间,缓解小目标在下采样链路中的信息损失。上述处理与增强共同服务于机械器件场景的核心难点:在复杂背景与强反光条件下稳定抑制误检,在密集堆叠与遮挡条件下减少漏检,并在跨场景分布变化时保持可用的泛化性能。
4. 模型原理与设计
本文默认以 YOLOv12 作为系统的核心检测器主线,其目标是在“工业可用的实时性”前提下,引入更强的上下文建模能力,以适配机械器件场景中常见的类间相似、反光高亮、遮挡密集与尺度跨度大的综合难点。YOLOv12 属于一阶段(single-stage)的密集预测范式:网络对输入图像进行端到端前向计算,在多尺度特征层上直接输出候选框的位置回归与类别得分,再结合阈值过滤与后处理得到最终检测结果;这种范式天然更贴近桌面端在线推理的低延迟需求。与早期 YOLO 系列主要依赖卷积堆叠不同,YOLOv12 以“注意力为中心”的架构为导向,引入区域注意力(Area Attention)与残差高效层聚合网络(R-ELAN)等模块,并在实现层面强调 FlashAttention 等高效算子以降低注意力的访存开销,从而在速度与精度之间取得更优折中。(arXiv)
从整体结构看,YOLOv12 仍沿用工程上成熟的 Backbone–Neck–Head 三段式组织:主干网络逐级下采样提取语义特征,颈部网络对不同层级特征进行融合以增强多尺度表达,检测头在多个尺度上输出预测以覆盖小目标与大目标的共同需求。为了让“全局上下文”更有效地参与到特征提取,YOLOv12 将区域注意力融入到关键的特征处理单元中,使得网络在保留卷积高效性的同时,获得更强的长程依赖建模能力;这对机械器件中“相似纹理但结构差异细微”的类别辨析,以及“背景文字/水印/反光边缘”带来的误检抑制尤其关键。网络整体架构图如下图所示:该示意图以 Conv、C3k2、A2C2f 等模块串联 Backbone 与 Neck,并在 Head 端提供多尺度 Detect 输出,便于读者从工程视角把握信息流与多尺度检测的落点。

在关键组件层面,注意力机制可用经典的 Q–K–V 形式刻画:给定特征映射展平后的 token 序列,通过线性变换得到查询、键和值(
Q
,
K
,
V
Q,K,V
Q,K,V),标准自注意力可写为
A
t
t
n
(
Q
,
K
,
V
)
=
S
o
f
t
m
a
x
(
Q
K
⊤
d
)
V
,
\mathrm{Attn}(Q,K,V)=\mathrm{Softmax}\left(\frac{QK^\top}{\sqrt{d}}\right)V,
Attn(Q,K,V)=Softmax(dQK⊤)V,
其中
d
d
d 为特征维度,用于缩放以稳定训练;该结构能够显式聚合全局上下文,但计算与访存成本通常较高。YOLOv12 的区域注意力思想是将特征图按水平或垂直方向划分为
L
L
L 个等分区域(工程默认常取
L
=
4
L=4
L=4),将注意力计算限制在区域级别的聚合范围内,从而在尽量保留“大感受野”的同时显著降低复杂度,并配合 FlashAttention 缓解注意力计算的内存访问瓶颈;同时,R-ELAN 通过残差与改造后的聚合方式稳定更大规模注意力网络的优化过程,使训练更易收敛。(Ultralytics Docs)
损失函数与训练策略决定了模型能否在本任务的误检/漏检权衡上“可控”,工程上通常将总损失写作框回归、分类(及可能的分布建模项)的加权和:
L
=
λ
box
L
∗
box
+
λ
∗
cls
L
∗
cls
+
λ
∗
dfl
L
∗
dfl
,
\mathcal{L}=\lambda_{\text{box}}\mathcal{L}*{\text{box}}+\lambda*{\text{cls}}\mathcal{L}*{\text{cls}}+\lambda*{\text{dfl}}\mathcal{L}*{\text{dfl}},
L=λboxL∗box+λ∗clsL∗cls+λ∗dflL∗dfl,
其中
L
∗
box
\mathcal{L}*{\text{box}}
L∗box 常采用 IoU 系列度量以直接优化定位质量,
L
∗
cls
\mathcal{L}*{\text{cls}}
L∗cls 对应类别判别,
L
∗
dfl
\mathcal{L}*{\text{dfl}}
L∗dfl 用于提升边界回归的分布表达能力;对应地,IoU 的基础定义为
I
o
U
=
∣
B
∩
B
g
t
∣
∣
B
∪
B
g
t
∣
\mathrm{IoU}=\frac{|B\cap B^{gt}|}{|B\cup B^{gt}|}
IoU=∣B∪Bgt∣∣B∩Bgt∣,
B
B
B 与
B
g
t
B^{gt}
Bgt 分别为预测框与真值框。训练层面,为与桌面端推理保持一致,输入分辨率通常统一到 640 尺度以兼顾速度与精度,并通过 Mosaic、MixUp、Copy-Paste、尺度与颜色扰动等增强覆盖反光、遮挡与尺度变化等难点;推理阶段再通过置信度阈值与 IoU 阈值控制候选框过滤与抑制强度,从而在“密集零件不过度互相抑制”和“背景干扰不过度放大”之间取得更稳定的可视化结果,这也与系统端的 Conf/IoU 滑块交互形成一一对应的调参闭环。(Ultralytics Docs)
5. 实验结果与分析
本章实验以机械器件 6 类检测数据集为对象(训练/验证/测试分别为 3931/1183/800),在统一输入尺度 640×640 与一致评测脚本下,对 8 种 YOLO 系列模型进行横向对比:轻量组为 yolov5nu、yolov6n、yolov7-tiny、yolov8n、yolov9t、yolov10n、yolo11n、yolo12n;中等组为 yolov5su、yolov6s、yolov7、yolov8s、yolov9s、yolov10s、yolo11s、yolo12s。评估指标包含 Precision、Recall、F1、mAP50 与 mAP50-95,并在同一硬件环境(NVIDIA GeForce RTX 3070 Laptop GPU,8GB)统计端到端耗时(Pre/Inf/Post),以支撑“精度—速度—复杂度”的工程选型。
表5-1给出了各模型的核心对比结果。轻量组中,YOLOv12n 在 Precision、F1 与 mAP50 上整体最优或接近最优(Precision=0.8880,F1=0.8639,mAP50=0.9108),体现出更偏向“误检抑制与综合判别”的能力;YOLOv9t 在 Recall 与 mAP50-95 上表现最佳(Recall=0.8565,mAP50-95=0.7718),更适合对漏检敏感的质检环节,但其推理时延显著偏高(Inf=16.51ms)。从效率角度看,YOLOv8n、YOLOv6n 与 YOLOv5nu 的端到端延迟均约 10ms 量级(以 Pre+Inf+Post 计),属于较稳妥的实时基线;而 YOLOv10n 的 PostTime 仅 0.63ms,说明其端到端化/轻后处理带来的收益在系统链路上可直接体感,但在本硬件与实现条件下其 InfTime 仍高于 v8n/v6n。
中等组的上限更高但差异同样体现为“精度与延迟的再平衡”。YOLOv9s 在 mAP50 与 mAP50-95 上达到该组最高(mAP50=0.9155,mAP50-95=0.7830),与机械器件场景中“高反光、密集遮挡与类间相似”难点更匹配,但其 InfTime 达到 18.66ms,若叠加视频帧率目标可能带来更明显的吞吐压力;YOLOv7 的 F1 达到该组最高(0.8696),说明其对 Precision/Recall 的折中较好,但推理时延(Inf=23.62ms)与模型规模显著增加,使其更适合离线复核或低帧率场景。若以“尽量高的精度同时维持实时交互”为目标,YOLOv8s 在该组给出了最均衡的延迟(Pre+Inf+Post≈11.39ms)与可接受的精度(mAP50-95=0.7644),在桌面端视频/摄像头在线检测中更容易稳定跑满帧率。
表5-1 不同 YOLO 模型性能与效率对比(RTX 3070 Laptop GPU, 8GB)
| 模型 | Params(M) | FLOPs(G) | Pre(ms) | Inf(ms) | Post(ms) | Precision | Recall | F1 | mAP50 | mAP50-95 |
|---|---|---|---|---|---|---|---|---|---|---|
| YOLOv5nu | 2.6 | 7.7 | 1.90 | 7.73 | 1.31 | 0.8706 | 0.8363 | 0.8531 | 0.9021 | 0.7506 |
| YOLOv6n | 4.3 | 11.1 | 2.17 | 6.78 | 1.39 | 0.8763 | 0.8193 | 0.8469 | 0.8952 | 0.7525 |
| YOLOv7-tiny | 6.2 | 13.8 | 2.28 | 14.74 | 4.06 | 0.8667 | 0.8311 | 0.8485 | 0.8865 | 0.6971 |
| YOLOv8n | 3.2 | 8.7 | 1.95 | 6.83 | 1.39 | 0.8794 | 0.8304 | 0.8542 | 0.9018 | 0.7586 |
| YOLOv9t | 2.0 | 7.7 | 1.87 | 16.51 | 1.29 | 0.8708 | 0.8565 | 0.8636 | 0.9098 | 0.7718 |
| YOLOv10n | 2.3 | 6.7 | 2.08 | 11.24 | 0.63 | 0.8735 | 0.8308 | 0.8516 | 0.8980 | 0.7627 |
| YOLOv11n | 2.6 | 6.5 | 2.11 | 9.44 | 1.42 | 0.8695 | 0.8484 | 0.8588 | 0.9088 | 0.7651 |
| YOLOv12n | 2.6 | 6.5 | 1.91 | 12.47 | 1.37 | 0.8880 | 0.8410 | 0.8639 | 0.9108 | 0.7688 |
| YOLOv5su | 9.1 | 24.0 | 2.28 | 8.45 | 1.51 | 0.8678 | 0.8398 | 0.8536 | 0.9019 | 0.7620 |
| YOLOv6s | 17.2 | 44.2 | 2.22 | 8.59 | 1.45 | 0.8731 | 0.8231 | 0.8474 | 0.8958 | 0.7554 |
| YOLOv7 | 36.9 | 104.7 | 2.44 | 23.62 | 3.46 | 0.8850 | 0.8547 | 0.8696 | 0.8907 | 0.7495 |
| YOLOv8s | 11.2 | 28.6 | 2.31 | 7.66 | 1.42 | 0.8729 | 0.8401 | 0.8562 | 0.9019 | 0.7644 |
| YOLOv9s | 7.2 | 26.7 | 2.12 | 18.66 | 1.39 | 0.8884 | 0.8398 | 0.8634 | 0.9155 | 0.7830 |
| YOLOv10s | 7.2 | 21.6 | 2.21 | 11.38 | 0.60 | 0.8739 | 0.8449 | 0.8592 | 0.9061 | 0.7726 |
| YOLOv11s | 9.4 | 21.5 | 2.37 | 9.74 | 1.36 | 0.8820 | 0.8430 | 0.8621 | 0.9090 | 0.7791 |
| YOLOv12s | 9.3 | 21.4 | 2.09 | 13.23 | 1.42 | 0.8649 | 0.8676 | 0.8662 | 0.9134 | 0.7756 |
图5-1 轻量组(n-type)F1 与 mAP50 双条形对比

图注:同一评测设置下,YOLOv12n 与 YOLOv9t 在综合指标上略占优势,但延迟差异更能直接影响桌面端实时体验。
为了更直观地呈现轻量组在 F1 与 mAP50 上的差异,图5-1给出了双指标双条形对比。可以看到,在轻量组整体差距不大的情况下,YOLOv12n 与 YOLOv9t 更偏向“更高的综合精度”,而 YOLOv8n/v6n 则以更低延迟提供稳定基线,这一现象与桌面端实时检测的工程诉求高度一致:当用户更关注“画面稳定与不卡顿”,应优先考虑端到端耗时更小且指标不显著退化的模型;当用户更关注“少漏检/少误检”,则可在可接受的帧率下降范围内选择更高 mAP50-95 的版本,并通过 Conf/IoU 交互进一步平衡误检与漏检。

从训练与收敛行为看,训练损失(box/cls/dfl)在前期快速下降,验证侧损失同步下降并趋于平稳,Precision/Recall 与 mAP 曲线在约 20–40 epoch 后进入平台期,后续增益边际递减,这说明当前数据规模与增强强度下模型已达到相对稳定的优化状态。结合 F1-Confidence 曲线,整体最优 F1 约为 0.87,最优置信度阈值出现在约 0.397 附近,意味着在系统默认阈值设置上,可将 Conf 的默认值从偏保守的 0.25 调整到约 0.4,以减少背景误检并保持可观的召回;同时保留滑块交互,让操作者在“漏检敏感(偏低 Conf)”与“误检敏感(偏高 Conf)”之间快速切换策略。
图5-2 归一化混淆矩阵(测试集)

图注:gear 类别相对更易混淆,且背景误检更集中在 bolt/gear 等具有重复纹理的类别上,提示需要在困难背景与类间相似样本上做定向强化。
误差形态方面,图5-2的归一化混淆矩阵显示 6 类目标整体对角线占优,其中 flange(法兰)识别最稳定(对角线约 0.95),bearing/bolt/nut/spring 均在 0.90 左右,而 gear(齿轮)对角线相对较低(约 0.83),说明其更容易受到遮挡、尺度变化或背景纹理干扰。矩阵中 “true background” 列在 bolt 与 gear 上出现相对更高的占比(例如 bolt 行约 0.31、gear 行约 0.20),提示背景被误检为螺栓/齿轮的情况更突出;对应到数据特性,电商图中的金属高光、重复纹理、文字水印与零件堆叠边缘容易产生与螺纹/齿形相似的局部结构,从而诱发假阳性。针对这类问题,工程上更有效的改进通常不是盲目加大模型,而是“数据与阈值优先”:补充负样本与困难背景(强反光、纹理地面、印刷文字区域)、对 gear 类增加更丰富的尺度与角度样本,并结合更强的局部遮挡增强以提升对密集与缺失场景的鲁棒性;同时在系统部署时采用“推荐阈值 + 交互微调”的策略,将最优点附近(Conf≈0.4,IoU≈0.5)作为默认并允许用户按场景上调/下调。
6. 系统设计与实现
6.1 系统设计思路
本系统以“桌面端可交互在线检测”为目标,采用分层架构组织整体实现,将复杂的推理链路、会话与导出编排从界面逻辑中剥离出来,从而在保持交互响应的同时保证推理结果的一致性与可追溯性。总体上,系统划分为四层:表现与交互层(PySide6/Qt 客户端)、业务与会话管理层、推理与任务调度层、数据持久化层;各层以明确的输入输出契约连接,形成“多源输入—预处理—YOLO 推理—后处理/统计—可视化与导出”的闭环,便于后续扩展模型版本与导出能力而不破坏既有交互体验。
在运行链路上,系统以事件驱动的帧流为主线组织任务:图像输入强调一次性快速反馈,视频与摄像头输入强调连续帧稳定吞吐,并在源切换时保持互斥与状态清晰。Conf/IoU 等阈值参数由界面侧统一维护并实时同步到推理侧与后处理侧,使阈值变化能够在同一套后处理逻辑下即时生效,避免出现“界面显示与实际导出不一致”的工程风险;同时,进度条、耗时统计与底部记录表承担了“过程可见化”的职责,既增强用户对系统负载与推理节拍的感知,也为批量任务的中断恢复与复查定位提供依据。
在可扩展性设计上,系统将模型权重管理与类别信息刷新作为独立能力对外暴露:用户选择本地权重即可完成模型热切换,类别名与配色同步更新并作用于显示与导出,形成统一口径。数据侧采用本地 SQLite 管理账户与检测记录,并将结构化导出与媒体导出统一纳入归档策略,以时间戳命名保证溯源性;当出现异常输入、帧读取失败或推理超时等情况时,业务层以任务状态机方式协调界面提示、资源回收与日志记录,从而提升系统在真实使用场景中的稳定性与可维护性。

图6-1 系统流程图
图注:系统自启动后加载配置与模型列表,接入图片/视频/摄像头输入,完成 640×640 预处理、YOLO 推理与 Conf/IoU+NMS 后处理,并将叠加框、统计与进度反馈到界面;在视频/摄像头模式下以帧循环驱动记录与导出闭环。

图6-2 系统设计框图
图注:图中以“表现与交互、业务与会话、推理与调度、数据持久化”四层划分模块边界,数据流自上而下完成推理与落库,控制流自界面侧下发并在业务层完成编排与互斥管理。
6.2 登录与账户管理 — 流程图

图6-3 登录与账户管理流程图
图注:登录与注册均以本地数据库为持久化载体;登录成功后载入个性化配置与历史记录,并与主检测流程共享会话信息,从而实现“个性化体验—结果追溯—复查导出”的连贯闭环。
登录与账户管理流程在系统中的价值不仅体现在“访问控制”,更体现在对个性化配置与历史记录的组织能力:系统启动后首先进入登录界面,根据用户是否已有账号分流到注册或登录路径;注册阶段完成必要信息填写并将账户写入本地数据库,随后回到登录入口完成口令校验;登录成功后系统载入主题、默认模型与最近检测记录等偏好设置,并将会话状态注入到主界面,使多源检测、记录复查与导出归档共享同一身份与配置上下文。该设计使得不同操作者在同一设备上能够隔离各自的结果与设置,同时也为后续的记录追溯、异常复盘与批量导出提供稳定的“用户维度”索引。
参考文献(GB/T 7714)
1 高艺平, 王浩, 李新宇, 高亮. 基于深度智能视觉的表面缺陷检测研究进展[J]. 工业工程, 2024, 27(2): 27-36.
2 张洪, 朱志伟, 胡天宇, 等. 基于改进YOLOv5s的桥梁螺栓缺陷识别方法[J]. 吉林大学学报(工学版), 2024(3): 749-760.
3 Khanam R, Hussain M. What is YOLOv5: A deep look into the internal features of the popular object detector[EB/OL]. arXiv:2407.20892, 2024.
4 Li C, Li L, Jiang H, et al. YOLOv6: A Single-Stage Object Detection Framework for Industrial Applications[EB/OL]. arXiv:2209.02976, 2022.
[5] Wang C Y, Bochkovskiy A, Liao H Y M. YOLOv7: Trainable bag-of-freebies sets new state-of-the-art for real-time object detectors[EB/OL]. arXiv:2207.02696, 2022.
[6] Yaseen M. What is YOLOv8: An In-Depth Exploration of the Internal Features of the Next-Generation Object Detector[EB/OL]. arXiv:2408.15857, 2024.
[7] Wang C Y, et al. YOLOv9: Learning What You Want to Learn Using Programmable Gradient Information[C]//European Conference on Computer Vision. 2024.
[8] Wang A, Chen H, Liu L, et al. YOLOv10: Real-Time End-to-End Object Detection[EB/OL]. arXiv:2405.14458, 2024.
[9] Sapkota R, Karkee M. Ultralytics YOLO Evolution: An Overview of YOLO26, YOLO11, YOLOv8 and YOLOv5 Object Detectors for Computer Vision and Pattern Recognition[EB/OL]. arXiv:2510.09653, 2025.
[10] Ren S, He K, Girshick R, Sun J. Faster R-CNN: Towards Real-Time Object Detection with Region Proposal Networks[C]//Advances in Neural Information Processing Systems. 2015.
[11] Liu W, Anguelov D, Erhan D, et al. SSD: Single Shot MultiBox Detector[C]//European Conference on Computer Vision. 2016: 21-37.
[12] Lin T Y, Goyal P, Girshick R, He K, Dollár P. Focal Loss for Dense Object Detection[C]//Proceedings of the IEEE International Conference on Computer Vision. 2017: 2980-2988.
[13] Tan M, Pang R, Le Q V. EfficientDet: Scalable and Efficient Object Detection[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2020: 10781-10790.
[14] Tian Z, Shen C, Chen H, He T. FCOS: Fully Convolutional One-Stage Object Detection[C]//Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019: 9627-9636.
[15] Zhou X, Wang D, Krähenbühl P. Objects as Points[EB/OL]. arXiv:1904.07850, 2019.
[16] Carion N, Massa F, Synnaeve G, et al. End-to-End Object Detection with Transformers[C]//European Conference on Computer Vision. 2020: 213-229.
[17] Zhao Y, Lv W, Xu S, et al. DETRs Beat YOLOs on Real-time Object Detection[EB/OL]. arXiv:2304.08069, 2023.
[18] Rezatofighi H, Tsoi N, Gwak J, et al. Generalized Intersection over Union: A Metric and a Loss for Bounding Box Regression[C]//Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2019: 658-666.
项目资源链接
若您想获得博文中涉及的实现完整全部资源文件(包括测试图片、视频,py, UI文件,训练数据集、训练代码、界面代码等),这里见可参考博客与视频,已将所有涉及的文件同时打包到里面,点击即可运行,完整文件截图如下:
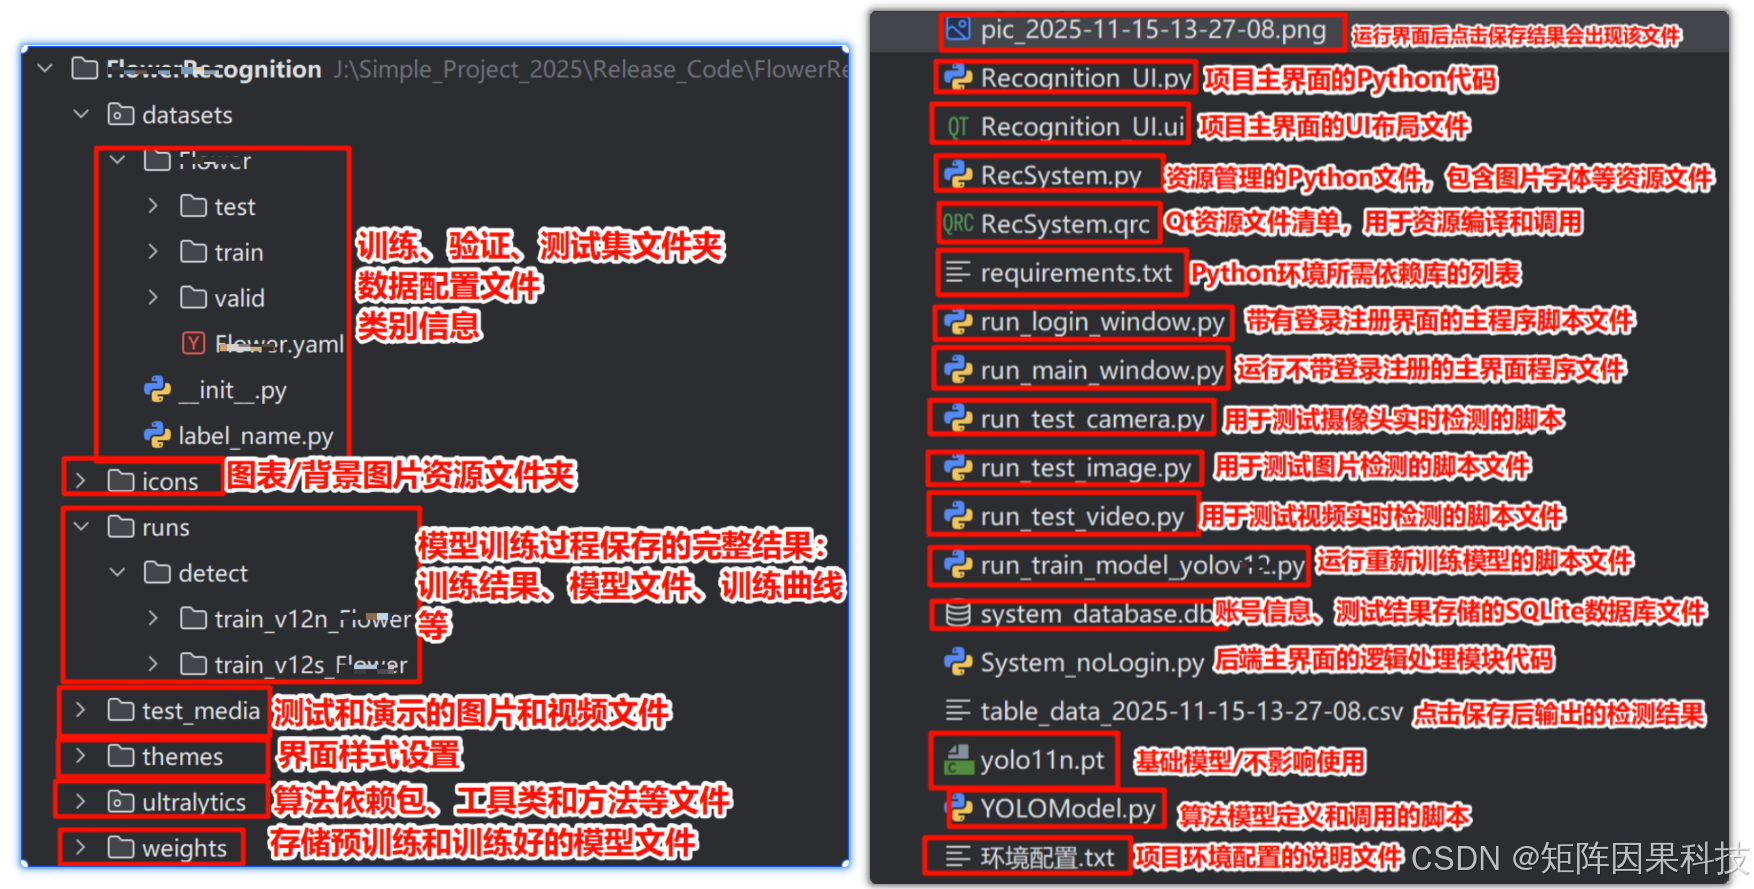
项目完整文件请见项目介绍及功能演示视频处给出:
完整项目及文档: https://newtopmat.feishu.cn/wiki/AiMbwOac4iSyM0kC4SFc7DGBnTd
功能效果展示视频:热门实战|《基于深度学习的机械器件识别系统》YOLOv12-v8多版本合集:附论文/源码/PPT/数据集,支持图片/视频/摄像头输入、可视化界面、结果导出与权重切换
环境配置博客教程:https://deeppython.feishu.cn/wiki/EwnTwJ2H3iLF6VkNG6ccgZYrnvd;
或者环境配置视频教程:Pycharm软件安装视频教程;(2)Anaconda软件安装视频教程;(3)Python环境配置视频教程;
数据集标注教程(如需自行标注数据):数据标注合集
更多推荐


 8
 0
- 0


 已为社区贡献82条内容

所有评论(0)