
机器学习实践——基于KNN算法的鸢尾花识别案例
·
一.案例介绍
数据来源于机器学习官方上传的数据,别分进行数据加载、绘制数据散点图、数据分割、完整案例演示以及利用交叉验证和网格搜索寻找最优超参的练习
二.代码分部详解
1.包的导入
from sklearn.datasets import load_iris          # 加载鸢尾花测试集的.
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib
matplotlib.use('TkAgg')   # 解决后端错误
from sklearn.model_selection import train_test_split,GridSearchCV   # 分割训练集和测试集的
from sklearn.preprocessing import StandardScaler        # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象
from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率
2.加载鸢尾花数据集并查看数据
def dm01_loadiris():
    #1.加载鸢尾花数据集
    iris_data = load_iris()
    #2.查看数据集
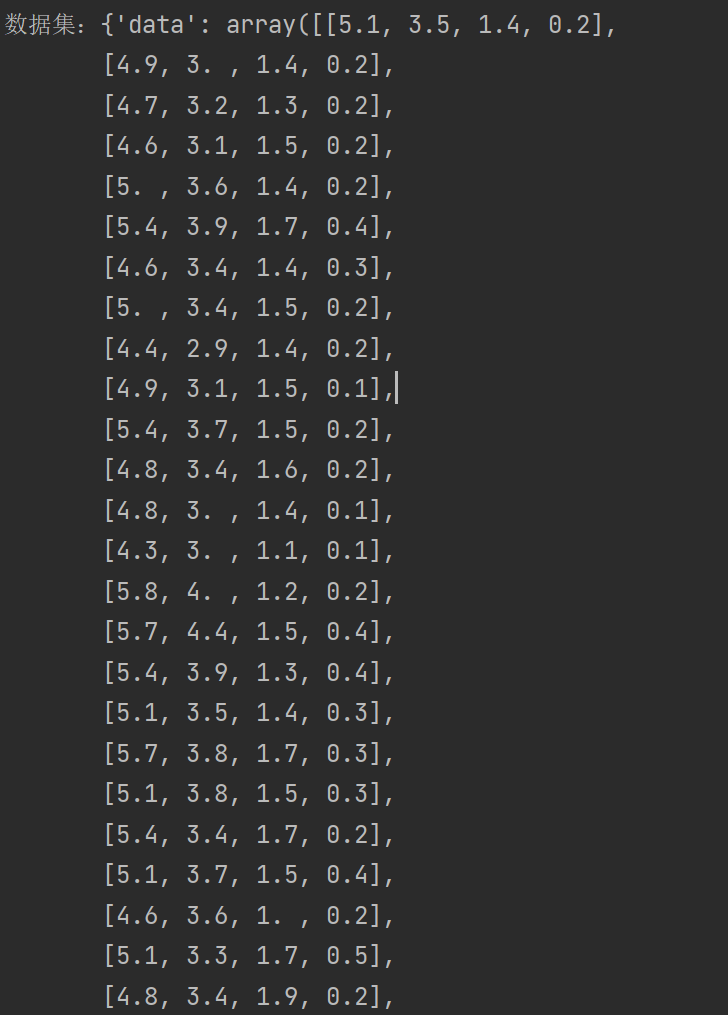
    # print(f'数据集:{iris_data}')    #字典形态
    # print(f'数据集的类型:{type(iris_data)}')
    #3.查看数据集所有的键
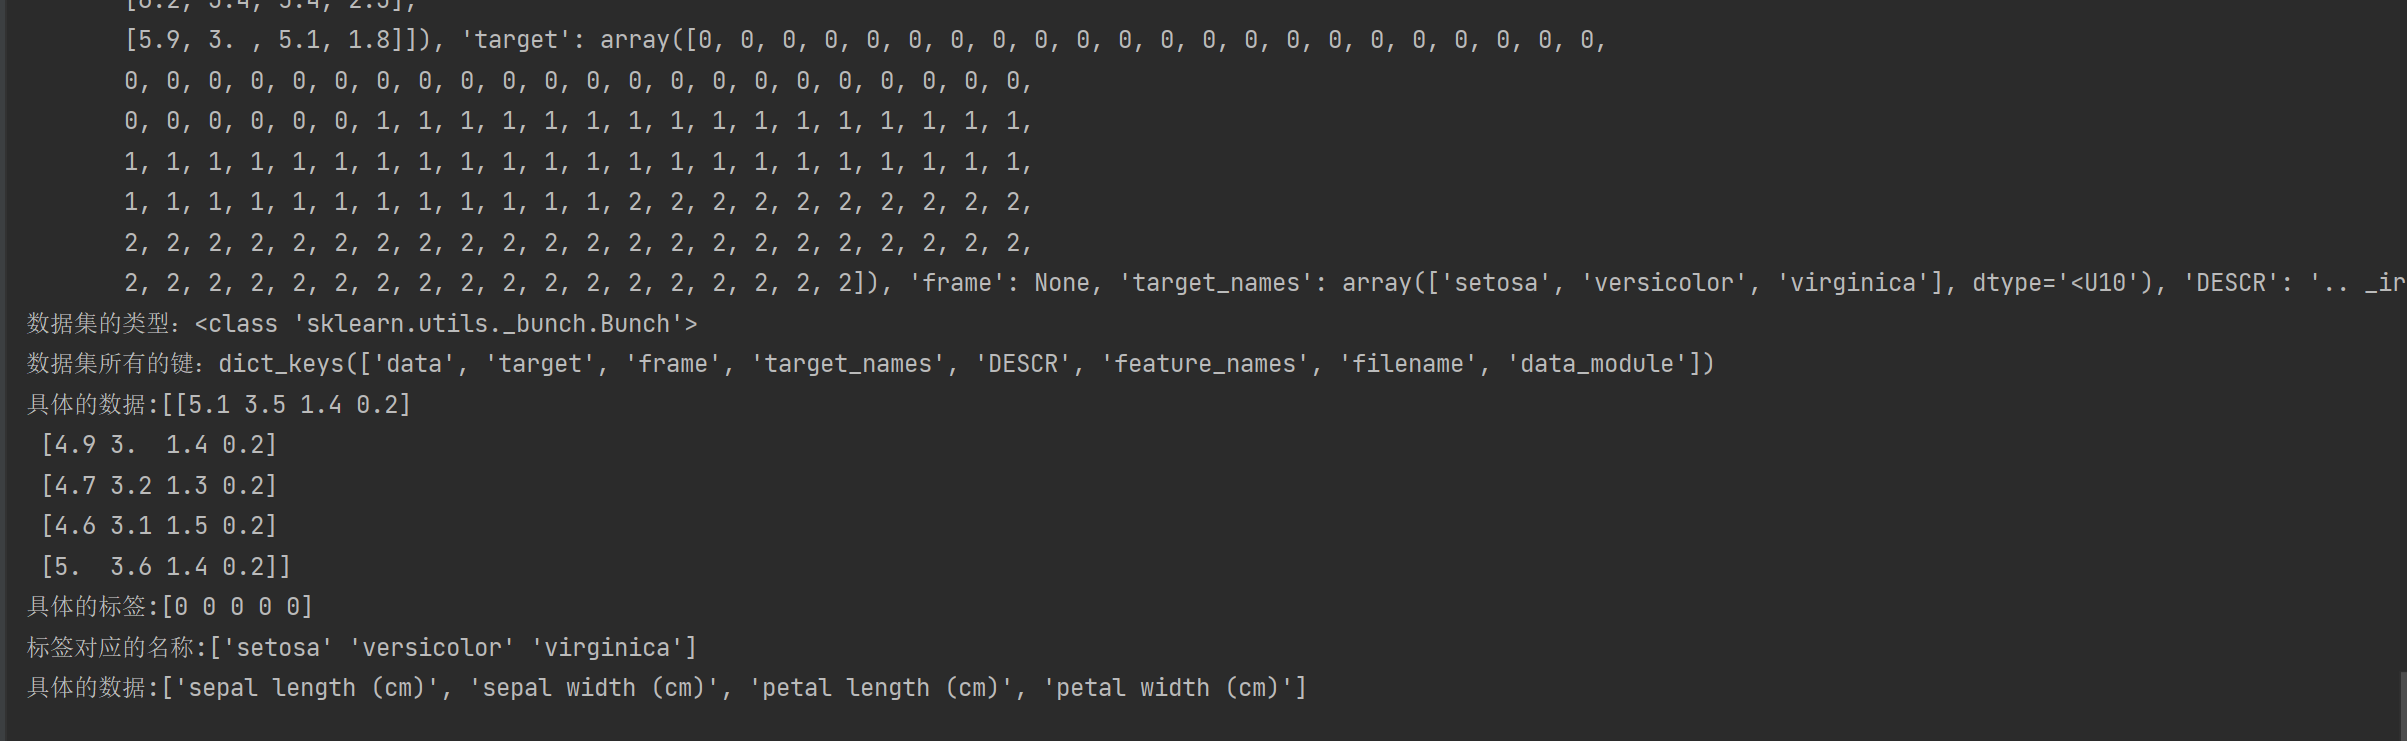
    # print(f'数据集所有的键:{iris_data.keys()}')
    # print(f'具体的数据:{iris_data.data[:5]}')           #150条数据,每个数据有4个特征,取前5个
    # print(f'具体的标签:{iris_data.target[:5]}')         #150条数据,每条数据有1个标签,取前5条
    # print(f'标签对应的名称:{iris_data.target_names}')
    # print(f'具体的数据:{iris_data.feature_names}')
结果展示
3.绘制数据的散点图
def dm02_show_iris():
    #加载数据集
    iris_data = load_iris()
    #2.把鸢尾花数据集封装成DataFrame对象  #
    iris_df = pd.DataFrame(iris_data.data, columns=iris_data.feature_names)
    iris_df['label'] = iris_data.target
    #print(iris_df)
    #4.通过Seaborn绘制散点图

    #           参1数据集      参2:X轴               参3:Y轴              参4:标签       参5:是否显示拟合线
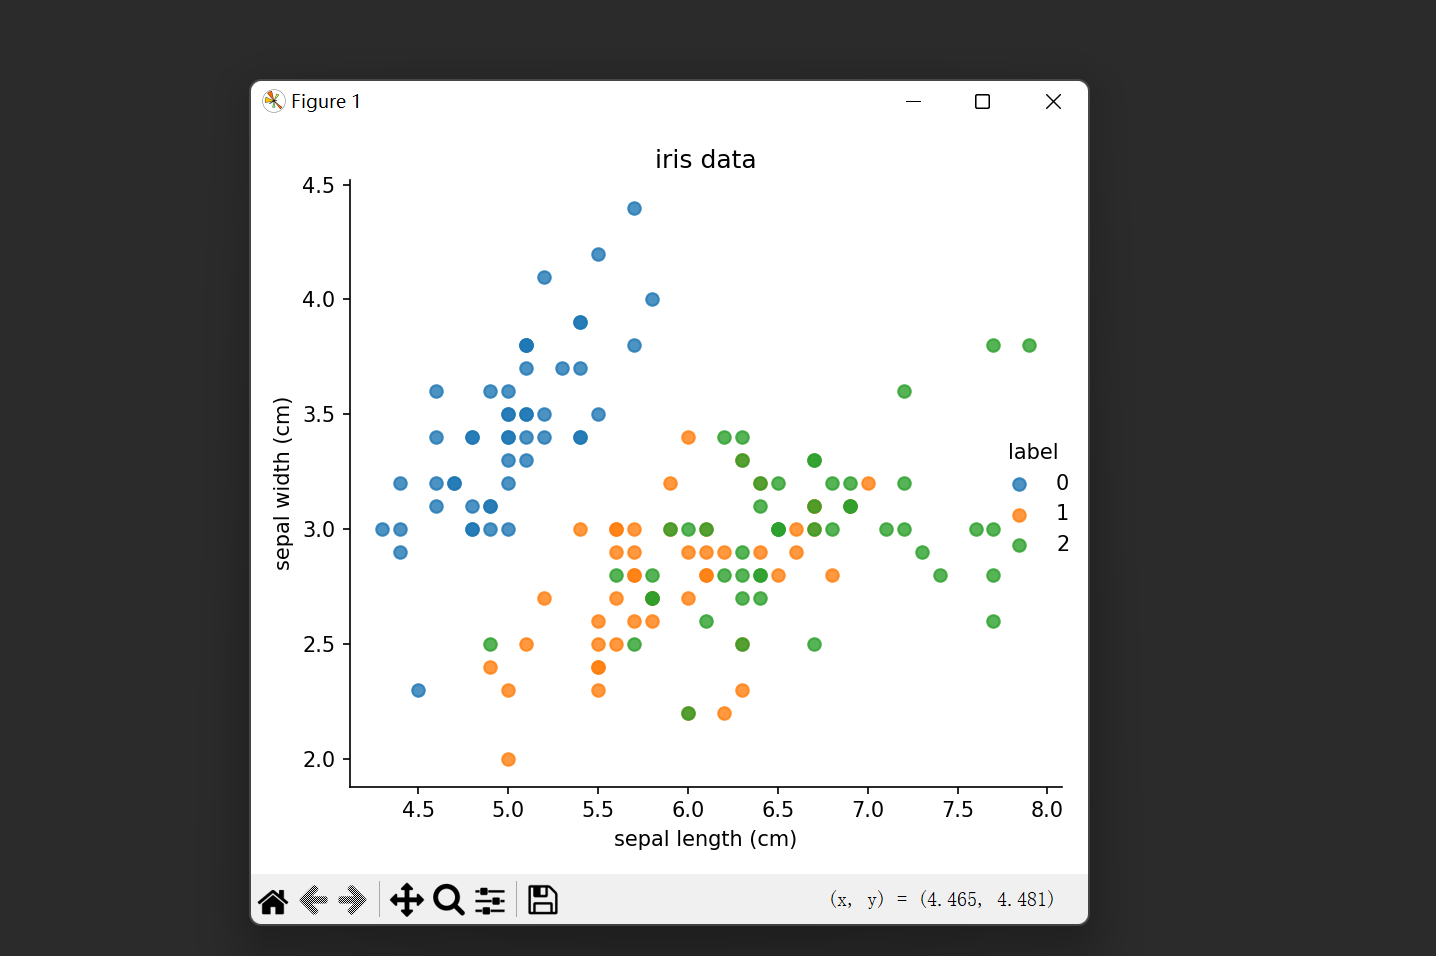
    sns.lmplot(data=iris_df, x='sepal length (cm)', y='sepal width (cm)', hue='label', fit_reg=False)
    #5.设置标题,显示
    plt.title('iris data')
    plt.tight_layout()   #自动调整子图参数,以使整个图像的边界与子图匹配
    plt.show()
效果展示
4.切分训练集和测试集
def dm03_split_train_test():
    #1.加载数据集
    iris_data = load_iris()
    #2.数据的预处理:从150个特征和标签中,按照8:2的比例,切分训练集和测试集
    #返回值:训练集的特征,测试集的特征,训练集的标签,测试集的标签
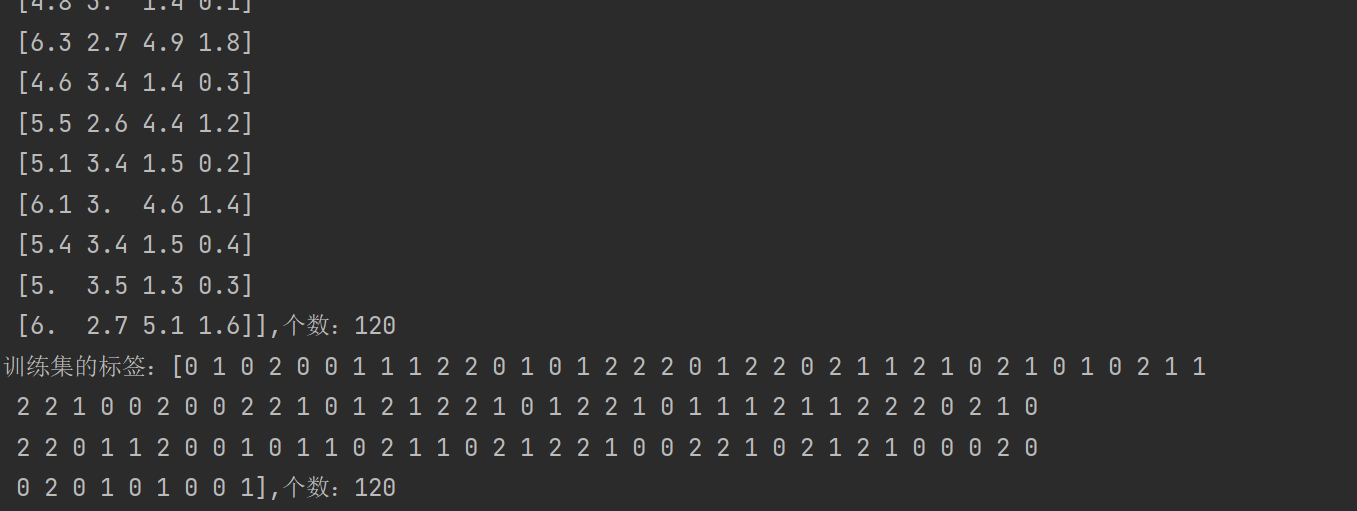
    x_train, x_test, y_train, y_test =  train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=23)

    #3.打印切割后的结果
    print(f'训练集的特征:{x_train},个数:{len(x_train)}')    #120条,每条4列(特征)
    print(f'训练集的标签:{y_train},个数:{len(y_train)}')    #120条,每条1列(标签)
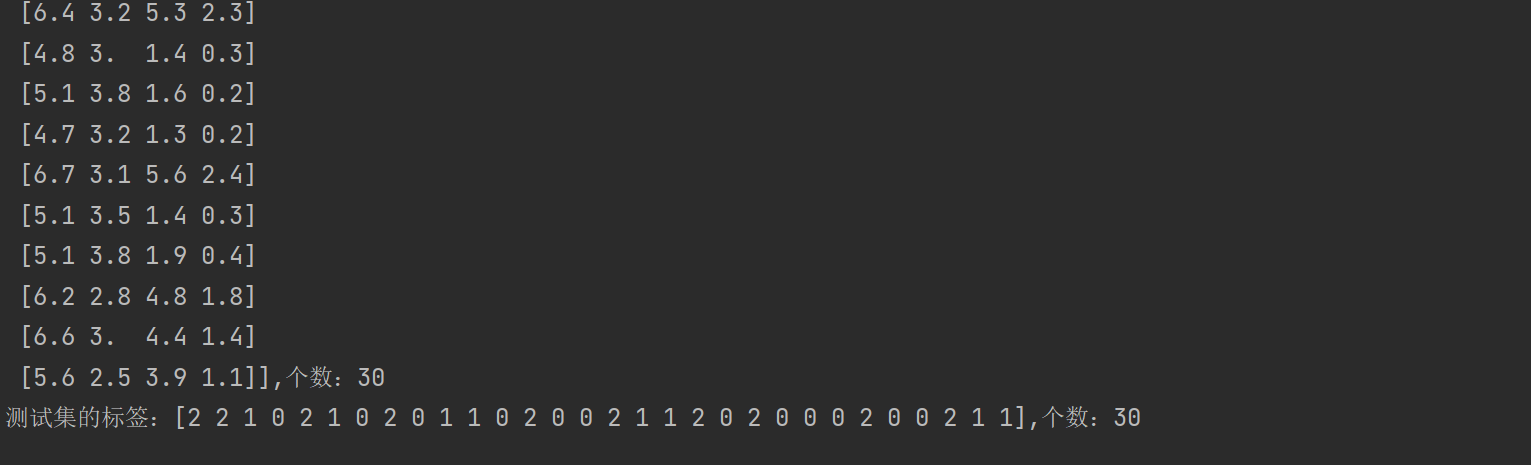
    print(f'测试集的特征:{x_test},个数:{len(x_test)}')      #30条,每条4列(特征)
    print(f'测试集的标签:{y_test},个数:{len(y_test)}')      #30条,每条1列(标签)
效果展示(按照4:1,将150条数据划分为训练集和测试集)
5.实现鸢尾花的完整案例
def dm04_iris_evaluate_test():
    #1.加载数据集
    iris_data = load_iris()
    #2.数据的预处理,这里是把150条数据,按照8:2的比例,分割训练集和测试集。
    x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=23)
    #3.特征工程
    #思考1:特征提取:应为原数据只有4个特征列,都是我们用的,所以这里无需做特征提取
    #思考2:特征预处理
    #3.1创建标准化对象
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)#fit_tarnsform是训练+转化兼具,第一次标准化使用,一般用于训练集
    x_test = transfer.transform(x_test)      #transform只有转化,重复标准化时使用,一般用于测试集

    #4.模型训练
    #4.1创建模型对象
    estimator = KNeighborsClassifier(n_neighbors=3)
    #4.2具体的训练模型的动作
    estimator.fit(x_train,y_train)

    #模型的预测
    #场景1:对刚才切分的测试集(30条)进行测试
    y_pre = estimator.predict(x_test)
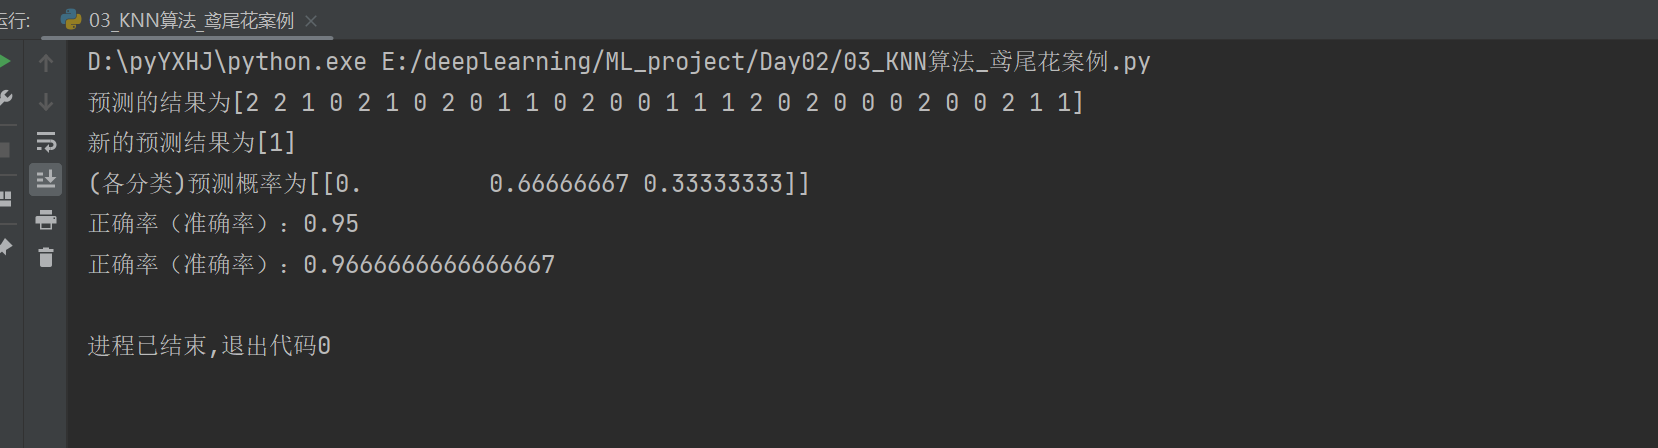
    print((f'预测的结果为{y_pre}'))
    #场景2:对新数据进行测试
    #5.1自定义预测测试集
    my_data = [[7.8, 2.1, 3.9, 1.6]]
    my_data = transfer.transform(my_data)
    #5.3模型的预测
    y_pre_new = estimator.predict(my_data)
    print(f'新的预测结果为{y_pre_new}')
    #5.4 查看上述数据集,各种分类的预测概率
    y_pre_proba = estimator.predict_proba(my_data)
    print(f'(各分类)预测概率为{y_pre_proba}')

    #6. 模型评估
    #方式1:直接评分,基于:训练集的特征 和 训练集的标签
    print(f'正确率(准确率):{estimator.score(x_train,y_train)}')

    #方式2:基于测试集的标签和预测结果
    print(f'正确率(准确率):{accuracy_score(y_test,y_pre)}')
效果展示
6.完整代码展示
# 导入工具包
from sklearn.datasets import load_iris          # 加载鸢尾花测试集的.
import seaborn as sns
import pandas as pd
import matplotlib.pyplot as plt
import matplotlib
matplotlib.use('TkAgg')   # 解决后端错误
from sklearn.model_selection import train_test_split,GridSearchCV   # 分割训练集和测试集的
from sklearn.preprocessing import StandardScaler        # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier      # KNN算法 分类对象
from sklearn.metrics import accuracy_score              # 模型评估的, 计算模型预测的准确率


#d定义函数,加载鸢尾花数据集,并查看数据
def dm01_loadiris():
    #1.加载鸢尾花数据集
    iris_data = load_iris()
    #2.查看数据集
    print(f'数据集:{iris_data}')    #字典形态
    print(f'数据集的类型:{type(iris_data)}')
    #3.查看数据集所有的键
    print(f'数据集所有的键:{iris_data.keys()}')
    print(f'具体的数据:{iris_data.data[:5]}')           #150条数据,每个数据有4个特征,取前5个
    print(f'具体的标签:{iris_data.target[:5]}')         #150条数据,每条数据有1个标签,取前5条
    print(f'标签对应的名称:{iris_data.target_names}')
    print(f'具体的数据:{iris_data.feature_names}')

#2.绘制数据集的散点图
def dm02_show_iris():
    #加载数据集
    iris_data = load_iris()
    #2.把鸢尾花数据集封装成DataFrame对象  #
    iris_df = pd.DataFrame(iris_data.data, columns=iris_data.feature_names)
    iris_df['label'] = iris_data.target
    #print(iris_df)
    #4.通过Seaborn绘制散点图

    #           参1数据集      参2:X轴               参3:Y轴              参4:标签       参5:是否显示拟合线
    sns.lmplot(data=iris_df, x='sepal length (cm)', y='sepal width (cm)', hue='label', fit_reg=False)
    #5.设置标题,显示
    plt.title('iris data')
    plt.tight_layout()   #自动调整子图参数,以使整个图像的边界与子图匹配
    plt.show()

# 3.切分训练集和测试集
def dm03_split_train_test():
    #1.加载数据集
    iris_data = load_iris()
    #2.数据的预处理:从150个特征和标签中,按照8:2的比例,切分训练集和测试集
    #返回值:训练集的特征,测试集的特征,训练集的标签,测试集的标签
    x_train, x_test, y_train, y_test =  train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=23)

    #3.打印切割后的结果
    print(f'训练集的特征:{x_train},个数:{len(x_train)}')    #120条,每条4列(特征)
    print(f'训练集的标签:{y_train},个数:{len(y_train)}')    #120条,每条1列(标签)
    print(f'测试集的特征:{x_test},个数:{len(x_test)}')      #30条,每条4列(特征)
    print(f'测试集的标签:{y_test},个数:{len(y_test)}')      #30条,每条1列(标签)
#4.实现鸢尾花完整案例-》  加载数据、数据预处理、特征工程、模型训练、模型评估、模型预测

def dm04_iris_evaluate_test():
    #1.加载数据集
    iris_data = load_iris()
    #2.数据的预处理,这里是把150条数据,按照8:2的比例,分割训练集和测试集。
    x_train, x_test, y_train, y_test = train_test_split(iris_data.data, iris_data.target, test_size=0.2, random_state=23)
    #3.特征工程
    #思考1:特征提取:应为原数据只有4个特征列,都是我们用的,所以这里无需做特征提取
    #思考2:特征预处理
    #3.1创建标准化对象
    transfer = StandardScaler()
    x_train = transfer.fit_transform(x_train)#fit_tarnsform是训练+转化兼具,第一次标准化使用,一般用于训练集
    x_test = transfer.transform(x_test)      #transform只有转化,重复标准化时使用,一般用于测试集

    #4.模型训练
    #4.1创建模型对象
    estimator = KNeighborsClassifier(n_neighbors=3)
    #4.2具体的训练模型的动作
    estimator.fit(x_train,y_train)

    #模型的预测
    #场景1:对刚才切分的测试集(30条)进行测试
    y_pre = estimator.predict(x_test)
    print((f'预测的结果为{y_pre}'))
    #场景2:对新数据进行测试
    #5.1自定义预测测试集
    my_data = [[7.8, 2.1, 3.9, 1.6]]
    my_data = transfer.transform(my_data)
    #5.3模型的预测
    y_pre_new = estimator.predict(my_data)
    print(f'新的预测结果为{y_pre_new}')
    #5.4 查看上述数据集,各种分类的预测概率
    y_pre_proba = estimator.predict_proba(my_data)
    print(f'(各分类)预测概率为{y_pre_proba}')

    #6. 模型评估
    #方式1:直接评分,基于:训练集的特征 和 训练集的标签
    print(f'正确率(准确率):{estimator.score(x_train,y_train)}')

    #方式2:基于测试集的标签和预测结果
    print(f'正确率(准确率):{accuracy_score(y_test,y_pre)}')


#测试
if __name__ == '__main__':
   #dm01_loadiris()
   #dm02_show_iris()
   #dm03_split_train_test()
   dm04_iris_evaluate_test()
三.交叉验证和网格搜索寻找最优超参K
1.导包
from sklearn.datasets import load_iris                              # 加载鸢尾花测试集的.
from sklearn.model_selection import train_test_split,GridSearchCV   # 分割训练集和测试集的,寻找最优超参(网格搜索+交叉验证)
from sklearn.preprocessing import StandardScaler                    # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier                  # KNN算法 分类对象
from sklearn.metrics import accuracy_score                          # 模型评估的, 计算模型预测的准确率
2.加载数据
#1.加载鸢尾花数据集
iris_data = load_iris()
3.数据预处理(划分数据集)
#2.数据预处理

x_train,  x_test, y_train, y_test = train_test_split(iris_data.data,iris_data.target,test_size=0.2,random_state=22)
4.特征工程(标准化)
#3.特征工程——》标准化
#3.1创建标准化对象
transfor = StandardScaler()
#3.2对训练集和测试集的特征进行标准化
x_train = transfor.fit_transform(x_train)
x_test = transfor.transform(x_test)
5.模型训练
#4.模型训练
#4.1创建KNN分类对象
estimator = KNeighborsClassifier()
#4.2定义字典,记录超参可能出现的情况
param_dict = {'n_neighbors':[i for i in range(1,11)]}
#4.3创建GridSearchCV对象,寻找最优超参,使用网格搜索+交叉验证方式

#参1:要计算的最优超参模型对象
#参2:该模型超参可能出现的值
#参3:交叉验证的折数,这里4表示:每个超参组合,都会进行4此交叉验证,这里共计时4*10 = 40
#返回值:estimator——》处理后的模型对象
estimator = GridSearchCV(estimator,param_dict,cv = 4)
#4.4 具体的模型训练动作
estimator.fit(x_train,y_train)
#4.5 打印最优超参组合
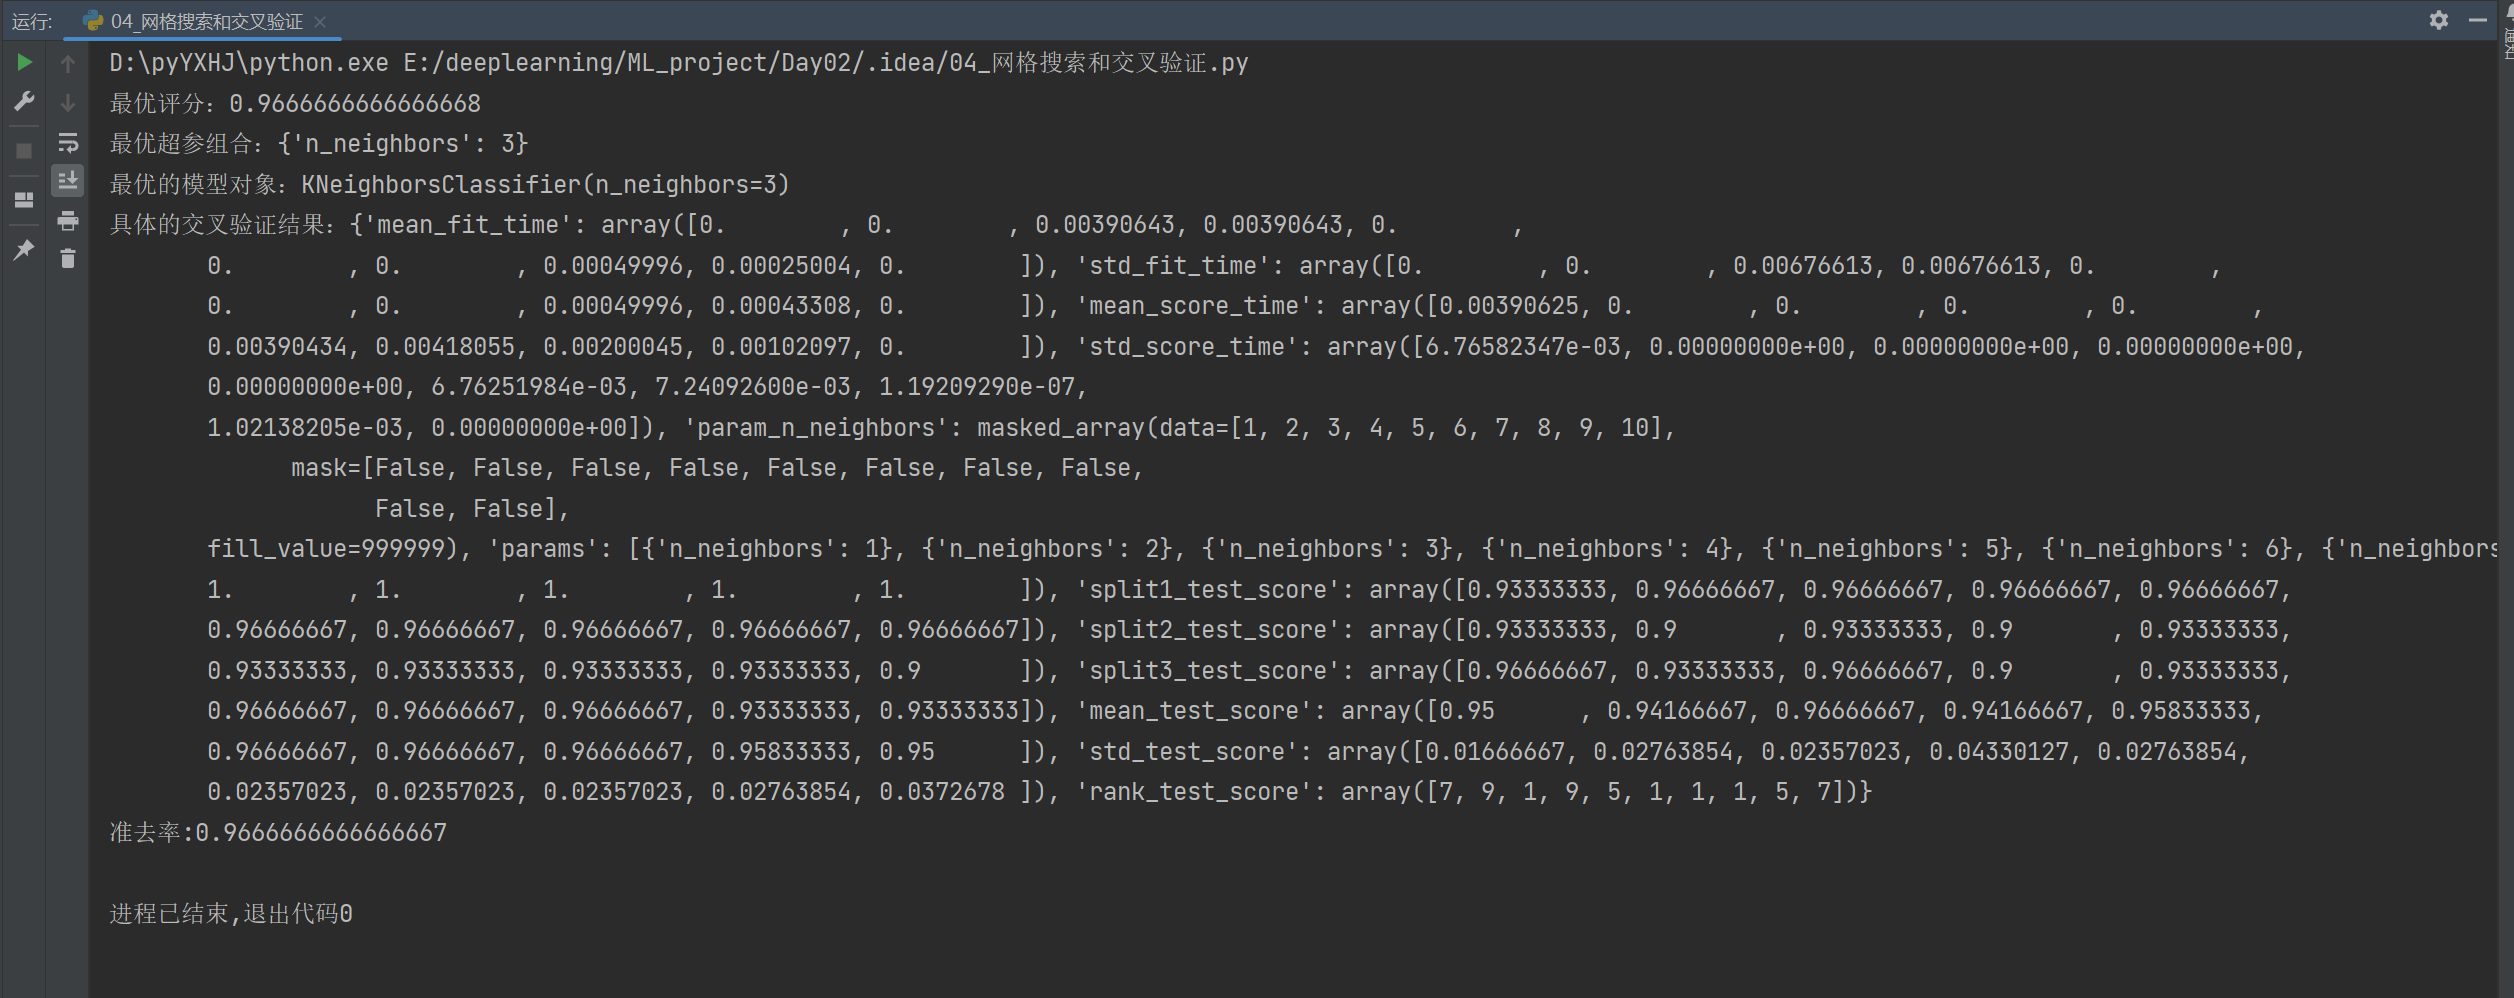
print(f'最优评分:{estimator.best_score_}')
print(f'最优超参组合:{estimator.best_params_}')
print(f'最优的模型对象:{estimator.best_estimator_}')
print(f'具体的交叉验证结果:{estimator.cv_results_}')
6.模型评估
#5.模型评估
#5.1获取最优超参的模型对象
#estimator = estimator.best_estimator_
estimator = KNeighborsClassifier(n_neighbors=3)
#5.2训练模型
estimator.fit(x_train,y_train)
#5.3模型预测
y_pre = estimator.predict(x_test)
#5.4 模型评估
#参1:测试集 参2 预测集

print(f'准去率:{accuracy_score(y_test,y_pre)}')
7.完整代码展示
from sklearn.datasets import load_iris                              # 加载鸢尾花测试集的.
from sklearn.model_selection import train_test_split,GridSearchCV   # 分割训练集和测试集的,寻找最优超参(网格搜索+交叉验证)
from sklearn.preprocessing import StandardScaler                    # 数据标准化的
from sklearn.neighbors import KNeighborsClassifier                  # KNN算法 分类对象
from sklearn.metrics import accuracy_score                          # 模型评估的, 计算模型预测的准确率


#1.加载鸢尾花数据集
iris_data = load_iris()

#2.数据预处理

x_train,  x_test, y_train, y_test = train_test_split(iris_data.data,iris_data.target,test_size=0.2,random_state=22)

#3.特征工程——》标准化
#3.1创建标准化对象
transfor = StandardScaler()
#3.2对训练集和测试集的特征进行标准化
x_train = transfor.fit_transform(x_train)
x_test = transfor.transform(x_test)

#4.模型训练
#4.1创建KNN分类对象
estimator = KNeighborsClassifier()
#4.2定义字典,记录超参可能出现的情况
param_dict = {'n_neighbors':[i for i in range(1,11)]}
#4.3创建GridSearchCV对象,寻找最优超参,使用网格搜索+交叉验证方式

#参1:要计算的最优超参模型对象
#参2:该模型超参可能出现的值
#参3:交叉验证的折数,这里4表示:每个超参组合,都会进行4此交叉验证,这里共计时4*10 = 40
#返回值:estimator——》处理后的模型对象
estimator = GridSearchCV(estimator,param_dict,cv = 4)
#4.4 具体的模型训练动作
estimator.fit(x_train,y_train)
#4.5 打印最优超参组合
print(f'最优评分:{estimator.best_score_}')
print(f'最优超参组合:{estimator.best_params_}')
print(f'最优的模型对象:{estimator.best_estimator_}')
print(f'具体的交叉验证结果:{estimator.cv_results_}')

#5.模型评估
#5.1获取最优超参的模型对象
#estimator = estimator.best_estimator_
estimator = KNeighborsClassifier(n_neighbors=3)
#5.2训练模型
estimator.fit(x_train,y_train)
#5.3模型预测
y_pre = estimator.predict(x_test)
#5.4 模型评估
#参1:测试集 参2 预测集

print(f'准去率:{accuracy_score(y_test,y_pre)}')
效果展示
四.总结
通过鸢尾花案例,了解了训练模型的基本步骤以及调用KNN的API,对机器学习有了初步认识
更多推荐

 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)