
ClickHouse 内存只涨不降之谜:MemoryTracking 20G 但 MemoryResident 才 2.5G,内存到底跑哪去了?
📝 摘要:ClickHouse 内存连涨 5 天,TRUNCATE、TTL、OPTIMIZE FINAL、JEMALLOC PURGE 全无效,只能重启。CK 自报 MemoryTracking 20G,进程 RSS 才 2.5G。半年后漂移顶到 55G 上限,查询报 MEMORY_LIMIT_EXCEEDED,才追到根因:25.4 的 MemoryWorker 默认只在启动时校正一次计数器。打开 memory_worker_correct_memory_tracker 并重启,基线从 44G 回到 1G。
ClickHouse 内存连涨 5 天,TRUNCATE 系统日志没用、配 TTL 没用、OPTIMIZE FINAL 没用,
SYSTEM JEMALLOC PURGE也没用。最后只能重启大法——但下次它还会涨。最迷的是:CK 自己说占了 20G+,OS 看进程 RSS 才 2.5G(RSS = Resident Set Size,进程真正占着物理内存的部分——它是操作系统的口径,比应用自报的数更接近真相)。这两个对不上的内存到底在哪?
这篇最早是一道没解开的题,靠定时重启和加内存撑了半年。现在破案了:是一行默认关着的配置。 想直接要答案的,跳到第十节;排查过程留着,因为每一步「没用」后来都有了解释。
一、背景
线上一台 ClickHouse 单机节点,跑了一段时间后,内存监控曲线像股神看走眼那天的 K 线——只涨不跌。
近 5 天的内存占用是一条优雅的、毫不犹豫的上升直线:基线从 ~7 GiB 一路爬到 ~19 GiB,平均每天涨 2.4 GiB(尖峰另算,最高摸到 27.9 GiB)。记住这条线的形状,第十节它还会再出现一次。
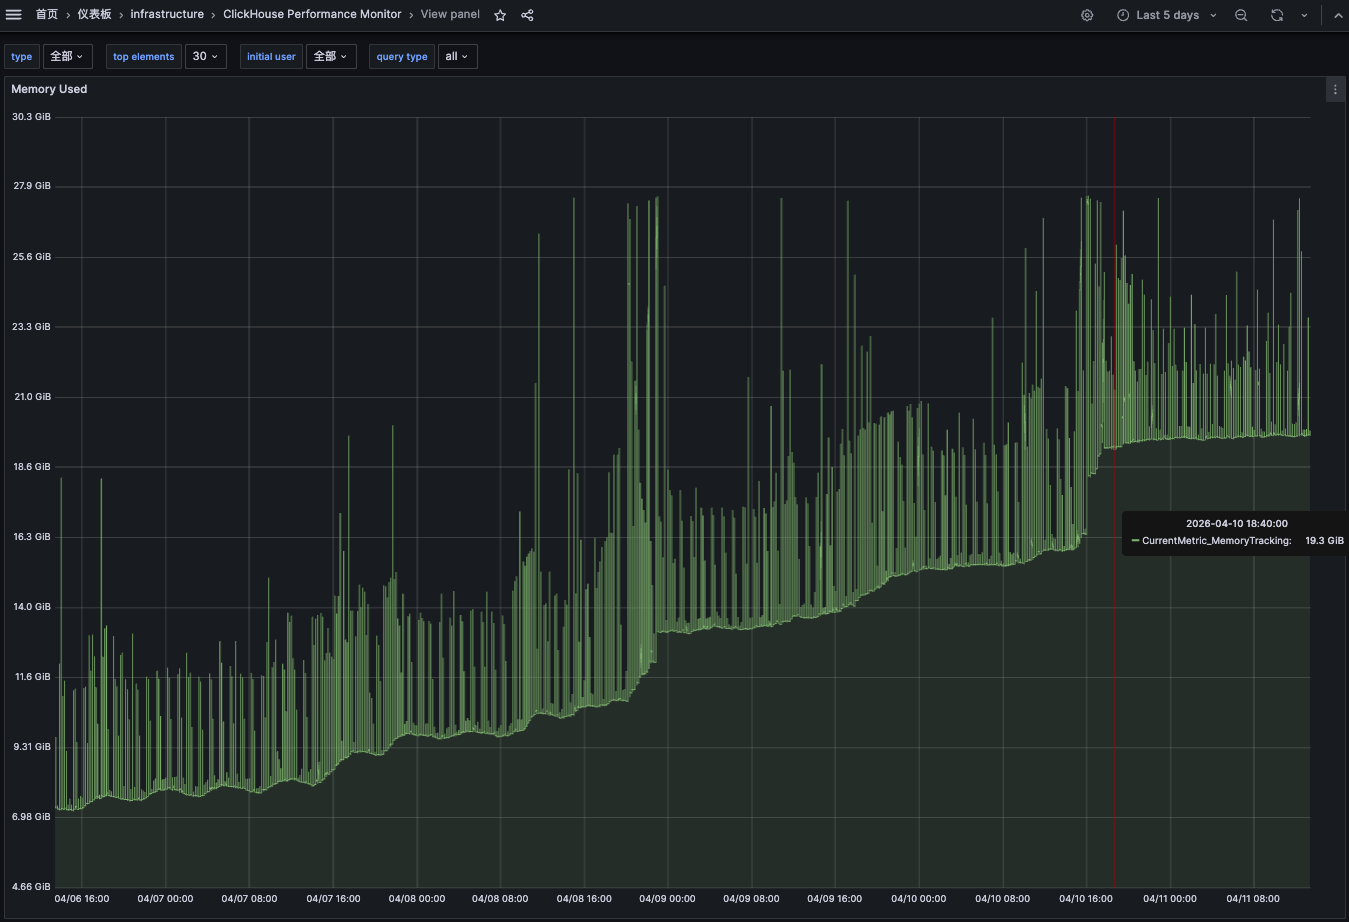
机器总内存约 30GB,CK(ClickHouse,下文简称 CK)摸到 22GB 上下就开始触发我们的告警。
二、第一回合:常规排查
按 ClickHouse 内存问题的标准套路,先把"嫌疑人名单"过一遍。
2.1 看各类内存指标分布
SELECT
    metric,
    formatReadableSize(value) AS size
FROM system.metrics
WHERE metric LIKE '%Memory%' OR metric LIKE '%Cache%'
ORDER BY value DESC;
| metric | size |
|---|---|
| MemoryTracking | 18.4 GiB |
| MemoryTrackingUncorrected | 16.16 MiB |
| MergesMutationsMemoryTracking | -448.00 B |
| 其他 Cache 相关 | 几乎全是 0.00 B |
MemoryTracking 是 ClickHouse 自己跟踪的内存总量,排查开始时是 18.4 GiB(后面会看到它还在继续涨)。
但奇怪的是其他细分指标几乎全是 0。各种 Cache 都没用,这 18 个 G 到底是谁吃的?
还有个小细节:MergesMutationsMemoryTracking 居然是负值。内存还能用成负数,说明这套记账的加减并不总是对称——先记下来。
2.2 看是否有残留的 Memory 引擎临时表
Memory 引擎的表是常见"内存泄露源"——数据全在内存里,不主动 DROP 就不会释放。
SELECT `database`, name, `engine`,
       formatReadableSize(total_bytes) AS size,
       metadata_modification_time
FROM system.tables
WHERE `engine` = 'Memory';
| database | name | engine | size |
|---|---|---|---|
| tmp | tmp_pair_first_pay | Memory | 0.00 B |
| tmp | tmp_pair_messages | Memory | 0.00 B |
两张临时表都是空的。排除。
2.3 看各表内存占用(含主键 + 压缩 + 未压缩)
SELECT
    database, table,
    formatReadableSize(sum(primary_key_bytes_in_memory))  AS pk_memory,
    formatReadableSize(sum(data_compressed_bytes))        AS compressed,
    formatReadableSize(sum(data_uncompressed_bytes))      AS uncompressed,
    sum(rows)  AS total_rows,
    count()    AS parts_count
FROM system.parts
WHERE active
GROUP BY database, table
ORDER BY sum(primary_key_bytes_in_memory) DESC
LIMIT 10;
| database | table | pk_memory | compressed | uncompressed | rows | parts |
|---|---|---|---|---|---|---|
| ods | ods_event_log | 2.83 MiB | 121.76 GiB | 698.95 GiB | 9.2 亿 | 402 |
| ods | ods_im_message_ext | 2.45 MiB | 52.21 GiB | 207.75 GiB | 5.5 亿 | 64 |
| dws | dws_user_activity_hour | 1.31 MiB | 352.21 MiB | 9.26 GiB | 4.3 亿 | 7 |
| ods | ods_tb_user_extra_info | 930.49 KiB | 1.10 GiB | 2.56 GiB | 1098 万 | 246 |
| … | … | … | … | … | … | … |
| system | trace_log | 128.47 KiB | 24.67 GiB | 269.15 GiB | 7.6 亿 | 32 |
注意最后一行:system.trace_log 24.67 GiB 压缩、269 GiB 未压缩、7.6 亿行。
trace_log 是 ClickHouse 内部的性能采样日志,默认保留时间很长。一旦没配 TTL,它能涨到吓人。这是头号嫌疑。
2.4 看未合并的 parts 数量
SELECT database, table,
       count() AS parts,
       sum(rows) AS total_rows,
       formatReadableSize(sum(bytes_on_disk)) AS disk_size
FROM system.parts
WHERE active
GROUP BY database, table
HAVING parts > 50
ORDER BY parts DESC;
| database | table | parts | rows | disk |
|---|---|---|---|---|
| ods | ods_tb_user_action_record | 589 | 4.2 亿 | 8.20 GiB |
| dwd | dwd_log_track_user | 432 | 7700 万 | 2.46 GiB |
| ods | ods_event_log | 399 | 9.2 亿 | 121.78 GiB |
| ods | ods_mongo_trace_logs | 324 | 8.9 亿 | 46.30 GiB |
| … | … | … | … | … |
parts 数 500+ 是另一个警钟——后台 merge 跟不上写入。parts 多了不仅查询慢,每个 part 的元数据也都吃内存。
2.5 看 mark cache 和解压缓存
SELECT name, formatReadableSize(value) AS size
FROM system.asynchronous_metrics
WHERE name IN ('MarkCacheBytes', 'MarkCacheFiles',
               'UncompressedCacheBytes', 'UncompressedCacheCells');
| name | size |
|---|---|
| MarkCacheBytes | 40.57 MiB |
| UncompressedCacheBytes | 0.00 B |
| MarkCacheFiles | 38.90 KiB |
| UncompressedCacheCells | 0.00 B |
Mark cache 才 40 MB,解压缓存压根没用。也不是缓存的锅。
三、第一回合处理
线索基本清晰:trace_log 等 system 日志表 + 高碎片业务表两座大山。先动手清。
3.1 TRUNCATE 体积最大的 system 日志表
TRUNCATE TABLE system.trace_log;
TRUNCATE TABLE system.text_log;
TRUNCATE TABLE system.processors_profile_log;
TRUNCATE TABLE system.asynchronous_metric_log;
-- query_log / metric_log 留着,按时间删
ALTER TABLE system.query_log  DELETE WHERE event_date < today() - 3;
ALTER TABLE system.metric_log DELETE WHERE event_date < today() - 3;
3.2 配置 TTL 防复发
<!-- /etc/clickhouse-server/config.d/log_tables_ttl.xml -->
<clickhouse>
    <query_log>              <ttl>event_date + INTERVAL 7 DAY DELETE</ttl></query_log>
    <trace_log>              <ttl>event_date + INTERVAL 3 DAY DELETE</ttl></trace_log>
    <text_log>               <ttl>event_date + INTERVAL 3 DAY DELETE</ttl></text_log>
    <metric_log>             <ttl>event_date + INTERVAL 7 DAY DELETE</ttl></metric_log>
    <asynchronous_metric_log><ttl>event_date + INTERVAL 3 DAY DELETE</ttl></asynchronous_metric_log>
    <processors_profile_log> <ttl>event_date + INTERVAL 3 DAY DELETE</ttl></processors_profile_log>
</clickhouse>
3.3 低峰期 OPTIMIZE 高碎片业务表
-- 3 分多
OPTIMIZE TABLE ods.ods_tb_user_action_record FINAL;
-- 1 分多
OPTIMIZE TABLE dwd.dwd_log_track_user FINAL;
-- 44 分钟(这张表确实大)
OPTIMIZE TABLE ods.ods_event_log FINAL;
⚠️
OPTIMIZE FINAL自身会消耗大量内存,建议低峰期串行执行,不要并行。
四、然而……内存没降
按理说,TRUNCATE 几张几十 G 的 system 日志表 + OPTIMIZE 高碎片业务表,内存应该有个明显回落。
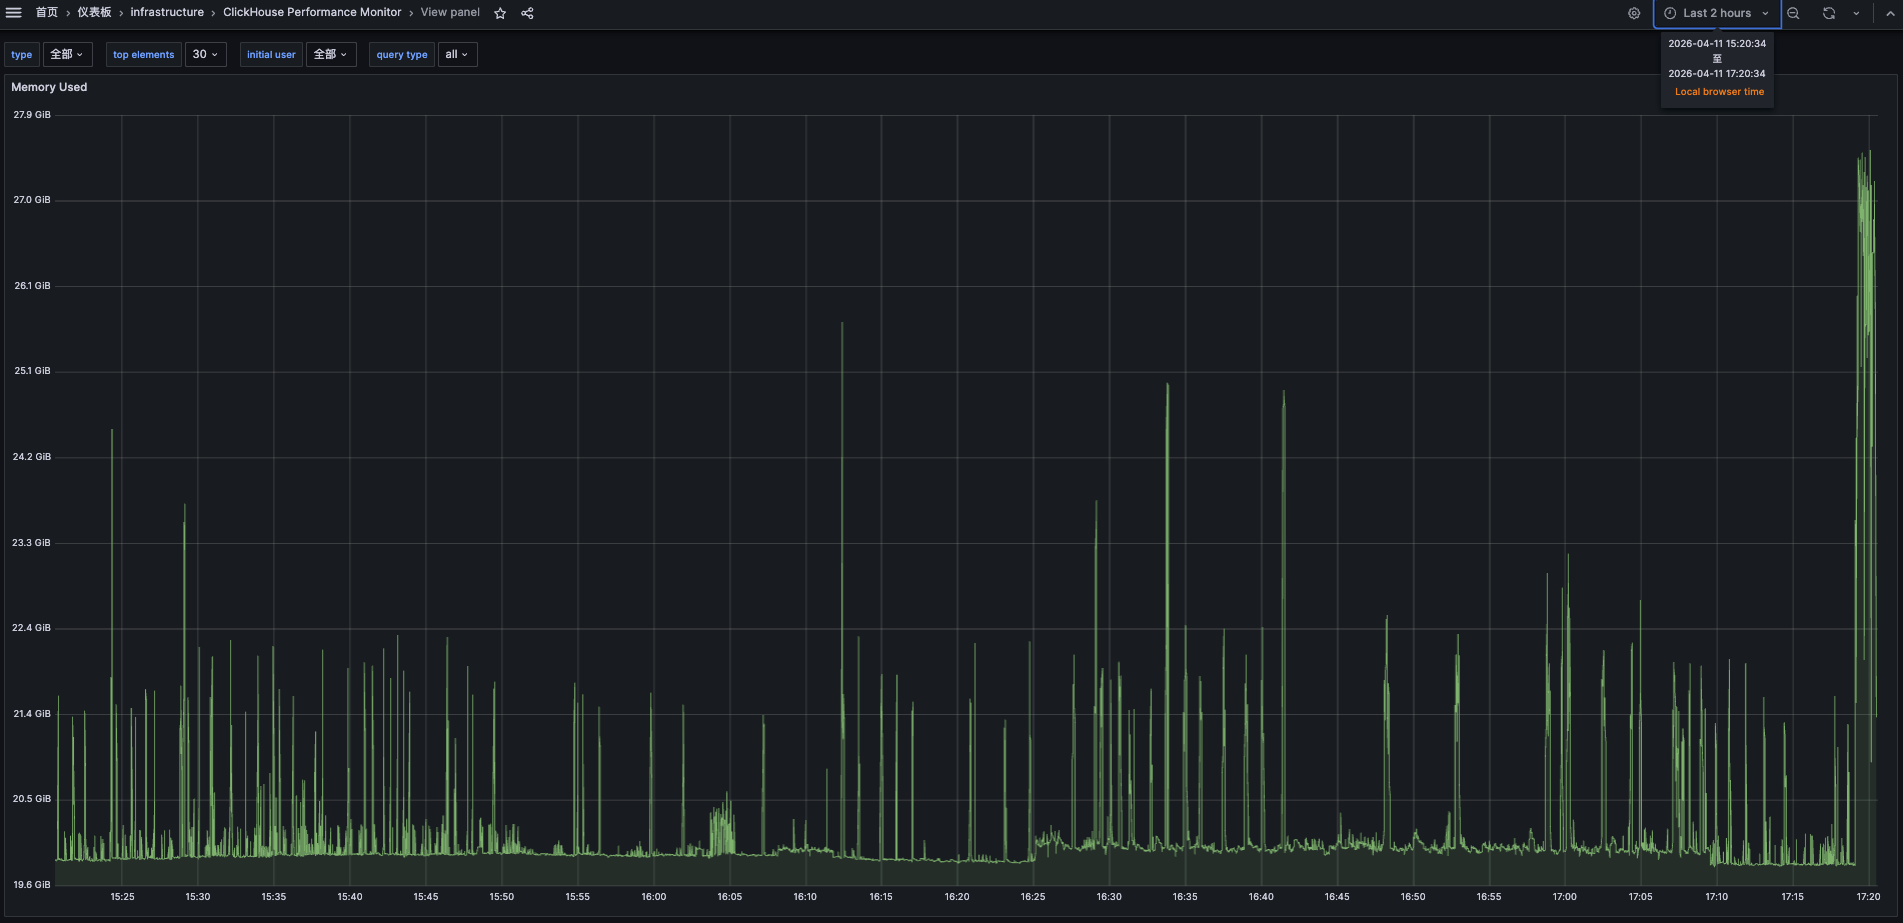
实际情况是——几乎没动。监控图依旧是那条优雅的上升直线。
我的内心活动:
我:trace_log 24G 都干掉了,怎么不降?
ClickHouse:你猜啊。
只能继续往里挖。
五、第二回合:深入排查
注意:排查过程中 CK 还在持续运行,
MemoryTracking已经从第一回合的 18.4 GiB 涨到了 20.6 GiB——它不等人。
5.1 正在运行的查询
SELECT query_id, user,
       formatReadableSize(memory_usage) AS memory,
       elapsed, substring(query, 1, 120) AS query_short
FROM system.processes
ORDER BY memory_usage DESC;
结果只有我自己跑的这条查询本身。没有任何用户查询在占内存。
5.2 后台 merge
SELECT database, table,
       formatReadableSize(memory_usage) AS memory,
       elapsed, progress, num_parts
FROM system.merges
ORDER BY memory_usage DESC;
| database | table | memory | progress |
|---|---|---|---|
| system | asynchronous_metric_log | 17.06 MiB | 56% |
只有一个 17MB 的小 merge,也不是它。
5.3 各 db 的 parts 元数据
SELECT database,
       count() AS parts_count,
       formatReadableSize(sum(primary_key_bytes_in_memory))           AS pk_in_memory,
       formatReadableSize(sum(primary_key_bytes_in_memory_allocated)) AS pk_allocated
FROM system.parts
WHERE active
GROUP BY database
ORDER BY sum(primary_key_bytes_in_memory_allocated) DESC;
| database | parts_count | pk_in_memory | pk_allocated |
|---|---|---|---|
| ods | 3,964 | 9.39 MiB | 10.45 MiB |
| dws | 206 | 1.31 MiB | 1.33 MiB |
| dwd | 384 | 729.37 KiB | 1.20 MiB |
| system | 206 | 154.96 KiB | 194.93 KiB |
| … | … | … | … |
全部加起来才 13 MB 不到。和 20 GiB 差着 1500 倍,根本不是一个量级。
5.4 ⭐ 最关键的一查:CK 内部各组件内存分配
SELECT metric, formatReadableSize(value) AS size
FROM system.asynchronous_metrics
WHERE lower(metric) LIKE '%cache%'
   OR lower(metric) LIKE '%memory%'
   OR lower(metric) LIKE '%rss%'
   OR lower(metric) LIKE '%pool%'
ORDER BY value DESC
LIMIT 30;
| metric | size |
|---|---|
| MemoryVirtual | 59.83 GiB |
| MemoryDataAndStack | 58.87 GiB |
| OSMemoryTotal | 30.64 GiB |
| OSMemoryAvailable | 26.00 GiB |
| CGroupMemoryUsed | 25.45 GiB |
| OSMemoryFreePlusCached | 25.41 GiB |
| MemoryResidentMax | 23.33 GiB |
| OSMemoryCached | 22.17 GiB |
| OSMemoryFreeWithoutCached | 3.24 GiB |
| MemoryResidentWithoutPageCache | 2.58 GiB |
| MemoryResident | 2.58 GiB |
| MemoryCode | 319.02 MiB |
| MemoryShared | 74.79 MiB |
| MarkCacheBytes | 30.52 MiB |
| TotalPrimaryKeyBytesInMemoryAllocated | 13.39 MiB |
| … | … |
这一查直接让我懵了。
| 视角 | 数值 | 含义 |
|---|---|---|
MemoryTracking(CK 视角) | 20.6 GiB | CK 自己跟踪的内存使用量 |
MemoryResident(OS 视角) | 2.58 GiB | OS 看到的进程 RSS(实际物理内存) |
差了将近 8 倍。
CK 在喊"我用了 20G!“,操作系统在说"你才用了 2.5G 啊兄弟”。到底听谁的?
按道理 MemoryResident(RSS)才是真实物理内存占用。可既然 RSS 才 2.5G,监控曲线为什么还在涨、内存为什么吃得越来越紧?
5.5 inactive parts 是不是没物理清理
SELECT database, table,
       count() AS inactive_parts,
       formatReadableSize(sum(bytes_on_disk)) AS disk_size
FROM system.parts
WHERE NOT active AND database = 'system'
GROUP BY database, table
ORDER BY sum(bytes_on_disk) DESC;
| table | inactive_parts | disk_size |
|---|---|---|
| metric_log | 76 | 340.76 MiB |
| query_views_log | 128 | 103.99 MiB |
| asynchronous_metric_log | 138 | 63.40 MiB |
| … | … | … |
确实有几百 MB 的 inactive parts 没回收,但也就 600 MB 量级,不至于撑起 20G 的差值。
六、第三回合:继续追凶
到这里还没找到凶手,再排除几个冷门嫌疑。
| 嫌疑 | 查询 | 结果 |
|---|---|---|
| Lightweight delete 残留 | has_lightweight_delete 列 | 全是 0,排除 |
| 后台 mutation 未完成 | system.mutations WHERE is_done != 1 | 空,排除 |
| 外部 dictionary | system.dictionaries | 空,没用 |
| stack trace 分配 | sum(size) FROM system.stack_trace | 量级不对 |
常规嫌疑人名单全过完了,主谋还没找到。
七、尝试解决
7.1 方案 1:强制 jemalloc 释放(无效)
ClickHouse 用 jemalloc 做内存分配。理论上,应用层"释放"了内存后,jemalloc 可能还把页面缓存在自己手里没还给 OS。SYSTEM JEMALLOC PURGE 就是强制 jemalloc 把这些页面归还。
SYSTEM JEMALLOC PURGE;
-- Updated Rows: -1
-- Execute time: 43s
执行了 43 秒,看起来很认真在干活。然后查内存:
SELECT formatReadableSize(value) FROM system.metrics WHERE metric = 'MemoryTracking';
结果:还是 20G 左右。
jemalloc:你说释放就释放,那我面子往哪儿搁?
7.2 方案 2:重启 CK(有效,但不优雅)
最后只能祭出"重启大法"。先确认没在跑重要的东西:
-- 没有用户查询
SELECT count() FROM system.processes WHERE query NOT LIKE '%system.processes%';
-- 没有进行中的 merge
SELECT count() FROM system.merges;
两个都是 0,可以重启:
# systemd
systemctl restart clickhouse-server

# Docker
docker restart <clickhouse-container>
重启后再看:
SELECT formatReadableSize(value) FROM system.metrics WHERE metric = 'MemoryTracking';
-- 920 MiB
从 20G 直接降到不到 1G。 重启大法好。
但下次再涨上去,难道还得重启?不能每次都靠半夜爬起来执行 docker restart。
八、核心谜题:MemoryTracking vs MemoryResident,相信谁?
到这里,临时表、缓存、主键、查询、merge、mutation、字典都排除了,inactive parts 只占 600 MB,PURGE 也没用。剩下的只有一组对不上的数:
MemoryTracking      = 20.6  GiB   (CK 自己跟踪)
MemoryResident      =  2.58 GiB   (OS 看到的 RSS)
MemoryResidentMax   = 23.33 GiB   (历史峰值 RSS)
CGroupMemoryUsed    = 25.45 GiB   (cgroup 视角)
当时我列了四个猜想。先剧透:猜想 1 是对的,其余三个的结论放在第十节的对照表里。
猜想 1:MemoryTracking 计数器漂移
ClickHouse 的 MemoryTracking 是应用层手动维护的计数器,每次分配/释放都靠代码主动更新。如果某个路径只 +=、不 -=(或者反过来),就会漂移。
§2.1 里 MergesMutationsMemoryTracking = -448 B 是第一条线索:同一套记账机制已经算出了负数,加减并不对称。
那 MemoryResidentMax = 23.33 GiB 怎么解释?乍看像是"OS 也承认吃到过 23 G",于是这条猜想就被推翻了。但这个指标是历史峰值,不是当前值——官方定义是 “Maximum amount of physical memory used by the server process”,源码里取的是 getrusage(RUSAGE_SELF).ru_maxrss,即进程启动以来的最高水位线,一旦冲上去就再也不会降。
把这几个数按时间顺序重读一遍,它们讲的其实是同一件事:
| 指标 | 数值 | 说明 |
|---|---|---|
MemoryResidentMax | 23.33 GiB | RSS 曾经真的到过这个水位 |
MemoryResident | 2.58 GiB | 但现在只剩这么多——物理内存已经还给 OS 了 |
MemoryTracking | 20.6 GiB | 而 CK 的计数器没跟着降回来 |
MergesMutationsMemoryTracking | -448 B | 同一套计数器已经算出了负数 |
RSS 涨上去又降回来、计数器只涨不降——这正是"计数器漂移"该有的样子。 所以 MemoryResidentMax 非但不是猜想 1 的反证,反而是它最直接的旁证。
⚠️ 但漂移说也有它圆不回来的地方:§5.4 那次快照里 OSMemoryAvailable 还有 26 GiB(总共 30.64 GiB),机器其实根本不缺内存。那为什么非重启不可?如果只是个计数器在虚报,把机器从 32G 扩到 64G 又为什么真的换来了时间(见 §9.3)?这两问当时答不上来,答案在第十节——两个都指向同一处源码。
猜想 2~4:page cache 虚高、隐藏缓存、jemalloc dirty pages
CGroupMemoryUsed = 25 GiB、OSMemoryCached = 22 GiB,像是 page cache 把 cgroup 占用撑高了;- CK 里还有没暴露到
system.metrics的缓存在涨; - jemalloc 的 dirty pages 没还回去,
JEMALLOC PURGE没生效。
根因没找到之前,线上不能裸奔,于是有了下面这套缓解方案。
九、当时的缓解方案:监控 + 定时重启 + 加内存
这一节是根因找到之前的权宜之计。监控和告警继续有用;定时重启和加内存,在第十节的配置生效后已经不需要了,见 9.3。
9.1 Grafana 监控看板
指标选择:用 system.metrics.MemoryTracking(CK 进程自身跟踪的内存),不要用 CGroupMemoryUsed(含 page cache 虚高,前面猜想 2 说过)。
历史数据:system.metric_log 自动记录 CurrentMetric_MemoryTracking 的历史值,不需要额外 exporter。
-- Grafana 官方插件语法
SELECT
    event_time AS time,
    CurrentMetric_MemoryTracking / 1073741824 AS memory_gib
FROM system.metric_log
WHERE event_time >= toDateTime64($__from / 1000, 3, 'Asia/Shanghai')
  AND event_time <  toDateTime64($__to   / 1000, 3, 'Asia/Shanghai')
ORDER BY event_time
9.2 告警规则:连续 4 小时超阈值
Grafana 的 Alerting → New alert rule:
Query A:按小时聚合取 max
SELECT
    toStartOfHour(event_time) AS t,
    max(CurrentMetric_MemoryTracking) / 1073741824 AS memory_gib
FROM system.metric_log
WHERE event_time >= now() - INTERVAL 4 HOUR
GROUP BY t
ORDER BY t
Expression 配置:
- Expression B(Reduce):Function = Min,Input = A —— 对 4 小时的 max 值取 min;最低值都超标,才算"持续超标"
- Expression C(Threshold):Input = B,Condition = IS ABOVE 15.32 —— 容器 30.64 GiB 的 50%
- Alert condition 选 C
Evaluation:
- Evaluate every
5m - Pending period
0s(SQL 已用 4 小时窗口,无需再等)
阈值按容器总内存的 50% 算,扩容后记得同步改 Expression C。
9.3 定时重启和加内存:已经不需要了
当时的兜底分两步:先是 cron 定时重启(每天固定一次,或 MemoryTracking 超过 15 GiB 才重启);后来漂移越来越快、重启间隔越缩越短,干脆把机器从 4C32G 升到 4C64G,「重启保平安」从每天一次变成每周一次。
这两招都只是在推迟计数器撞上限的时间——第十节会讲清楚为什么加内存真的能换来时间。打开校正之后,计数器不会再漂,定时重启的 cron 可以撤掉;64G 是否降回去,按真实查询峰值来定,别按当初的漂移速度算。
十、破案:计数器只在启动时校正一次
10.1 第二次发作:真实内存 15G,查询却被拦在 55G
第一次排查约半年后的一个上午(机器早已升到 64G),业务查询开始成批报错:
Code: 241. DB::Exception: (total) memory limit exceeded: would use 55.60 GiB
(attempt to allocate chunk of 4.11 MiB bytes), current RSS: 15.03 GiB, maximum: 55.59 GiB.
OvercommitTracker decision: Query was selected to stop by OvercommitTracker ...
(MEMORY_LIMIT_EXCEEDED) (version 25.4.7.66 (official build))
同一行报错里两个数对不上:would use 55.60 GiB 是计数器的账,current RSS: 15.03 GiB 才是进程真实占的物理内存。上限 55.59 GiB 等于物理内存约 61.8 GiB 乘以默认的 max_server_memory_usage_to_ram_ratio = 0.9。监控上,基线 5 天里从 ~10G 单调爬到 ~43G——形状和第一节那条线一样,只是爬得更快(每天约 6.6G)、顶得更高。
这一下把第八节那两个答不上来的问题都答了:
- 为什么非重启不可:服务端的超限判断看的就是这个计数器。25.4 源码
src/Common/MemoryTracker.cpp里的条件是will_be > current_hard_limit || will_be_rss > current_hard_limit,两个任意一个超了就拒绝分配。账虚高到上限,真实内存再空也照样拒查询。 - 为什么加内存真的换来了时间:上限是「物理内存 × 0.9」,内存翻倍,漂移撞上限的时间也跟着翻倍。机器其实从来不缺内存,缺的是一本记对的账。
10.2 根因:后台线程默认只读不改
MemoryTracking 是个纯计数器:分配时加、释放时减。只要某条路径加和减不对称,误差就留在里面,进程活多久就留多久。
ClickHouse 有一个后台线程 MemoryWorker,专门对这本账:每 50 ms 读一次 cgroup 的内存用量(cgroup 不可用时读 jemalloc),用来更新 RSS。但用 jemalloc 的真实分配量 allocated 回写计数器,25.4 只在三种情况下做(src/Common/MemoryWorker.cpp):
- 线程第一次运行,也就是进程刚启动;
- 计数器变成了负数;
- 配置
memory_worker_correct_memory_tracker为 true。
第 3 条的默认值是 0。所以默认情况下,计数器只在启动时被校正一次,之后往下漂会被拉回来,往上漂没人管。
这个默认值我在测试机的 25.4.13.22 上查过 system.server_settings:value = 0,changeable_without_restart = No,改了要重启才生效。翻了各版本源码:25.4 到 26.9 默认都是 0,26.10 起改成了 1。新版的配置说明把这个坑写得很直白:“an upward drift is never worked off … the server rejects all queries while using a fraction of its limit.”
回头对一遍前面每一步的「没用」:
| 当时的现象 | 解释 |
|---|---|
| 重启后从 20G 降到 920 MiB | 启动时 MemoryWorker 第一次运行,校正了一次 |
SYSTEM JEMALLOC PURGE 无效 | purge 把空闲页还给 OS,降的是 RSS;计数器不受影响 |
| TRUNCATE / OPTIMIZE 无效 | 漂移是记账误差,和表的数据量无关 |
§2.1 里 MemoryTrackingUncorrected 只有 16 MiB | 这个指标只在校正时更新。启动后再没校正过,它就一直停在启动那一刻的值 |
| 猜想 2:page cache 把 cgroup 撑高 | CGroupMemoryUsed 确实含 page cache,但计数器不看它 |
| 猜想 3、4:隐藏缓存、jemalloc dirty pages | 都不成立。RSS 只有 2.5G,本来就没有多少内存可还 |
还没查清的是:具体哪条分配或释放路径在漏记。打开校正后它已经不影响业务,我就没再往下挖。
10.3 先确认你是不是同一个病
两条只读 SQL:
-- 计数器 vs jemalloc 真实分配 vs RSS:MemoryTracking 远大于 jemalloc.allocated 即为漂移
SELECT 'MemoryTracking' AS k, formatReadableSize(value) AS v FROM system.metrics WHERE metric = 'MemoryTracking'
UNION ALL SELECT 'MemoryTrackingUncorrected', formatReadableSize(value) FROM system.metrics WHERE metric = 'MemoryTrackingUncorrected'
UNION ALL SELECT metric, formatReadableSize(value) FROM system.asynchronous_metrics
          WHERE metric IN ('jemalloc.allocated', 'jemalloc.resident', 'MemoryResident', 'CGroupMemoryUsed');

-- 当前配置值,value = 0 且 changed = 0 就是默认关着
SELECT name, value, changed FROM system.server_settings WHERE name LIKE 'memory_worker%';
我们线上第二次发作当天的结果:
MemoryTracking      44.46 GiB   ← CK 记的账
CGroupMemoryUsed    35.62 GiB   ← cgroup 用量,含 page cache
MemoryResident       2.86 GiB   ← 进程 RSS
jemalloc.allocated   2.22 GiB   ← 真实分配量

memory_worker_correct_memory_tracker = 0(changed = 0)
账比真实分配多出约 42G。报错时的 RSS 是 15G,比这里高,是因为那一刻有大查询在跑。
10.4 修复:一行配置,再重启最后一次
<!-- /etc/clickhouse-server/config.d/memory_worker.xml -->
<clickhouse>
    <memory_worker_correct_memory_tracker>1</memory_worker_correct_memory_tracker>
</clickhouse>
重启后先确认生效:server_settings 里这一项 value = 1, changed = 1;MemoryTracking 1.23 GiB,jemalloc.allocated 1.19 GiB,两本账对上了。

左半边是改之前:基线 42G 起步,还在往上爬,上面的毛刺是真实查询。中间那道断崖就是重启生效的时刻。右半边观察了约一天半:基线贴着 1G 走,没有再爬。毛刺照旧,最高 40 多 G,那是真实查询的峰值,和计数器无关。
暂时没有重启窗口的话,可以先调高 max_server_memory_usage 止血,它支持热加载。但这个上限同时管着 RSS,调到超过物理内存,真实内存失控时就只能等 OOM,只适合撑到重启窗口。
附录:本文用到的全部排查 SQL 速查
为了方便你直接复现,全部 SQL 整理在这里。除了第三节的 TRUNCATE / OPTIMIZE,其余都是只读:
-- 1. 看各类内存指标分布
SELECT metric, formatReadableSize(value) AS size
FROM system.metrics
WHERE metric LIKE '%Memory%' OR metric LIKE '%Cache%'
ORDER BY value DESC;

-- 2. 看 Memory 引擎的临时表
SELECT `database`, name, `engine`,
       formatReadableSize(total_bytes) AS size,
       metadata_modification_time
FROM system.tables
WHERE `engine` = 'Memory'
ORDER BY total_bytes DESC;

-- 3. 看各表内存占用(含主键 + 压缩 + 未压缩)
SELECT database, table,
       formatReadableSize(sum(primary_key_bytes_in_memory)) AS pk_memory,
       formatReadableSize(sum(data_compressed_bytes))       AS compressed,
       formatReadableSize(sum(data_uncompressed_bytes))     AS uncompressed,
       sum(rows) AS total_rows,
       count()   AS parts_count
FROM system.parts
WHERE active
GROUP BY database, table
ORDER BY sum(primary_key_bytes_in_memory) DESC
LIMIT 20;

-- 4. 看未合并的 parts 数量
SELECT database, table,
       count() AS parts,
       sum(rows) AS total_rows,
       formatReadableSize(sum(bytes_on_disk)) AS disk_size
FROM system.parts
WHERE active
GROUP BY database, table
HAVING parts > 50
ORDER BY parts DESC;

-- 5. 看 mark / uncompressed cache
SELECT name, formatReadableSize(value) AS size
FROM system.asynchronous_metrics
WHERE name IN ('MarkCacheBytes', 'MarkCacheFiles',
               'UncompressedCacheBytes', 'UncompressedCacheCells');

-- 6. 看正在运行的查询
SELECT query_id, user,
       formatReadableSize(memory_usage) AS memory,
       elapsed, substring(query, 1, 120) AS query_short
FROM system.processes
ORDER BY memory_usage DESC;

-- 7. 看后台 merge
SELECT database, table,
       formatReadableSize(memory_usage) AS memory,
       elapsed, progress, num_parts,
       formatReadableSize(total_size_bytes_compressed) AS merge_size
FROM system.merges
ORDER BY memory_usage DESC;

-- 8. ⭐ 看 CK 内部组件内存(最关键)
SELECT metric, formatReadableSize(value) AS size
FROM system.asynchronous_metrics
WHERE lower(metric) LIKE '%cache%'
   OR lower(metric) LIKE '%memory%'
   OR lower(metric) LIKE '%rss%'
   OR lower(metric) LIKE '%pool%'
ORDER BY value DESC
LIMIT 30;

-- 9. 看 inactive parts
SELECT database, table,
       count() AS inactive_parts,
       formatReadableSize(sum(bytes_on_disk)) AS disk_size
FROM system.parts
WHERE NOT active
GROUP BY database, table
ORDER BY sum(bytes_on_disk) DESC;

-- 10. 看后台 mutation
SELECT database, table, mutation_id, command, create_time,
       is_done, latest_fail_reason
FROM system.mutations
WHERE is_done != 1
ORDER BY create_time;

-- 11. 看 dictionary
SELECT name, formatReadableSize(bytes_allocated) AS memory, element_count
FROM system.dictionaries
ORDER BY bytes_allocated DESC;

-- 12. Grafana 看板:MemoryTracking 历史曲线
SELECT event_time AS time,
       CurrentMetric_MemoryTracking / 1073741824 AS memory_gib
FROM system.metric_log
WHERE event_time >= toDateTime64($__from / 1000, 3, 'Asia/Shanghai')
  AND event_time <  toDateTime64($__to   / 1000, 3, 'Asia/Shanghai')
ORDER BY event_time;

-- 13. 告警查询:近 4 小时按小时 max
SELECT toStartOfHour(event_time) AS t,
       max(CurrentMetric_MemoryTracking) / 1073741824 AS memory_gib
FROM system.metric_log
WHERE event_time >= now() - INTERVAL 4 HOUR
GROUP BY t
ORDER BY t;

-- 14. 强制 jemalloc 释放(降的是 RSS,对计数器漂移无效)
SYSTEM JEMALLOC PURGE;

-- 15. 重启前确认安全
SELECT count() FROM system.processes
WHERE query NOT LIKE '%system.processes%';
SELECT count() FROM system.merges;

-- 16. 漂移诊断:MemoryTracking 远大于 jemalloc.allocated 即为漂移
SELECT 'MemoryTracking' AS k, formatReadableSize(value) AS v FROM system.metrics WHERE metric = 'MemoryTracking'
UNION ALL SELECT 'MemoryTrackingUncorrected', formatReadableSize(value) FROM system.metrics WHERE metric = 'MemoryTrackingUncorrected'
UNION ALL SELECT metric, formatReadableSize(value) FROM system.asynchronous_metrics
          WHERE metric IN ('jemalloc.allocated', 'jemalloc.resident', 'MemoryResident', 'CGroupMemoryUsed');

-- 17. 计数器校正开没开(value = 0 即默认关着)
SELECT name, value, changed FROM system.server_settings WHERE name LIKE 'memory_worker%';
延伸阅读
- ClickHouse 内存爆了?一次增量 SQL 从 8.6 GiB 干到 115 MiB 的实战复盘 —— 同样是 CK 内存告警,但这篇的锅在查询本身,从 SQL 侧把峰值内存打下来,和本文的计数器视角互补。
- 1443 行 INSERT 跑了 16 分钟,凶手不是 ClickHouse 并发控制:一次误判复盘 + 4 个复现实验 —— 另一个「指标会骗人」的例子:ConcurrencyControl 指标看着像在排队,复现之后发现根本没排队。
📅 最后更新:2026-10-30,根因已找到,新增第十节:25.4 的 MemoryWorker 默认不回写计数器,打开
memory_worker_correct_memory_tracker并重启即可根治。原第十节「求助」、第十一节「持续更新」删除;第九节的定时重启和加内存改为「已不需要」,脚本删除;第八节猜想改为指向结论;附录补两条诊断 SQL。2026-09-30,两处订正。① §八 结论反了:原文拿
MemoryResidentMax = 23.33 GiB反驳「计数器漂移」、断言「OS 不会撒谎」——查官方文档后确认它是历史峰值不是当前值,RSS 冲上去又降回 2.58 GiB,反而是漂移的旁证。② 告警 SQL 与说明不符:§9.2 和附录第 13 条正文写「按小时取 max」、SQL 却是min(),已改回max()——照旧版抄会得到另一种告警语义。
更多推荐

 15
 0
- 0


 已为社区贡献15条内容

所有评论(0)