
机器学习实践——基于KNN算法的手写数字识别
·
一.案例介绍
将42000个手写数字数据进行读取,进行数据格式转换、数据打印、模型选练、模型保存、模型评估,以达到KNN算法练习的目的
二.代码部分详解
1.导包
import matplotlib.pyplot as plt
import pandas as pd
import matplotlib
matplotlib.use('TkAgg')   # 解决后端错误
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.neighbors import KNeighborsClassifier
import joblib                                                           #保存模型
from collections import Counter                                         #去重统计
from sklearn.metrics import accuracy_score
2.数据读取
#1.接收用户传入的索引,展示该索引对应的图片
def show_digit(idx):
    #1.读取数据集,获取到原数据
    df = pd.read_csv('./data/手写数字识别.csv')
    #print(df)         #(42000行*785列)

    #2.判断传入的索引是否越界
    if idx < 0 or idx > len(df) - 1:
        print('索引越界')
        return

    #3.走这里,说明没有越界,就正常获取数据
    x = df.iloc[:, 1:]   #第一个冒号代表所有数据,第二个代表从编号1开始拿数据
    y = df.iloc[:,0]
    #4.查看用户传入的索引对应的图片是几
    print(f'该图片对应的数字是:{y.iloc[idx]}')
    print(f'查看所有的标签的分布情况:{Counter(y)}')

    #5.查看下 用户传入的索引图片 的形状
    print(x.iloc[idx].shape)    #(784)  我们要想办法把(784)转换为(28,28)
    #print(x.iloc[idx].values)   #具体的784个像素点数据

    #6.把(748)转化为(28*28)
    x = x.iloc[idx].values.reshape(28, 28)
    #print(x)   #已经转化为28 * 28像素点

    #7.具体的绘制灰度图的动作
    plt.imshow(x,cmap='gray')   #灰度图
    plt.axis('off')             #不显示坐标
    plt.show()
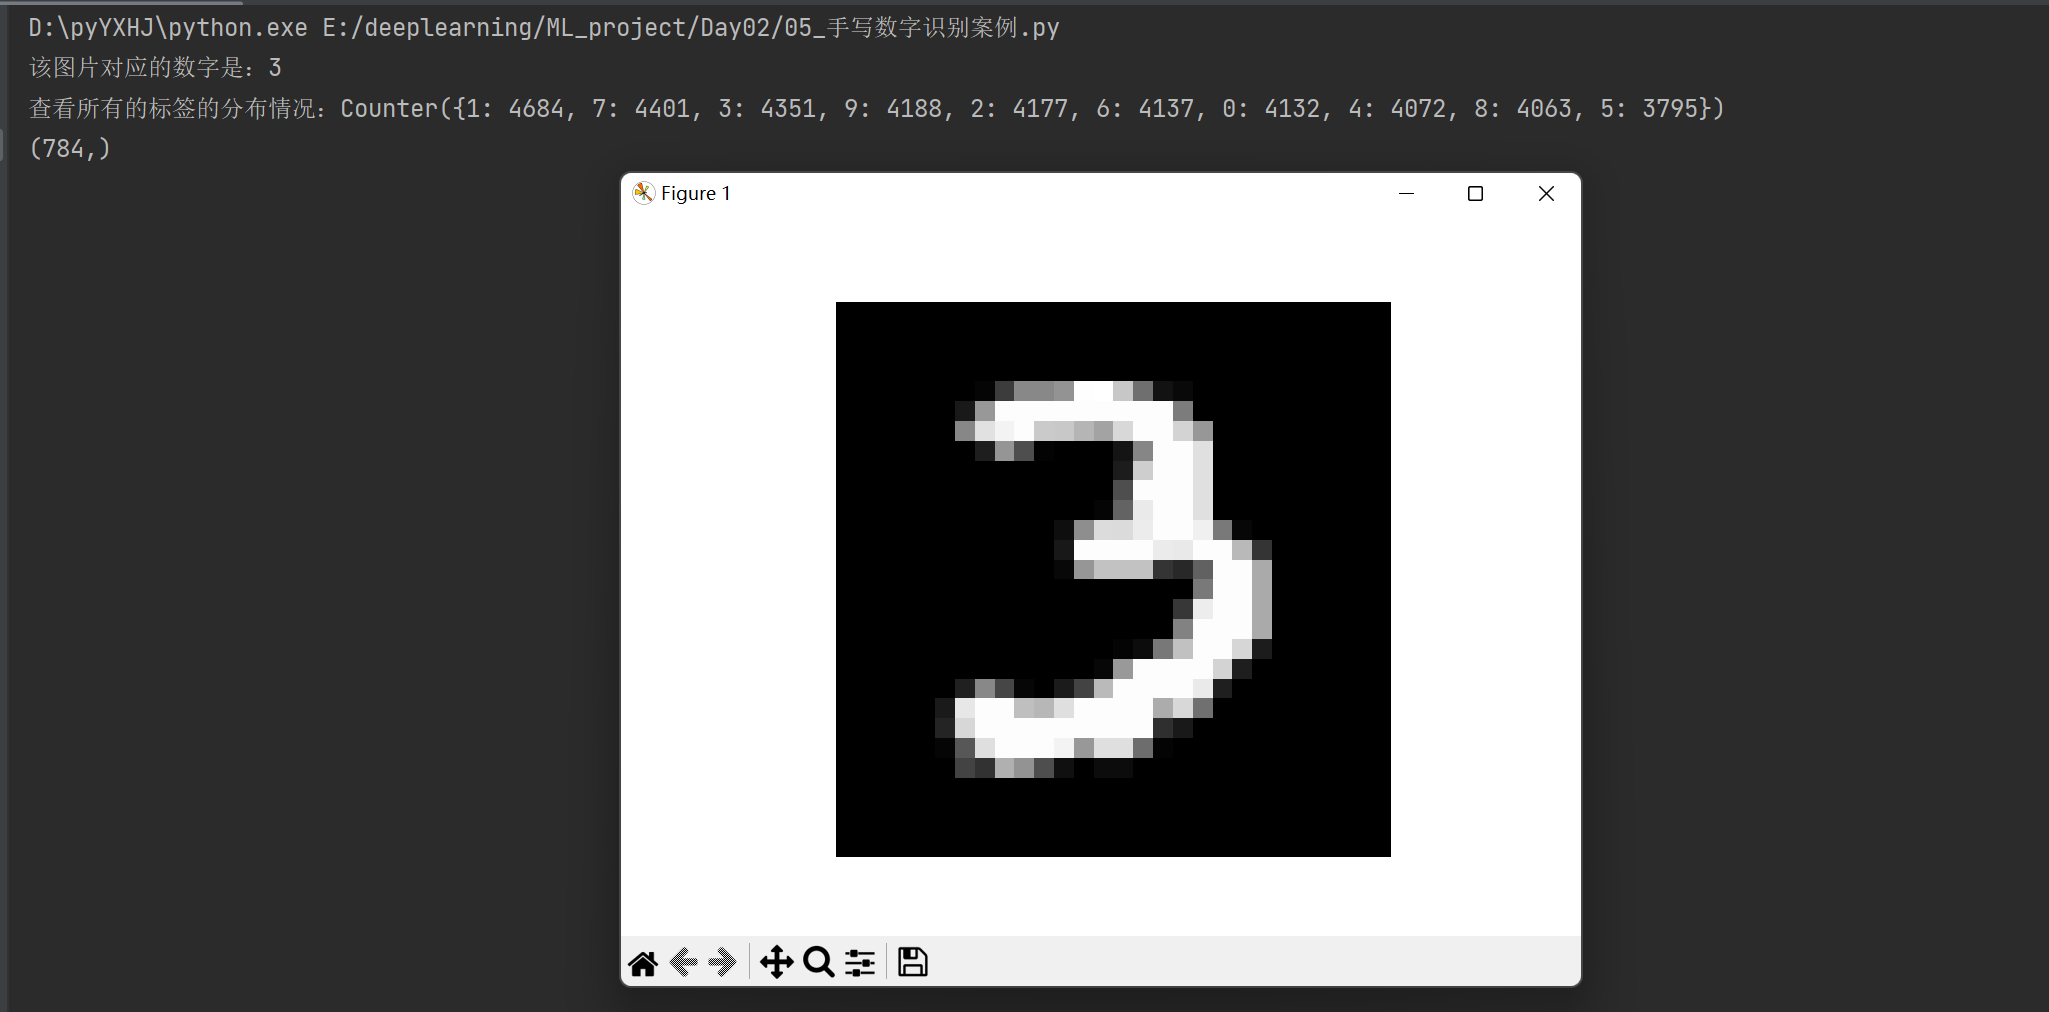
运行效果展示
3.模型训练以及保存
#2.训练模型,并保存训练好的模型
def train_model():
    #1.加载数据集
    df = pd.read_csv('./data/手写数字识别.csv')
    #2.数据的预处理
    #2.1拆分出特征列
    x = df.iloc[:, 1:]  #特征列                这里指的是行和列,如果是单:就是所有的意思
    #2.2拆分出标签列
    y = df.iloc[:,0]    #标签列
    #2.3打印特征和标签的形状
    print(f'x的形状:{x.shape}')    #42000 * 784
    print(f'y的形状:{y.shape}')    #42000 * 1
    print(f'查看所有标签的分布情况:{Counter(y)}')
    #2.4对特征列(拆分前)进行归一化
    x =  x / 255
    #2.5拆分训练集和测试集
    #参1:特征列    参2:标签列   参3:测试集的比例    参4:随机种子   参5:参考y值进行抽取,保持标签的比例(数据均衡)
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=21, stratify=y)

    #3.模型训练
    #3.1创建模型对象
    estimator = KNeighborsClassifier(n_neighbors=3)
    #3.2 模型训练
    estimator.fit(x_train,y_train)
    #4.模型评估
    print(f'准确率:{estimator.score(x_test,y_test)}')
    print(f'准确率:{accuracy_score(y_test,estimator.predict(x_test))}')
    #5.保存模型
    #参1:模型对象    参2:模型保存的路径
    joblib.dump(estimator, './model/手写数字识别.pkl')    #pickle文件:Python(pandas)独有的文件类型
    print('模型保存成功')
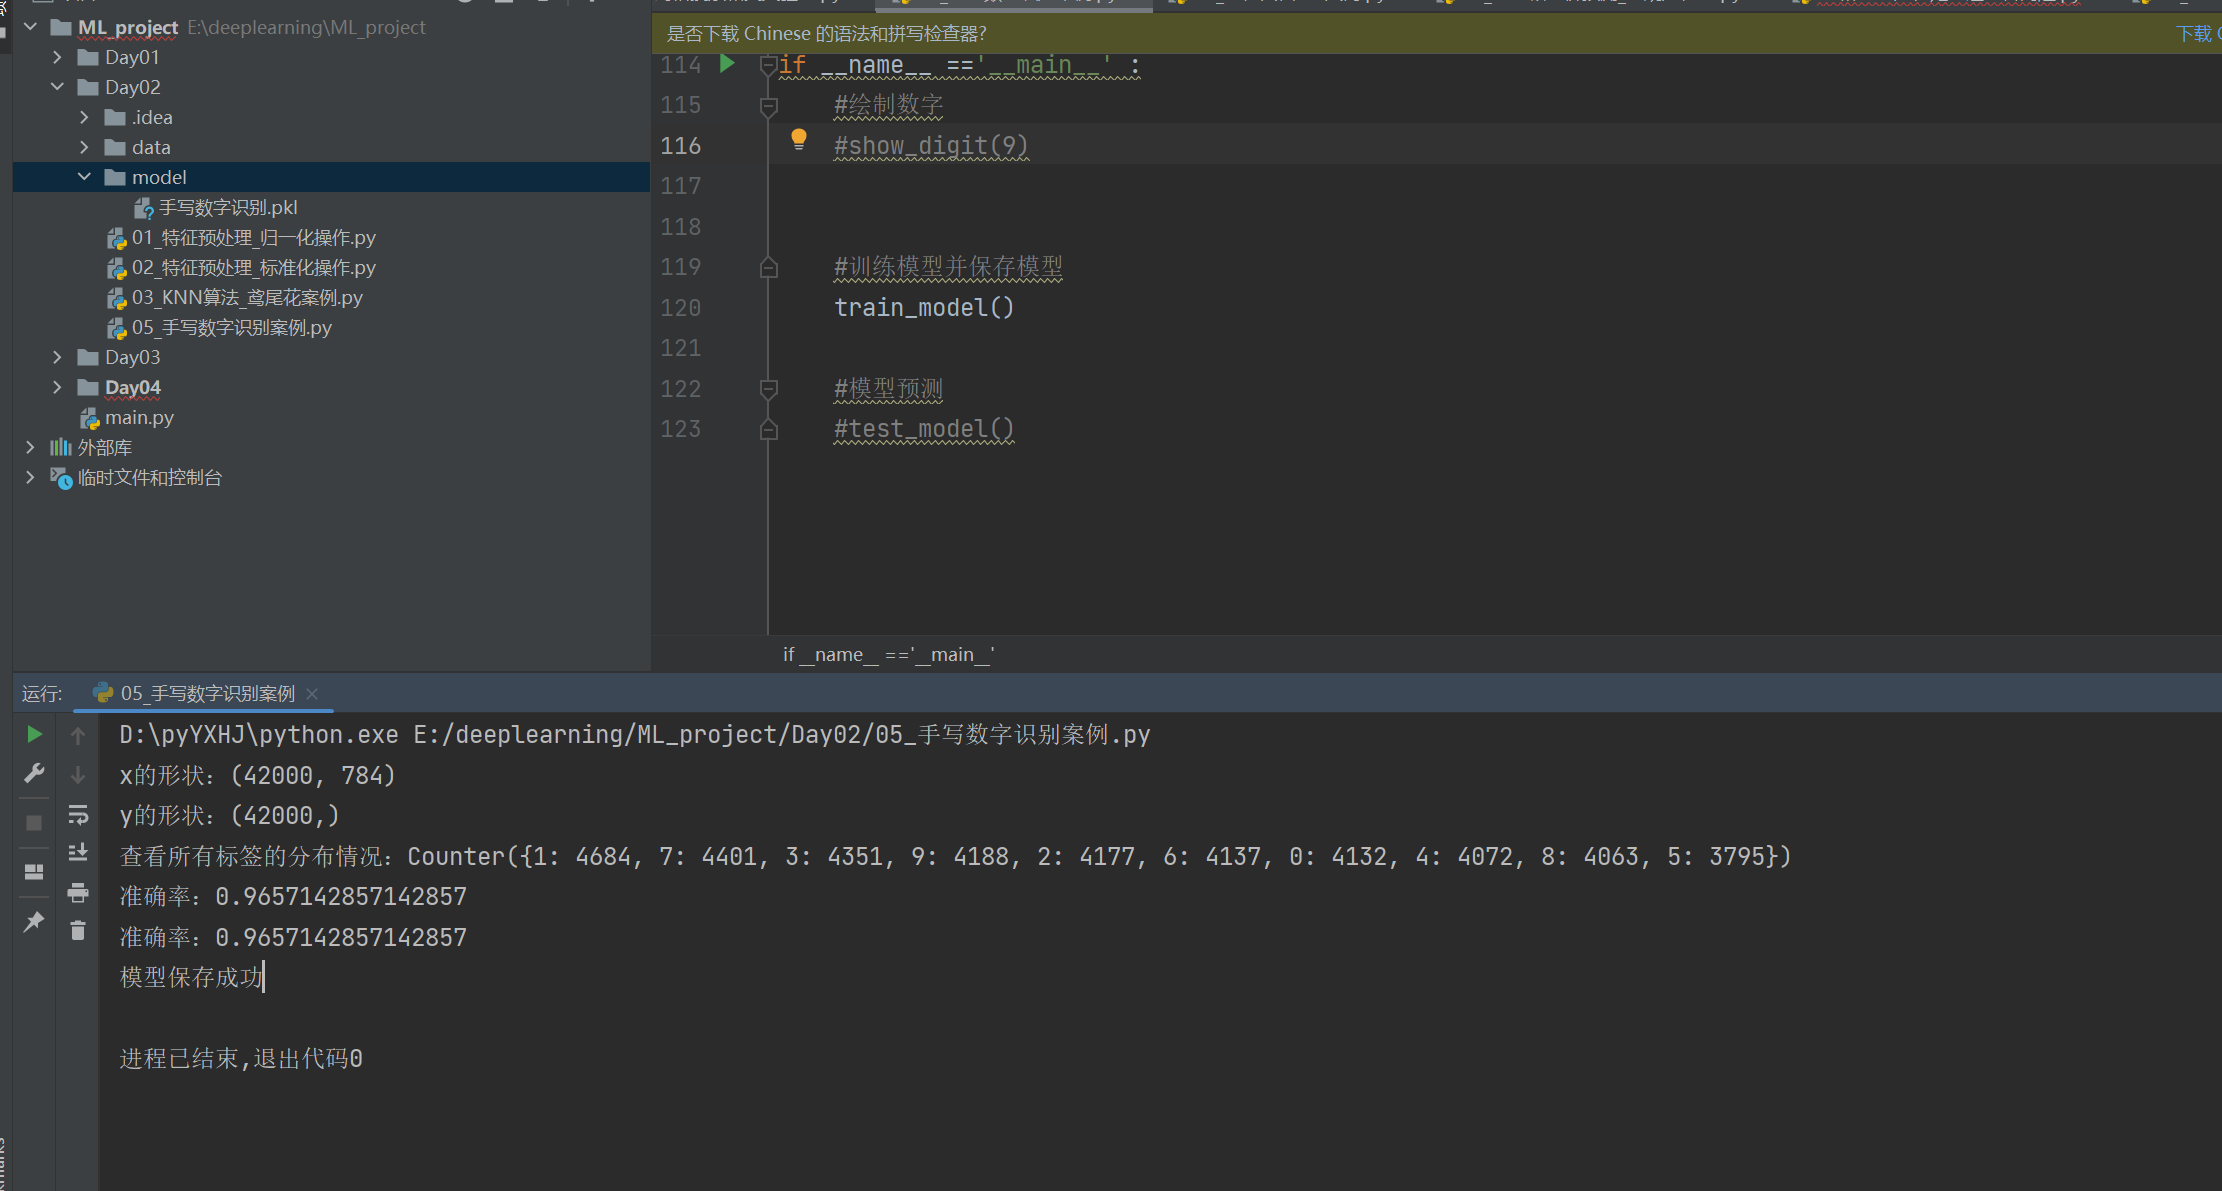
运行效果展示
4.模型测试
#3.测试模型
def test_model():
    #1.加载图片
    x = plt.imread('./data/demo.png')   #28*28     注意imread函数在读数据时,自动进行归一化,数据为0-1之间
    #2.绘制图片
    plt.imshow(x, cmap='gray')
    plt.axis('off')
    plt.show()

    #3.加载模型
    estimator = joblib.load('./model/手写数字识别.pkl')

    #4.模型预测
    #4.1查看数据集转换
    print(x.shape)                      #(28, 28)
    print(x.reshape(1, 784).shape)      #(1, 784)
    print(x.reshape(1,-1).shape)        #效果上等同于(1,784),语法糖

    #4.2 具体的转换动作,记得归一化
    #x = x.reshape(1,-1)/255            #可能会预测失败,应为读图的时候,像素点可能不是特别的精准
    x = x.reshape(1, -1)                #用原始的赌徒到的像素值,做预测

    #4.3 模型预测
    y_pre = estimator.predict(x)
    print(f'预测的结果为:{y_pre}')
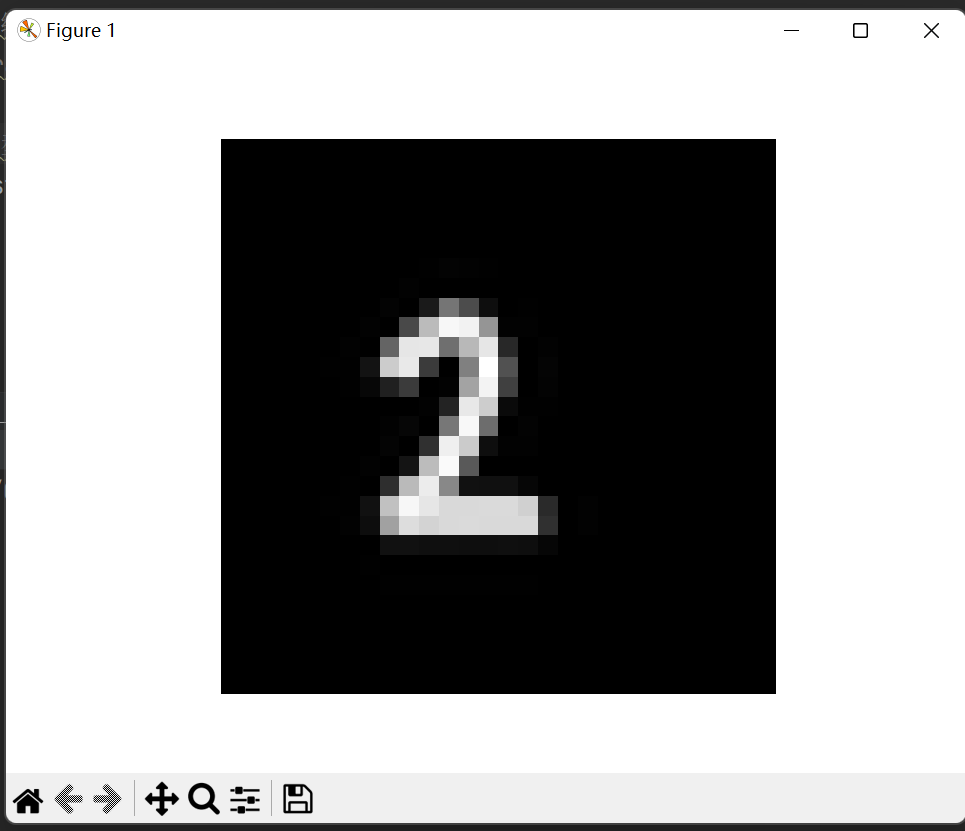
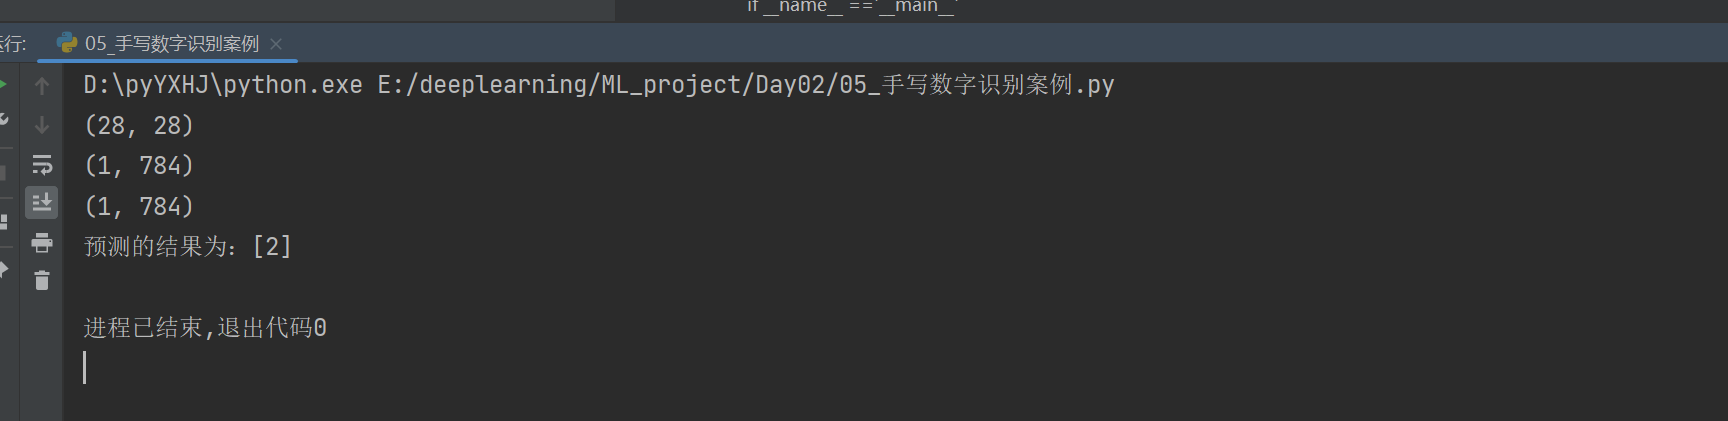
运行效果展示
5.完整代码
import matplotlib.pyplot as plt
import pandas as pd
import matplotlib
matplotlib.use('TkAgg')   # 解决后端错误
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.neighbors import KNeighborsClassifier
import joblib                                                           #保存模型
from collections import Counter                                         #去重统计
from sklearn.metrics import accuracy_score

#扩展:忽略警告
import warnings
warnings.filterwarnings('ignore', module='sklearn')                     #参1表示忽略警报  参2表示忽略的模块


#1.接收用户传入的索引,展示该索引对应的图片
def show_digit(idx):
    #1.读取数据集,获取到原数据
    df = pd.read_csv('./data/手写数字识别.csv')
    #print(df)         #(42000行*785列)

    #2.判断传入的索引是否越界
    if idx < 0 or idx > len(df) - 1:
        print('索引越界')
        return

    #3.走这里,说明没有越界,就正常获取数据
    x = df.iloc[:, 1:]   #第一个冒号代表所有数据,第二个代表从编号1开始拿数据
    y = df.iloc[:,0]
    #4.查看用户传入的索引对应的图片是几
    print(f'该图片对应的数字是:{y.iloc[idx]}')
    print(f'查看所有的标签的分布情况:{Counter(y)}')

    #5.查看下 用户传入的索引图片 的形状
    print(x.iloc[idx].shape)    #(784)  我们要想办法把(784)转换为(28,28)
    #print(x.iloc[idx].values)   #具体的784个像素点数据

    #6.把(748)转化为(28*28)
    x = x.iloc[idx].values.reshape(28, 28)
    #print(x)   #已经转化为28 * 28像素点

    #7.具体的绘制灰度图的动作
    plt.imshow(x,cmap='gray')   #灰度图
    plt.axis('off')             #不显示坐标
    plt.show()


#2.训练模型,并保存训练好的模型
def train_model():
    #1.加载数据集
    df = pd.read_csv('./data/手写数字识别.csv')
    #2.数据的预处理
    #2.1拆分出特征列
    x = df.iloc[:, 1:]  #特征列                这里指的是行和列,如果是单:就是所有的意思
    #2.2拆分出标签列
    y = df.iloc[:,0]    #标签列
    #2.3打印特征和标签的形状
    print(f'x的形状:{x.shape}')    #42000 * 784
    print(f'y的形状:{y.shape}')    #42000 * 1
    print(f'查看所有标签的分布情况:{Counter(y)}')
    #2.4对特征列(拆分前)进行归一化
    x =  x / 255
    #2.5拆分训练集和测试集
    #参1:特征列    参2:标签列   参3:测试集的比例    参4:随机种子   参5:参考y值进行抽取,保持标签的比例(数据均衡)
    x_train, x_test, y_train, y_test = train_test_split(x, y, test_size=0.2, random_state=21, stratify=y)

    #3.模型训练
    #3.1创建模型对象
    estimator = KNeighborsClassifier(n_neighbors=3)
    #3.2 模型训练
    estimator.fit(x_train,y_train)
    #4.模型评估
    print(f'准确率:{estimator.score(x_test,y_test)}')
    print(f'准确率:{accuracy_score(y_test,estimator.predict(x_test))}')
    #5.保存模型
    #参1:模型对象    参2:模型保存的路径
    joblib.dump(estimator, './model/手写数字识别.pkl')    #pickle文件:Python(pandas)独有的文件类型
    print('模型保存成功')


#3.测试模型
def test_model():
    #1.加载图片
    x = plt.imread('./data/demo.png')   #28*28     注意imread函数在读数据时,自动进行归一化,数据为0-1之间
    #2.绘制图片
    plt.imshow(x, cmap='gray')
    plt.axis('off')
    plt.show()

    #3.加载模型
    estimator = joblib.load('./model/手写数字识别.pkl')

    #4.模型预测
    #4.1查看数据集转换
    print(x.shape)                      #(28, 28)
    print(x.reshape(1, 784).shape)      #(1, 784)
    print(x.reshape(1,-1).shape)        #效果上等同于(1,784),语法糖

    #4.2 具体的转换动作,记得归一化
    #x = x.reshape(1,-1)/255            #可能会预测失败,应为读图的时候,像素点可能不是特别的精准
    x = x.reshape(1, -1)                #用原始的赌徒到的像素值,做预测

    #4.3 模型预测
    y_pre = estimator.predict(x)
    print(f'预测的结果为:{y_pre}')


#4.测试
if __name__ =='__main__' :
    #绘制数字
    #show_digit(9)


    #训练模型并保存模型
    #train_model()

    #模型预测
    test_model()
三.总结
通过手写数字识别,训练了对于数据转换的注意事项,学习了相关API的调用,强化了对于KNN算法的认识
更多推荐

 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)