
【LoRA论文阅读】:大模型微调的革命——用0.01%参数击败全量微调的秘密
前言
在2021年之前,大语言模型的微调还是一个只有科技巨头才能玩得起的游戏。想要微调一个GPT-3 175B模型?你需要几十张A100显卡,花费数百万美元的电费,而且每个任务都要保存一份完整的175B参数模型。这意味着,如果你有100个不同的任务,你需要准备17.5TB的存储空间来存放这些模型。
就在所有人都以为大模型微调会永远被少数公司垄断的时候,微软的研究人员提出了一个颠覆性的想法:我们真的需要更新模型的所有参数吗? 他们发现,大模型在适应下游任务时,权重的变化其实具有非常低的"内在秩"。换句话说,我们只需要训练两个很小的低秩矩阵,就能达到和全量微调相当甚至更好的效果。
这个方法就是Low-Rank Adaptation,简称LoRA。它可以将GPT-3 175B的可训练参数减少10000倍,GPU内存需求降低3倍,同时训练速度提升25%,而且完全不会引入任何推理延迟。今天,我们就来深度拆解这篇改变了整个大模型生态的经典论文。
论文信息
- 标题:LoRA: Low-Rank Adaptation of Large Language Models
- 会议:ICLR 2022
- 单位:微软研究院
- 代码:github.com/microsoft/LoRA
- 论文:https://arxiv.org/pdf/2106.09685
一、为什么我们需要LoRA?
大语言模型的标准工作流程是:先在海量通用数据上预训练一个大模型,然后在下游任务上进行微调。但随着模型越来越大,全量微调变得越来越不现实:
- 训练成本极高:微调GPT-3 175B需要至少80张A100 80GB显卡,一次训练就要花费几十万美元
- 存储成本爆炸:每个微调后的模型都和原模型一样大,100个任务就需要17.5TB的存储空间
- 部署困难:在生产环境中切换不同任务需要加载整个模型,耗时长达几分钟
为了解决这些问题,研究者们提出了很多参数高效的微调方法,但它们都有各自的缺点:
| 方法 | 原理 | 缺点 |
|---|---|---|
| 适配器(Adapter) | 在Transformer层之间插入小的瓶颈层 | 增加推理延迟,尤其是在小批量场景下 |
| 前缀调优(Prefix Tuning) | 在输入序列前添加可训练的特殊token | 占用可用的序列长度,优化困难 |
| BitFit | 只训练模型的偏置参数 | 性能通常不如全量微调 |
LoRA的出现完美解决了这些问题。它既没有推理延迟,也不占用序列长度,同时用极少的参数达到了全量微调的性能。
二、LoRA的核心思想:低秩更新
2.1 什么是低秩?
在讲LoRA之前,我们先简单理解一下"秩"的概念。通俗地说,矩阵的秩就是矩阵中线性无关的行或列的数量。一个满秩矩阵的所有行和列都是线性无关的,而一个低秩矩阵可以用更少的行和列来表示。
比如,一个1000×1000的满秩矩阵需要100万个参数来存储,但如果它的秩是8,我们就可以把它分解成一个1000×8的矩阵和一个8×1000的矩阵的乘积,只需要16000个参数,减少了62.5倍!
LoRA的核心洞察就是:大模型在适应下游任务时,权重的更新ΔW其实是低秩的。也就是说,我们不需要直接学习ΔW,只需要学习两个小矩阵A和B,使得ΔW=BA,这样就能大幅减少可训练参数的数量。
2.2 LoRA的数学原理
LoRA的原理非常简单,如下图所示:
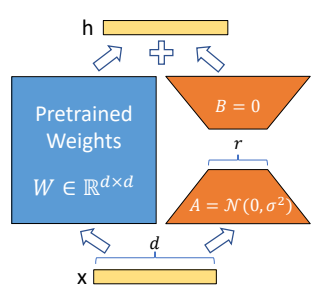
图1:LoRA重参数化示意图(出处:原文Figure 1)
我们冻结预训练模型的权重矩阵W0∈Rd×kW_0 \in \mathbb{R}^{d \times k}W0∈Rd×k,然后在它旁边并行添加两个低秩矩阵A∈Rr×kA \in \mathbb{R}^{r \times k}A∈Rr×k和B∈Rd×rB \in \mathbb{R}^{d \times r}B∈Rd×r,其中秩r≪min(d,k)r \ll \min(d, k)r≪min(d,k)。
前向传播的公式变为:
h=W0x+ΔWx=W0x+BAxh = W_0 x + \Delta W x = W_0 x + B A xh=W0x+ΔWx=W0x+BAx
其中:
- hhh:输出向量
- W0W_0W0:预训练的权重矩阵,冻结不训练
- xxx:输入向量
- ΔW\Delta WΔW:权重更新矩阵,等于BABABA
- AAA:低秩矩阵,用高斯分布N(0,σ2)\mathcal{N}(0, \sigma^2)N(0,σ2)初始化
- BBB:低秩矩阵,初始化为全零
- rrr:LoRA的秩,通常取1、2、4、8等很小的值
通俗解释:这就像你有一本已经写好的百科全书(预训练模型W0W_0W0),现在你要给它加一个附录(LoRA矩阵AAA和BBB),专门用来解答某个特定领域的问题。你不需要重写整本书,只需要写几页附录就够了。
为了让训练更稳定,我们还会对LoRA的输出进行缩放:
h=W0x+αrBAxh = W_0 x + \frac{\alpha}{r} B A xh=W0x+rαBAx
其中α\alphaα是一个常数,通常设置为第一个尝试的rrr值。这样做的好处是,当我们改变rrr时,不需要重新调整学习率,大大简化了超参数调优的过程。
2.3 零推理延迟的秘密
LoRA最神奇的地方在于,它完全不会引入任何推理延迟。这是怎么做到的呢?
在部署的时候,我们可以直接把LoRA矩阵合并到预训练权重中:
W=W0+BAW = W_0 + B AW=W0+BA
这样,推理的时候就和普通的全量微调模型完全一样了,没有任何额外的计算。当我们需要切换到另一个任务时,只需要减去原来的BABABA,再加上新任务的B′A′B'A'B′A′即可,整个过程只需要几毫秒。
对比一下适配器方法:适配器是在Transformer层之间插入额外的层,这些层必须在推理时顺序计算,无法合并到原模型中。在小批量在线推理场景下,适配器会带来高达30%的延迟增加,这在生产环境中是不可接受的。
三、LoRA在Transformer中的应用
在Transformer架构中,有很多权重矩阵可以应用LoRA,比如自注意力模块中的Wq,Wk,Wv,WoW_q, W_k, W_v, W_oWq,Wk,Wv,Wo,以及MLP模块中的两个线性层。
作者们做了一个实验,在相同的参数预算下,测试了在不同权重上应用LoRA的效果:
| 应用的权重 | WikiSQL准确率 | MultiNLI准确率 |
|---|---|---|
| 仅WqW_qWq | 70.4% | 91.0% |
| 仅WkW_kWk | 70.0% | 90.8% |
| 仅WvW_vWv | 73.0% | 91.0% |
| 仅WoW_oWo | 73.2% | 91.3% |
| Wq+WkW_q + W_kWq+Wk | 71.4% | 91.3% |
| Wq+WvW_q + W_vWq+Wv | 73.7% | 91.3% |
| 所有四个权重 | 73.7% | 91.7% |
表1:不同权重应用LoRA的性能对比(出处:原文Table 5)
从结果可以看出,同时在WqW_qWq和WvW_vWv上应用LoRA能获得最好的性能。而只在WqW_qWq或WkW_kWk上应用LoRA的效果则差很多。这说明,注意力机制中的查询和值投影矩阵是最需要适应下游任务的。
在后续的所有实验中,作者们都只在WqW_qWq和WvW_vWv上应用LoRA,这样既简单又高效。
四、实验结果:用数据说话
作者们在RoBERTa、DeBERTa、GPT-2和GPT-3上进行了全面的实验,覆盖了自然语言理解、自然语言生成、问答、摘要等多个任务。
4.1 推理延迟对比
首先,我们来看大家最关心的推理延迟问题。作者们在GPT-2 medium上测试了不同方法的单前向传播延迟:
| 批量大小 | 序列长度 | 全量微调/LoRA | Adapter L | Adapter H |
|---|---|---|---|---|
| 32 | 512 | 1449.4ms | 1482.0ms (+2.2%) | 1492.2ms (+3.0%) |
| 16 | 256 | 338.0ms | 354.8ms (+5.0%) | 366.3ms (+8.4%) |
| 1 | 128 | 19.8ms | 23.9ms (+20.7%) | 25.8ms (+30.3%) |
表2:GPT-2 medium推理延迟对比(出处:原文Table 1)
这个结果非常直观:在大批量场景下,适配器的延迟增加还不太明显,但在小批量在线推理场景下(批量大小=1),适配器的延迟增加高达20%-30%!而LoRA和全量微调的延迟完全一样,没有任何额外开销。
这就是为什么LoRA在生产环境中比适配器更受欢迎的原因。对于大多数在线服务来说,批量大小通常都是1,30%的延迟增加意味着用户需要多等30%的时间,这是完全不可接受的。
4.2 RoBERTa和DeBERTa在GLUE上的表现
接下来,我们看自然语言理解任务的黄金标准——GLUE基准:
| 模型与方法 | 可训练参数 | MNLI | SST-2 | MRPC | CoLA | QNLI | QQP | RTE | STS-B | 平均 |
|---|---|---|---|---|---|---|---|---|---|---|
| RoBERTa base (全量微调) | 125.0M | 87.6 | 94.8 | 90.2 | 63.6 | 92.8 | 91.9 | 78.7 | 91.2 | 86.4 |
| RoBERTa base (LoRA) | 0.3M | 87.5 | 95.1 | 89.7 | 63.4 | 93.3 | 90.8 | 86.6 | 91.5 | 87.2 |
| RoBERTa large (全量微调) | 355.0M | 90.2 | 96.4 | 90.9 | 68.0 | 94.7 | 92.2 | 86.6 | 92.4 | 88.9 |
| RoBERTa large (LoRA) | 0.8M | 90.6 | 96.2 | 90.9 | 68.2 | 94.9 | 91.6 | 87.4 | 92.6 | 89.0 |
| DeBERTa XXL (全量微调) | 1500.0M | 91.8 | 97.2 | 92.0 | 72.0 | 96.0 | 92.7 | 93.9 | 92.9 | 91.1 |
| DeBERTa XXL (LoRA) | 4.7M | 91.9 | 96.9 | 92.6 | 72.4 | 96.0 | 92.9 | 94.9 | 93.0 | 91.3 |
表3:GLUE基准性能对比(出处:原文Table 2)
这个结果太震撼了!LoRA只用了**0.24%的参数,就超过了全量微调的RoBERTa base;只用了0.03%**的参数,就超过了全量微调的DeBERTa XXL!
这意味着,你不需要再花费大量的时间和资源去全量微调一个大模型了。只需要训练几个MB的LoRA权重,就能获得和全量微调一样甚至更好的效果。
4.3 GPT-3 175B的惊人表现
最激动人心的实验当然是在GPT-3 175B上的结果。作者们测试了三个不同的任务:WikiSQL(自然语言转SQL)、MNLI(自然语言推理)和SAMSum(对话摘要):
| 方法 | 可训练参数 | WikiSQL准确率 | MNLI准确率 | SAMSum R1/R2/RL |
|---|---|---|---|---|
| 全量微调 | 175,255.8M | 73.8% | 89.5% | 52.0/28.0/44.5 |
| BitFit | 14.2M | 71.3% | 91.0% | 51.3/27.4/43.5 |
| 前缀嵌入调优 | 3.2M | 63.1% | 88.6% | 48.3/24.2/40.5 |
| 前缀层调优 | 20.2M | 70.1% | 89.5% | 50.8/27.3/43.5 |
| Adapter H | 7.1M | 71.9% | 89.8% | 53.0/28.9/44.8 |
| Adapter H | 40.1M | 73.2% | 91.5% | 53.2/29.0/45.1 |
| LoRA | 4.7M | 73.4% | 91.7% | 53.8/29.8/45.9 |
| LoRA | 37.7M | 74.0% | 91.6% | 53.4/29.2/45.1 |
表4:GPT-3 175B不同任务性能对比(出处:原文Table 4)
LoRA只用了4.7M参数(相当于全量参数的0.0027%),就在所有三个任务上都超过了全量微调!这简直是一个奇迹。
我们来算一笔账:全量微调GPT-3需要保存一个350GB的模型(FP16精度),而LoRA只需要保存一个4.7MB的权重文件。如果你有100个任务,全量微调需要35TB的存储空间,而LoRA只需要350GB + 4.7MB×100 ≈ 350.5GB,节省了近100倍的存储空间!
更重要的是,训练LoRA只需要3张A100显卡,而全量微调需要至少80张。这意味着,现在一个普通的实验室甚至个人,都可以微调GPT-3级别的大模型了。
4.4 性能与参数数量的关系
作者们还绘制了不同方法的性能随可训练参数数量变化的曲线:
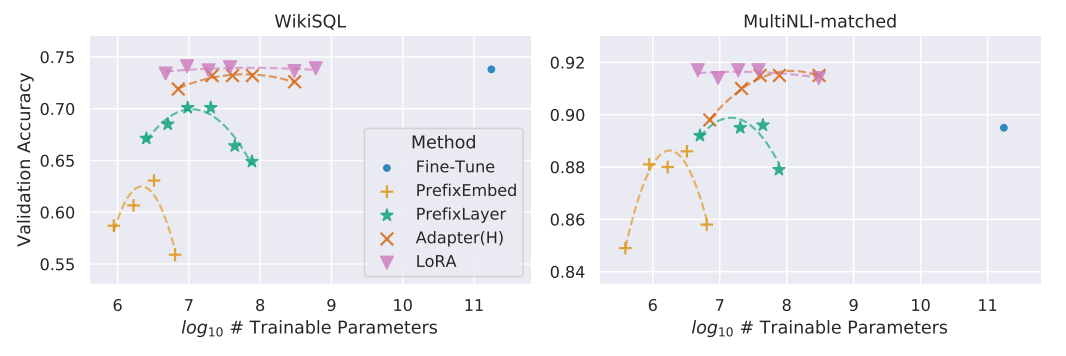
图2:GPT-3 175B验证准确率与可训练参数数量的关系(出处:原文Figure 2)
从图中可以清楚地看到:
- 前缀调优的性能随着参数数量的增加反而下降,说明它的优化非常困难
- 适配器的性能提升缓慢,需要更多的参数才能达到好的效果
- LoRA的性能随着参数数量的增加稳步提升,而且在相同的参数数量下,性能远远超过其他方法
这说明LoRA不仅参数效率高,而且扩展性也非常好。
五、深入理解LoRA:为什么低秩就够了?
LoRA的效果这么好,很多人都会问一个问题:为什么这么小的秩就足够了? 作者们通过一系列深入的实验,为我们揭示了其中的奥秘。
5.1 最优的秩r其实很小
作者们测试了不同的秩r对性能的影响:
| 权重类型 | r=1 | r=2 | r=4 | r=8 | r=64 |
|---|---|---|---|---|---|
| WikiSQL (仅WqW_qWq) | 68.8% | 69.6% | 70.5% | 70.4% | 70.0% |
| WikiSQL (Wq+WvW_q+W_vWq+Wv) | 73.4% | 73.3% | 73.7% | 73.8% | 73.5% |
| WikiSQL (所有四个权重) | 74.1% | 73.7% | 74.0% | 74.0% | 73.9% |
| MultiNLI (仅WqW_qWq) | 90.7% | 90.9% | 91.1% | 90.7% | 90.7% |
| MultiNLI (Wq+WvW_q+W_vWq+Wv) | 91.3% | 91.4% | 91.3% | 91.6% | 91.4% |
| MultiNLI (所有四个权重) | 91.2% | 91.7% | 91.7% | 91.5% | 91.4% |
表5:不同秩r的性能对比(出处:原文Table 6)
结果令人惊讶:当同时在WqW_qWq和WvW_vWv上应用LoRA时,r=1就已经能达到非常好的性能了! 增加r到8甚至64,性能几乎没有提升。
这说明,大模型在适应下游任务时,权重的更新确实具有非常低的内在秩。大多数情况下,r=4或8就足够了,更大的r只会增加计算量,而不会带来明显的性能提升。
5.2 子空间相似性分析
为了进一步验证这个结论,作者们对不同r学到的子空间进行了相似性分析:
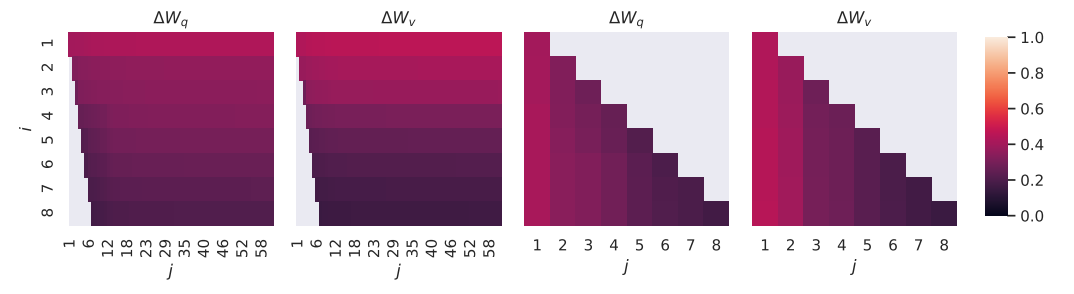
图3:r=8和r=64学到的子空间相似性(出处:原文Figure 3)
图中颜色越亮表示相似性越高。可以看到,r=8学到的前几个主要方向,和r=64学到的前几个主要方向几乎完全重合。而r=64学到的其他方向,和r=8的方向几乎没有重叠,说明这些方向大多是噪声,对任务性能没有贡献。
这就解释了为什么r=8就足够了:因为它已经捕捉到了所有对任务重要的方向,更大的r只是学到了更多的噪声而已。
5.3 ΔW和W0的关系
最后,作者们研究了LoRA学到的更新矩阵ΔW和预训练权重W0之间的关系:
| r=4 | r=64 | |||||
|---|---|---|---|---|---|---|
| ΔW_q | W_q | 随机 | ΔW_q | W_q | 随机 | |
| ∣U⊤WqV⊤∣F|U^\top W_q V^\top|_F∣U⊤WqV⊤∣F | 0.32 | 21.67 | 0.02 | 1.90 | 37.71 | 0.33 |
| ∣Wq∣F=61.95|W_q|_F = 61.95∣Wq∣F=61.95 | ∣ΔWq∣F=6.91|\Delta W_q|_F = 6.91∣ΔWq∣F=6.91 | ∣ΔWq∣F=3.57|\Delta W_q|_F = 3.57∣ΔWq∣F=3.57 |
表6:ΔW和W0的相关性分析(出处:原文Table 7)
从表中可以得出三个重要结论:
- ΔW和W0有一定的相关性,比随机矩阵高很多,说明ΔW放大了W0中已经存在的一些特征
- ΔW并没有重复W0的主要方向,而是放大了那些在预训练中没有被强调的方向
- 放大因子非常大:对于r=4,放大因子约为6.91/0.32 ≈ 21.5倍!
通俗解释:预训练模型就像一个万能的工具箱,里面有各种各样的工具。但对于某个特定的任务,你只需要其中的几个工具。LoRA的作用就是把这几个工具拿出来,磨得更锋利一些,让它们在这个特定任务上更好用。它不需要给工具箱添加新的工具,只需要把现有的工具打磨好就够了。
六、动手实践:5行代码实现LoRA微调
现在,我们可以用Hugging Face的PEFT库,只用几行代码就能实现LoRA微调。下面是一个微调Llama-2-7b进行文本分类的完整示例:
import torch
from datasets import load_dataset
from transformers import AutoTokenizer, AutoModelForSequenceClassification, TrainingArguments, Trainer
from peft import LoraConfig, get_peft_model

# 1. 加载数据集和模型
dataset = load_dataset("imdb")
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")
tokenizer.pad_token = tokenizer.eos_token

model = AutoModelForSequenceClassification.from_pretrained(
    "meta-llama/Llama-2-7b-hf",
    num_labels=2,
    torch_dtype=torch.bfloat16,
    device_map="auto"
)

# 2. 配置LoRA参数
lora_config = LoraConfig(
    r=8,  # LoRA秩
    lora_alpha=32,  # 缩放因子
    target_modules=["q_proj", "v_proj"],  # 要应用LoRA的模块
    lora_dropout=0.05,
    bias="none",
    task_type="SEQ_CLASSIFICATION"
)

# 3. 将模型转换为PEFT模型
model = get_peft_model(model, lora_config)
model.print_trainable_parameters()  # 输出:trainable params: 4,194,304 || all params: 6,742,609,920 || trainable%: 0.0622%

# 4. 预处理数据
def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True, max_length=512)

tokenized_datasets = dataset.map(tokenize_function, batched=True)

# 5. 训练模型
training_args = TrainingArguments(
    output_dir="./lora-llama2-imdb",
    learning_rate=3e-4,
    per_device_train_batch_size=8,
    per_device_eval_batch_size=8,
    num_train_epochs=3,
    logging_steps=10,
    evaluation_strategy="epoch",
    save_strategy="epoch",
    fp16=True
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_datasets["train"],
    eval_dataset=tokenized_datasets["test"]
)

trainer.train()

# 6. 保存LoRA权重
model.save_pretrained("./lora-llama2-imdb-final")
就是这么简单!整个训练过程只需要一张A100 80GB显卡,大约3小时就能完成。训练完成后,你会得到一个只有16MB大小的LoRA权重文件,而不是一个14GB的完整模型。
总结
LoRA是大模型发展史上的一个里程碑式的工作。它的核心贡献可以总结为三点:
- 提出了一种全新的参数高效微调方法,用极少的参数达到了全量微调的性能
- 完全解决了推理延迟问题,部署时可以合并权重,和全量微调模型没有任何区别
- 极大地降低了大模型微调的门槛,让普通研究者和开发者也能微调GPT-3级别的大模型
LoRA的出现彻底改变了大模型的生态。在LoRA之后,Alpaca、Vicuna、Llama 2等一系列开源大模型如雨后春笋般涌现,推动了AI技术的民主化进程。今天,几乎所有的大模型微调都在使用LoRA或它的变体,它已经成为了大模型微调的事实标准。
更多推荐


 5
 0
- 0


 已为社区贡献24条内容

所有评论(0)