
Kimi K3 全球首发:2.8T 参数开源,首个 3T 级大模型登场
AI 大模型 API与Token中转服务,稳定、高效、低成本
前言
今天,我们正式推出 Kimi K3——我们迄今为止最强的模型。Kimi K3 是一颗 **2.8T 参数**的大模型,基于自研的 **Kimi Delta Attention (KDA)** 与 **Attention Residuals (AttnRes)** 架构,具备**原生视觉能力**和 **1M token 上下文窗口**。它是**全球首个开源的 3T 级模型**,专为长程编码 (long-horizon coding)、知识工作和推理而设计,面向 frontier intelligence 这一目标。
虽然整体性能仍落后于目前最强的闭源模型 **Claude Fable 5** 和 **GPT-5.6 Sol**,但 Kimi K3 在我们整套评测体系中展示了 frontier 级别的性能,稳定优于其他被测模型。
发布时 Kimi K3 默认采用 **max thinking effort**;后续将逐步引入 low / high effort 模式。我们正在与推理合作伙伴和开源社区紧密协作,对齐技术细节、确保生态稳定发布。**完整模型权重将于 2026 年 7 月 27 日前正式放出**。架构、训练和评测的更多细节将随 Kimi K3 技术报告一并发布。
一、An Open 3T-Class Model(首个开源 3T 级模型)
Kimi K3 是首个达到 2.8T 参数规模的开源模型。它延续了 Kimi 团队在 scaling frontier 上的持续推进:过去 12 个月里有 9 个月,Kimi 模型都在刷新开源模型尺寸的上限。
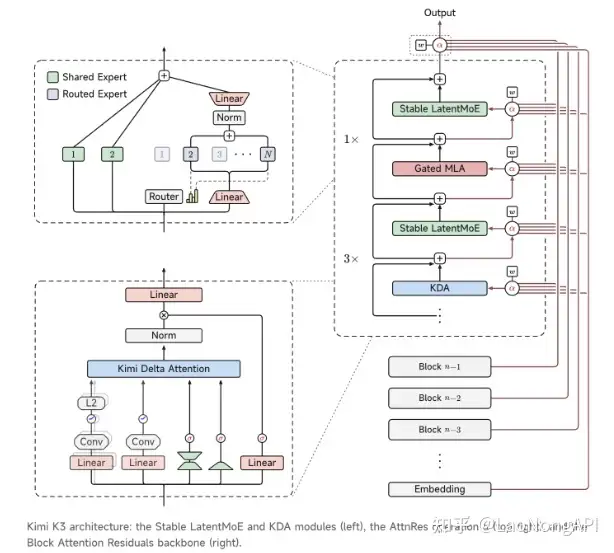
Kimi K3 基于两个架构升级:
- Kimi Delta Attention (KDA)
- Attention Residuals (AttnRes)
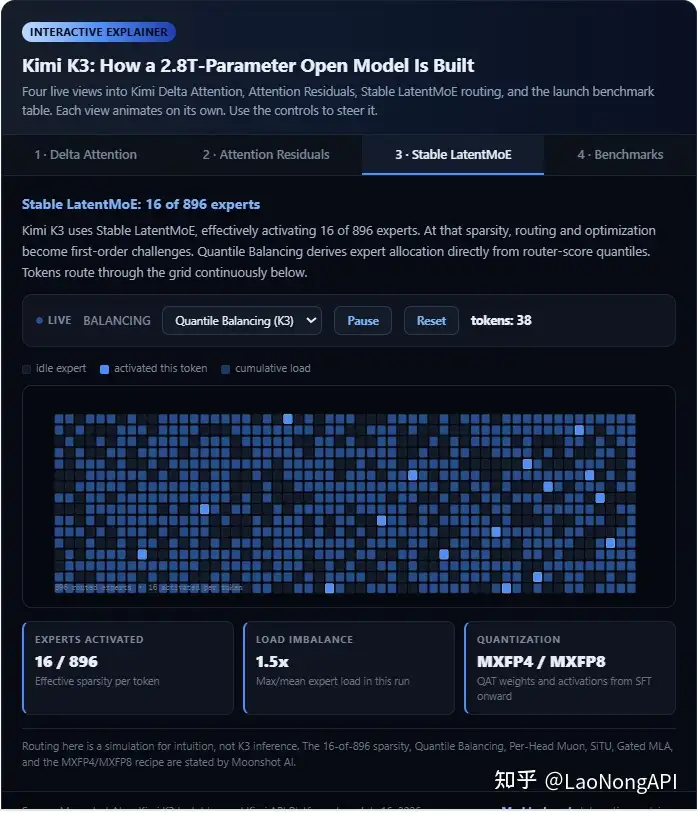
二者共同改善信息在序列长度和模型深度上的流动方式。我们还把 Mixture of Experts (MoE) 的稀疏度往上推:搭配 Stable LatentMoE 框架,实际激活 16 / 896 专家。
配合改进后的训练与数据配方,这些结构变化带来整体 scaling 效率比 Kimi K2 提升约 2.5×,让模型能更高效地把算力转化为智能。
Stable LatentMoE 的核心创新:
- Quantile Balancing:直接由 router-score 分位数推导专家分配,消除启发式更新与敏感的平衡超参;
- Per-Head Muon:把 Muon 优化器扩展到 attention head,实现更自适应的可扩展学习;
- Sigmoid Tanh Unit (SiTU) + Gated MLA:分别改善激活控制与注意力选择性。
上述组合让 2.8T 规模训练既稳定又高效。
二、Coding(编码)
Kimi K3 在长程编码 (long-horizon coding) 上表现强劲。仅需极少人工监督,它就能:
- 持续推进长工程会话
- 跨大型代码仓库导航
- 编排 terminal 工具链
Kimi K3 在软件工程 × 视觉推理的混合任务上也极其出色——它会利用截图与画面信息,反推前端/游戏/CAD 优化方案。
下面这些案例研究,展示了 Kimi K3 的编码能力如何转化为开放式软件创作和科研工作流。
1. Kernel Optimization(GPU 算子优化)
我们测试了模型在 GPU 算子优化上的能力。每个模型在相同的 sandbox 中独立工作,最多 24 小时,profile / rewrite / benchmark 四个任务,涵盖 AttnRes、KDA、512-head-dimension MLA kernel,跨 NVIDIA H200 与一个 GPGPU 替代供应商。
结果:
- Kimi K3 与 Claude Fable 5(with fallback)表现接近;
- Kimi K3 显著优于 Opus 4.8、GPT-5.6 Sol、GPT-5.5。
注:Claude Fable 5 的结果由第三方评估,可能包含 fallback 行为;各模型的少量轨迹中包含可接受的小幅精度简化,均落在我们数值容差内。GPGPU 指用于通用计算(非图形)的 GPU。
在 Kimi K3 开发的后期,早期版本的 Kimi K3 接手了团队大部分的 kernel 优化工作。
2. GPU Compiler Development(从零写 GPU 编译器)
我们进一步测试 Kimi K3 能否从零搭建 GPU 编程系统。
Kimi K3 写出了 MiniTriton——一个紧凑的 Triton-like 编译器,包含:
- 自有 tile-level IR(在 MLIR 之上)
- 一套优化 pass
- PTX 代码生成流水线
在支持的 roofline benchmark 上,MiniTriton 性能与 Triton、torch.compile 相当或更优,在部分工作负载上反超 Triton。超出 microbenchmark 之外,MiniTriton 在端到端 nanoGPT 训练中保持稳定收敛,loss 曲线与参考实现几乎完全对齐,只存在极小偏差——这在真实工作负载上验证了整条流水线的正确性。
这些结果表明 Kimi K3 可以构建一个完整的端到端编译器(从 DSL 前端、IR pass 到 PTX codegen 和 runtime),而不是孤立的 kernel。其从零写出的 Tensor Core 路径已能与 Triton 久经优化的栈掰手腕。
3. Game Dev and Digital Creation(游戏开发与数字创作)
Kimi K3 把3D 推理、编码、视觉能力合在一起,能把概念、图像、视频变成完整可玩的交互体验。它通过在代码与实时截图之间反复迭代,做到真正的”vision in the loop”,即时看到并打磨输出。
Case 1:3D Open World(3D 开放世界)
Kimi K3 用 Three.js WebGPU + GPU compute 搭了一个完全程序化生成的浏览器 3D 探索游戏。它程序化生成环境,并用 3D 资产生成工具做出骑手和马匹模型,最终呈现出一个拥有森林、木屋村庄、雪山、动态天气的广阔开放世界。
4. Chip Design(芯片设计)
作为早期验证,Kimi K3 自主设计了一颗芯片,用来跑一个基于自有架构的 nano 模型。
在一次 48 小时自治运行 中,K3 用开源 EDA 工具,在 Nangate 45nm 库 上完成从构建、优化到验证的全流程:
- 4 mm² die 面积
- 100 MHz 主频,时序收敛
- 仿真中持续 8,700+ tokens/s 解码吞吐
- 1.46M 标准单元
- 0.277 MB SRAM
- INT4 MAC 阵列 + fused dequantization
一颗模型为模型设计的芯片,这是 K3 长程 agentic 能力的直接体现。
5. Coding for Research(科研向编码)
Kimi K3 把科学文献与可执行代码打通,自主完成科研工作流的实现、验证和分析。
典型案例:为复现计算天体物理中的 I–Love–Q 普适关系,K3:
- 审阅并交叉验证 20+ 篇论文
- 实现完整数值 pipeline
- 评估 300+ 状态方程
- 发现已发表公式中的不一致
- 生成 3,000+ 行 Python 代码
- 输出可交互的 HTML dashboard 展示结果
原本需要经验丰富的 researcher 1~2 周 的工作,Kimi K3 用了约 2 小时完成。
三、Knowledge Work(知识工作)
Kimi K3 推动端到端知识工作。除公开 benchmark 外,Kimi K3 (max) 在我们的内部评测中持续领先,这些评测脱胎于真实用户-agent 工作流中反复出现的模式与挑战。这种在多条产品化工作流上的稳定优势,反映了 Kimi K3 在 agentic 知识工作能力上的整体提升。
1. Research with Interactive Visualization(带交互可视化的研究)
以下是 Kimi Work 中 Kimi K3 在金融咨询和科研领域能产出的几个示例:
Case 1:42 年 AI ASIC 行业交互研究网站
一份可下钻的交互式研究报告:覆盖 42 年的 ASIC 行业,经 120+ 轮递归自我改进生成。Kimi K3 把证据转换为定制化图表、动画演示和交互式视觉叙事。数据获取过程:2.8k+ 次 web search/fetch + 1.1k+ 次 terminal 拉数,横跨 11k+ 页,覆盖 87 份季报 + 99 份原始 PDF。
Case 2:Fusion 行业研究
一份咨询风格行业报告,带交互式可视化,包含时间线、Funnel Chart、Range Bar Chart、Gantt Chart以及出版级幻灯片。
Case 3:GWTC-5 引力波分析
对 391 起引力波事件做分析,使用 20+ 个并发子 agent,产出 7 张科研可视化 + 2 张表 + 1 份文献综述(基于 10+ 篇论文)。
Kimi K3 在信息图风格的演示上也特别有效,包括可编辑的热力图和年报。
2. Widgets and Dashboard(小组件与面板)
Kimi Work 新增两个特性:
- Widgets:在对话中直接生成可交互组件,可连接本地数据或外部插件,实现持续刷新;
- Dashboard:把你最关心的小组件汇聚到一个持久、个性化的视图,围绕主题/项目/目标组织。
四、Video Editing(视频编辑)
Kimi K3 在动效设计、动画与视频剪辑上同样出色,因为它的原生多模态架构在同一个模型里同时理解文本、图像与视频。
示例 1:K3 制作了一段 3Blue1Brown 风格的动效演示,讲解它自己的架构——把技术概念翻译成动画图示和过渡。
示例 2:Kimi K3 用 56 段源素材 剪辑了它自己的预热视频,自主完成片段挑选、motion-matched cuts、帧级节拍同步、音频处理和多轮迭代。这类高密度短视频,经验丰富的剪辑师通常需要 1-2 个工作日,新手需要 3-5 天。
五、Architecture and Infrastructure(架构与基础设施)
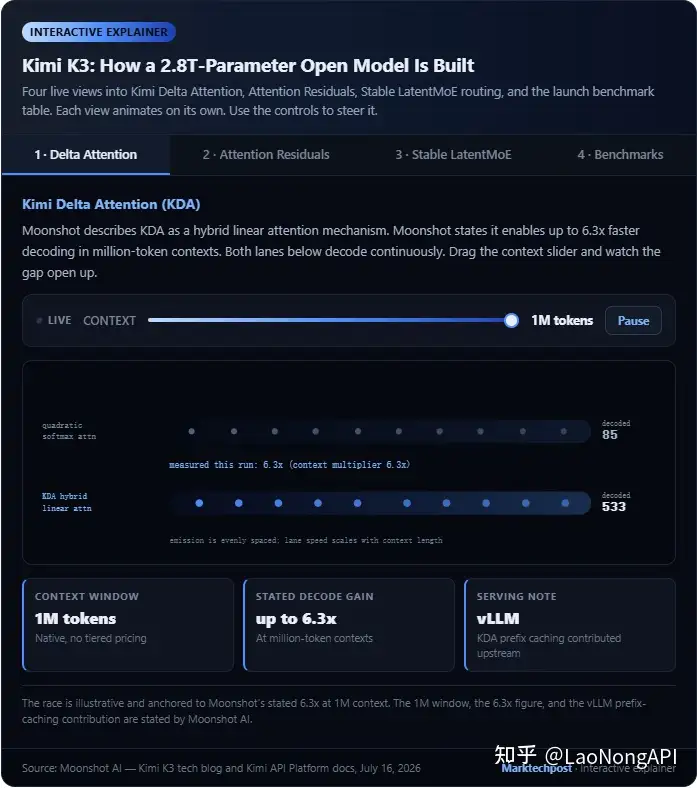
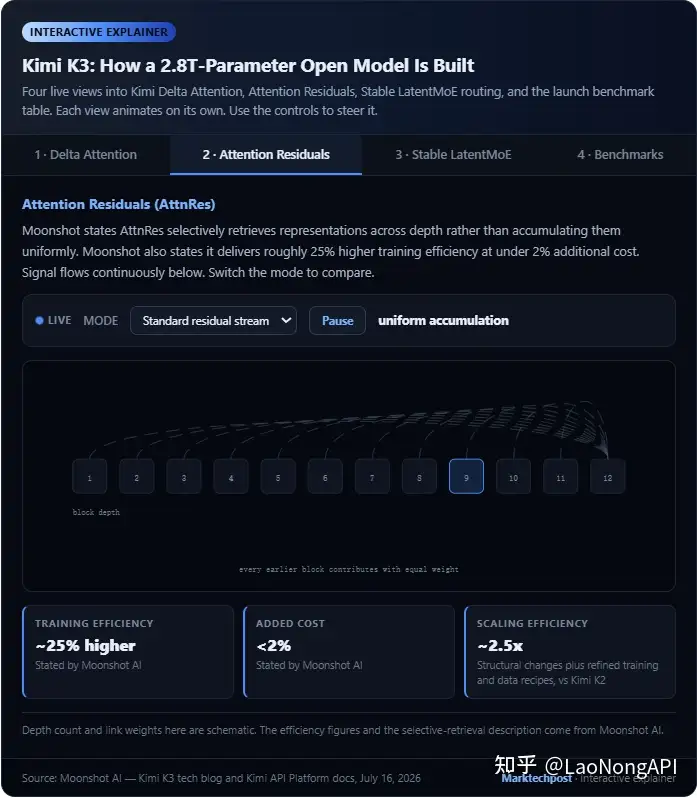
Kimi K3 的核心架构由 KDA (Kimi Delta Attention) 与 AttnRes (Attention Residuals) 共同支撑。KDA 为 attention 扩展提供高效基础;AttnRes 选择性地在深度上检索表征,而不是均匀累加。两者结合,构成面向万亿参数之后继续 scaling 的架构骨干。
Kimi K3 采用 Stable LatentMoE,实际激活 16 / 896 专家。在这种稀疏度下,routing 与优化成为一等公民问题。Quantile Balancing 从 router-score 分位数直接推导专家分配,去掉了启发式更新和敏感的平衡超参;Per-Head Muon 把 Muon 扩展到独立优化每个 attention head,在大规模下提供更自适应的学习。SiTU (Sigmoid Tanh Unit) 与 Gated MLA 分别改善激活控制与注意力选择性。共同作用下,2.8T 参数规模训练既稳定又高效。
Kimi K3 从 SFT 阶段起就采用量化感知训练,使用 MXFP4 权重 + MXFP8 激活,保证硬件兼容性。为防止专家不均衡在大 expert-parallel 时拖累吞吐,我们引入完全均衡的 expert-parallel 训练方法——静态 shape、关键路径上无 host 同步。
考虑到推理效率同样受益于更大的高带宽通信域,推荐在 64 卡以上的 supernode 配置上部署 Kimi K3。
由于 KDA 给传统 prefix caching 带来新挑战,我们向 vLLM 社区贡献了相应的实现,会随模型一起发布。带 prefill cache 的 KDA,让 Kimi K3 在规模与长上下文的约束下,仍能提供极具竞争力的 token 单价。
更多技术细节将在即将发布的技术报告中给出。
六、Availability(可用性)
| 渠道 | 说明 |
|---|---|
| Kimi K3 Agents | 移动端更新最新 Kimi App(iOS / Android / HarmonyOS),或访问 http://kimi.com |
| Work with Kimi K3 | 下载最新版 Kimi Work 桌面端,3.1.0+,支持 Windows 与 Apple Silicon Mac |
| Code with Kimi K3 | terminal 中跑 Kimi Code,使用 /model 命令切换到 Kimi K3 |
| Build with the Kimi API | Kimi API Platform 选 kimi-k3。定价:0.30 / MTok (cache-hit 输入),3.00 / MTok (cache-miss 输入),$15.00 / MTok (输出)。基于 Mooncake 的分离式推理架构,官方 API 在编码工作负载上 >90% cache 命中率 |
| 企业部署 | Kimi Enterprise 提供企业级数据隐私与成员管理,个人/企业账号完全隔离。在定价页选 “Get Kimi Enterprise” 给团队订阅 |
七、Full Benchmark Table(完整 benchmark 表)
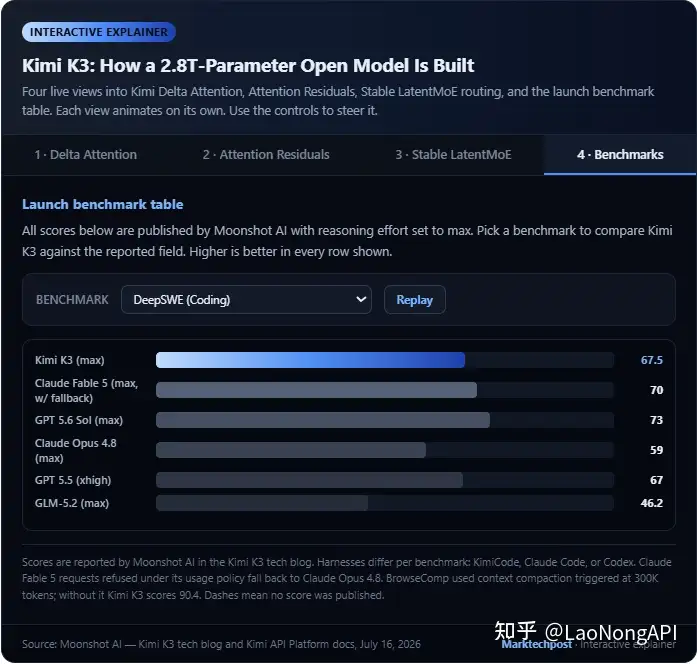
所有 Kimi K3 成绩在 reasoning effort = ‘max’, temperature = 1.0, top-p = 1.0 下报告。视 benchmark 而定,各模型分别在 KimiCode / Claude Code / Codex 三种 agentic harness 之一上评估。
1. Coding
| Benchmark | Kimi K3 (max) | Claude Fable 5 (max, fallback) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| DeepSWE | 67.5 | 70.0 | 73.0 | 59.0 | 67.0 | 46.2 |
| Program Bench | 77.8 | 76.8 | 77.6 | 71.9 | 70.8 | 63.7 |
| Terminal Bench 2.1 | 88.3 | 84.6 | 88.8 | 84.6 | 83.4 | 82.7 |
| FrontierSWE | 81.2 | 86.6 | 71.3 | 66.7 | 64.9 | 67.3 |
| SWE Marathon | 42.0 | 35.0 | 39.0 | 40.0 | 14.0 | 13.0 |
| PostTrain Bench | 36.6 | 41.4 | 34.6 | 34.1 | 28.4 | 34.3 |
| MLS Bench | 48.3 | 49.9 | 46.2 | 42.8 | 35.5 | 40.4 |
| Kimi Code Bench 2.0 (Internal) | 72.9 | 76.9 | 64.8 | 71.7 | 69.0 | 64.2 |
2. Agentic
| Benchmark | Kimi K3 (max) | Claude Fable 5 (max, fallback) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| GDPval-AA v2 (Elo) | 1668.0 | 1760.0 | 1748.0 | 1600.0 | 1494.0 | 1514.0 |
| BrowseComp | 91.2 | 88.0 | 90.4 | 84.3 | 84.4 | — |
| DeepSearchQA (f1) | 95.0 | 94.2 | — | 93.1 | — | — |
| Toolathlon-Verified | 73.2 | 77.9 | 74.9 | 76.2 | 73.5 | 59.9 |
| MCP Atlas | 84.2 | 84.7 | 83.6 | 83.6 | 82.8 | 82.6 |
| Automation Bench | 30.8 | 29.1 | 29.7 | 27.2 | 22.7 | 12.9 |
| Job Bench | 52.9 | 57.4 | 46.5 | 48.4 | 38.3 | 43.4 |
| AA-Briefcase (Elo) | 1548.0 | 1583.0 | 1495.0 | 1354.0 | 1158.0 | 1260.0 |
| APEX-Agents | 37.6 | 43.3 | 39.9 | 39.4 | 38.5 | 35.6 |
| Office QA Pro | 63.3 | 69.9* | 63.2* | 63.9* | 60.9* | 41.4 |
| SpreadsheetBench 2 | 34.8 | 34.7* | 32.4* | 31.6* | 29.1* | 28.1 |
| DECK-Bench (Internal) | 73.5 | 73.0 | 74.7 | 66.9 | 68.2 | 68.6 |
3. Reasoning & Knowledge
| Benchmark | Kimi K3 (max) | Claude Fable 5 (max, fallback) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| GPQA-Diamond | 93.5 | 92.6 | 94.1 | 91.0 | 93.5 | 91.2 |
| HLE-Full | 43.5 | 53.3 | 44.5 | 49.8* | 41.4* | — |
| HLE-Full w/ tools | 56.0 | 63.0 | 58.0 | 57.9* | 52.2* | — |
4. Vision
| Benchmark | Kimi K3 (max) | Claude Fable 5 (max, fallback) | GPT-5.6 Sol (max) | Claude Opus 4.8 (max) | GPT-5.5 (xhigh) | GLM-5.2 (max) |
|---|---|---|---|---|---|---|
| MMMU-Pro | 81.6 | 81.2 | 83.0 | 78.9 | 81.2 | — |
| MMMU-Pro w/ python | 83.4 | 86.5 | 84.6 | 82.7 | 83.2 | — |
| CharXiv (RQ) | 84.8 | 88.9 | 84.6 | 80.5 | 84.1 | — |
| CharXiv (RQ) w/ python | 91.3 | 93.5 | 89.1 | 89.9 | 89.0 | — |
| MathVision | 94.3 | 94.8 | 95.8 | 86.7 | 92.2 | — |
| MathVision w/ python | 97.8 | 98.6 | 97.8 | 97.1 | 96.8 | — |
| BabyVision w/ python | 85.7 | 90.5 | 88.9 | 81.2 | 83.6 | — |
| ZeroBench_main (pass@5) | 23.0 | 23.0 | 17.0 | 17.0 | 22.0 | — |
| ZeroBench_main w/ python (pass@5) | 41.0 | 46.0 | 35.0 | 34.0 | 41.0 | — |
| WorldVQA ForceAnswer | 51.0 | 56.7 | 41.8 | 39.1 | 38.5 | — |
| OmniDocBench | 91.1 | 89.8 | 85.8 | 87.9 | 89.4 | — |
| PerceptionBench | 58.5 | 57.2 | 59.7 | 47.2 | 55.8 | — |
标注
* 的成绩引自厂商官方 blog 或官方 leaderboard。
八、Limitations(局限)
1. Sensitivity to thinking history(对思考历史的敏感)
K3 在保留思考历史(preserved thinking history)模式下训练。如果 agent harness 没有按要求把历史思考内容回传,或在其他模型的进行中会话切到 K3,生成质量可能变得很不稳定。建议使用经过验证兼容性的 harness(如 Kimi Code),避免在会话中途切到 K3。
2. Excessive proactiveness(过度主动)
K3 的训练特别强调长程、高难度任务。因此,当它在任务执行中遇到小问题或用户意图模糊时,可能会替用户做出意料之外的决策。如果你的应用要求 agent 在明确边界内运行、避免过度即兴发挥,请在 system prompt 或 AGENTS.md 中给 K3 更明确的行为约束。
整体上,虽然 K3 极具竞争力,但相对 Claude Fable 5 和 GPT-5.6 Sol,它在用户体验上仍存在一定可感知的差距。
更多推荐

 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)