
ClickHouse磁盘损坏的故障排查,原理分析和问题解决
前言
我们的ClickHouse集群每台机器都配置了多块磁盘。我们对比HDFS的磁盘损坏的自动恢复和高容忍度,我们理所当然地认为,在配置了多块磁盘并且整个集群配置了Replication以后,ClickHouse中的Replicated*Tree表可以高度容忍磁盘损坏。
但是实际运维发现,ClickHouse没有很好地处理单块磁盘损坏的情形,不仅如此,我们甚至无法通过人工干预的方式在不重启ClickHouse的情况下实现磁盘的卸载,只能重启ClickHouse。
当然,整个过程没有发生数据丢失(Replicated*Tree已有数据在Peer Replica上存在备份,新的数据可以写入到其他的磁盘上),但是整个系统因为单块盘的损坏进入了异常状态,Merge异常,查询异常都在发生,已经影响了用户的正常使用,破坏了系统的SLA。
本文讲解了整个磁盘故障发生的现象和我们排查解决的过程,并以此为机会了解了ClickHouse在磁盘管理层面的原理,并以此积累了我们运维的经验。
问题发现:用户反馈查询失败
我们发现问题的时候是用户报告查询偶尔失败。我们自己也复现了这个问题: 在运行简单的全表扫描时,查询偶尔报错。只是偶尔报错,而不是全部报错,这是因为: 我们的查询是基于Replicated*Tree表的,一个Shard有两个replica,查询被打到损坏replica时会失败,打到健康replica时正常。
查看system.query_log确认查询失败的模式:
radp606-6.iad7.prod.viva.com :) SELECT
                                       event_time,
                                       type,
                                       exception_code,
                                       substring(exception, 1, 400) as exception_text
                                   FROM system.query_log
                                   WHERE event_time >= '2026-07-01 00:00:00'
                                     AND event_time < '2026-07-04 00:00:00'
                                     AND exception != ''
                                     AND exception LIKE '%nvme9%'
                                   ORDER BY event_time DESC
                                   LIMIT 3
                                   FORMAT Vertical;

Row 1:
──────
event_time:     2026-07-03 06:57:25
type:           ExceptionWhileProcessing
exception_code: 76
exception_text: Code: 76. DB::Exception: Cannot open file /viva/data/nvme9/clickhouse/store/291/291f2241-48d1-4d9e-b1ac-151e637b3d9e/20260629_861_893_2/timestampMs.cmrk2: , errno: 5, strerror: Input/output error...

Row 2:
──────
event_time:     2026-07-03 06:57:15
type:           ExceptionWhileProcessing
exception_code: 76
exception_text: Code: 76. DB::Exception: Cannot open file /viva/data/nvme9/clickhouse/store/291/291f2241-48d1-4d9e-b1ac-151e637b3d9e/20260629_861_893_2/timestampMs.cmrk2: , errno: 5, strerror: Input/output error...

Row 3:
──────
event_time:     2026-07-03 06:32:26
type:           ExceptionWhileProcessing
exception_code: 1001
exception_text: Code: 1001. DB::Exception: std::__1::filesystem::filesystem_error: filesystem error: in file_size: Input/output error...

3 rows in set. Elapsed: 0.156 sec. Processed 5.10 million rows, 8.29 GB (32.54 million rows/s., 52.88 GB/s.)
这些查询的特点:
- 都试图读取
disk9上的part文件 - errno都是5 (EIO)
- 失败发生在查询执行过程中 (
ExceptionWhileProcessing)
这说明: 虽然ClickHouse检测到了disk9损坏,但disk9上仍有active的part没有被恢复,导致查询在尝试读取这些part时失败。
我们检查日志,发现错误信息非常明确,先不考虑整个堆栈的具体日志:
Code: 76. DB::Exception: Cannot open file
/viva/data/nvme9/clickhouse/store/467/46714060-70b8-453d-affc-e8ba63498622/20260628_990_995_1/timestampMs.bin:
errno: 5, strerror: Input/output error
(CANNOT_OPEN_FILE)
errno 5是Linux内核的EIO (Input/Output Error),意味着底层磁盘硬件出了问题。
调查过程
确认磁盘状态和系统配置
我首先SSH登录到radp606-6,尝试访问nvme9目录:
ssh -i ~/.ssh/viva.pem root@radp606-6.iad7.prod.viva.com

root@radp606-6:~# ls -la /viva/data/nvme9/
ls: /viva/data/nvme9/: Input/output error
ls: reading directory '/viva/data/nvme9/': Input/output error
total 0
确认了: nvme9已经完全无法访问,连列目录都做不到。这不是简单的文件损坏,而是整块磁盘的硬件故障。
我们的环境: radp606-6是一台多磁盘服务器,配置了13块NVMe SSD (nvme0-nvme12),使用ClickHouse的JBOD storage policy。所有表都是ReplicatedMergeTree引擎,每个shard有两个replica。
进入ClickHouse检查disk状态:
radp606-6.iad7.prod.viva.com :) SELECT name, path, is_broken, is_read_only
                                     FROM system.disks
                                     ORDER BY name;

    ┌─name────┬─path─────────────────────────────┬─is_broken─┬─is_read_only─┐
 1. │ default │ /viva/data/lib/clickhouse/    │         0 │            0 │
 2. │ disk1   │ /viva/data/nvme1/clickhouse/  │         0 │            0 │
 3. │ disk2   │ /viva/data/nvme2/clickhouse/  │         0 │            0 │
 4. │ disk3   │ /viva/data/nvme3/clickhouse/  │         0 │            0 │
 5. │ disk4   │ /viva/data/nvme4/clickhouse/  │         0 │            0 │
 6. │ disk5   │ /viva/data/nvme5/clickhouse/  │         0 │            0 │
 7. │ disk6   │ /viva/data/nvme6/clickhouse/  │         0 │            0 │
 8. │ disk7   │ /viva/data/nvme7/clickhouse/  │         0 │            0 │
 9. │ disk8   │ /viva/data/nvme8/clickhouse/  │         0 │            0 │
10. │ disk9   │ /viva/data/nvme9/clickhouse/  │         1 │            0 │
11. │ disk10  │ /viva/data/nvme10/clickhouse/ │         0 │            0 │
12. │ disk11  │ /viva/data/nvme11/clickhouse/ │         0 │            0 │
13. │ disk12  │ /viva/data/nvme12/clickhouse/ │         0 │            0 │
    └─────────┴──────────────────────────────────┴───────────┴──────────────┘

13 rows in set. Elapsed: 0.002 sec.
disk9的is_broken=1,说明ClickHouse的DiskLocalCheckThread已经检测到了磁盘故障。
我们需要知道disk9上是否有,以及还有多少active part。其实我们不关心具体的part,所以我们直接看看这些在nvme9上的active part按照表的分布情况:
radp606-6.iad7.prod.viva.com :) SELECT DISTINCT table
FROM system.parts
WHERE active AND disk_name = 'disk9';

    ┌─table───────────────────────────────────────────────┐
 1. │ ad_summary_10_local       │
 2. │ ad_summary_11_local       │
 3. │ ad_summary_12_local       │
... (共32行)
32. │ insights_summary_9_local  │
    └─────────────────────────────────────────────────────┘

32 rows in set. Elapsed: 0.019 sec.
我们看到,有32张表在nvme9上有active part,说明这些part都还没有从nvme9上移走。
查看ClickHouse运行时长:
root@radp606-6:~# ps -ef | grep clickhouse
clickho+ 1413820       1  0 Feb28 ?        00:00:00 clickhouse-watchdog ...
clickho+ 1413832 1413820 99 Feb28 ?        486-23:10:00 /usr/bin/clickhouse-server ...
我们的ClickHouse Server从2月28日启动,已经连续运行了一个多月:
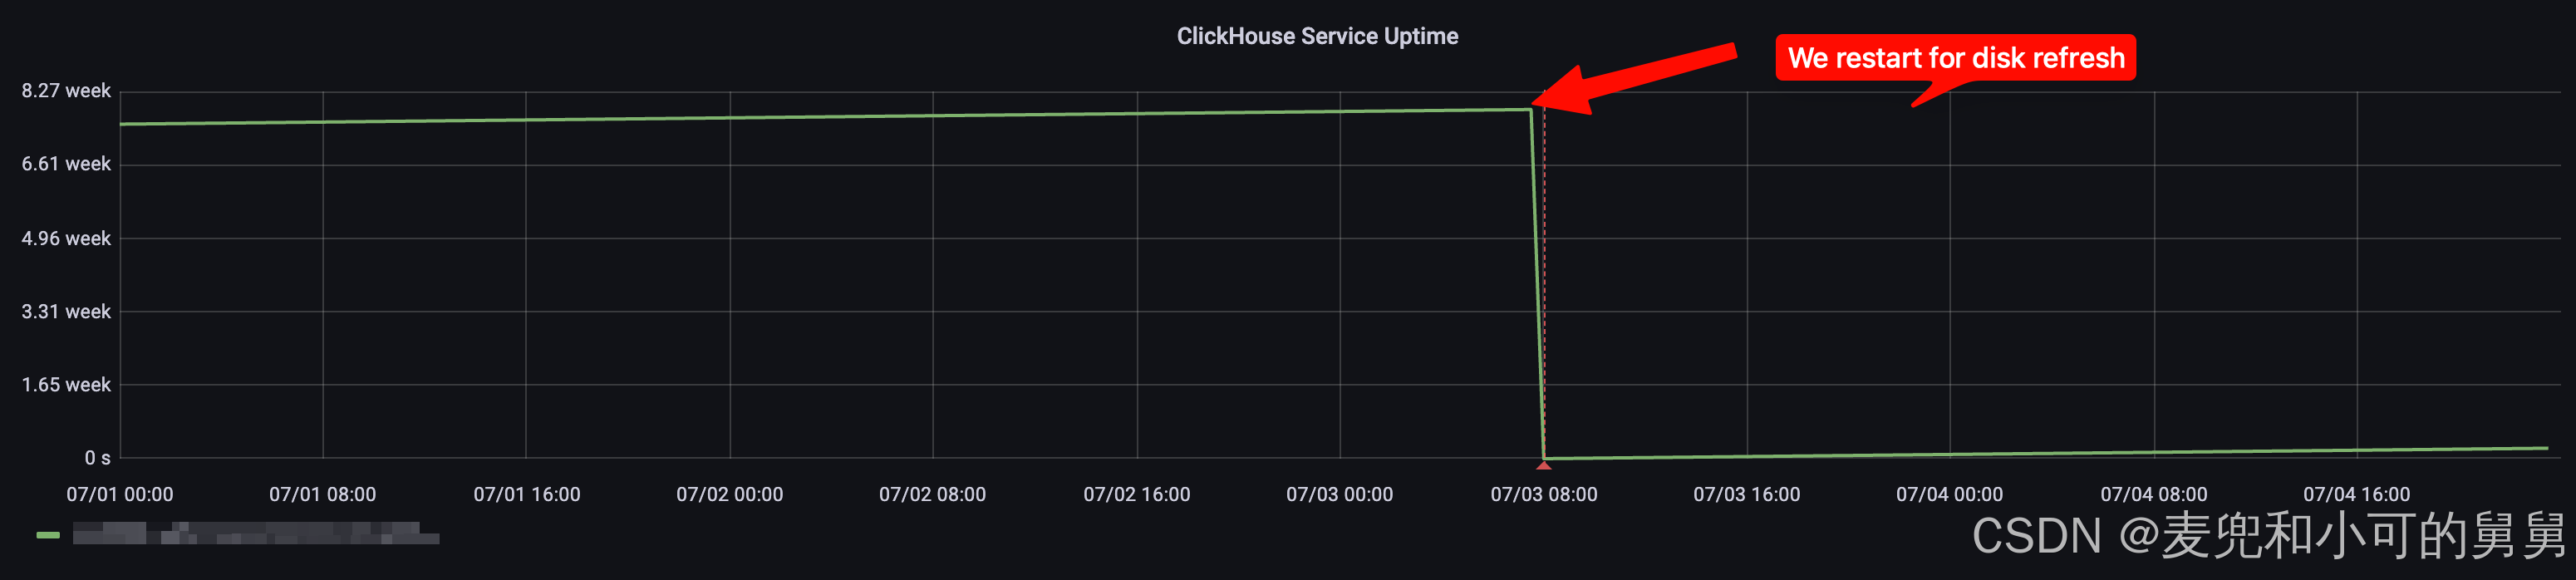
自动恢复为什么卡住?
其实,我们看到由于磁盘损坏导致系统发生问题,就天然产生疑惑: 磁盘损坏,为什么ClickHouse不自动检测并剔除坏盘,然后从Peer Replica去fetch数据呢?因为,我们的表是ReplicatedMergeTree表,每个Shard一个Replica,自带存储冗余。
我查看了ClickHouse的错误日志,找到最初触发问题的完整堆栈:
root@radp606-6:~# grep -B 2 -A 50 'Cannot open file.*nvme9.*timestampMs' \
  /viva/data/log/clickhouse-server/clickhouse-server.err.log | head -100
日志显示,最开始的异常发生在后台merge任务中:
2026.07.03 05:11:41.544810
<Warning> default.insights_summary_1_local:
Scanning parts to recover on broken disk disk9@/viva/data/nvme9/clickhouse/.

2026.07.03 05:11:41.545433
<Error> 46714060-70b8-453d-affc-e8ba63498622::20260628_978_1004_2 (MergeFromLogEntryTask):
virtual bool DB::ReplicatedMergeMutateTaskBase::executeStep():
Code: 76. DB::Exception: Cannot open file
/viva/data/nvme9/clickhouse/store/467/46714060-70b8-453d-affc-e8ba63498622/20260628_990_995_1/timestampMs.bin:
errno: 5, strerror: Input/output error...
可以看到:
- 任务类型:
MergeFromLogEntryTask-ReplicatedMergeTree的复制队列任务 - 源part之一:
20260628_990_995_1- 这个part在disk9上 - 失败原因: 读取源part的
timestampMs.bin文件时发生I/O错误
这说明disk9损坏不仅影响查询,还影响后台merge任务。
当我们找到nvme9上的一个broken part,那么我们就可以完全focus在这个part上,搜索这个part的整个生命周期所发生的故事:
2026.07.01 08:56:12.206251 <Information> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Checking part 20250528_0_3_1_276
2026.07.01 08:56:12.207019 <Information> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Checking data of part 20250528_0_3_1_276.

2026.07.01 08:56:12.207474
<Error> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread):
Part 20250528_0_3_1_276 looks broken. Removing it and will try to fetch.

2026.07.01 08:56:12.207479
<Warning> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread):
Part 20250528_0_3_1_276 exists in ZooKeeper and the local part was broken.
Detaching it, removing from ZooKeeper and queueing a fetch.

2026.07.01 08:56:12.207700
<Error> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread):
void DB::ReplicatedMergeTreePartCheckThread::run():
std::exception. Code: 1001, type: std::__1::filesystem::filesystem_error,
e.what() = filesystem error: in create_directories: Input/output error
["/viva/data/nvme9/clickhouse/store/248/2486d4ec-525a-41ca-9604-81bdd7f02dc5/detached/broken_20250528_0_3_1_276"]

Stack trace (when copying this message, always include the lines below):

0. std::system_error::system_error(std::error_code, String const&) @ 0x000000001fcf5717
1. std::filesystem::filesystem_error::filesystem_error[abi:ne190107](...) @ 0x00000000134a501f
2. void std::filesystem::__throw_filesystem_error[abi:ne190107]<...>(...) @ 0x000000001fcab86d
3. std::filesystem::detail::ErrorHandler<bool>::report(...) @ 0x000000001fcae9e2
4. std::filesystem::__create_directories(...) @ 0x000000001fcaf1cf
5. DB::DiskLocal::createDirectories(String const&) @ 0x000000001728857a
6. DB::(anonymous namespace)::BackupImpl(...) @ 0x00000000190d8a54
7. DB::Backup(...) @ 0x00000000190d85a9
8. DB::DataPartStorageOnDiskBase::freeze(...) @ 0x00000000190c38ff
9. DB::IMergeTreeDataPart::makeCloneInDetached(...) @ 0x0000000019124870
10. DB::StorageReplicatedMergeTree::removePartAndEnqueueFetch(...) @ 0x0000000018c78f8e
11. DB::ReplicatedMergeTreePartCheckThread::checkPartAndFix(...) @ 0x000000001960dc98
从这段日志可以看到核心问题:
- 系统发现了一个有问题的part,这个被发现的broken part随后会被交给
ReplicatedMergeTreePartCheckThread进行处理。我们先不用管怎么发现这个broken part并交给ReplicatedMergeTreePartCheckThread处理的,下文会讲解:2026.07.01 08:56:12.206251 <Information> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Checking part 20250528_0_3_1_276 2026.07.01 08:56:12.207019 <Information> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Checking data of part 20250528_0_3_1_276. ReplicatedMergeTreePartCheckThread也确实开始处理这个坏part:2026.07.01 08:56:12.207474 <Error> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Part 20250528_0_3_1_276 looks broken. Removing it and will try to fetch.- 尝试detach这个part,然后从Keeper上把这个Part删除,然后重新fetch这个Part:
2026.07.01 08:56:12.207479 <Warning> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Part 20250528_0_3_1_276 exists in ZooKeeper and the local part was broken. Detaching it, removing from ZooKeeper and queueing a fetch. - 但是,在执行detach操作时失败了:
ClickHouse试图在nvme9上创建2026.07.01 08:56:12.207700 <Error> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): void DB::ReplicatedMergeTreePartCheckThread::run(): std::exception. Code: 1001, type: std::__1::filesystem::filesystem_error, e.what() = filesystem error: in create_directories: Input/output error ["/viva/data/nvme9/clickhouse/store/248/2486d4ec-525a-41ca-9604-81bdd7f02dc5/detached/broken_20250528_0_3_1_276"] ........ 3. std::filesystem::detail::ErrorHandler<bool>::report(...) @ 0x000000001fcae9e2 4. std::filesystem::__create_directories(...) @ 0x000000001fcaf1cf 5. DB::DiskLocal::createDirectories(String const&) @ 0x000000001728857a 6. DB::(anonymous namespace)::BackupImpl(...) @ 0x00000000190d8a54 7. DB::Backup(...) @ 0x00000000190d85a9 8. DB::DataPartStorageOnDiskBase::freeze(...) @ 0x00000000190c38ff 9. DB::IMergeTreeDataPart::makeCloneInDetached(...) @ 0x0000000019124870 10. DB::StorageReplicatedMergeTree::removePartAndEnqueueFetch(...) @ 0x0000000018c78f8e 11. DB::ReplicatedMergeTreePartCheckThread::checkPartAndFix(...) @ 0x000000001960dc98detached/broken_*目录,但nvme9已经完全损坏,连创建目录都做不到。
所以,从日志看来,这个失败的part的确有被ClickHouse尝试进行detach,但是detach失败。下文会具体介绍失败的原因。
然后,对于这一块坏盘,我们从日志里面看到,日志里反复出现对/viva/data/nvme9/clickhouse/的扫描日志。虽然有大量"Scanning"日志,但是仅此而已,似乎什么都没有做成功:
2026.07.01 11:13:30.152148 <Warning> default.insights_summary_3_local:
Scanning parts to recover on broken disk disk9@/viva/data/nvme9/clickhouse/.
2026.07.01 11:14:16.442858 <Warning> default.ad_summary_11_local:
Scanning parts to recover on broken disk disk9@/viva/data/nvme9/clickhouse/.
... (大量Scanning日志,持续不断)
所以,Part的Re-Fetch的整个流程断在了detach步骤:
正常流程:
Scanning → Part looks broken → Detach成功 → Remove from ZK → Create GET_PART → Fetch开始
实际流程:
Scanning → Part looks broken → Detach失败 (disk9无法写) → 抛异常 → 后续步骤全部跳过
↑
卡在这里!
ReplicatedMergeTreePartCheckThread在不断重试 (每5秒一次),但每次都卡在detach步骤的filesystem error,永远无法进入创建fetch队列的阶段。
上面这套「Scanning → looks broken → Detaching → filesystem error」的日志,其实是一条固定的调用链一步步打印出来的。我们顺着代码把它捋一遍,就能明白为什么日志会停在detach这一步,也能反过来用日志印证整个流程。
源码分析与日志印证
下图显示了我们整个事件的发生过程。这是ClickHouse在运行时发生磁盘损坏开始、到我们看到异常的全部因果关系链条。
即,从Broken Disk被DiskChecker探针发现,到用户的读取操作或者Merge操作发现了Broken Part并因此触发了对Broken Disk的全部Part的Re-Fetch尝试,以及在尝试Re-Fetch以前的准备工作中发生了备份失败(把Broken Part迁移到Detach其实本质就是备份)的全部过程:
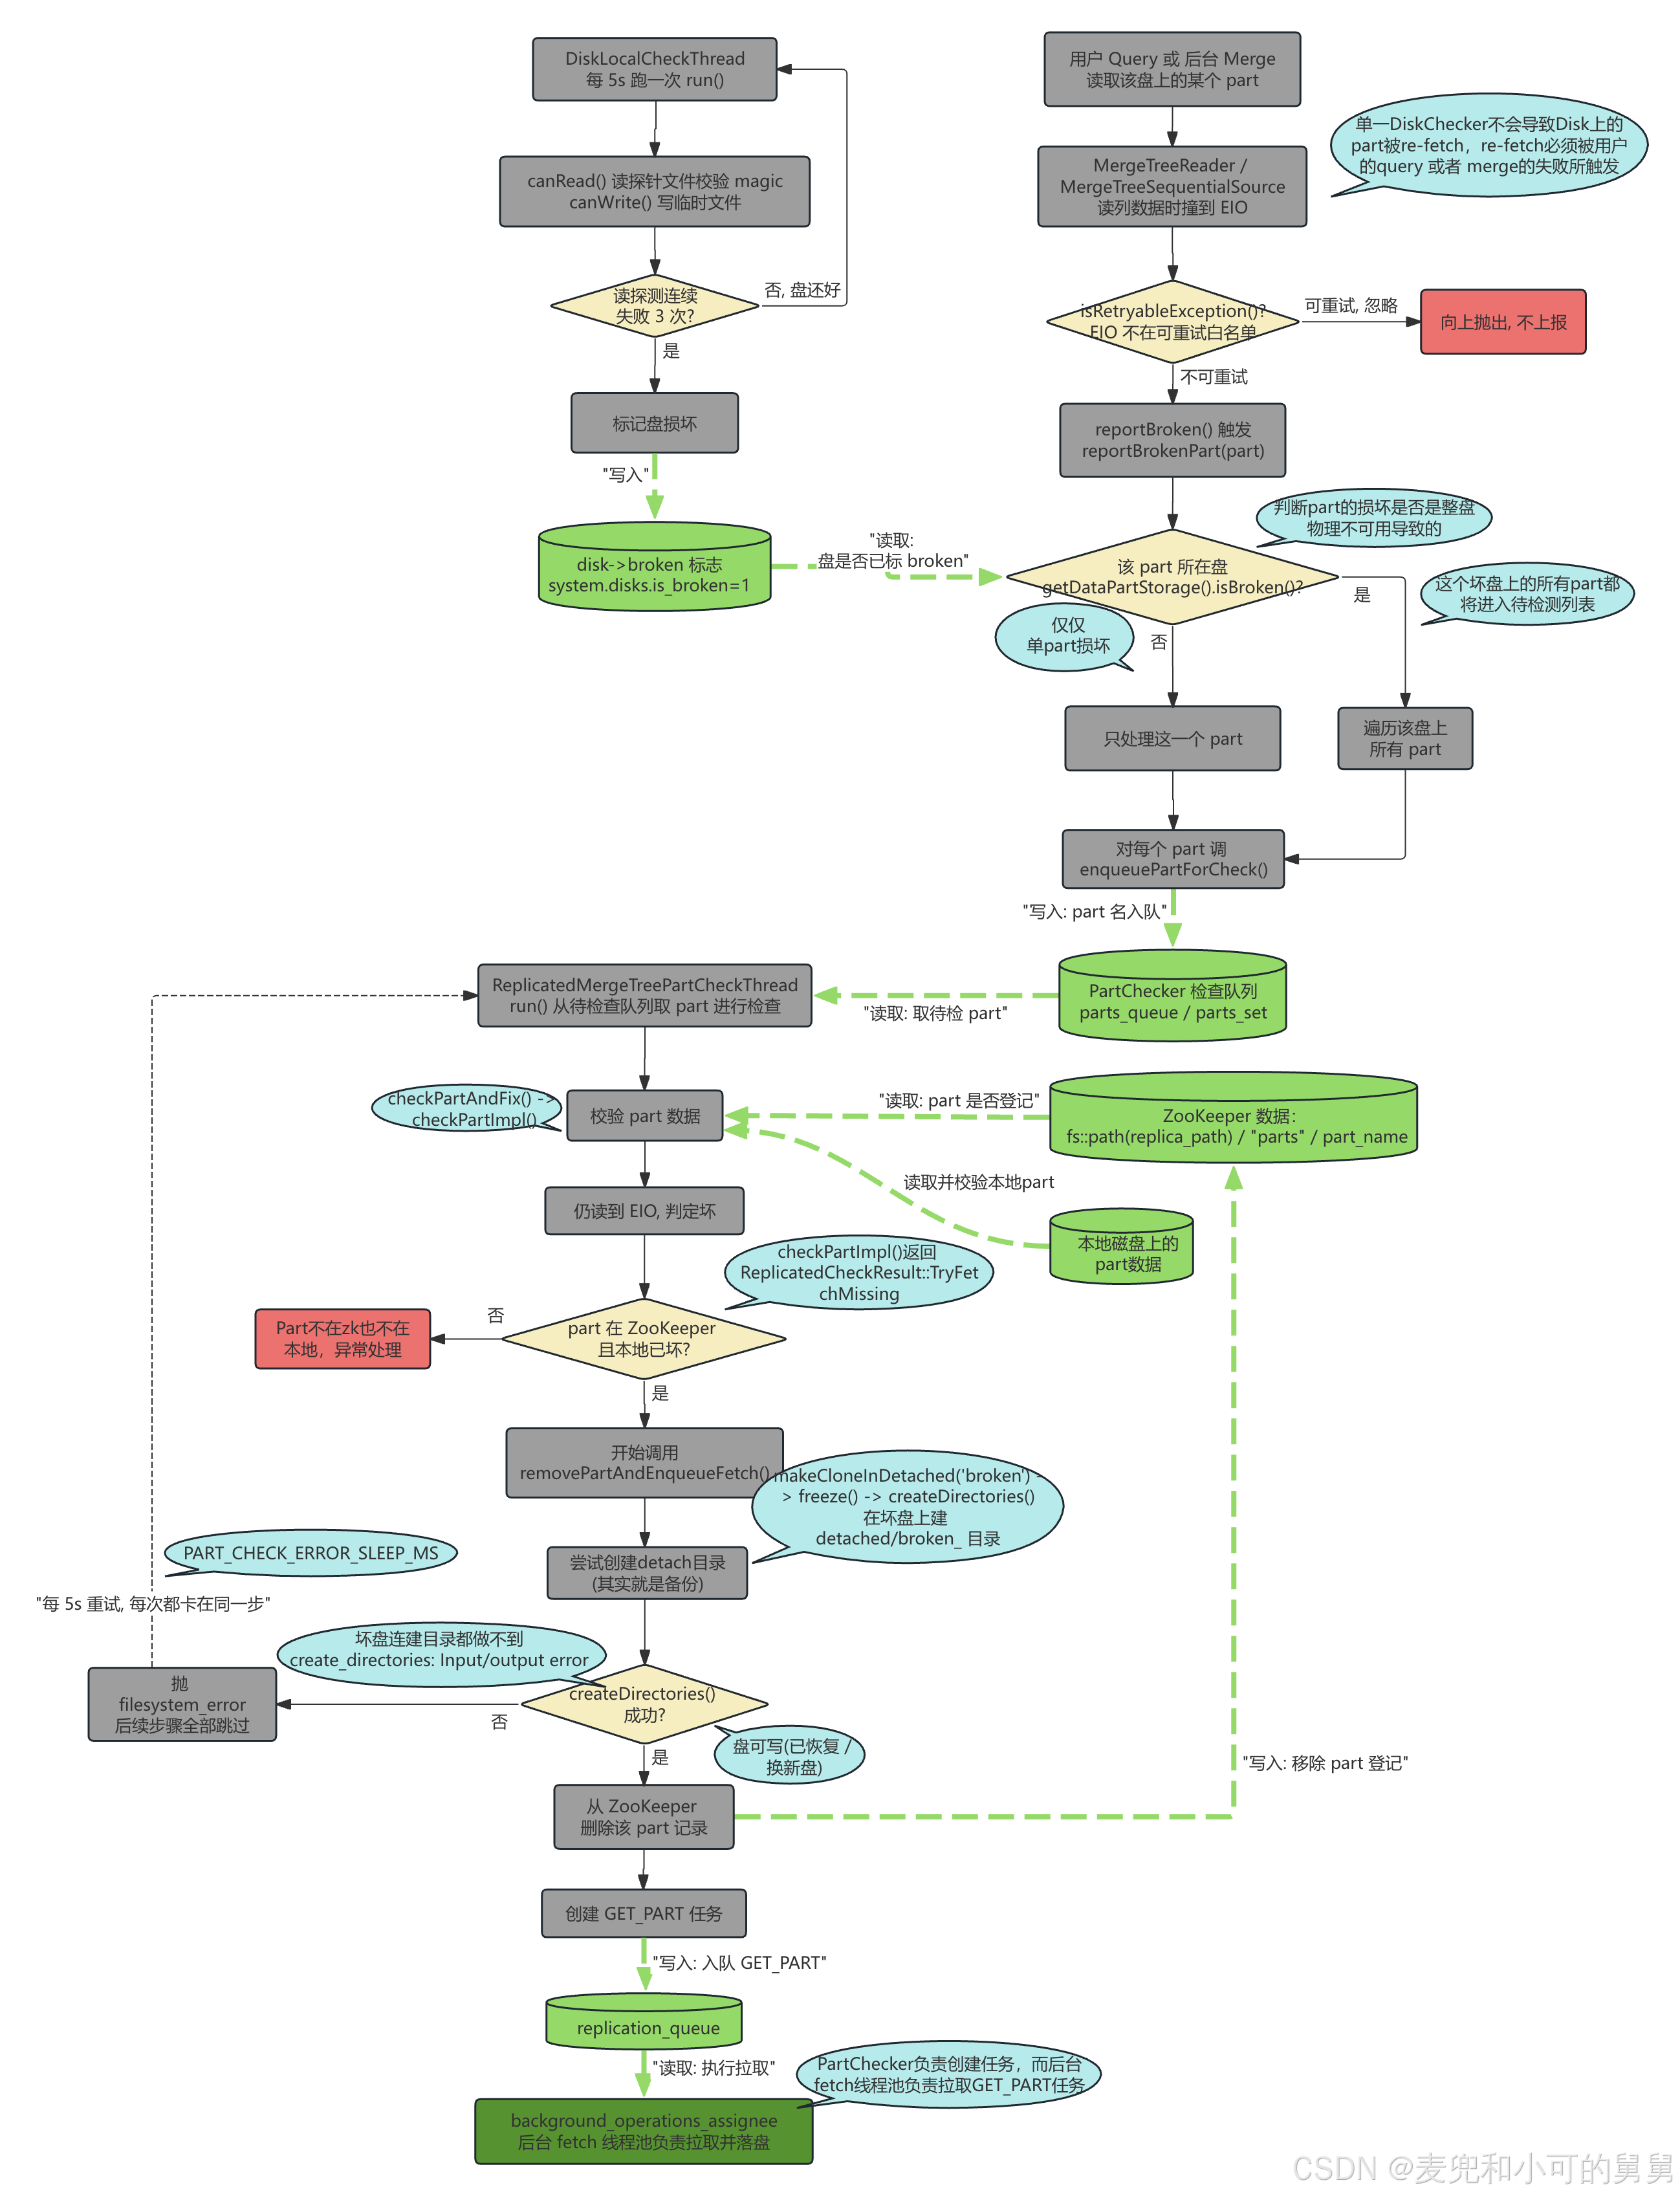
首先,我们需要先知道,这个broken disk是谁发现的? 负责发现这件事的,是一个独立的探针线程DiskLocalCheckThread,即每个本地盘(DiskLocal,注意是每块盘,不是每个Server)都可以挂一个这样的后台探测任务,不过它只在配置了local_disk_check_period_ms > 0时才创建(默认值是0,即默认不开启):
// src/Disks/DiskLocal.cpp (构造 DiskLocal 时)
auto local_disk_check_period_ms = config.getUInt("local_disk_check_period_ms", 0);
if (local_disk_check_period_ms > 0)
disk_checker = std::make_unique<DiskLocalCheckThread>(this, context, local_disk_check_period_ms);
开启后,它周期性地跑run(),用一次读探测(canRead():读盘上的checker文件并校验magic number)加一次写探测(canWrite():往盘上写一个临时文件)判断盘是否健康。
nvme9硬件故障后,读探测持续失败,于是走到标记broken的分支, 这就是我们最开始在system.disks里看到disk9is_broken=1的由来。(如果没配local_disk_check_period_ms,这个探测线程根本不存在,运行期就没人去把盘标记broken,只剩启动时加载失败这一条兜底路径,这也是运维时值得注意的一个点)
// src/Disks/DiskLocalCheckThread.cpp
// static const auto DISK_CHECK_ERROR_SLEEP_MS = 1000;
// static const auto DISK_CHECK_ERROR_RETRY_TIME = 3;
void DiskLocalCheckThread::run()
{
...
bool can_read = disk->canRead();
bool can_write = disk->canWrite();
if (can_read)
{
// 读探测成功:盘是好的,清零重试计数、按正常周期再排
retry = 0;
disk->readonly = !can_write; // 能读不能写 → 只读
disk->broken = false;
task->scheduleAfter(check_period_ms);
}
else if (!disk->broken && retry < DISK_CHECK_ERROR_RETRY_TIME)
{
// 读探测失败但还没到重试上限:快速重试(每次间隔 1s)
++retry;
task->scheduleAfter(DISK_CHECK_ERROR_SLEEP_MS);
}
else
{
// 连续重试仍失败 → 标记 broken
retry = 0;
if (!disk->broken)
LOG_ERROR(log, "Disk {} marked as broken", disk->getName()); // ← 对应 system.disks 里的 is_broken=1
disk->broken = true;
task->scheduleAfter(check_period_ms);
}
...
}
当坏盘被发现并标记broken之后,还不会直接触发坏part的识别和坏part的re-fetch。接下来,还要有读操作(后台merge或查询)落到这块盘上、撞到Input/Output Error,就会调用MergeTreeData::reportBrokenPart(...)来试图对这个Part甚至这个Part所在的磁盘(如果的确磁盘已经损坏)上的所有part进行处理:
// src/Storages/MergeTree/MergeTreeData.cpp
void MergeTreeData::reportBrokenPart(MergeTreeData::DataPartPtr data_part) const
{
if (!data_part)
return;
if (data_part->isProjectionPart())
{
// projection part 坏了,回溯到它的 parent part 再处理
...
data_part = parent_part;
}
if (data_part->getDataPartStorage().isBroken()) // 整块盘全部损坏
{
// 整盘 broken:扫描该盘上的每一个 part,逐个交给 PartCheckThread
auto parts = getDataPartsForInternalUsage();
LOG_WARNING(log, "Scanning parts to recover on broken disk {}@{}.",
data_part->getDataPartStorage().getDiskName(),
data_part->getDataPartStorage().getDiskPath());
// ↑ 对应日志里反复出现的「Scanning parts to recover on broken disk disk9@/viva/data/nvme9/clickhouse/.」
for (const auto & part : parts)
{
if (part->getDataPartStorage().getDiskName() == data_part->getDataPartStorage().getDiskName())
broken_part_callback(part->name); // ← 把 part 塞进 ReplicatedMergeTreePartCheckThread 的待检查队列
}
}
else if (data_part->getState() == MergeTreeDataPartState::Active)
broken_part_callback(data_part->name); // 盘没坏、只是单个 active part 坏:只挂这一个
else
// 连 active 都不是(Outdated 等),既不扫盘也不单挂,只留一条 DEBUG
LOG_DEBUG(log, "Will not check potentially broken part {} because it's not active",
data_part->getNameWithState());
}
可以看到,这里通过getDataPartStorage().isBroken()判断Broken Part所在的盘是否是坏盘,即part的损坏是个例,还是因为磁盘的损坏引起的规模性事件:
- 如果所在磁盘的确已经broken,那么就走全盘扫描、把每个part都
broken_part_callback一遍;
这里的auto parts = getDataPartsForInternalUsage(); LOG_WARNING(log, "Scanning parts to recover on broken disk {}@{}.", data_part->getDataPartStorage().getDiskName(), data_part->getDataPartStorage().getDiskPath()); // ↑ 对应日志里反复出现的「Scanning parts to recover on broken disk disk9@/viva/data/nvme9/clickhouse/.」 for (const auto & part : parts) { if (part->getDataPartStorage().getDiskName() == data_part->getDataPartStorage().getDiskName()) broken_part_callback(part->name); // ← 把 part 塞进 ReplicatedMergeTreePartCheckThread 的待检查队列 }broken_part_callback其实就是enqueuePartForCheck(...)(下文会看到): 它把part名字塞进ReplicatedMergeTreePartCheckThread的待检查队列,后台检查线程随之被唤醒。 - 如果盘还没被标记broken,则只走
else if (Active)分支、只挂当前这一个part;else if (data_part->getState() == MergeTreeDataPartState::Active) broken_part_callback(data_part->name); // 盘没坏、只是单个 active part 坏:只挂这一个
被唤醒后的ReplicatedMergeTreePartCheckThread::run()会从队列里取出一个待检查的part交给checkPartAndFix(...),并在最外层用try/catch兜住所有异常:
// src/Storages/MergeTree/ReplicatedMergeTreePartCheckThread.cpp
void ReplicatedMergeTreePartCheckThread::run()
{
...
try
{
PartsToCheckQueue::iterator selected = parts_queue.end();
std::lock_guard lock(parts_mutex);
selected = std::find_if(parts_queue.begin(), parts_queue.end(), [current_time](const auto & elem)
{
return elem.time <= current_time;
});
std::optional<time_t> recheck_after;
// 取出一个待检查的 part,做校验并尝试修复
checkPartAndFix(selected->name, &recheck_after, /* throw_on_broken_projection */false);
...
storage.checkBrokenDisks(); // ← 后面会讲:顺带把「整盘 broken」的 part 也补挂进队列
task->schedule(); // 正常情况下立刻排下一轮
}
catch (const Coordination::Exception & e)
{
tryLogCurrentException(log, __PRETTY_FUNCTION__);
if (Coordination::isHardwareError(e.code))
return;
task->scheduleAfter(PART_CHECK_ERROR_SLEEP_MS);
}
catch (...)
{
// detach 在坏盘上抛出的 filesystem_error 最终在这里被兜住
tryLogCurrentException(log, __PRETTY_FUNCTION__);
// ↑ 对应日志第三条:「void DB::ReplicatedMergeTreePartCheckThread::run(): std::exception. Code: 1001 ... filesystem error」
// 出错后固定延迟再次调度 —— 这就是「每隔几秒重试一次」的来源
task->scheduleAfter(PART_CHECK_ERROR_SLEEP_MS);
}
}
在ReplicatedMergeTreePartCheckThread::run()中,真正做检查和修复决策的是checkPartAndFix(...)。它内部分两步:
-
先对本地part做校验、得到一个带
action的检查结果。这里会打印日志:2026.07.01 08:56:12.207474 <Error> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Part 20250528_0_3_1_276 looks broken. Removing it and will try to fetch. -
再根据
action执行修复(这一步打印日志第二条并调用removePartAndEnqueueFetch()):CheckResult ReplicatedMergeTreePartCheckThread::checkPartAndFix(const String & part_name, std::optional<time_t> * recheck_after, bool throw_on_broken_projection) { // 我们看到了这条日志 LOG_INFO(log, "Checking part {}", part_name); ProfileEvents::increment(ProfileEvents::ReplicatedPartChecks); // 第一步(校验阶段,checkPartImpl 内):本地 part 读不了/校验不过,判定为坏 // 这里会打印日志: Part 20250528_0_3_1_276 looks broken. Removing it and will try to fetch. // 置 action = TryFetchMissing ReplicatedCheckResult result = checkPartImpl(part_name, throw_on_broken_projection); switch (result.action) // 第二步(checkPartAndFix 内,switch(result.action)): case ReplicatedCheckResult::TryFetchMissing: { // 这个 part 在 ZooKeeper 里仍然登记着(说明本 replica 本应拥有它), // 那就走「detach 本地坏副本 → 从 ZK 注销 → 排队重新 fetch」的修复路径 if (result.exists_in_zookeeper) { if (result.part) LOG_WARNING(log, "Part {} exists in ZooKeeper and the local part was broken. " "Detaching it, removing from ZooKeeper and queueing a fetch.", part_name); // ↑ 对应日志第二条 —— 注意这只是「打算这么做」的声明式日志,打印在真正执行 detach 之前 else LOG_WARNING(log, "Part {} exists in ZooKeeper but not locally. " "Removing from ZooKeeper and queueing a fetch.", part_name); storage.removePartAndEnqueueFetch(part_name, /* storage_init = */ false); break; } ... } ReplicatedCheckResult ReplicatedMergeTreePartCheckThread::checkPartImpl(const String & part_name, bool throw_on_broken_projection) { ..... // part 在 ZK 里:核对 checksums + checkDataPart if (exists_in_zookeeper) { // 我们看到了这条日志 LOG_INFO(log, "Checking data of part {}.", part_name); try { // 本地列/checksums 与 ZK 比对 zk_part_header.getChecksums().checkEqual(local_part_header.getChecksums(), true, part_name); checkDataPart(part, /*require_checksums*/ true, is_broken_projection, ..., throw_on_broken_projection); LOG_INFO(log, "Part {} looks good.", part_name); return result; } catch (...) { ..... // 我们看到了这条日志 LOG_ERROR(log, "Part {} looks broken. Removing it and will try to fetch.", part_name); result.action = ReplicatedCheckResult::TryFetchMissing; return result; } } ...... }可以看到,如果part存在于Keeper上,并且被发现损坏,并且决定从Peer Replica上进行fetch,那么会依次打印如下日志:
2026.07.01 08:56:12.206251 <Information> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Checking part 20250528_0_3_1_276 2026.07.01 08:56:12.207019 <Information> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Checking data of part 20250528_0_3_1_276. 2026.07.01 08:56:12.207474 <Error> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Part 20250528_0_3_1_276 looks broken. Removing it and will try to fetch. 2026.07.01 08:56:12.207479 <Warning> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): Part 20250528_0_3_1_276 exists in ZooKeeper and the local part was broken. Detaching it, removing from ZooKeeper and queueing a fetch.而
removePartAndEnqueueFetch(...)内部本应顺序完成几件事,但它的第一步就是对坏part调用makeCloneInDetached("broken", ...): 在原盘(disk9)上克隆出detached/broken_*目录:void StorageReplicatedMergeTree::removePartAndEnqueueFetch(const String & part_name, bool storage_init) { auto zookeeper = getZooKeeper(); auto broken_part_info = MergeTreePartInfo::fromPartName(part_name, format_version); // ① detach:在坏 part 原本所在的盘(disk9)上把它 clone 到 detached/broken_* // disk9 已损坏 → create_directories 抛 filesystem_error(EIO),异常在此冒泡出去,②③④都不执行 auto partition_range = getDataPartsVectorInPartitionForInternalUsage({MergeTreeDataPartState::Active, MergeTreataPartState::Outdated}, broken_pt_info.getPartitionId()); Strings detached_parts; for (const auto & part : partition_range) { ... // 这里报错 part->makeCloneInDetached("covered-by-broken", getInMemoryMetadataPtr(), /*disk_transaction*/ } LOG_WARNING(log, "Detached {} parts covered by broken part {}: {}", detached_parts.size(), part_name, fmt::join(detached_parts, ", ")); // ② 从 ZK 注销本 replica 对该 part 的所有权 getRemovePartFromZooKeeperOps(part_name, ops, ...); // ③ 创建 GET_PART,让复制队列去 peer 上重新 fetch(②③作为一次 tryMulti 原子提交) log_entry->type = LogEntry::GET_PART; log_entry->new_part_name = part_name; zookeeper->tryMulti(ops, results, ...); LOG_DEBUG(log, "Created entry {} to fetch missing part {}", log_entry->znode_name, part_name); // ④ 把坏 part 从内存 active 集合中摘掉(放在建 GET_PART 之后,避免副本发散) outdate_broken_part(); }可惜,第一步即报错:
2026.07.01 08:56:12.207700 <Error> default.ad_summary_11_local (ReplicatedMergeTreePartCheckThread): void DB::ReplicatedMergeTreePartCheckThread::run(): std::exception. Code: 1001, type: std::__1::filesystem::filesystem_error, e.what() = filesystem error: in create_directories: Input/output error ["/viva/data/nvme9/clickhouse/store/248/2486d4ec-525a-41ca-9604-81bdd7f02dc5/detached/broken_20250528_0_3_1_276"] ........ 3. std::filesystem::detail::ErrorHandler<bool>::report(...) @ 0x000000001fcae9e2 4. std::filesystem::__create_directories(...) @ 0x000000001fcaf1cf 5. DB::DiskLocal::createDirectories(String const&) @ 0x000000001728857a 6. DB::(anonymous namespace)::BackupImpl(...) @ 0x00000000190d8a54 7. DB::Backup(...) @ 0x00000000190d85a9 8. DB::DataPartStorageOnDiskBase::freeze(...) @ 0x00000000190c38ff 9. DB::IMergeTreeDataPart::makeCloneInDetached(...) @ 0x0000000019124870 10. DB::StorageReplicatedMergeTree::removePartAndEnqueueFetch(...) @ 0x0000000018c78f8e 11. DB::ReplicatedMergeTreePartCheckThread::checkPartAndFix(...) @ 0x000000001960dc98所以,我们没有看到任何一个detach成功的WARNING日志:
LOG_WARNING(log, "Detached {} parts covered by broken part {}: {}", detached_parts.size(), part_name, fmt::join(detached_parts, ", "));
另外,我需要确认: ClickHouse的源码逻辑中,是否真的要求detach目录必须创建在坏盘上?能否绕过这一步? 如果这个「detach到原盘」的行为是可配置的,那就意味着我们可以在整个线上集群改一下配置来防止类似问题;如果是写死的,那就只能靠运维手段兜底。
带着这个问题,我们沿着removePartAndEnqueueFetch(...) → makeCloneInDetached(...) → freeze(...)这条调用链看下去。
第一层,removePartAndEnqueueFetch(...)对坏part调用makeCloneInDetached("broken", ...),注意最后一个参数disk_transaction传的是空{}:
// src/Storages/StorageReplicatedMergeTree.cpp
void StorageReplicatedMergeTree::removePartAndEnqueueFetch(const String & part_name, bool storage_init)
{
    ...
    if (broken_part_info == part->info)
    {
        part->was_removed_as_broken = true;
        part->makeCloneInDetached("broken", getInMemoryMetadataPtr(), /*disk_transaction*/ {});
        broken_part = part;
    }
    // ... 后续: 清 queue、从 ZK 注销、创建 GET_PART ...
}
第二层,makeCloneInDetached(...)——这就是之前缺的那一环。它算出detached/下的目标目录(如detached/broken_<part>),然后在part自己的storage上调用freeze(...)。关键在于getDataPartStorage()拿到的就是这个part所在的盘(disk9):
// src/Storages/MergeTree/IMergeTreeDataPart.cpp
DataPartStoragePtr IMergeTreeDataPart::makeCloneInDetached(const String & prefix, ...,
                                                           const DiskTransactionPtr & disk_transaction) const
{
    // 目标目录:detached/broken_<part>
    auto maybe_path_in_detached = getRelativePathForDetachedPart(prefix, /*broken=*/ !prefix.empty());
    if (!maybe_path_in_detached)
        return nullptr;

    IDataPartStorage::ClonePartParams params { ..., .make_source_readonly = true, .external_transaction = disk_transaction };

    // ★ 在 part 自己的 storage(= 它所在的 disk9)上 freeze,没有传入任何“换一块盘”的参数
    return getDataPartStorage().freeze(
        storage.relative_data_path,   // to:表数据根目录(在 disk9 上)
        *maybe_path_in_detached,      // dir_path:detached/broken_<part>
        ..., params);
}
第三层,freeze(...)真正落地建目录。因为上面disk_transaction是空的,params.external_transaction为null,于是走disk->createDirectories(to)这条分支——而disk来自volume->getDisk(),正是disk9:
// src/Storages/MergeTree/DataPartStorageOnDiskBase.cpp
MutableDataPartStoragePtr DataPartStorageOnDiskBase::freeze(
    const std::string & to, const std::string & dir_path, ..., const ClonePartParams & params) const
{
    auto disk = volume->getDisk();          // ★ part 原本所在的 disk,这里就是 disk9

    if (params.external_transaction)
        params.external_transaction->createDirectories(to);
    else
        disk->createDirectories(to);        // ★ 在 disk9 上创建 detached/ 目录 —— 坏盘 EIO,就在这里抛 filesystem_error

    Backup(disk, disk, getRelativePath(), fs::path(to) / dir_path, ...);
    // ★ 源盘、目标盘都是同一个 disk(disk9),在坏盘上做 hardlink/copy
    ...
}
关键发现,也回答了最初的两个疑问:
- 整条
makeCloneInDetached() → freeze()链路里,目标盘自始至终来自volume->getDisk(),也就是part原本所在的disk9,没有任何参数或配置项能把它重定向到别的健康盘。所以「detach到原盘」是这条代码路径写死的行为,不可配置。 - 顺带说明:ClickHouse并非没有「跨盘clone」的能力——同一批接口里就有
freezeRemote(..., const DiskPtr & dst_disk, ...)和IMergeTreeDataPart::makeCloneOnDisk(const DiskPtr & disk, ...),它们都能把part落到指定的另一块盘上;但detach走的偏偏是同盘的freeze(...),而不是它们。 - 所以,这个问题无法通过改集群配置规避(没有对应开关),后续只能靠运维手段兜底(把坏盘从配置里摘除 + 重启走启动路径、加监控等)。
所以, 总体来说,我们可以回答,为什么坏盘期间,明明同一Shard的另外一个Replica完好无损,但是查询却一直概率性失败:
-
损坏的Part没有被成功evict,而是一直被认为是有效的Part,直到读取的时候才发现失败;
disk9标记is_broken=1后,MergeTreeData::reportBrokenPart(...)→PartCheck线程尝试StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)- 恢复路径需要
IMergeTreeDataPart::makeCloneInDetached(...)→DataPartStorageOnDiskBase::freeze(...)→ 在同一块坏盘上建目录 - 坏盘 EIO → detach 失败 →
GET_PART永远入不了队 → part 在内存里仍是 Active system.parts显示active=1,disk_name=disk9→ SELECT 仍会读到它
-
Part的读取失败,无法被正确处理和正确Failover。下文会讲为什么无法被Failover;
为什么Distributed查询的Failover没有生效?
我们先看一下连接失败在Hedge和非Hedge场景下为什么没有触发Connection的Failover,然后,我们看一下,在Hedge Enable场景下,这种磁盘失败为什么没有触发Hedge?注意,这是两种不同的情形:
- 直观上来讲,在多Replica的场景下,无论是Hedge还是非Hedge,都应该记录Replica的失败,后续Query尽量打到失败较少的Replica上,这本来就是多Replica在Query场景下的存在的价值。但是,这不是Hedge,只是普通的Priority-Based Failover;
- 而对于Hedge,如果一个Replica总是出错,那么Hedge机制是否会让ClickHouse对当前的Query立刻采取Hedge行为,即,立刻把Query发送到对等的其他Replica上呢?这取决于ClickHouse的Hedge 策略。
我们看一下他们的实现机制,从而在代码层面解释,为什么坏盘没有触发对应的Replica的降级,从而逐渐降低Query层面的影响。
Failover层面的失败重试不针对磁盘异常
我们的集群架构是典型的Distributed(*_pt1h_*) + ReplicatedMergeTree(*_local) 架构:
- 每个 Shard 有 2 个 Replica,存储在 JBOD 多盘(disk1–disk12),
- 当客户端查 Distributed 表,由 Initiator 节点按 Shard 选 replica 发远程查询;
- 在每一个Shard中选 replica 的核心组件是
ConnectionPoolWithFailover;
在我的另外一篇文章中说过,一个ConnectionPoolWithFailover对象代表的是一个Shard内对Replica的选择策略,它维护了这个Shard中每个 replica 的error_count和slowdown_count,其优先级是按照下列多个不同的维度去依次参考(即errors_count一致则参考slowdowns_count,slowdowns_count一致则参考config_priority,以此类推)。我们看到,error_count的优先级最高:
我们在(error_count, slowdown_count, config_priority, priority, random)system.clusters里看到的每一个Replica的errors_count、slowdowns_count,,estimated_recovery_time就来自这里。
所以,理论上讲,Distributed表查询有replica failover机制: 在一个Shard内,ClickHouse会根据策略选择对应的Replica来serve。一个Replica发生的error越多,其优先级越低。
但我们的测试发现,无论运行多少次,发生错误的几率几乎都保持不变,都在偶尔而频发地发生,而不是渐渐不发生。
其实,Shard内确实有基于replica error计数的负载均衡,但它主要覆盖连接层失败,对于我们这种查询执行中读坏盘 (Code 76/EIO) 的保护很弱。我在我的另外一篇文章中讲解过,ClickHouse通过ConnectionPoolWithFailover选择replica:
// src/Client/ConnectionPoolWithFailover.cpp
// Pools are tried in the order consistent with lexicographical order of:
// (error_count, slowdown_count, config_priority, ...) tuples.
但代码分析表明,Code 76 (CANNOT_OPEN_FILE) 这类查询执行错误通常不会增加replica的error_count。error_count增加的场景主要是TCP连接失败。
我们下文会讲解。即,在非Hedged Request和Hedged Request(Linux环境下默认)两种连接方式下,我们的磁盘损坏导致的错误,都不会让error_count增加从而让Shard中的Replica的优先级降低的机制,即,我们的磁盘损坏场景,不会触发Replica优先级降级:
ClickHouse使用我们配置的load_balancing策略来进行Replica的选择,默认的load_balancing策略是random,这里的random,就是基于对error_count和slowdown_count优先级考虑以后的random策略(这个random其实有一定的误导性,当配置为random以后,实际的做法是,先按照优先级的考虑因素的先后顺序(error_count -> slowdowns_count -> …),逐级考虑优先级,如果优先级一致,则随机(random)选择):
ClickHouse supports the following algorithms of choosing replicas:

- [Random](#load_balancing-random) (by default)
- [Nearest hostname](#load_balancing-nearest_hostname)
- [Hostname levenshtein distance](#load_balancing-hostname_levenshtein_distance)
- [In order](#load_balancing-in_order)
- [First or random](#load_balancing-first_or_random)
- [Round robin](#load_balancing-round_robin)

See also:

- [distributed_replica_max_ignored_errors](#distributed_replica_max_ignored_errors)

### Random (by Default) {#load_balancing-random}

load_balancing = random

The number of errors is counted for each replica. The query is sent to the replica with the fewest errors, and if there are several of these, to anyone of them.
Disadvantages: Server proximity is not accounted for; if the replicas have different data, you will also get different data.
从上面的文档代码可以看到,load_balancing=random意味着:连接失败越多的 replica,越不容易被选中。
那么,什么情况下,一个Replica的error_count会被增加,从而其被选择的优先级降低呢?
我们知道,无论是HedgedConnections,还是非Hedge模式下的MultiplexedConnections,底层都是通过ConnectionEstablisher来建立连接。ConnectionEstablisher会返回一个Entry,这个Entry是从连接池借出的一条 Connection 句柄(IConnectionPool::Entry)。
ConnectionEstablisher 在建立连接阶段捕获以下网络类异常后,会将 entry 置空:
NETWORK_ERRORSOCKET_TIMEOUTATTEMPT_TO_READ_AFTER_EOFDNS_ERRORCANNOT_READ_FROM_SOCKET
这时候,ConnectionEstablisher 的使用者会通过判断entry.isNull()来知道网络连接是否建立成功:
entry.isNull(),意味着连这条 TCP 连接都没拿到(或拿到后又因网络异常被 reset)- entry 非空但
is_usable=false: TCP 已通,但表不存在,或者 replica 太 stale 等等原因,因此 不加error_count
我在另外一篇文章中讲过,MultiplexedConnections和HedgedConnections分别对应了非Hedge模式和Hedge模式,他们下层都是基于构造的ClickHouse Server端的 ConnectionPoolWithFailover来管理一个Shard内部的Replica的连接的, 而ConnectionPoolWithFailover下层则是通过ConnectionEstablisher来真正建立连接。
当然,Hedged模式下是对ConnectionEstablisher进行了封装变成了ConnectionEstablisherAsync。
需要注意ConnectionPoolWithFailover, HedgedConnections/HedgedConnectionsFactory和MultiplexedConnections的生命周期:
进程 (ClickHouse Server)                                  # 集群里每台节点都持有这样一份结构,任意节点都可能作为 Initiator
├── ConnectionPoolFactory (singleton)                    # ClickHouse Server内部唯一,按远程 host:port 去重,并缓存底层连接池
│   └── ConnectionPool                                   # 每个远程 host:port 一个,内部维护到该实例的 TCP 连接、可复用
│
├── Context::clusters                                    # 从 remote_servers 的配置加载,ClickHouse Server 内缓存的所有 Cluster 对象
│   └── Cluster ("viva_all")                          # key 是 system.clusters 里的集群名
│       └── ShardInfo (shard 1 ~ 12)                     # viva_all 共 12 个 shard(每个 shard 2 个 replica,合计 24 台)
│           ├── pool: ConnectionPoolWithFailover         # Initiator 侧、每个 shard 一个;在 Cluster 构建(配置加载)时创建、跨查询复用
│           │                                            #   作用:在该 shard 的多个 replica 之间做 failover / 负载均衡
│           └── per_replica_pools: [pool_r1, pool_r2]    # 该 shard 每个 replica 各一个底层 ConnectionPool(复用上面 Factory 里的实例)
│
└── 单次查询                                              # 下面都是 Per Query 的,随查询创建,查询结束即销毁
    └── ReadFromRemote                                   # 分布式读取的执行算子,Per Query Per ReadFromRemote istance
        └── 每个参与的 shard 一个 RemoteQueryExecutor      # Per Query、Per Shard,一个 shard 一个
            └── sendQuery() 时创建 HedgedConnections / MultiplexedConnections   # 分别对应 Hedge / 非 Hedge 模式
                └── 从 shard.pool 借连接                  # 从上面那个常驻的 ConnectionPoolWithFailover 借连接,用完归还
可以看到:
ConnectionPoolWithFailover是在Initiator端所在的ClickHouse Server刚启动的时候就被构建完成的,它是Per-Cluster Per Shard的,而不是Per Query的RemoteQueryExecutor、ReadFromRemote,HedgedConnections/MultiplexedConnections是 Per Cluster, Per Shard , Per Query的
我们先看一下 非 Hedged 路径的核心逻辑。
我在我的另外一篇文章中讲过,非Hedge模式下,通过调用 ConnectionPoolWithFailover::getMany(...)来一次性获取Connection,其实是调用其基类的PoolWithFailoverBase::getMany(...)来获取连接,在这个方法里,我们可以看到,
ConnectionPoolWithFailover::getMany(...)首先通过getShuffledPools(...)按照前面讲过的(error_count, slowdown_count, config_priority, ...)优先级把当前Shard内的Replica排好序(error_count越少越靠前),- 然后依次尝试从每个pool借连接:
- 如果
result.entry非空,说明这个Replica的连接建立成功,++entries_count,直接使用该Replica; - 如果
result.entry.isNull(),说明连接建立失败,就把这个shuffled_pool.error_count加一(上限为max_error_cap),当某个pool的error_count累加到max_tries时,认为这个Replica彻底失败,++failed_pools_count。
- 如果
template <typename TNestedPool>
std::vector<typename PoolWithFailoverBase<TNestedPool>::TryResult>
PoolWithFailoverBase<TNestedPool>::getMany(
        size_t min_entries, size_t max_entries, size_t max_tries,
        size_t max_ignored_errors,
        bool fallback_to_stale_replicas,
        bool skip_read_only_replicas,
        const TryGetEntryFunc & try_get_entry,
        const GetPriorityFunc & get_priority)
{
    std::vector<ShuffledPool> shuffled_pools = getShuffledPools(max_ignored_errors, get_priority);
    .....
    while (!finished)
    {
        for (size_t i = 0; i < shuffled_pools.size(); ++i)
        {
            .....
            if (!fail_message.empty())
                fail_messages += fail_message + '\n';

            if (!result.entry.isNull())
            {
                ++entries_count; // 连接成功,使用该 replica
                .....
            }
            else
            {
                LOG_WARNING(log, "Connection failed at try №{}, reason: {}", (shuffled_pool.error_count + 1), fail_message);

                shuffled_pool.error_count = std::min(max_error_cap, shuffled_pool.error_count + 1);

                if (shuffled_pool.error_count >= max_tries)
                {
                    ++failed_pools_count;
                    ProfileEvents::increment(ProfileEvents::DistributedConnectionFailAtAll);
                }
            }
        }
    }
    return try_results;
}
而对应的HedgedConnections则不会调用ConnectionPoolWithFailover::getMany(...)方法一次性尝试获取连接,而是基于EPoll的方式异步建立连接。
我在专门讲解HedgedConnections的文章中,讲过HedgedConnectionsFactory::processFinishedConnection(...)方法,它在连接建立完成(成功或者失败)以后被调用,进而更新error_count和slowdown_count:
HedgedConnectionsFactory::State HedgedConnectionsFactory::processFinishedConnection(int index, TryResult result, Connection *& connection_out)
{
    const std::string & fail_message = replicas[index].connection_establisher->getFailMessage();
    if (!fail_message.empty())
        fail_messages += fail_message + "\n";

    if (!result.entry.isNull())
    {
        ++entries_count;
        .... // 连接成功,使用该 replica
    }
    else
    {
        ShuffledPool & shuffled_pool = shuffled_pools[index];
        LOG_INFO(log, "Connection failed at try №{}, reason: {}", (shuffled_pool.error_count + 1), fail_message);

        shuffled_pool.error_count = std::min(pool->getMaxErrorCap(), shuffled_pool.error_count + 1);
        shuffled_pool.slowdown_count = 0; // 将对应的error count和slowdown count记录到当前的HedgedConnectionsFactory的shuffled_pools中,在HedgedConnectionsFactory的析构的时候,会把这个信息更新到ClickHouse Server对应的Replica的error coutn等信息中

        if (shuffled_pool.error_count >= max_tries)
        {
            ++failed_pools_count;
            ProfileEvents::increment(ProfileEvents::DistributedConnectionFailAtAll);
        }
    }

    return State::CANNOT_CHOOSE;
}

HedgedConnectionsFactory::~HedgedConnectionsFactory()
{
    /// Stop anything that maybe in progress,
    /// to avoid interference with the subsequent connections.
    ///
    /// I.e. some replcas may be in the establishing state,
    /// this means that hedged connection is waiting for TablesStatusResponse,
    /// and if the connection will not be canceled,
    /// then next user of the connection will get TablesStatusResponse,
    /// while this is not the expected package.
    stopChoosingReplicas();
    // 这里的Pool, 是ConnectionPoolWithFailover对象, 一个ConnectionPoolWithFailover对象是 Per Cluster, Per Shard的
    pool->updateSharedError(shuffled_pools); // HedgedConnectionsFactory析构的时候,将本次Query累积在shuffled_pools里的error_count/slowdown_count合并更新回Per-Cluster Per-Shard的ConnectionPoolWithFailover对象中,从而左右后续其他Query对该Shard内Replica的选择
}
可以看到,HedgedConnectionsFactory::processFinishedConnection(...)会记录下当前的Query执行过程中的连接错误等信息,但是,这只是当前Query的生命周期的连接错误信息,不是整个Shard的全局信息。所以,在Query结束以后,在析构对应的HedgedConnectionsFactory的时候,会把对应的error_count等信息更新到Initiator端的Per-Shard 的ConnectionPoolWithFailover对象中,进而左右后续其他Query对Replica的选择结果。
所以,上面error_count增加的场景没有覆盖什么情况?
- TCP 已建立,但表不存在 / replica delay 过大(entry 非空、
is_usable=false) - 查询执行中失败(Code 76 读坏盘)——连接已成功,不算连接失败
我们注意到,error数量的增加也不会导致一个Replica永远不会被选择,即,它不会导致Replica被判死刑,实际情况是: error count会随着时间衰减,避免一个Replica由于之前的error count而永远无法被恢复: 我们可以通过配置distributed_replica_error_half_life类决定error_count的半衰期, 默认 60 秒:error_count 每过一个周期右移一位(减半)。就算连接层有 error,也会较快恢复,无法长期标记坏节点。上限由 distributed_replica_error_cap(默认 1000)控制。
Hedge层面只是用来抛弃慢查询,而不是失败
当我们通过use_hedged_requests=True打开Hedged Request(Linux默认开启), Hedged层面的目标不是「失败重试」,而是规避慢 replica:
下面是ClickHouse的源码对use_hedged_requests的定义:
DECLARE(Bool, use_hedged_requests, true, R"(
Enables hedged requests logic for remote queries. It allows to establish many connections with different replicas for query.
New connection is enabled in case existent connection(s) with replica(s) were not established within `hedged_connection_timeout`
or no data was received within `receive_data_timeout`. Query uses the first connection which send non empty progress packet (or data packet, if `allow_changing_replica_until_first_data_packet`);
other connections are cancelled. Queries with `max_parallel_replicas > 1` are supported.
从定义我们也能看到:
ClickHouse的HedgedRequest的两个超时触发点如下所示 :
| 阶段 | 设置 | 默认值 | 含义 |
|---|---|---|---|
| 连接建立 | hedged_connection_timeout_ms | 50ms | 第一个 replica 建连太慢,启动第二个 |
| 等待首包 | receive_data_timeout_ms | 2000ms | 发完 query 后 2 秒内无 progress/data,启动第二个 |
所以,HedgedConnection在最开始的时候只会和一个Replica建立连接。
- 在建立连接阶段,开始了
hedged_connection_timeout_ms的倒计时计时,如果超时,则启动Hedge - 发 query 后,计时器则重置为
receive_data_timeout,如果收数据超时,则也启动Hedge
所以,之所以磁盘导致的快速失败为什么不触发 hedge,我们可以以下面的坏盘场景的典型时间线为例子来解释:
t=0ms      连上坏 replica(TCP 正常,< 50ms)
t=几十ms   发送 query,启动 receive_data_timeout 计时(2000ms)
t=几百ms   读到坏 part → 服务端发 Exception (Code 76)
           ↑ 远小于 2000ms → hedge 未启动
           ↑ 收到 Exception → disableChangingReplica
           → 查询直接失败,不会切到 peer replica
Packet HedgedConnections::receivePacketFromReplica(const ReplicaLocation & replica_location)
{
    ReplicaState & replica = offset_states[replica_location.offset].replicas[replica_location.index];
    Packet packet = std::move(last_received_packet);
    switch (packet.type)
    {
        ....
        case Protocol::Server::Exception:
        default:
            /// Check case when we receive Exception before first not empty data packet
            /// or positive progress. It may happen if max_parallel_replicas > 1 and
            /// there is no way to sample data in this query.
            if (offset_states[replica_location.offset].can_change_replica)
                disableChangingReplica(replica_location); // Hedge层面已经分出了胜负,这时候会cancel掉除了自己以外的其他正在运行的Hedge Request
            finishProcessReplica(replica, true); // 处理自己的异常
            break;
    }

    return packet;
}
可以看到,在Hedge层面,收到异常也是收到了数据,也是有了响应,因此也是一种胜利。
这时候
- 如果Hedge的确还没有分出胜负,那么这个Exception的到来就可以决定胜负了: 收到异常的Replica胜出。随后,通过
HedgedConnections::disableChangingReplica(...)cancel 掉已在建立的备用连接(除了自己)。然后,调用HedgedConnections::finishProcessReplica(...)来处理自己收到的异常。 - 如果发生超时,Hedged 路径在
receive_data_timeout超时时还会累加slowdown_count,影响后续 replica 排序。但这同样只对慢 replica 有效,同样对快速 EIO 无效。
所以,在Hedge层面,Hedge 的设计是用快的,不是救失败的。。在receive_data_timeout的时间内只要收到了消息(不管是正常的data/progress包,还是Exception包),对Hedge的计时器来说都算作「这个Replica有响应」,于是receive_data_timeout根本不会超时,Hedge也就不会被触发去启动备用连接——这正是坏盘的快速失败(几百ms就把Exception返回,远小于2000ms)绕过Hedge的根本原因:Hedge等的是「慢」,而坏盘给的是「快速的失败」,快速的失败在Hedge眼里和快速的成功没有区别,都是「有响应」。
Distributed SELECT层面也没有Failover机制
既然在下层连接层面,包括在Hedge层面,都无法处理磁盘失败导致Replica失败的情形,那么,在上层Distributed Query层面,当下层已经反馈上来了某个Replica的失败,是否可以在某个Replica发生了Failure以后,自动选择另外一个Replica呢?
结论是,Distributed SELECT 的编排(StorageDistributed / ClusterProxy)按 shard 发起远程查询。同 shard 的 replica failover 只发生在连接选择阶段(ConnectionPoolWithFailover / hedged 建连)。一旦某个 replica 已经承接查询并返回失败,编排层不会自动换同 shard 的其他 replica 重试,异常直接返回客户端。
我们在查询一个Distributed表的基本层次如下所示:
StorageDistributed::read / ClusterProxy::executeQuery
        │  按 shard 扇出,拼 remote plan / local plan
        ▼
ReadFromRemote + RemoteSource
        │  每个 shard 一个(或一组)RemoteQueryExecutor
        ▼
RemoteQueryExecutor
        │  发 query、收 packet;收到 Exception 就 rethrow
        ▼
ConnectionPoolWithFailover / HedgedConnections
        │  只在“拿到可用连接”时做 replica 选择与 hedge
        ▼
TCP Connection + ConnectionEstablisher
           建连、可选 TablesStatus(表是否存在/延迟/readonly)
我们可以在代码层面得到印证。我们看到:
- 在查询入口层,
StorageDistributed直接交给ClusterProxy::executeQuery(...)执行:void StorageDistributed::read( QueryPlan & query_plan, const Names &, ) { ..... ClusterProxy::executeQuery( query_plan, header, ....); } ClusterProxy::executeQuery(...)会构造一个Per Query的ReadFromRemote和RemoteSource对象:void executeQuery( QueryPlan & query_plan, SharedHeader header, ..... AdditionalShardFilterGenerator shard_filter_generator, bool is_remote_function) { ..... if (!remote_shards.empty()) { .... auto read_from_remote = std::make_unique<ReadFromRemote>( std::move(remote_shards), header, ....); ... } .... }ReadFromRemote会为每个 shard 最终构造一个RemoteQueryExecutor,没有 “失败后换 replica 再跑一遍”的逻辑:RemoteQueryExecutor::ReadResult RemoteQueryExecutor::processPacket(Packet packet) { switch (packet.type) { ..... case Protocol::Server::Exception: got_exception_from_replica = true; packet.exception->rethrow(); break; // 失败直接退出 case Protocol::Server::EndOfStream: .... break; .... } return ReadResult(ReadResult::Type::Nothing); }
尝试多种解决方案
分析到这里,运行期的报错堆栈的前因后果已经清楚了:ReplicatedMergeTreePartCheckThread发现坏part后,调用removePartAndEnqueueFetch(part_name, /*storage_init=*/ false),而这个part此刻还以Active状态挂在内存里,函数第一步就要在disk9上detach它,create_directories撞上EIO,然后每几秒重试一次,陷入死循环。
这样看来,我们如果把这个坏盘从storage.xml中删掉,那么,由于ClickHouse启动加载part时,只扫描配置里还在的盘。 那么,它上面的part根本不会被加载进内存,随后就会被当成缺失part直接排队fetch,全程不需要在坏盘上detach。准确理解这里缺失的含义: 这个Part在任何一个磁盘上都不存在,但是在Zookeeper的Metadata中存在。
多种非重启方案的测试和探究
在了解了问题根源,我开始尝试各种可能的解决方案。我们尝试尽量不重启ClickHouse:
-
尝试 DROP PART - 失败
我的第一个想法是: 既然ClickHouse知道这个part坏了,我能不能手动DROP它,让ClickHouse自动从peer fetch?
但在执行前,我查了一下文档,发现了一个严重问题:The query is replicated – it deletes data on all replicas.
DROP PART在ReplicatedMergeTree上是replicated操作,会删除所有replica上的数据,包括健康的那台。这不是"修复本机坏数据",而是"永久删除数据"。
放弃这个方案。 -
从storage配置中移除disk9 - 无效
即能否通过修改storage配置,将disk9从配置中删除,期望ClickHouse热加载新配置?
编辑/etc/clickhouse-server/config.d/storage.xml,注释掉disk9,然后执行:radp606-6.iad7.prod.viva.com :) SYSTEM RELOAD CONFIG; Ok.执行后,重新查询
system.disks:radp606-6.iad7.prod.viva.com :) SELECT name, is_broken FROM system.disks ORDER BY name; ┌─name────┬─is_broken─┐ 10. │ disk9 │ 1 │ ← 还在! └─────────┴───────────┘disk9还在,配置没有生效。查看日志:
 2026.07.03 06:25:15.789 <Warning> DiskSelector:
 Disk disk9 disappeared from configuration,
 this change will be applied after restart of ClickHouse
原来,删除disk的配置需要重启才能生效,
SYSTEM RELOAD CONFIG只会打印警告,不会真的删除disk:
源码验证:// src/Disks/DiskSelector.cpp void DiskSelector::updateFromConfig(...) { size_t num_disks_removed_from_config = 0; std::ostringstream warning; for (const auto & [disk_name, disk_ptr] : disks) { if (!new_disks_map.contains(disk_name)) { warning << disk_name << ", "; ++num_disks_removed_from_config; } } if (num_disks_removed_from_config > 0) { LOG_WARNING( getLogger("DiskSelector"), "{} disappeared from configuration, this change will be applied after restart of ClickHouse", warning.str()); // ↑ 只打印警告,不做任何删除操作! } // 只添加新disk,不删除旧disk for (const auto & [disk_name, disk_ptr] : new_disks_map) { if (!disks.contains(disk_name)) disks.emplace(disk_name, disk_ptr); } }所以,从上面的代码可以看到,热加载只会添加新disk,不会删除旧disk。删除disk时只打印警告,真正的移除要等重启。
-
SYSTEM STOP LISTEN - 太激进
既然自动恢复卡住了,能否先把这台机器从查询路由中摘除?我们发现,执行后无法reconnect:
root@radp606-6:~# clickhouse-client
Code: 210. DB::NetException: Connection refused (localhost:9000). (NETWORK_ERROR)
SYSTEM STOP LISTEN QUERIES ALL停止了所有查询协议的监听,包括本地连接。这个命令太激进了,风险太高。放弃这个方案。
-
FETCH PARTITION - 可行但不够优雅
理论上,可以手动fetch partition,绕过detach步骤。但disk9上有大量的part,覆盖许多历史partition,手动FETCH每个partition会非常耗时,而且容易遗漏。
这个方案可行,但不够优雅,而且风险未知。
综合上面的所有尝试,我们确认了: 重启似乎是唯一出路。因此,在重启以前,我们需要在代码层面确认重启的确有效。
启动时,Replicated表对detach失败有容错 (ignore_error=true),可以跳过detach步骤,直接创建fetch队列。这给了我一个新的思路: 重启ClickHouse,让它走启动路径。
启动时的part加载逻辑:
// src/Storages/MergeTree/MergeTreeData.cpp
void MergeTreeData::loadDataParts(bool skip_sanity_checks)
{
    LOG_DEBUG(log, "Loading data parts");

    // 1. 扫描所有配置中的disk
    for (size_t i = 0; i < disks.size(); ++i)
    {
        const auto & disk_ptr = disks[i];

        if (disk_ptr->isBroken())
        {
            LOG_WARNING(log, "Skipping broken disk {}", disk_ptr->getName());
            continue;
            // ↑ 跳过is_broken=1的disk
            // ↑ 但disk9从配置删除后,根本不在disks列表中
        }

        loadDataPartsFromDisk(disk_ptr, pool);
    }

    // 2. 对于Replicated表,创建fetch队列
    bool replicated = dynamic_cast<StorageReplicatedMergeTree *>(this) != nullptr;
    if (replicated && !parts_to_fetch.empty())
    {
        createLogEntriesToFetchBrokenParts();
    }
}
启动时只会扫描配置中的disk,因此,如果disk9已从配置删除,它上面的part不会加载到内存。
基于以上分析,我决定:
- 先从storage配置中删除disk9
- 重启ClickHouse
- 让启动流程自动发现缺失的part并从peer fetch
执行恢复: 重启ClickHouse
在重启前,我必须确认几个前提条件:
- 同shard的另一个replica是否健康? - 在radp606-5上查询,确认数据正常
- 剩余盘的空间是否足够? - 剩余盘的总空闲空间约3TB,应该足够容纳disk9的数据
编辑配置文件,删除disk9的两处配置:
root@radp606-6:~# vi /etc/clickhouse-server/config.d/storage.xml
- 从
<disks>段删除整个<disk9>...</disk9>块 - 从
<jbod_volume>删除<disk>disk9</disk>
<clickhouse>
    <storage_configuration>
        <disks>
            <disk1>
                <path>/viva/data/nvme1/clickhouse/</path>
                <keep_free_space_bytes>104857600000</keep_free_space_bytes>
            </disk1>
            .....
            <disk8>
                <path>/viva/data/nvme8/clickhouse/</path>
                <keep_free_space_bytes>104857600000</keep_free_space_bytes>
            </disk8>
            <disk10>
                <path>/viva/data/nvme10/clickhouse/</path>
                <keep_free_space_bytes>104857600000</keep_free_space_bytes>
            </disk10>
            .....
        </disks>
        <policies>
            <ssd_in_order>
                <volumes>
                    <jbod_volume>
                        ....
                        <disk>disk8</disk>
                        <disk>disk10</disk>
                        ....
                    </jbod_volume>
                </volumes>
            </ssd_in_order>
        </policies>
    </storage_configuration>
</clickhouse>
必须同时从<disks>和<jbod_volume>两处删除disk9。
重启ClickHouse:
root@radp606-6:~# systemctl restart clickhouse-server
等待启动 (约10-20秒),然后观察日志:
root@radp606-6:~# tail -f /viva/data/log/clickhouse-server/clickhouse-server.log
我看到了对应的日志:
2026.07.03 07:58:02.772889 <Warning> default.ad_summary_1_local: Detached 0 parts covered by broken part 20260607_0_185_3:
基于我们上文对代码的理解,说明此时StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)方法已经执行成功:
void StorageReplicatedMergeTree::removePartAndEnqueueFetch(const String & part_name, bool storage_init)
{
  auto zookeeper = getZooKeeper();
  auto broken_part_info = MergeTreePartInfo::fromPartName(part_name, format_version);

 auto partition_range = getDataPartsVectorInPartitionForInternalUsage(....);
 Strings detached_parts;
 // 系统启动时,由于nvme9已经被删除,因此这里的partition_range是空的,因此根本不会执行到 循环内的 part->makeCloneInDetached
 for (const auto & part : partition_range)
 {
          // ① detach:在坏 part 原本所在的盘(disk9)上把它 clone 到 detached/broken_*
          //    disk9 已损坏 → create_directories 抛 filesystem_error(EIO),异常在此冒泡出去,②③④都不执行
          part->makeCloneInDetached("broken", getInMemoryMetadataPtr(), /*disk_transaction*/ {});

          LOG_WARNING(log, "Detached {} parts covered by broken part {}: {}", detached_parts.size(), part_name, fmt::join(detached_parts, ", "));
  }
  // ② 从 ZK 注销本 replica 对该 part 的所有权
  getRemovePartFromZooKeeperOps(part_name, ops, ...);
最关键的是,日志里再也没有出现filesystem error: in create_directories: Input/output error这样的错误。我们后面会说,在我们删掉磁盘并重启ClickHouse,StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)在执行的时候,代码路径不会走到part->makeCloneInDetached("broken", getInMemoryMetadataPtr(), /*disk_transaction*/ {});;
等待约2分钟后,验证恢复结果:
radp606-6.iad7.prod.viva.com :) SELECT * FROM system.parts
                                     WHERE name = '20260607_0_185_3'
                                     FORMAT Vertical;

Row 1:
──────
partition:                                   20260607
name:                                        20260607_0_185_3
active:                                      1
disk_name:                                   disk12
path:                                        /viva/data/nvme12/clickhouse/store/c02/c021051d-2918-4755-bfef-53a167fcda89/20260607_0_185_3/
modification_time:                           2026-07-03 07:58:25
rows:                                        5223999
验证结果:
active=1: part已激活disk_name=disk12: 在健康盘nvme12上rows=5223999: 包含完整数据modification_time=2026-07-03 07:58:25: 刚才07:58下载的
最终确认全库验证:
radp606-6.iad7.prod.viva.com :) SELECT count() FROM system.parts
                                     WHERE active AND disk_name = 'disk9';

   ┌─count()─┐
1. │       0 │
   └─────────┘
0个active part在disk9上,全部迁移完成。数据已经重新分布到11块健康盘上 (disk1-8, disk10-12)。
深入理解: ClickHouse磁盘故障处理机制
现在问题已经解决了,但我需要搞清楚ClickHouse的磁盘故障处理机制。
磁盘探针: DiskLocalCheckThread
ClickHouse的每一个Local Disk有一个专门的后台线程负责检测磁盘健康状态: DiskLocalCheckThread,我们把它叫做磁盘探针。
每隔一段时间 (默认5分钟),它会对自己所负责的disk执行读写测试:
// src/Disks/DiskLocalCheckThread.cpp
void DiskLocalCheckThread::run()
{
    while (!shutdown)
    {
        for (auto & [disk_name, disk_ptr] : disks)
        {
            if (disk_ptr->broken)
                continue;

            try
            {
                testDisk(disk_ptr);
                disk_ptr->readonly_count = 0;
                disk_ptr->error_count = 0;
            }
            catch (const Exception & e)
            {
                disk_ptr->error_count++;

                // 连续失败3次,标记为broken
                if (disk_ptr->error_count >= 3)
                {
                    if (!disk_ptr->broken)
                    {
                        LOG_ERROR(log, "Disk {} marked as broken", disk_ptr->getName());
                    }
                    disk_ptr->broken = true;  // ← 这里设置is_broken=1
                }
            }
        }

        std::this_thread::sleep_for(std::chrono::seconds(300));
    }
}
一旦disk_ptr->broken = true,后续调用getAvailableSpace()会返回0:
// src/Disks/DiskLocal.cpp
UInt64 DiskLocal::getAvailableSpace() const
{
    if (broken)
        return 0;  // broken盘返回0空间

    struct statvfs stat;
    if (statvfs(disk_path.c_str(), &stat) != 0)
        throwFromErrnoWithPath("Cannot statvfs", disk_path, ErrorCodes::CANNOT_STATVFS);

    return stat.f_bavail * stat.f_bsize;
}
这样,新的insert/merge/fetch就不会再选择这块盘来reserve空间。
Part恢复流程: removePartAndEnqueueFetch()的完整逻辑
前面在源码分析里已经看到,在ClickHouse的运行时, 如果disk被标记broken,查询或者merge过程中发现这个有问题的part,会通过 MergeTreeData::reportBrokenPart(...)把坏盘上的part逐个交给ReplicatedMergeTreePartCheckThread,最终都会通过removePartAndEnqueueFetch(...)方法来最终完成这个part的重建。
所以,StorageReplicatedMergeTree::removePartAndEnqueueFetch(...) 这个函数是恢复的核心,它按顺序做四件事:1) detach坏part、2) 清理queue、3) 从ZooKeeper注销并建GET_PART任务(但是它不负责领取和执行GET_PART任务)、4) 再把坏part从内存摘除。
可以看到,在DiskChecker发现坏盘以后,removePartAndEnqueueFetch(...)不会自己自动开始运行,还需要外界触发——
- 运行时,真正的触发是一次落到坏part上的读(用户Query或后台Merge):这次读经
reportBrokenPart(...)把坏part交给ReplicatedMergeTreePartCheckThread,再由这个检查线程调用removePartAndEnqueueFetch(...); - 而在启动或重启路径下,则是由
ReplicatedMergeTreeRestartingThread在收尾时经createLogEntriesToFetchBrokenParts()逐个调它(这条启动路径在后面「为什么重启能绕过卡点」一节会展开)。
所以后面无论在哪条堆栈里看到removePartAndEnqueueFetch(...),它肯定是通过
这两条路径之一被触发的。
我们看一下这个方法的具体过程:
// src/Storages/StorageReplicatedMergeTree.cpp
void StorageReplicatedMergeTree::removePartAndEnqueueFetch(const String & part_name, bool storage_init)
{
    auto zookeeper = getZooKeeper();
    auto broken_part_info = MergeTreePartInfo::fromPartName(part_name, format_version);

    // 第 1 步:detach —— 在 part 原本所在的盘上,把它 clone 到 detached/broken_*
    auto partition_range = getDataPartsVectorInPartitionForInternalUsage(
        {MergeTreeDataPartState::Active, MergeTreeDataPartState::Outdated},
        broken_part_info.getPartitionId());
    for (const auto & part : partition_range)
    {
        if (!broken_part_info.contains(part->info))
            continue;
        if (broken_part_info == part->info)
        {
            chassert(!storage_init);                    // 启动路径不应走到这里(下一节展开)
            part->was_removed_as_broken = true;
            part->makeCloneInDetached("broken", ...);   // 坏盘上 create_directories → EIO,就卡在这一步
        }
        else
            part->makeCloneInDetached("covered-by-broken", ...);
    }
    LOG_WARNING(log, "Detached {} parts covered by broken part {}: {}", ...);   // detach 成功才会打印

    // 第 2 步:清掉 queue 里被这个坏 part 覆盖的旧日志项
    queue.removePartProducingOpsInRange(zookeeper, broken_part_info, {});

    // 第 3 步:从 ZK 注销本 replica 对该 part 的所有权,并原子地建一条 GET_PART
    Coordination::Requests ops;
    if (zookeeper->exists(fs::path(replica_path) / "parts" / part_name))
        getRemovePartFromZooKeeperOps(part_name, ops, ...);
    // ... 往 ops 里追加创建 GET_PART 的请求(queue/queue-)...
    zookeeper->tryMulti(ops, responses, ...);
    LOG_DEBUG(log, "Created entry {} to fetch missing part {}", ..., part_name);

    // 第 4 步:把坏 part 从内存 active 集合中摘除(放在建 GET_PART 之后,避免副本发散)
    outdate_broken_part();
}
从上面的代码中我们看到:
- 第 1 步的
makeCloneInDetached("broken", ...)要在part原本所在的盘上创建detached/broken_*目录。disk9已经彻底损坏,create_directories直接抛filesystem_error, - 第 2、3、4 步于是全都不会执行——
Detached ... parts covered by broken part不会打印,Created entry ... to fetch missing part也不会打印。这正好对应前面日志里「只有Scanning、没有Created entry」的现象。
为什么重启能绕过卡点?
我们后来把disk9从配置删掉再重启,系统恢复正常,这说明 StorageReplicatedMergeTree::removePartAndEnqueueFetch(...) -> IMergeTreeDataPart::makeCloneInDetached(...) 的执行路径在ClickHouse Server重启的时候没有发生,即,恢复流程会走一条和运行时不同的路径。
我们看一下为什么。
ClickHouse Server启动时,会为每一张ReplicatedMergeTree表构造一个StorageReplicatedMergeTree对象。ReplicatedMergeTree构造函数并不只在启动时被调用,实际情况是,任何时候只要出现了一张新的表,都会构造: 无论是CREATE TABLE新建表、ATTACH TABLE手动挂载、还是服务启动时加载磁盘上已有的表,最终都汇聚到同一处构造点(registerStorageMergeTree.cpp里的storage工厂):
// src/Storages/MergeTree/registerStorageMergeTree.cpp
return std::make_shared<StorageReplicatedMergeTree>(
    args.mode,           // ← LoadingStrictnessLevel:三种场景在这里区分
    args.table_id,
    ...);
所以构造函数一定会被调用,三种场景唯一的区别是传进来的args.mode(LoadingStrictnessLevel);后面会看到,正是这个mode,决定了构造函数里是否创建attach线程。其中
-「启动加载已有表」和「ATTACH TABLE」中mode = ATTACH,启动加载相当于对每张已有表做一次隐式attach;
CREATE则是新建表,无需attach。
StorageReplicatedMergeTree构造的时候,会调用StorageReplicatedMergeTree::loadDataParts(...)把part从磁盘中加载进内存;因为disk9已经不在配置里,它和它上面的part都不会被看到。
StorageReplicatedMergeTree构造函数本身不检查缺失、也不建fetch。当StorageReplicatedMergeTree::loadDataParts(...)加载完所有part,后续会有独立的线程对这些part进行检查和加载:
// src/Storages/StorageReplicatedMergeTree.cpp (构造函数节选)
StorageReplicatedMergeTree::StorageReplicatedMergeTree(..., LoadingStrictnessLevel mode, ...)
{
    ...
    loadDataParts(skip_sanity_checks, expected_parts_on_this_replica);   // 加载 part;disk9 不在配置,其 part 不加载
    ...
    if (LoadingStrictnessLevel::ATTACH <= mode)     // ← 只有 ATTACH 及以上的加载模式才建 attach 线程
    {
        LOG_INFO(log, "Table will be in readonly mode until initialization is finished");
        attach_thread.emplace(*this);
        attach_thread->setSkipSanityChecks(skip_sanity_checks);
        return;                                     // 到此结束,没有检查缺失 part
    }
    ...   // mode < ATTACH(例如 CREATE 新建表)时不建 attach 线程,走另一套同步初始化
}
我们从 MergeTreeData::loadDataParts(...) 的实现可以看到, 它加载Part的数据源是本地磁盘,即,它遍历storage policy(也就是配置)里的每一块盘,扫描盘上的part目录,把目录名解析成part再加载进内存:
// src/Storages/MergeTree/MergeTreeData.cpp
void MergeTreeData::loadDataParts(bool skip_sanity_checks, ...)
{
    ...
    auto disks = getStoragePolicy()->getDisks();   // ← 只取 storage policy(配置)里的盘;disk9 已删,不在其中
    ...
    for (size_t i = 0; i < disks.size(); ++i)
    {
        const auto & disk_ptr = disks[i];
        if (disk_ptr->isBroken())                  // 被标记 broken 的盘也跳过
            continue;
        ...
        // 扫描这块盘上的目录(实际是丢进线程池并行扫),把 part 目录名解析成 part
        for (auto it = disk_ptr->iterateDirectory(relative_data_path); it->isValid(); it->next())
        {
            if (startsWith(it->name(), "tmp")
                || it->name() == MergeTreeData::FORMAT_VERSION_FILE_NAME
                || it->name() == DETACHED_DIR_NAME)
                continue;
            if (auto part_info = MergeTreePartInfo::tryParsePartName(it->name(), format_version))
                disk_parts.emplace_back(*part_info, it->name(), disk_ptr);   // 收集,稍后加载成内存里的 part 对象
        }
    }
    ...
}
所以ClickHouse启动的时候会加载哪些part完全由配置里的盘决定:getDisks()返回的是storage policy里的盘,disk9从storage.xml删掉后就不在其中,它上面的part目录一个都不会被iterateDirectory扫到,自然不会进内存。这一点是我们把disk9从storage.xml中移除以后重启就能绕过卡点的原因。
我们看一下 LoadingStrictnessLevel的具体含义,因为它涉及到StorageReplicatedMergeTree启动的时候(StorageReplicatedMergeTree::start())是否构建attach线程:
/// Strictness mode for loading a table or database
enum class LoadingStrictnessLevel : uint8_t
{
    /// Do all possible sanity checks
    CREATE = 0,
    /// Skip some sanity checks (for internal queries in DatabaseReplicated; for RESTORE)
    SECONDARY_CREATE = 1,
    /// Expect existing paths on FS and in ZK for ATTACH query
    ATTACH = 2,
    /// We ignore some error on server startup
    FORCE_ATTACH = 3,
    /// Skip all sanity checks (if force_restore_data flag exists)
    FORCE_RESTORE = 4,
};
LoadingStrictnessLevel是表加载的严格程度,取值从低到高是CREATE(0) < SECONDARY_CREATE(1) < ATTACH(2) < FORCE_ATTACH(3) < FORCE_RESTORE(4)。
上面讲过,不同的场景都会调用 StorageReplicatedMergeTree 的构造方法,不同的场景下会设置不同的LoadingStrictnessLevel mode值 :
- 服务重启时,ClickHouse会把已经存在的表逐个重新加载进来,正常走的是 attach 已有表 的语义,
mode为ATTACH(若带 force-restore 标志则更高),满足ATTACH <= mode。此时构造函数会建一个专门的ReplicatedMergeTreeAttachThread attach_thread并提前返回,然后由它去完成表的attach工作(它的职责后面细讲);手动执行ATTACH TABLE挂载一张已有表,也走这条路。 - 而我们在一个运行的ClickHouse中执行
CREATE TABLE新建一张表时,mode为CREATE(最低级),不满足ATTACH <= mode,于是不建attach线程:新建表本来就没有「已有数据要挂载」,也不必异步等ZK,直接同步初始化即可。 - 同时,我们看到,
LoadingStrictnessLevel还有最严格的FORCE_RESTORE模式(带着force_restore_data标志文件)启动。强制使用该模式需要管理员在本地磁盘或者Keeper强行创建flag文件:- 管理员可以选择在ClickHouse磁盘创建
<clickhouse-path>/flags/force_restore_data文件,强制ClickHouse服务以FORCE_RESTORE模式(带着force_restore_data标志文件)启动。注意,这是一个全局的、且很重的启动方式: 这个文件一开,本次启动每一张表都enableskip_sanity_check; - 同时,我们可以在Keeper上打开Replica层面的精细开关,来控制某一个Replica是否以
FORSE_RESTORE方式启动:/replicas/<replica>/flags/force_restore_data:if (current_zookeeper && current_zookeeper->exists(replica_path + "/flags/force_restore_data")) { skip_sanity_checks = true; // replica层面FORCE_RESTORE current_zookeeper->remove(replica_path + "/flags/force_restore_data"); .... } else if (LoadingStrictnessLevel::FORCE_RESTORE <= mode) { skip_sanity_checks = true; // 全局FORCE_RESTORE }
StorageReplicatedMergeTree::checkPartsImpl(...)将会看到,一旦enable了skip_sanity_check,ClickHouse启动的时候会绕过"本地多出太多 ZK上没有的 part的"这道防接错 shard 的保护。但是,我们磁盘坏掉的情况不是这种情况,而是恰恰相反: Zookeeper上存在但是本地没有(坏盘在启动以前被删掉)的情况。 - 管理员可以选择在ClickHouse磁盘创建
所以,我们这次是重启并加载已有表,走的是第一条,会建ReplicatedMergeTreeAttachThread attach_thread。
📎 补充:启动时「加载表 / 加载 part」是从磁盘还是 Keeper?
我们知道,ClickHouse服务有两层持久层,本地磁盘和ClickHouse Keeper(Zookeeper)。
但是,ClickHouse服务启动的时候的加载都来自磁盘,并且在磁盘上有两层加载:
- 加载表定义(schema / DDL):数据库对象遍历本地
metadata/<db>/*.sql文件(DatabaseOnDisk::iterateMetadataFiles),用createTableFromAST把每张表的CREATE语句建成StorageReplicatedMergeTree对象;- 加载表数据(part):构造该对象时,
loadDataParts(...)从getStoragePolicy()->getDisks()配置的盘上iterateDirectory扫 part 目录(就是上面那段代码)。Keeper 里存的是元信息(本 replica 应有哪些 part、schema 版本、复制队列等),它是「权威账本」,但不是启动时的数据源:启动先从本地磁盘把表和 part 构造出来,之后才由 attach 线程拿它和 Keeper 对账——
checkTableStructure校验 schema、checkParts对 part 做差集。一句话:磁盘负责「构造出表和 part」,Keeper 负责「告诉你本该有什么」;先构造、后对账。(即便是 schema 权威在 Keeper 的
DatabaseReplicated,磁盘本地也保有 metadata 文件副本,启动仍是先从本地文件构造、再与 Keeper 同步。)
StorageReplicatedMergeTree 构造完成以后,就开始启动这张表(启动完成以前,这张表是ReadOnly状态)。 我们看到,在StorageReplicatedMergeTree启动的时候,会查看attach_thread是否的确构建了:
// src/Storages/StorageReplicatedMergeTree.cpp
void StorageReplicatedMergeTree::startup()
{
    LOG_TRACE(log, "Starting up table");
    startOutdatedAndUnexpectedDataPartsLoadingTask();
    if (attach_thread)                 // ← 重启加载已有表:attach_thread 存在,走异步 attach 线程这条路
    {
        attach_thread->start();
        attach_thread->waitFirstTry();
        return; // attach_thread 在收尾 finalizeInitialization() 里自己调用 startupImpl(),再由 startupImpl 启动 restarting_thread
    }
    // 真正让这个Replica运转起来,调用 StorageReplicatedMergeTree::startupImpl()
    startupImpl(/* from_attach_thread */ false, ...);   // 没有 attach_thread(如新建表):直接同步初始化
}
-
如果有
attach_thread(即构造StorageReplicatedMergeTree的时候,LoadingStrictnessLevel的判断决定了需要 attach thread),就启动attach_thread并waitFirstTry()等它第一次尝试跑完再返回。attach_thread在后台调度池线程上先做「挂载 + 检查」,收尾时由它自己直接调用StorageReplicatedMergeTree::startupImpl();再由startupImpl()启动常驻的ReplicatedMergeTreeRestartingThread restarting_thread去激活并持续维护 replica。 -
如果没有
attach_thread(即构造StorageReplicatedMergeTree的时候,LoadingStrictnessLevel的判断决定了不需要attach thread),就直接调用StorageReplicatedMergeTree::startupImpl(),不需要Attach 的过程;由于我们这次是重启并加载已有的表,因此
ATTACH <= mode,所以attach_thread存在,StorageReplicatedMergeTree::startup()便把StorageReplicatedMergeTreeAttachThread::start()挂到后台调度池并启动运行;
我们看一下,ReplicatedMergeTreeAttachThread,StorageReplicatedMergeTree::startupImpl() 和 ReplicatedMergeTreeRestartingThread的职责和分工,他们贯穿了我们整个事故发生的主线:
ReplicatedMergeTreeAttachThread线程的职责是- 把这张表「挂载」到已有的本地数据和ZooKeeper上,
- 做启动前的初始化与各项检查:校验表结构、用
StorageReplicatedMergeTree::checkParts(...)找出缺失或多余的part、建必要的ZK节点、清理临时目录等。
我们看到源码注释也对ReplicatedMergeTreeAttachThread的职责进行了解释:
落到本文这次「删掉disk9后重启」:它就是跑// src/Storages/MergeTree/ReplicatedMergeTreeAttachThread.h // Attach table to the existing data. // Initialize the table by creating all the necessary nodes and do the required checks. // Initialization is repeated if an operation fails because of a ZK request or connection loss. class ReplicatedMergeTreeAttachThread { ... };StorageReplicatedMergeTree::checkPartsImpl(...)、拿「ZK应有的part」减「本地实有的part」做差集、把原本在disk9上、现在没被加载的那批part算成缺失,再通过ReplicatedMergeTreeQueue::setBrokenPartsToEnqueueFetchesOnLoading(...)把这批缺失part暂存进broken_parts_to_enqueue_fetches_on_loading的那个线程。它只负责「发现并记下缺哪些part」,并不负责去fetch。StorageReplicatedMergeTree::startupImpl()则是在attach_thread收尾时被调用,负责把这个 replica 对外服务所需的基础设施搭起来,然后启动ReplicatedMergeTreeRestartingThread负责激活Replica:- 注册
DataPartsExchange端点(别的 replica 才能从本机拉 part)、startBeingLeader()参与 leader 选举,然后启动ReplicatedMergeTreeRestartingThread(它常驻内存、后台定时调度),做完就返回; - 在本文中,
ReplicatedMergeTreeAttachThread算完并暂存缺失清单后,正是由StorageReplicatedMergeTree::startupImpl()把接力棒交给ReplicatedMergeTreeRestartingThread去真正建fetch(GET_PART)。
- 注册
ReplicatedMergeTreeRestartingThread是常驻的后台线程,它才是真正「激活」并持续维护 replica 的那一个:- 「激活」的实质是,向 ZK 写
/replicas/<me>/is_active(宣告本副本可用,别人才会把它当活跃副本、也才会从它拉 part)、加载复制队列并开始执行、拉公共 log 跟上别的副本做过的操作、拉起后台合并/清理/part检查等任务;之后一直守着 ZK 会话,过期就重连、重新激活。 - 在本文中,它就是在
ReplicatedMergeTreeRestartingThread::tryStartup()里调ReplicatedMergeTreeQueue::createLogEntriesToFetchBrokenParts()把Attach检测并收集上来的那批缺失part,逐个用StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)(storage_init=true)建成GET_PART,从而真正触发对part的fetch(fetch本身由另外的独立线程执行)。
- 「激活」的实质是,向 ZK 写
所以三者是一条直线,不是层层转发:
attach_thread在后台调度池线程上跑run(),run()分两步:先runImpl()做「挂载 + 检查」(checkParts()→checkPartsImpl()就在这一步),再finalizeInitialization()收尾——这里说的「收尾」,指的就是 attach 线程run()初始化流程的收尾阶段finalizeInitialization()直接调用StorageReplicatedMergeTree::startupImpl(from_attach_thread=true),中间不经过任何其它线程startupImpl()再启动常驻的restarting_thread,由它去激活并持续维护 replica
如果是新建表、没有 attach_thread,StorageReplicatedMergeTree::startup() 会绕过 attach 这条路,在 startup() 中直接同步调用 startupImpl(from_attach_thread=false)。
由于我们不是新建表,而是重启系统,因此我们这次的恢复,全程走 attach 线程这条路。
从StorageReplicatedMergeTree::startup()被调用,到ReplicatedMergeTreeAttachThread中真正调用StorageReplicatedMergeTree::checkPartsImpl(...)检查,调用堆栈如下所示:
StorageReplicatedMergeTree::startup()
  └─ attach_thread->start()                          // 丢进 BackgroundSchedulePool
       └─ ReplicatedMergeTreeAttachThread::run()
            └─ runImpl()
                 └─ storage.checkParts(skip_sanity_checks)
                      └─ checkPartsImpl(skip_sanity_checks)
ReplicatedMergeTreeAttachThread线程的run()里先跑runImpl()做检查,再跑finalizeInitialization()完成后续启动:
// src/Storages/MergeTree/ReplicatedMergeTreeAttachThread.cpp
void ReplicatedMergeTreeAttachThread::run()
{
    ...
    runImpl();                  // 检查(含 checkParts)
    finalizeInitialization();   // 收尾:startupImpl → 起 RestartingThread

}
ReplicatedMergeTreeAttachThread::runImpl()中会调用 StorageReplicatedMergeTree::checkParts(...) -> StorageReplicatedMergeTree::checkPartsImpl(...) 来对part进行检查:
void ReplicatedMergeTreeAttachThread::runImpl()
{
    ...
    storage.checkTableStructure(replica_path, metadata_snapshot, ...);
    // 这里会进一步调用 StorageReplicatedMergeTree::checkPartsImpl()
    storage.checkParts(skip_sanity_checks);   // ← 检查缺失 part 在这里;checkParts 内部再调 checkPartsImpl
    ...
}
StorageReplicatedMergeTree::checkParts(...)只是StorageReplicatedMergeTree::checkPartsImpl(...)的一层包装(第一次检查若因Outdated part还没加载完而返回false,会等加载完再检查一遍),真正的比对在checkPartsImpl(...)里。
bool StorageReplicatedMergeTree::checkPartsImpl(bool skip_sanity_checks)
{
    // ① ZK 登记的、本 replica「应当拥有」的 part
    Strings expected_parts_vec = zookeeper->getChildren(fs::path(replica_path) / "parts");
    NameSet expected_parts(expected_parts_vec.begin(), expected_parts_vec.end());

    // ② 本地真正加载到的 part(disk9 已不在配置,其 part 不在其中)
    auto parts = getDataParts({MergeTreeDataPartState::Active, MergeTreeDataPartState::Outdated}, ...);

    // ③ ZK 说该有、但本地没有任何 active part 覆盖它 → 缺失
    Strings parts_to_fetch;
    for (const String & missing_name : expected_parts)
        if (!getActiveContainingPart(missing_name))
            parts_to_fetch.push_back(missing_name);
    ...
checkPartsImpl(...)做的是一次集合相减。一个replica「应当拥有哪些part」的权威记录在ZooKeeper的/replicas/<replica>/parts里,不在本地盘上;从storage.xml删掉disk9只改了本地配置,没有动ZK。所以它拿ZK里的应有的parts(肯定包含之前nvme9上的part)减去本地加载到的实有的parts(由于启动的时候没有配置nvme9,实有parts不包含nvme9上的parts),差集就是要fetch的part。
我们看到,StorageReplicatedMergeTree::checkPartsImpl(...) 是调用getActiveContainingPart(missing_name)来判断part在disk和zookeeper上的存在关系的: :
- 第①步的
expected_parts来自ZooKeeper的/replicas/<replica>/parts,是这个replica「应当拥有」的part名清单。它是Keeper上的记录,不是盘上的东西。 - 第②步以及
getActiveContainingPart(...)要去查的对象,都是本地磁盘加载进内存的active part(就是前面loadDataParts()从配置盘上扫出来的那批)。 - 第③步对
expected_parts里的每个part名missing_name调getActiveContainingPart(missing_name):传进去的参数missing_name是Keeper上登记的part名,也就是「被覆盖者」;返回值是本地磁盘上覆盖了它的那个active part,也就是「覆盖者」。 - 所以,
getActiveContainingPart(missing_name)回答的问题是:本地磁盘上有没有一个active part,覆盖(或者刚好就是)Keeper记着的这个part名(missing_name)?
顺着这个问题,则有两种结果:
- 有覆盖者(返回非空):这个Keeper上登记的part的数据,其实已经在本地磁盘上了。典型情况是Keeper里还记着一个旧part名(比如
all_0_4_0),本地早已把它合并进了更大的all_0_10_1,后者覆盖前者,数据不缺,就不必fetch。若改用精确名匹配,反而会把它误判成「缺失」、白白去peer拉一遍。 - 没有覆盖者(返回
nullptr):本地磁盘既没有这个part、也没有任何part盖住它的范围,这才是真正缺失,进parts_to_fetch。 这正是我们把坏盘从ClickHouse的Storage中移除然后重启ClickHouse以后发生的过程: 那些原本在disk9上、现在没被加载的part(下称孤儿part),删盘让它们从「本地磁盘实有」里彻底消失,也没有别的part覆盖它们的范围,于是被差集挑出来标为缺失,根本不需要谁去扫坏盘。
我们看一下getActiveContainingPart(...)到底怎么判断覆盖的。这要从ClickHouse的part名的编码说起。
part名编码了partition_minBlock_maxBlock_level(可再带mutation版本),比如20260607_0_185_3就是分区20260607、block范围[0,185]、level3。这个Level就相当于我们在HDFS中经常降到的epoch,只不过是这个part本身的 epoch。
小part合并成大part时,大part的block范围会把小part整个包住,这种「大包小」的关系就叫覆盖(contains),判断的核心是比分区、block范围和level:
// src/Storages/MergeTree/MergeTreePartInfo.h
// this(大 part)是否覆盖 rhs(小 part)
bool contains(const MergeTreePartInfo & rhs) const
{
    return partition_id == rhs.getPartitionId()   // 必须同一分区(跨分区不合并)
        && min_block <= rhs.min_block             // 我的左端 ≤ 它的左端
        && max_block >= rhs.max_block             // 我的右端 ≥ 它的右端 → 范围把它整个包住
        && level >= rhs.level
        && mutation >= rhs.mutation
        && strictly_contains_block_range;         // 范围完全相等时还要求 level 更高,避免自己"覆盖"自己
}
getActiveContainingPart(missing_part)就是拿这个contains去 active part里找,看看磁盘上有没有part等于或者覆盖了Keeper上登记的missing_part。
因为part按(分区, min_block, max_block, level)排好序,能覆盖part_info的候选只可能是排序里紧挨着的前一个或后一个,所以它只看这两个:
// src/Storages/MergeTree/MergeTreeData.cpp
DataPartPtr MergeTreeData::getActiveContainingPart(const MergeTreePartInfo & part_info, DataPartState state, ...) const
{
    auto it = data_parts_by_state_and_info.lower_bound(DataPartStateAndInfo{state, part_info});
    if (it != range.end())
    {
        if ((*it)->info == part_info)         return *it;   // 正好就是这个 part
        if ((*it)->info.contains(part_info))  return *it;   // 后一个 part 覆盖了它
    }
    if (it != range.begin())
    {
        --it;
        if ((*it)->info.contains(part_info))  return *it;   // 前一个 part 覆盖了它
    }
    return nullptr;                                          // 没人覆盖它 → 本地确实缺这段数据
}
说到差集,就得把两个结果都交代清楚:
- 「ZK有、本地没有」(且没有被别的part覆盖)就是上面的
parts_to_fetch——缺失part,也正是我们这次的情况:删掉disk9后ZK的记录没动、本地少了一批part,它们被列进待fetch清单,走后面的GET_PART从peer拉回。 - 「本地有、ZK没有」则叫unexpected part(多余part)。ClickHouse不会因为本地有它、就反过来把它写回ZK当权威;它先给这些part分类(是否被某个正常part覆盖、能否从block号推断为可恢复),,然后选择下面的某个处理方式
-
拒绝启动:如果"多余且没被任何正常 part 覆盖"的行数占比 >
replicated_max_ratio_of_wrong_parts(默认0.5),直接抛异常、拒绝启动(这多半意味着这台机器接错了 shard,是一道防呆保护); -
收进 detached:没超阈值就放行,把这些多余 part
renameToDetached("ignored", ...)挪到detached/ignored_*,
留在盘上但不参与服务,也不写回 ZKbool StorageReplicatedMergeTree::checkPartsImpl(bool skip_sanity_checks) { ...... // (a) 保护:若"多余且没被任何正常 part 覆盖"的行数占比过高,拒绝启动 bool insane = uncovered_unexpected_parts_rows > total_rows_on_filesystem * (*storage_settings_ptr)[MergeTreeSetting::replicated_max_ratio_of_wrong_parts]; // 默认 0.5 if (insane && !skip_sanity_checks) throw Exception(ErrorCodes::TOO_MANY_UNEXPECTED_DATA_PARTS, ...); ... // (b) 否则:把多余 part detach 到 detached/ignored_*(留在盘上但不参与服务,也不写回 ZK) for (auto & part_state : unexpected_data_parts) part_state.part->renameToDetached("ignored", /* ignore_error= */ true);
-
StorageReplicatedMergeTree::checkPartsImpl(...)并不自己建fetch,它最后调用setBrokenPartsToEnqueueFetchesOnLoading(...)只是把缺失清单暂存进队列对象,作为fetch线程进行fetch的依据。
这一「暂存 → 取用」的交接,靠的是ReplicatedMergeTreeQueue(每张表一个 ReplicatedMergeTreeQueue 对象)里的一个成员broken_parts_to_enqueue_fetches_on_loading。
StorageReplicatedMergeTreeAttachThread线程和StorageReplicatedMergeTreeRestartingThread线程持有的是同一个ReplicatedMergeTree storage,从而共享这个storage.queue,交接就发生在这个成员上:
// src/Storages/MergeTree/ReplicatedMergeTreeQueue.h
Strings broken_parts_to_enqueue_fetches_on_loading;   // attach 线程存、restarting 线程取;state_mutex 保护
StorageReplicatedMergeTreeAttachThread线程在checkPartsImpl(...)算完缺失清单后,通过ReplicatedMergeTreeQueue::setBrokenPartsToEnqueueFetchesOnLoading(...)把缺失的part清单一次性「投递」进broken_parts_to_enqueue_fetches_on_loading中:
// src/Storages/MergeTree/ReplicatedMergeTreeQueue.cpp
void ReplicatedMergeTreeQueue::setBrokenPartsToEnqueueFetchesOnLoading(Strings && parts_to_fetch)
{
    std::lock_guard lock(state_mutex);
    assert(broken_parts_to_enqueue_fetches_on_loading.empty());   // 只在队列初始化前投递一次
    assert(virtual_parts.size() == 0);
    broken_parts_to_enqueue_fetches_on_loading = std::move(parts_to_fetch);
}
StorageReplicatedMergeTreeRestartingThread线程则稍后会通过ReplicatedMergeTreeQueue::createLogEntriesToFetchBrokenParts()把这个成员读出来、逐个建GET_PART、最后清零(具体代码见下文)。
下面把「谁在什么时候投递、谁在什么时候取用」的控制流串起来看。真正建fetch的动作,是沿着attach线程收尾时启动的 ReplicatedMergeTreeRestartingThread 走下去的,调用关系是:
ReplicatedMergeTreeAttachThread::runImpl()
  ├─ storage.checkParts(...)             // 上一步:算出并暂存缺失清单
  └─ finalizeInitialization()
       └─ storage.startupImpl(from_attach_thread = true)
            └─ restarting_thread 启动
                 └─ ReplicatedMergeTreeRestartingThread::tryStartup()
                      └─ queue.createLogEntriesToFetchBrokenParts()   // 排空清单,建 GET_PART
我们看一下StorageReplicatedMergeTreeAttachThread::run()的运行过程:StorageReplicatedMergeTreeAttachThread::runImpl()检查完,紧接着在StorageReplicatedMergeTreeAttachThread::finalizeInitialization(),中转身去调StorageReplicatedMergeTree::startupImpl():
// src/Storages/MergeTree/ReplicatedMergeTreeAttachThread.cpp
void ReplicatedMergeTreeAttachThread::finalizeInitialization()
{
    storage.startupImpl(/* from_attach_thread */ true, ...);
    storage.initialization_done = true;
}
StorageReplicatedMergeTree::startupImpl() 的参数from_attach_thread 决定这个常驻的ReplicatedMergeTreeRestartingThread的激活方式是怎样的:
- 如果
from_attach_thread=true,即StorageReplicatedMergeTree::startupImpl()的调用来自AttachThread,那么,就在当前的线程里直接同步运行一次RestartingThread的主任务,随后restarting_thread.start(false)(即task->activate())只是把任务登记为常驻,让run()末尾自排的下一轮能被调度。所以首次激活是当前线程同步做的,之后的周期性维护转由后台调度池异步跑。 - 如果
from_attach_thread=false,说明不是来自Attach Thread,而是在StorageReplicatedMergeTree::startup()中直接调用StorageReplicatedMergeTree::startupImpl(),这时候,其实是把RestartingThread的主任务提交给后台线程池进行周期性调度;
// src/Storages/StorageReplicatedMergeTree.cpp
void StorageReplicatedMergeTree::startupImpl(bool from_attach_thread, ...)
{
    ...
    if (from_attach_thread)   // attach 线程收尾时进来:首次激活在当前 attach 线程里同步跑
    {
        restarting_thread.run();         // 同步跑一次 run()->runImpl()->tryStartup()(激活 replica、建 GET_PART 等)
        restarting_thread.start(false);  // 只 activate 转成常驻任务;run() 已自排下一轮,这里不再立即调度
    }
    else                      // 新建表等:首次激活丢给后台调度池异步跑
    {
        restarting_thread.start(true);   // activateAndSchedule:调度到后台池执行首轮,再等 startup_event
        ...
    }
    ...
}
这里,我们只需要知道:
ReplicatedMergeTreeRestartingThread::run()就是这个RestartingThread的任务代码,因此,restarting_thread.run()是直接同步执行一次任务ReplicatedMergeTreeRestartingThread::start(bool schedule)则是任务的异步启动方式,但是即使是异步启动,内部的任务代码依然是ReplicatedMergeTreeRestartingThread::run()
我们这次的重启恢复,走的是首次同步激活的路径,ReplicatedMergeTreeRestartingThread::run()最终会调用ReplicatedMergeTreeRestartingThread::tryStartup(),从而加载ReplicatedMergeTreeQueue broken_parts_to_enqueue_fetches_on_loading,再调ReplicatedMergeTreeQueue::createLogEntriesToFetchBrokenParts()把缺失清单逐个建GET_PART直到排空:
// src/Storages/MergeTree/ReplicatedMergeTreeRestartingThread.cpp
bool ReplicatedMergeTreeRestartingThread::tryStartup()
{
    ...
    storage.queue.initialize(zookeeper);
    storage.queue.load(zookeeper);
    storage.queue.createLogEntriesToFetchBrokenParts();   // ← 排空 checkPartsImpl 暂存的那批缺失 part
    storage.queue.pullLogsToQueue(zookeeper, {}, ReplicatedMergeTreeQueue::LOAD);
    ...
}
ReplicatedMergeTreeQueue::createLogEntriesToFetchBrokenParts()对每个缺失part调用的,仍然是运行时那条路用的StorageReplicatedMergeTree::removePartAndEnqueueFetch(...),但是,ReplicatedMergeTreeQueue::createLogEntriesToFetchBrokenParts()->StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)时,会设置storage_init=true,标记这是系统启动时候的调用:
// src/Storages/MergeTree/ReplicatedMergeTreeQueue.cpp
void ReplicatedMergeTreeQueue::createLogEntriesToFetchBrokenParts()
{
    Strings broken_parts = broken_parts_to_enqueue_fetches_on_loading;   // checkPartsImpl 暂存的那批
    for (const auto & broken_part_name : broken_parts)
        storage.removePartAndEnqueueFetch(broken_part_name, /* storage_init = */ true); // 这里的storage_init 为true
    ...
}
所以,参考上面运行时的故障调用堆栈,启动路径这里同样调用了StorageReplicatedMergeTree::removePartAndEnqueueFetch(...),只是在启动路径下,第二个参数storage_init传的是true。
但是,我们下面会看到,造成「运行时卡死、重启却成功」这个差别的,并不是storage_init这个参数。真正的决定因素是,在启动路径下,坏part此刻在不在内存里。
// src/Storages/StorageReplicatedMergeTree.cpp
void StorageReplicatedMergeTree::removePartAndEnqueueFetch(const String & part_name, bool storage_init)
{
    auto broken_part_info = MergeTreePartInfo::fromPartName(part_name, format_version);

    // 第 1 步 detach:注意它只遍历"当前加载在内存里"的 Active/Outdated part
    auto partition_range = getDataPartsVectorInPartitionForInternalUsage(
        {MergeTreeDataPartState::Active, MergeTreeDataPartState::Outdated},
        broken_part_info.getPartitionId());
    for (const auto & part : partition_range)
    {
        if (!broken_part_info.contains(part->info))
            continue;
        if (broken_part_info == part->info)            // 命中坏 part 本身
        {
            chassert(!storage_init);                   // 只是断言,不是"要不要 detach"的开关
            part->makeCloneInDetached("broken", ...);  // 在原盘 detach → 坏盘上 create_directories 抛 EIO,就卡这
        }
        else
            part->makeCloneInDetached("covered-by-broken", ...);
    }
    // ... 第 2~4 步(清 queue、从 ZK 注销、建 GET_PART、outdate)与上一节完整版一致,此处略 ...
}
StorageReplicatedMergeTree::getDataPartsVectorInPartitionForInternalUsage(...)返回的是当前加载在内存里、状态为Active或Outdated、且属于坏part那个partition的part对象,它查的是表在内存里维护的part索引,这个索引是启动时StorageReplicatedMergeTree::loadDataParts(...)扫盘之后建起来的一份快照。读取内存快照的目的,是获取这个Broken Part对应的Partition Range。
所以,我们是否会走到part->makeCloneInDetached(...),就看坏part在不在这个partition_range里:
- 运行时:坏part还以Active挂在内存里,它在
partition_range里,循环命中broken_part_info == part->info,执行makeCloneInDetached("broken"),在disk9上建目录时EIO; - 重启(disk9已从
storage.xml删掉):loadDataParts只扫配置里的盘,坏part压根没被加载,不在partition_range里,循环遍历时遇不到它,detach分支进不去,也就不碰坏盘、没有EIO,代码直接往下建GET_PART。
所以当我们重启了ClickHouse,真正的因果链就变成:坏盘在不在配置里 → 决定坏part在不在内存(partition_range) → 决定是否会调用part->makeCloneInDetached(...)。
至此,缺失part被写成GET_PART进入本replica的队列,队列处理线程再执行GET_PART,通过DataPartsExchange从健康的Peer Relica下载、落到本Replica的健康盘。整个过程是两个线程的接力:
ReplicatedMergeTreeAttachThread线程发现并暂存缺失清单,ReplicatedMergeTreeRestartingThread线程排空清单、建GET_PART;
两步在普通重启时都会执行,不依赖任何强制恢复标志。
两条路径的差异可以并排对照:
| 场景 | 内存里有disk9的part吗 | 会不会走到detach | 结果 |
|---|---|---|---|
运行时PartCheckThread(storage_init=false) | 有(Active) | 会(在disk9上建detached目录) | detach抛EIO,GET_PART建不出来 |
重启后加载(storage_init=true,disk9已删) | 没有(未加载) | 不会(不在partition_range) | 直接建GET_PART,从peer fetch |
下图显示了上文所讲解的整个 StorageReplicatedMergeTree 的加载过程,包含了 StorageReplicatedMergeTree 的构造,启动,Attach Thread,Restarting Thread,以及,最重要的,本地磁盘的Part与Keeper上的Part元信息的对账过程:
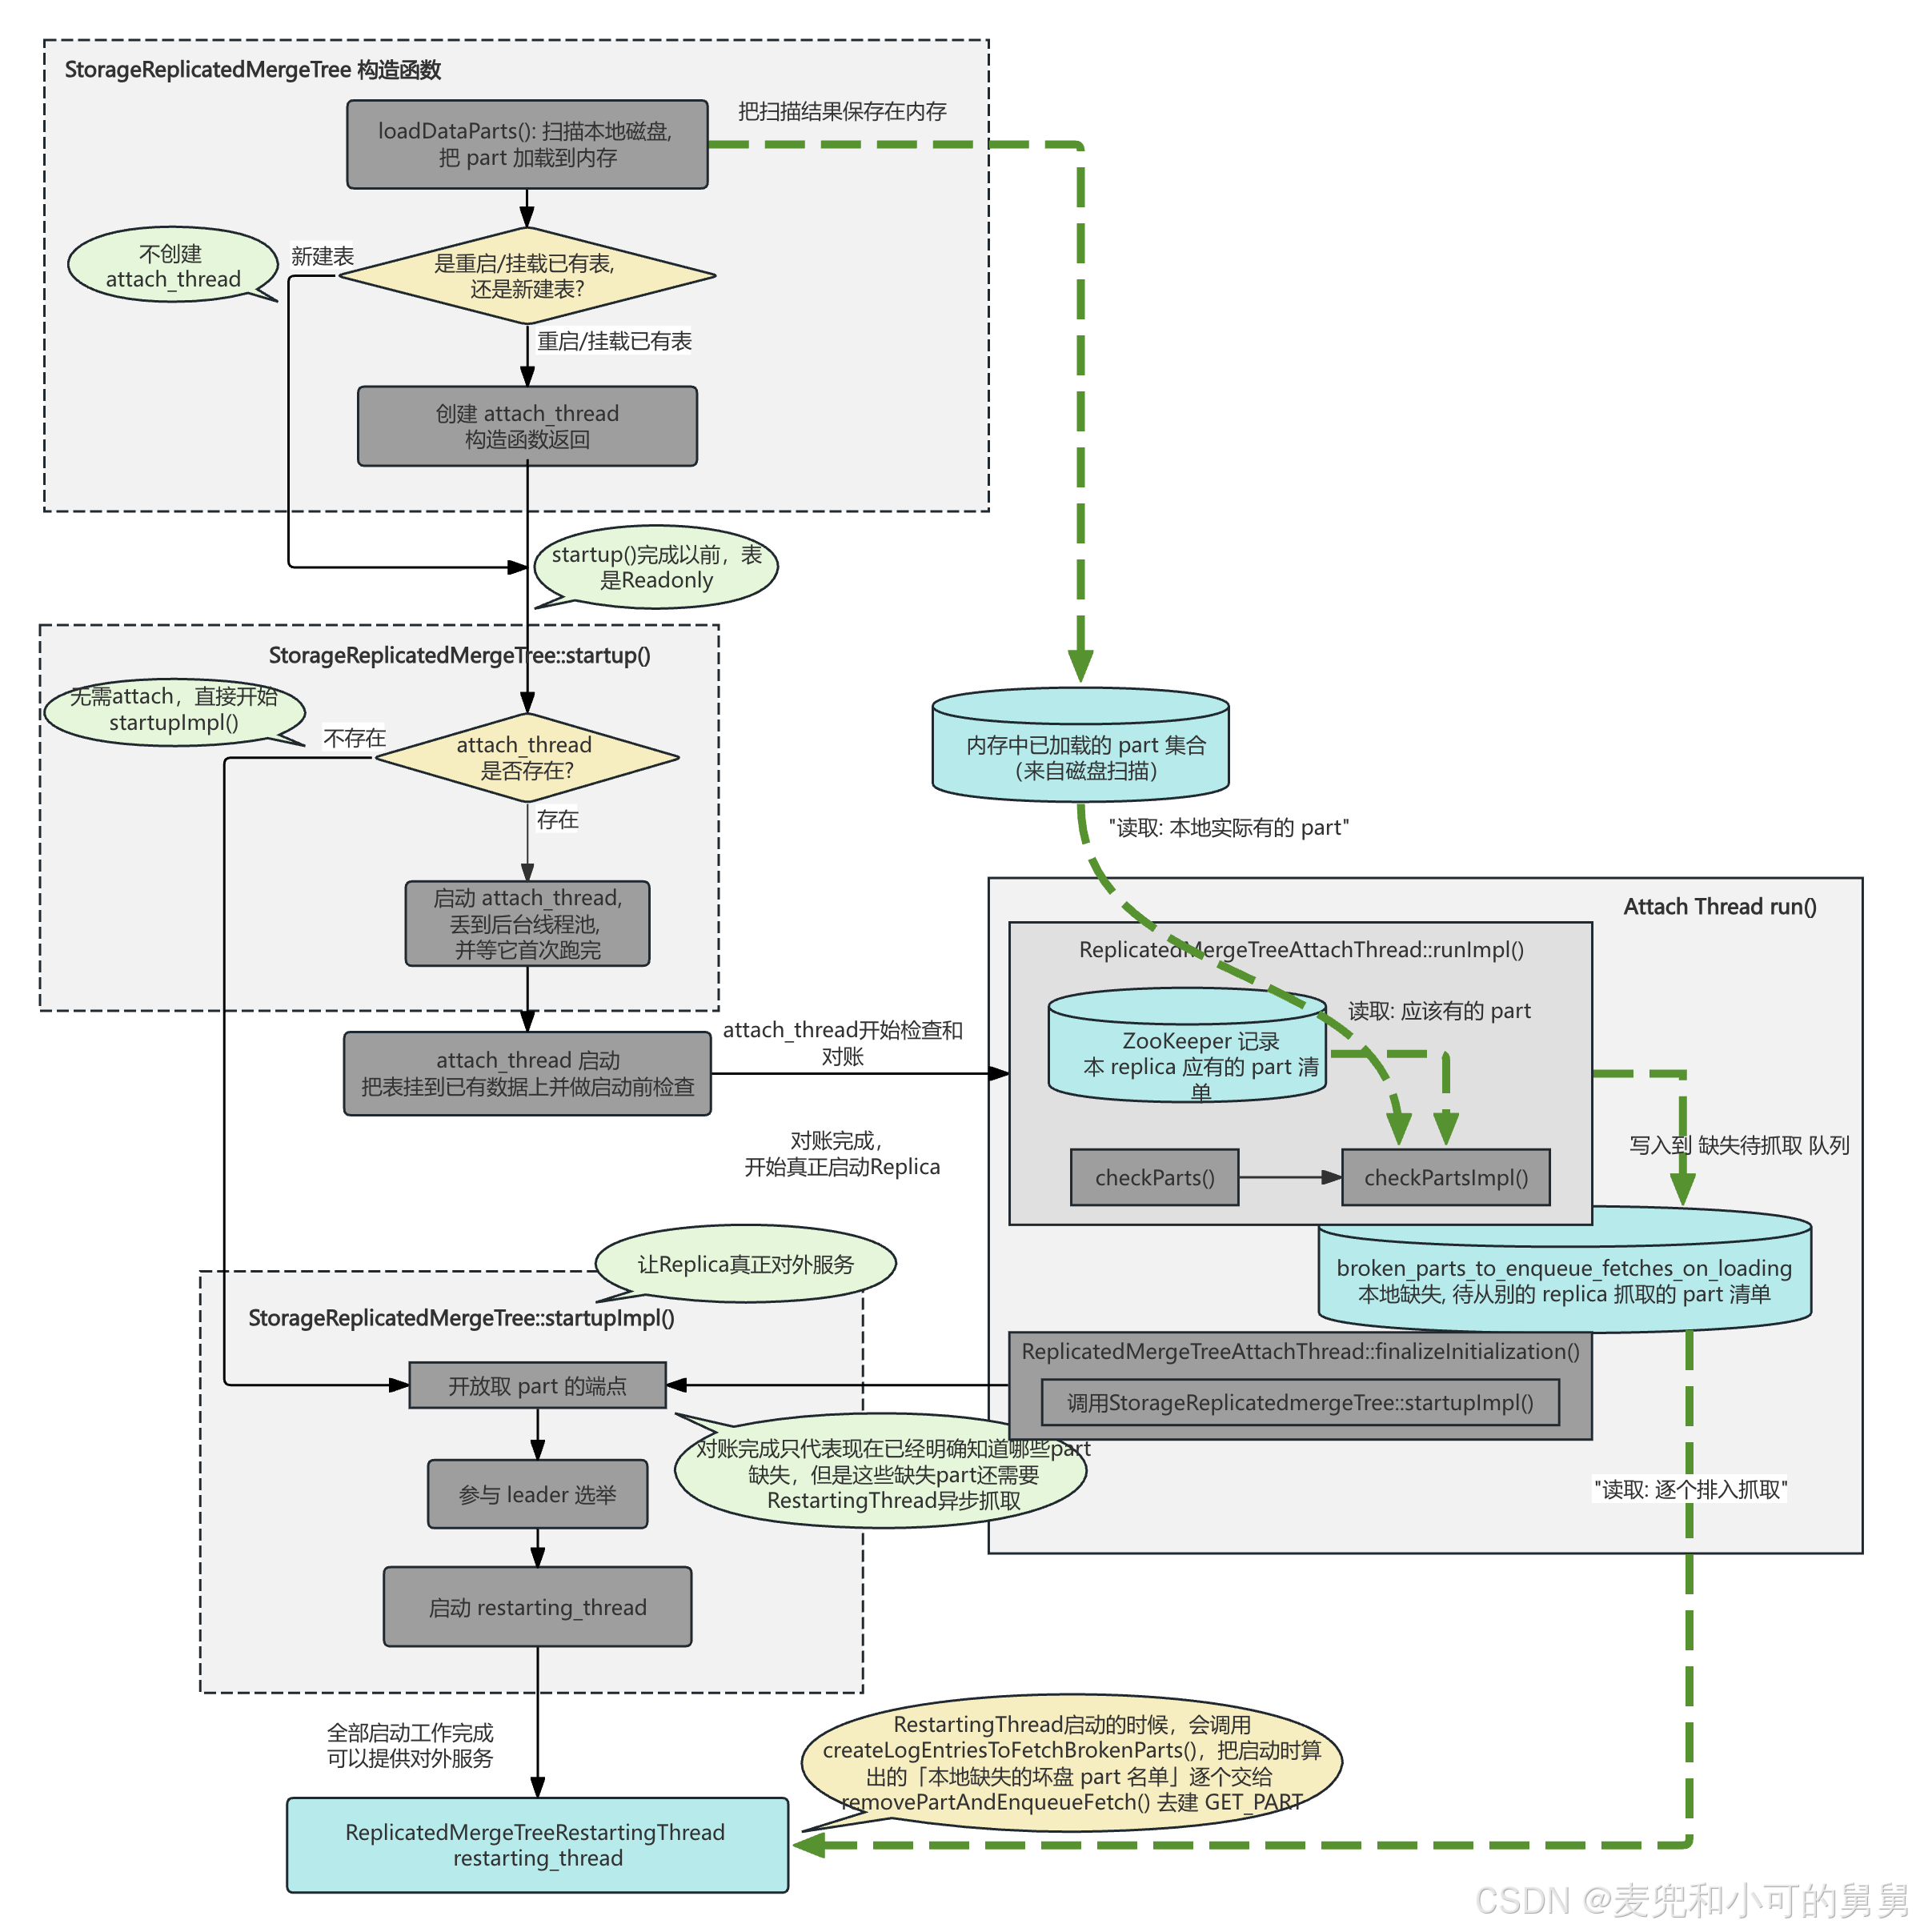
为什么不能detach到其他健康盘?
讲解到这里,我们的问题是,ClickHouse为什么愚蠢到在把part移动到detach 目录的时候,直接使用broken part所在的磁盘?或者,只管来讲,任何时候,发现broken part,ClickHouse能否skip detach,而直接开始fetch呢?毕竟,恢复数据比什么都重要。
技术上,这是可以实现的。但ClickHouse没有这样设计,可能的原因包括:
-
性能考虑:
在同一块盘上做detach,只需要hardlink文件 (几乎瞬间完成):# 同盘hardlink,几乎不消耗时间 ln /disk9/part/data.bin /disk9/detached/broken_part/data.bin如果要detach到另一块盘,需要真正复制数据:
# 跨盘复制,取决于文件大小,可能很慢
cp /disk9/part/data.bin /disk1/detached/broken_part/data.bin
对于TB级的part,这会非常耗时。
-
状态一致性:
detached目录通常和active part在同一块盘上,方便管理:- 查找: 一眼就能看到该盘上有哪些detached part
- 清理: 删除整块盘时,detached也一起清理
- 恢复: 如果需要attach回来,在同一块盘上更快
-
边界场景少:
磁盘部分损坏 (部分文件可读) 的场景更常见,此时detach到同盘仍然可行。磁盘完全损坏 (连目录都创建不了) 的场景相对罕见,且通常表示硬件彻底故障,需要整盘更换。
ClickHouse可能认为: 对于完全损坏的场景,重启恢复是可接受的解决方案,不值得为此增加复杂的"跨盘detach"逻辑。 -
设计简单性:
同盘detach的逻辑清晰、实现简单、易于维护。跨盘detach需要解决诸多问题,会显著增加代码复杂度。
受控复现:在测试集群上验证两条恢复路径
所以,既然在运行时,我们无法在不重启ClickHouse的情况下,让ClickHouse自动放弃坏盘,从Peer Replica上拉取健康的Parts,那么,我们的问题是,我们不修改storage.xml,只重启,ClickHouse能否自动忽略坏盘,同样完成这个坏盘上Part的Re-Fetch,以及,有一天,这个坏盘经过修复,ClickHouse还能否正确识别并重新使用这个坏盘呢?
为了把这两个结论坐实,我在一套两节点测试集群上做了两个受控实验,用可控的方式模拟坏盘,直接观察日志。
测试环境是radp603-21a和radp606-21d两台机器,ClickHouse 25.8.28.1,一张events表(ReplicatedMergeTree,storage policy为nvme,是一个跨disk_nvme1到disk_nvme4四块盘的JBOD卷,TTL 7天),另有一个后台程序持续写入(每秒99到199行不等)。
radp606-21d.iad7.prod.viva.com :) SHOW CREATE TABLE default.events;

SHOW CREATE TABLE default.events


Connecting to localhost:9000 as user default.
Connected to ClickHouse server version 25.8.28.

CREATE TABLE default.events
(
    `event_time` DateTime,
    `user_id` UInt64,
    `session_id` UInt64,
    `metric` Float64,
    `country` LowCardinality(String),
    `payload` String,
    `event_date` Date MATERIALIZED toDate(event_time)
)
ENGINE = ReplicatedMergeTree('/clickhouse/tables/{shard}/events', '{replica}')
PARTITION BY toStartOfHour(event_time)
ORDER BY (user_id, event_time)
TTL event_time + toIntervalDay(7)
SETTINGS storage_policy = 'nvme', index_granularity = 8192
对应的storage_policy nvme的配置如下所示:
<clickhouse>
    <storage_configuration>
        <disks>
            <disk_nvme1>
                <path>/viva/data/nvme1/clickhouse/store_jbod/</path>
            </disk_nvme1>
            <disk_nvme2>
                <path>/viva/data/nvme2/clickhouse/store_jbod/</path>
            </disk_nvme2>
            <disk_nvme3>
                <path>/viva/data/nvme3/clickhouse/store_jbod/</path>
            </disk_nvme3>
            <disk_nvme4>
                <path>/viva/data/nvme4/clickhouse/store_jbod/</path>
            </disk_nvme4>
        </disks>
        <policies>
            <nvme>
                <volumes>
                    <main>
                        <disk>disk_nvme1</disk>
                        <disk>disk_nvme2</disk>
                        <disk>disk_nvme3</disk>
                        <disk>disk_nvme4</disk>
                    </main>
                </volumes>
            </nvme>
        </policies>
    </storage_configuration>
</clickhouse>
我们可以选择简单地将对应盘的ClickHouse的数据目录的读写权限清空,从而让ClickHouse无法对该盘进行读写,比如:
chmod 000 /conviv
  a/data/nvme2/clickhouse/store_jbod
在我们的Test Case中,我选择用device-mapper的error目标,把disk_nvme2对应的块设备整块映射成「任何读写都返回错误」,以此模拟坏盘;注入故障期间写入不停,和线上「边写边坏」的场景一致。
有一点我们需要再次说明:Broken Part的检查不是磁盘探针DiskChecker触发的,而是外部读撞到坏part时通过reportBrokenPart(...)触发的(前文已分析)。所以,在我们制造了磁盘的不可读写并且磁盘已经被磁盘探针(DiskChecker)检测为Broken(system.disks能看到is_broken=true),但是如果我没有对应的查询或者对应的Merge触发到对应Broken Disk上的Broken part,那么就不会触发reportBrokenPart(...)的链条。刚开始我没有成功复现问题。后来,我每次注入磁盘故障后,我都手动跑一个读取列数据的SELECT去撞坏part,把检查流程启动起来,问题可以稳定复现。
我用error目标注入故障后,ext4在这个「死设备」上很快掉了挂载,于是测试里看到的报错是errno: 2(No such file / PATH_ACCESS_DENIED),而不是线上物理坏盘的errno: 5(EIO)。errno表层不同,但触发的是同一条代码路径,堆栈的frame也几乎一样,并不影响结论。
测试一:不重启,磁盘恢复后系统自愈
第一个问题是:如果坏盘只是短暂故障、数据还在,那么把盘恢复、但不重启ClickHouse,卡住的part能不能自己好起来?
测试结果证明能自愈:
- 如果磁盘上的数据并没有丢失(我们的测试场景), ClickHouse可以重新识别对应Part,系统完全恢复正常。
- 如果磁盘上的数据全部丢失,ClickHouse也会重新fetch对应的part,数据也会得到恢复(没有测试)。
先制造坏盘。disk_nvme2挂载在/viva/data/nvme2,底层是名为nvme3n1-crypt的device-mapper设备。我先把它当前的映射表连同密钥存下来(恢复时要用),再用dmsetup把整块设备换成error目标,让它的任何读写都返回错误,最后清一次page cache,逼后续访问真正落到这个「死设备」上:
root@radp606-21d:~# dmsetup table --showkeys nvme3n1-crypt > /root/nvme3n1-crypt.table
root@radp606-21d:~# SECT=$(blockdev --getsz /dev/mapper/nvme3n1-crypt)
root@radp606-21d:~# dmsetup suspend nvme3n1-crypt
root@radp606-21d:~# dmsetup reload nvme3n1-crypt --table "0 $SECT error"
root@radp606-21d:~# dmsetup resume nvme3n1-crypt
root@radp606-21d:~# echo 3 > /proc/sys/vm/drop_caches
几秒后,磁盘探针发现这块盘读写都失败,把它标为broken:
radp606-21d.iad7.prod.viva.com :) SELECT name, is_broken FROM system.disks WHERE name='disk_nvme2';

    ┌─name───────┬─is_broken─┐
    │ disk_nvme2 │         1 │
    └────────────┴───────────┘
但前面说过,磁盘被标broken只是把它挡在写入之外,并不会主动去处理它上面已有的part——真正启动检查链的,是一次落到坏part上的读。我的后台程序只写不读,所以我手动跑一个读取payload列的查询去撞它:
radp606-21d.iad7.prod.viva.com :) SELECT sum(cityHash64(payload)) FROM default.events;
这个查询会读到坏盘上的part文件、立刻抛错中断。而它这一读,触发了reportBrokenPart(...),检查线程随即开始处理。我盯住其中一个具体的part 1784199600_3449_3453_1,看它的完整经历:
2026.07.20 08:09:24.908630 ...ReplicatedMergeTreePartCheckThread): Checking part 1784199600_3449_3453_1
2026.07.20 08:09:24.908868 ...: Part 1784199600_3449_3453_1 in zookeeper: true, locally: true
2026.07.20 08:09:24.909153 ...checkPartImpl(...): Code: 107. DB::ErrnoException: Cannot open file /viva/data/nvme2/clickhouse/store_jbod/store/b5e/b5ef67f5-.../1784199600_3449_3453_1/columns.txt: , errno: 2, strerror: No such file or directory. (FILE_DOESNT_EXIST)
2026.07.20 08:09:24.909171 ...: Part 1784199600_3449_3453_1 looks broken. Removing it and will try to fetch.
2026.07.20 08:09:24.909175 ...: Part 1784199600_3449_3453_1 exists in ZooKeeper and the local part was broken. Detaching it, removing from ZooKeeper and queueing a fetch.
这几行说明:检查线程读这个part的columns.txt失败(盘已坏),于是判定它坏了,
进入「detach后重新fetch」的流程。注意locally: true: 这个part此刻还以已加载的状态挂在内存里,所以走的是运行时那条要先在坏盘上detach的路径。
这时我执行恢复动作,把disk_nvme2的映射还原成正常的加密盘,并重新挂载,全程不重启ClickHouse:
root@radp606-21d:~# dmsetup suspend --noflush --nolockfs nvme3n1-crypt
root@radp606-21d:~# dmsetup reload nvme3n1-crypt /root/nvme3n1-crypt.table
root@radp606-21d:~# dmsetup resume nvme3n1-crypt
root@radp606-21d:~# mount /viva/data/nvme2
盘恢复后,检查线程下一轮又轮到了同一个part:
2026.07.20 08:10:00.474372 ...: Checking part 1784199600_3449_3453_1
2026.07.20 08:10:00.474471 ...: Part 1784199600_3449_3453_1 in zookeeper: true, locally: true
2026.07.20 08:10:00.476009 ...: Part 1784199600_3449_3453_1 looks good.
这次ReplicatedMergeTreePartCheckThread::checkPartImpl()重新读这个part的数据,校验通过,直接返回looks good,对应源码里这一段:
// src/Storages/MergeTree/ReplicatedMergeTreePartCheckThread.cpp
ReplicatedCheckResult ReplicatedMergeTreePartCheckThread::checkPartImpl(const String & part_name, bool throw_on_broken_projection)
{
    auto [exists_in_zookeeper, part] = findLocalPart(part_name);   // 查 ZK 是否登记 + 取内存里的本地 part
    ...
    if (exists_in_zookeeper)
    {
        LOG_INFO(log, "Checking data of part {}.", part_name);
        ...
        checkDataPart(part, /* require_checksums */ true, ...);    // 真正读盘校验数据
        ...
        LOG_INFO(log, "Part {} looks good.", part_name);           // 盘恢复、数据完好 → 走到这里
        result.action = ReplicatedCheckResult::DoNothing;         // 什么都不做,卡点解除
        return result;
    }
    ...
}
盘恢复后,磁盘探针下一轮探测通过,disk_nvme2的broken标记也被自动清掉:
radp606-21d.iad7.prod.viva.com :) SELECT name, is_broken FROM system.disks WHERE name='disk_nvme2';

    ┌─name───────┬─is_broken─┐
    │ disk_nvme2 │         0 │
    └────────────┴───────────┘
再往后,这个part出现在正常的后台merge评估里,说明它已经彻底回到正常运作。有两点可以佐证这是「原地自愈」而不是re-fetch:
- 从头到尾都是
locally: true,这个part没有被移走; system.replication_queue里始终没有出现针对它的GET_PART。
也就是说,数据完好时,盘一恢复,系统靠原地重新校验就自愈了,全程没有产生任何跨副本的re-fetch。
测试二:磁盘仍损坏,只重启、不改storage.xml
前面生产事故的恢复办法是「先从storage.xml删掉坏盘,再重启」。这里我想验证一个更省事的做法:坏盘继续坏着,不修改配置,只重启ClickHouse,能不能恢复?
答案是能: 坏盘上的Broken Part可以在重启的时候被成功地从Peer Replica上Re-Fetch到本地的其他磁盘。这说明,在ClickHouse重启的时候,无论我们选择把磁盘删掉,还是选择让坏盘待在哪里,ClickHouse启动的时候都不会扫描到该Broken Parts盘上的Parts,因此,StorageReplicatedMergeTree::removePartAndEnqueueFetch(...) 会被调用,但是不会存在detach broken part的过程。
是否把Broken Disk从storage.xml中删除,我们在重启ClickHouse的时候都不会再扫描到Broken Disk上的Broken Parts的原因不同:
- 如果启动前删除了Broken Disk,无法扫描到Broken parts的原因是,这个盘已被删除,因此根本不会被扫描该盘;
- 如果启动前没有删除Broken Disk,但是ClickHouse启动以前实际上会检测磁盘的可用性,如果发现磁盘已经损坏,也会explicitly不扫描该盘;
无论是哪种情况,ClickHouse启动的时候都不扫描这个Broken Disk上的Broken Parts,因此StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)中不会尝试detach,也就不会再出错。
这次我把盘重新弄坏(映射表上一步已存过,不必再存):
root@radp606-21d:~# SECT=$(blockdev --getsz /dev/mapper/nvme3n1-crypt)
root@radp606-21d:~# dmsetup suspend nvme3n1-crypt
root@radp606-21d:~# dmsetup reload nvme3n1-crypt --table "0 $SECT error"
root@radp606-21d:~# dmsetup resume nvme3n1-crypt
root@radp606-21d:~# echo 3 > /proc/sys/vm/drop_caches
检查日志,确认detach异常重现以后,我的操作是,不碰storage.xml、不删盘,直接重启:
root@radp606-21d:~# systemctl restart clickhouse-server
重启瞬间,日志可以反馈处整个启动到Re-Fetch的基本流程。
第一段,磁盘在启动时的确被标为broken:
2026.07.20 08:23:58.312164 <Error> DiskLocal: Disk disk_nvme2 is marked as broken during startup: Code: 481. DB::ErrnoException: Cannot check read access to file: /viva/data/nvme2/clickhouse/store_jbod/: , errno: 2, strerror: No such file or directory. (PATH_ACCESS_DENIED)
这一步是同步发生的,不是那个周期性的探测线程DiskChecker做的。
磁盘初始化时会调用DiskLocal::startupImpl(),它先同步跑一次setup(),setup()里对坏盘的读访问检查直接抛异常,于是当场把broken置为true:
// src/Disks/DiskLocal.cpp
void DiskLocal::startupImpl()
{
    broken = false;
    ...
    try
    {
        setup();                     // setup() 里 FS::canRead(disk_path) 对坏盘直接抛异常
    }
    catch (...)
    {
        tryLogCurrentException(logger, fmt::format("Disk {} is marked as broken during startup", name));
        broken = true;               // 同步就地标 broken
        disk_checker_can_check_read = false;
    }
    if (disk_checker && disk_checker_can_check_read)
        disk_checker->startup();     // 异步探测线程只在盘没坏时才启动
}
而且,从上面的代码可以看到,异步探测线程只在盘没坏时才会startup()(并且DiskChecker的启动只有这一个机会,因此即使这块盘后来在ClickHouse运行过程中被修复,DiskChecker也不会被重新启动起来)。所以到磁盘初始化结束、开始加载part之前,broken已经是确定的true。这一点很重要,因为随后的加载逻辑正是靠它来跳过坏盘,只有跳过坏盘,才不会走到detach broken part的异常路径上。
加载part时,MergeTreeData::loadDataParts(...)遍历storage policy里的盘,遇到broken的直接跳过:
// src/Storages/MergeTree/MergeTreeData.cpp
void MergeTreeData::loadDataParts(bool skip_sanity_checks, ...)
{
    auto disks = getStoragePolicy()->getDisks();
    ...
    for (size_t i = 0; i < disks.size(); ++i)
    {
        const auto & disk_ptr = disks[i];
        if (disk_ptr->isBroken())     // disk_nvme2 已被同步标 broken → 整块跳过
            continue;
        // 只有健康盘才会 iterateDirectory 扫描目录、把 part 加载进内存
        for (auto it = disk_ptr->iterateDirectory(relative_data_path); it->isValid(); it->next())
            ...
    }
}
注意这里和生产事故那次「把盘从配置删掉」的区别:删配置是让盘不出现在getDisks()里;而这里盘还在配置里,但因为isBroken()为真,同样被continue跳过。两条路径殊途同归——坏盘上的part一个都不会被加载进内存。
第二段日志,就是启动时把这些「本地没加载到、但ZooKeeper里有」的part找出来:
2026.07.20 08:23:58.609836 ...default.events (...): Found parts to fetch (exist in zookeeper, but not locally): [1784214000_0_736_86, 1784502000_735_2037_96, ..., 1784199600_3449_3453_1, ...]
用ZooKeeper里期望的part集合,减去本地实际加载到的part,得到parts_to_fetch,再交给队列,等启动完成后从其它副本拉取:
bool StorageReplicatedMergeTree::checkPartsImpl(bool skip_sanity_checks)
{

// src/Storages/StorageReplicatedMergeTree.cpp (启动时的 part 校验)
// expected_parts 来自 ZooKeeper,减去本地实际加载到的 part,得到 parts_to_fetch
if (!parts_to_fetch.empty())
    LOG_DEBUG(log, "Found parts to fetch (exist in zookeeper, but not locally): [{}]", fmt::join(parts_to_fetch, ", "));

queue.setBrokenPartsToEnqueueFetchesOnLoading(std::move(parts_to_fetch));   // 交给队列,启动后拉取
第三段日志,是 ReplicatedMergeTreeRestartingThread 真正处理这些缺失part时打出来的:
2026.07.20 08:23:58.614753 ...default.events (...): Detached 0 parts covered by broken part 1784214000_0_736_86:
我们上文讲过,ReplicatedMergeTreeRestartingThread 会把系统启动时算出来的Missing Parts,通过ReplicatedMergeTreeQueue::createLogEntriesToFetchBrokenParts(),逐个交给 StorageReplicatedMergeTree::removePartAndEnqueueFetch(...) 去建 GET_PART,即触发 re-fetch 的那一下,就是它按下的。
这里的Detached 0 parts是关键。StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)要detach的对象,是从内存里已加载的part中找的;而这些part在启动时根本没被加载进来,所以StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)内部的循环体一次都没执行,IMergeTreeDataPart::makeCloneInDetached(...)(那个在运行时必然会在坏盘上失败的步骤)被完全跳过:
// src/Storages/StorageReplicatedMergeTree.cpp
void StorageReplicatedMergeTree::removePartAndEnqueueFetch(const String & part_name, bool storage_init)
{
    ...
    // 只在"内存里已加载的 part"里找要 clone 到 detached 的对象
    auto partition_range = getDataPartsVectorInPartitionForInternalUsage(
        {MergeTreeDataPartState::Active, MergeTreeDataPartState::Outdated}, broken_part_info.getPartitionId());

    Strings detached_parts;
    for (const auto & part : partition_range)
    {
        if (!broken_part_info.contains(part->info))
            continue;
        part->makeCloneInDetached("broken", ...);   // 启动路径: 内存里没有这些 part,循环体一次都不执行
        detached_parts.push_back(part->name);
    }
    LOG_WARNING(log, "Detached {} parts covered by broken part {}: {}", detached_parts.size(), part_name, ...);
    // ↑ 启动路径 detached_parts.size() == 0,于是日志是 "Detached 0 parts"
    ...
    // 后续:从 ZK 注销该 part、创建 GET_PART,全程没碰坏盘
}
所以,StorageReplicatedMergeTree::removePartAndEnqueueFetch(...)没有执行detach,就直接开始ZK上的注销流程,创建GET_PART流程等,刚好完美错过detach的bug。
MergeTreeData::getDataPartsVectorInPartitionForInternalUsage(...)之所以返回空,是因为它只读内存里的part索引:
// src/Storages/MergeTree/MergeTreeData.cpp
MergeTreeData::DataPartsVector MergeTreeData::getDataPartsVectorInPartitionForInternalUsage(
    const DataPartStates & affordable_states, const String & partition_id, ...) const
{
    auto lock = ...;
    DataPartsVector res;
    for (const auto & state : affordable_states)
        res.insert(res.end(),
            data_parts_by_state_and_info.lower_bound(...),   // 只遍历内存索引 data_parts_by_state_and_info
            data_parts_by_state_and_info.upper_bound(...));  // 没加载进来的 part 自然不在其中
    return res;
}
紧接着,这些part就从健康副本radp603被拉了回来:
2026.07.20 08:23:58.685051 ...default.events (...): Fetched part 1784224800_3360_3452_19 from default:/clickhouse/tables/01/events/replicas/radp603-21a
重启完成后验证:
radp606-21d.iad7.prod.viva.com :) SELECT name, is_broken, is_read_only
                                     FROM system.disks WHERE name LIKE 'disk\_%' ORDER BY name;

    ┌─name───────┬─is_broken─┬─is_read_only─┐
    │ disk_nvme1 │         0 │            0 │
    │ disk_nvme2 │         1 │            1 │   ← 盘仍然是坏的
    │ disk_nvme3 │         0 │            0 │
    │ disk_nvme4 │         0 │            0 │
    └────────────┴───────────┴──────────────┘

radp606-21d.iad7.prod.viva.com :) SELECT disk_name, count()
                                     FROM system.parts
                                     WHERE database='default' AND table='events' AND active
                                     GROUP BY disk_name ORDER BY disk_name;

    ┌─disk_name──┬─count()─┐
    │ disk_nvme1 │     209 │
    │ disk_nvme3 │     214 │
    │ disk_nvme4 │     195 │   ← disk_nvme2 上 0 个 part,原来它的 part 都到了其它三块盘
    └────────────┴─────────┘
disk_nvme2仍然标着broken、上面0个part,但表的数据是完整的:本机行数和另一台副本radp603基本一致(相差几百行,是持续写入的正常抖动)。也就是说,只重启、不从storage.xml删盘,同样把问题解决了。 坏盘留在配置里不要紧,启动时它被isBroken()跳过,等效于把它上面的part「删掉」,于是这些part走了「本地缺失 → 直接fetch」这条不需要detach的路径。这说明生产事故里「先删盘再重启」其实不是必需的一步,重启本身就够了。
至于坏盘本身,等硬件修好后(做测试一里那套恢复动作即可),DiskLocalCheckThread的探测会通过,is_broken回到0,这块盘会重新参与写入。
总结
我们可以看到,磁盘故障本身非常简单,但是要理解这种磁盘故障带来的系统影响、以及在我们当前的ClickHouse版本下的修复策略、各个修复策略的优劣、选择最优策略,则需要我们在事故解决以后,继续进行更多的测试和代码验证。
我们也就此看到,作为一个基于C++的存算一体的分布式查询引擎,ClickHouse有它自身的一些特点:
- 存储架构的不成熟: 首先,毕竟专注于计算,所以,存储层面的故障,ClickHouse并没有传统老牌的开源系统来得那么完备。在我们HDFS系统中,单一DataNode的crash,单一磁盘的故障,都不会造成任何系统影响,而且,都可以进行热修复和热加载,非常方便和完善;
- 理论和实践的差距: ClickHouse的文档和设计都很完善,
ReplicatedMergeTree理论上应该能自动处理单盘故障。但在极端情况下 (磁盘完全无法访问),"先detach再fetch"的流程会卡在第一步。 - 源码是最终的真相: 了解
makeCloneInDetached(...)必须在坏盘上执行、启动路径有ignore_error特殊处理、运行时路径没有容错机制等细节,对诊断问题至关重要。 - 失败的尝试有助于我们更深入理解系统: 在最终选择重启以前,我们尝试了DROP PART、动态删除disk、STOP LISTEN等多种方案,虽然都没有成功,但每次尝试都让我们对ClickHouse的特性和特点有了更深入的理解。这些失败的尝试有助于我们在其它场景下深入和熟练地管理ClickHouse;
当然,在磁盘发生问题的时候,及时而又直白地直接报出磁盘故障,显得非常省时省力,这样可以让管理员及时介入,同时也无需再看日志去寻找原因。
同时,我们也看到了并验证了ReplicatedMergeTree的设计初衷: 只要有一个健康的replica,数据就不会丢失。虽然自动恢复流程在磁盘完全损坏时卡住了,但通过重启,我们仍然成功地将所有数据从peer恢复回来,实现了零数据丢失。
更多推荐


 6
 0
- 0


 已为社区贡献7条内容

所有评论(0)