
基于Spark的贵州旅游景区气候数据分析与可视化系统设计
摘 要
随着旅游业的迅猛发展和气候变化的愈发显著,气候条件已成为影响游客出行决策和区域旅游发展规划的核心要素。然而,传统的旅游气候数据分析方法在处理海量、多源、异构数据时往往面临计算效率低下的难题。为了解决这一问题,本文设计并实现了一套基于大数据的贵州旅游景区气候数据分析与可视化系统。
该系统采用B/S架构,以后端Django框架和MySQL数据库为基础支撑,核心依托Spark分布式计算框架的高效内存计算能力,对贵州省主要旅游景区(如黄果树瀑布、荔波小七孔等)的历史气候数据及客流量数据进行深度的清洗、整合与分析。系统主要集成了用户管理、总客流量管理、境外客流量管理、景点客流量管理等一体化功能模块,并结合Python及ECharts等可视化技术,构建了直观的数据分析大屏。通过线性回归与K-means聚类等算法,系统成功挖掘了气候因子对游客出行的权重影响及关联性。
1 绪 论
随着旅游业的迅猛发展和气候变化愈发显著,气候条件已成为影响旅游景区吸引力、游客出行决策以及区域旅游发展规划的核心要素。贵州作为中国重要的生态旅游胜地,拥有丰富的自然与人文景观,其独特的高原山地气候对旅游体验具有深远影响。然而,传统的旅游气候数据分析方法在处理海量、多源、异构的气候数据时,往往面临存储与计算效率低下的难题。本研究旨在依托Spark分布式计算框架,对贵州省主要旅游景区(包括黄果树瀑布、荔波小七孔、西江千户苗寨等)的历史及实时气候数据进行深度分析与可视化展示。
2 系统开发技术
本系统基于B/S架构开发,以Python为核心开发语言,依托Django框架搭建Web后端,搭配MySQL数据库实现数据存储。采用Spark分布式计算框架完成海量气候与客流数据处理,借助Python各类可视化库与ECharts实现数据可视化展示,高效支撑系统数据分析与可视化功能落地。
5 系统详细设计
管理员点击用户管理。进入用户页面输入账号和姓名可以查询、新增或删除用户列表,并根据需要对用户详细信息进行详情、修改或删除操作,如图5-4所示:
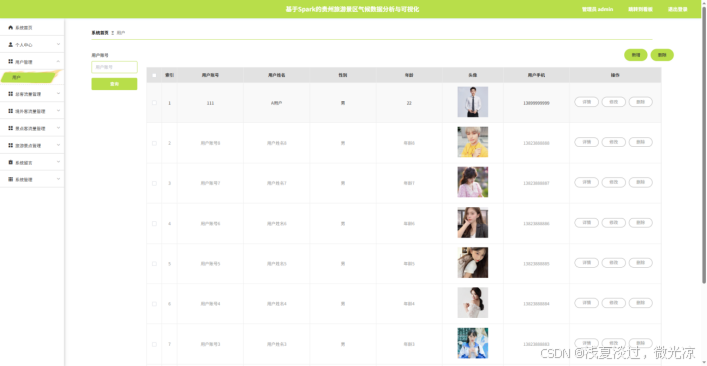
图5-4用户管理界面
管理员点击总客流量管理。在总体客流量信息的界面中,输入年份、地点及旅游景点的总数/家,就能够获得、提取相关的数据,也能够移除总体的客流量信息。同时,还能够依照需求,对这些详尽的客流量信息做出具体的调整、更新或者移除,具体的操作请参见图5-5。
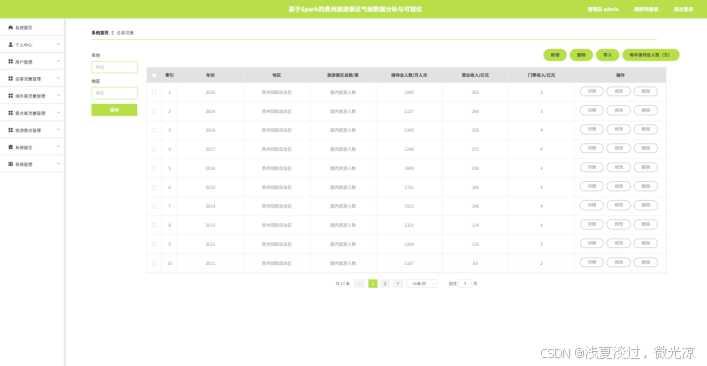
图5-5总客流量管理界面
景点列表。进入景点列表页面,用户可以查看到系统中所有景区的详细分类信息,并支持根据关键词、分类标签或评价热度进行筛选与搜索,方便用户快速定位感兴趣的旅游目的地,如图 5-12 所示:
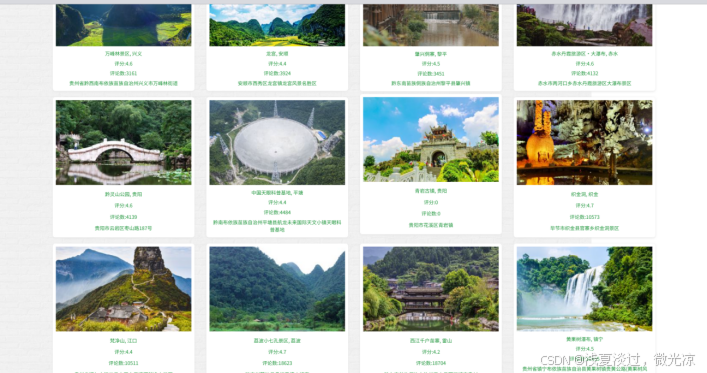
图5-12 景点列表
6系统测试
为客观评价 Spark 框架的加速效果,本小节对比了传统单机 Pandas 处理与 Spark 分布式引擎在同等算法逻辑下的耗时差异。实验选取气象适宜度模型作为测试基准,结果发现随着数据规模扩大,Spark 凭借内存并行计算优势,其处理速度呈现出指数级的领先。
更多推荐

 4
 0
- 0


 已为社区贡献5条内容

所有评论(0)