
大数据毕业设计选题【基于大数据的环境空气质量数据可视化分析】PySpark挖掘+可视化大屏
精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
一、项目介绍
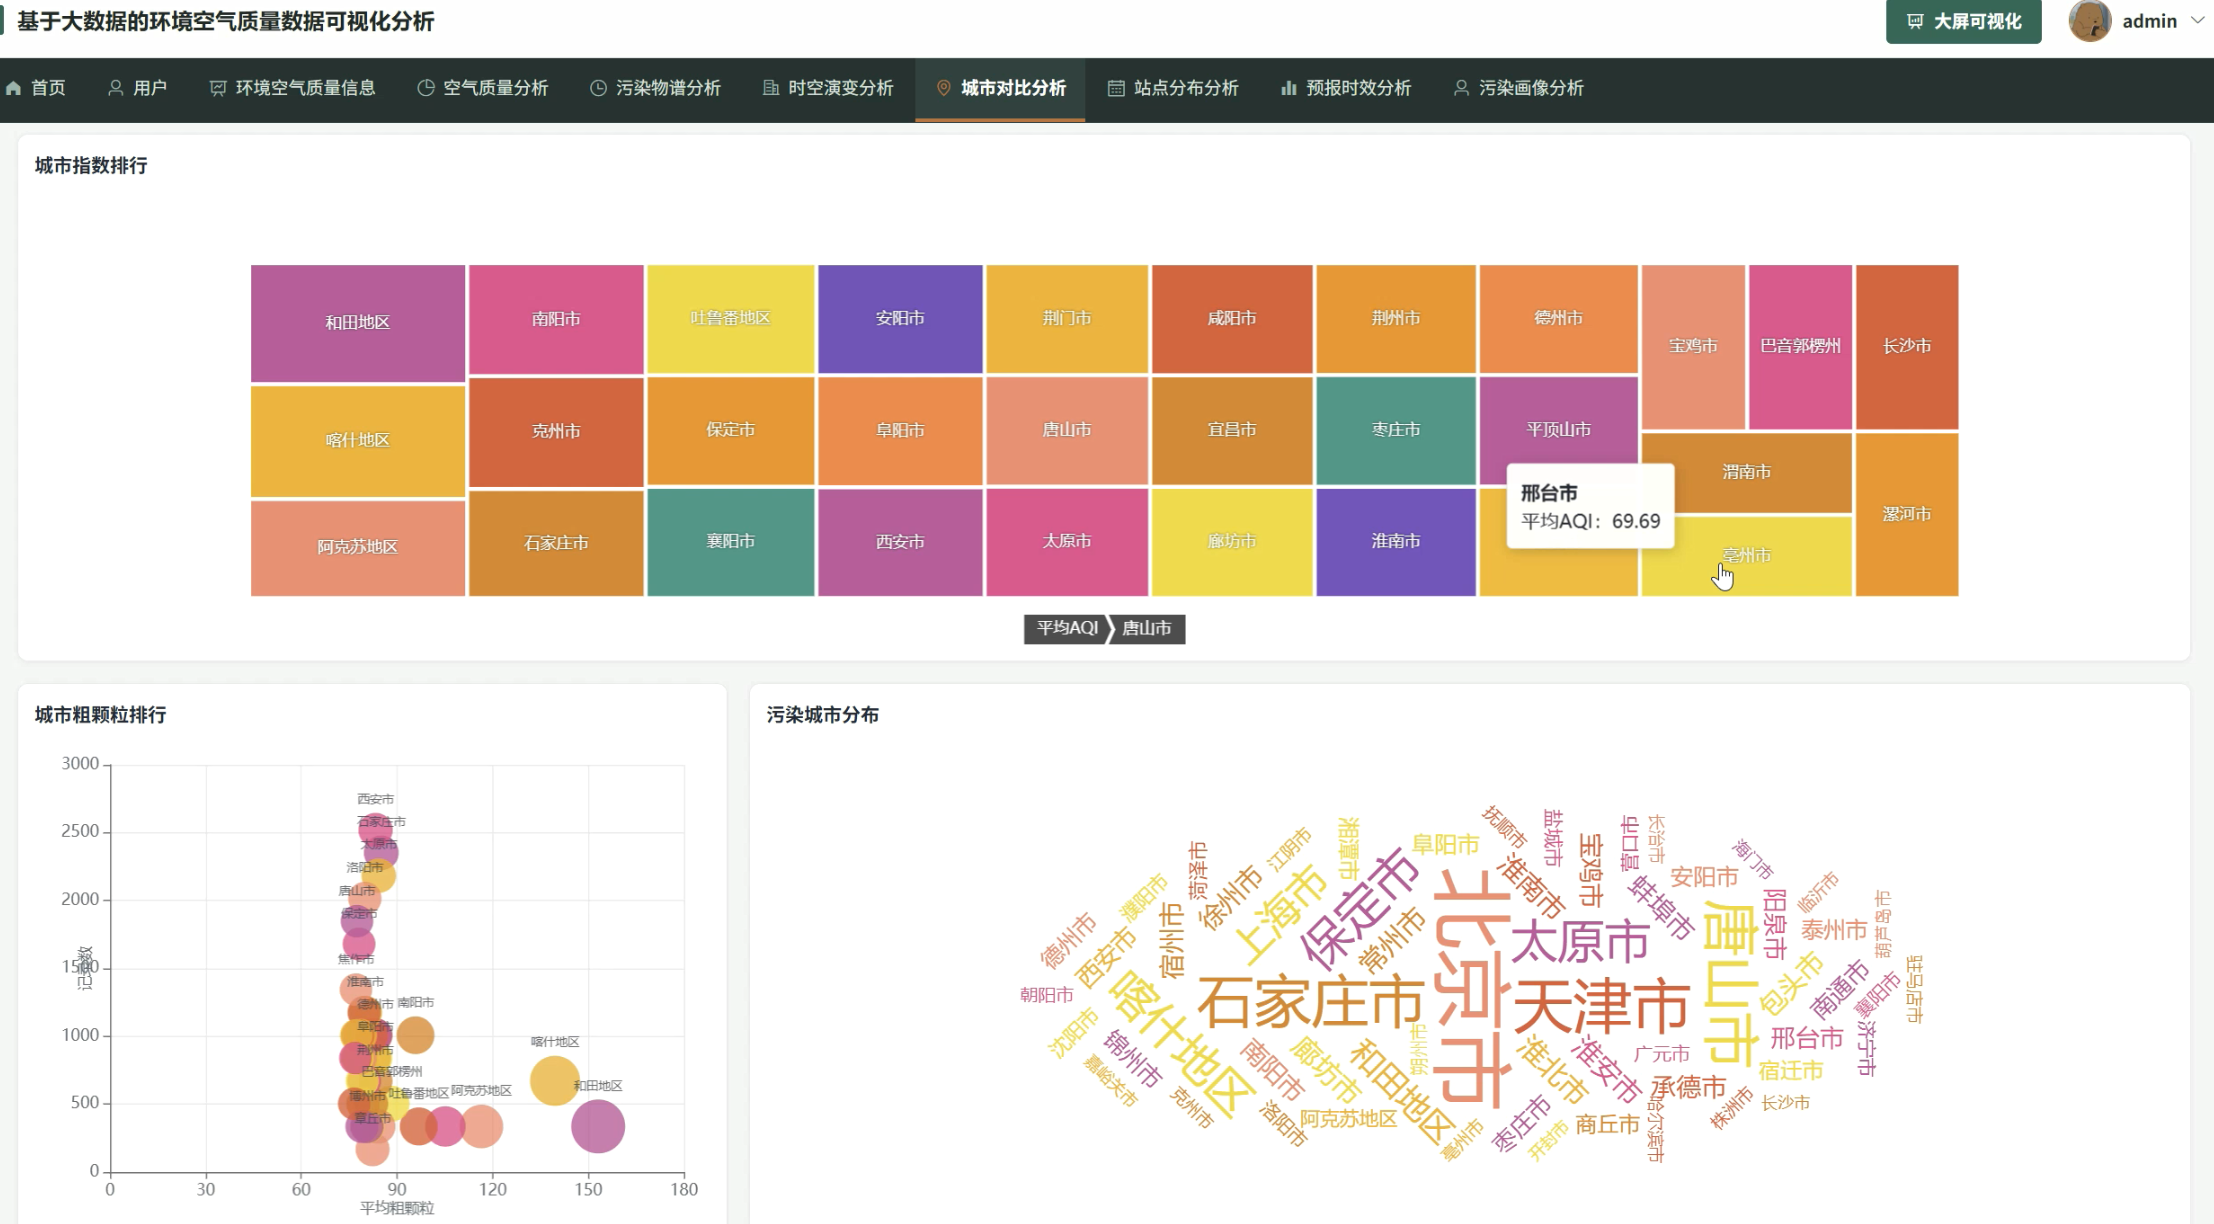
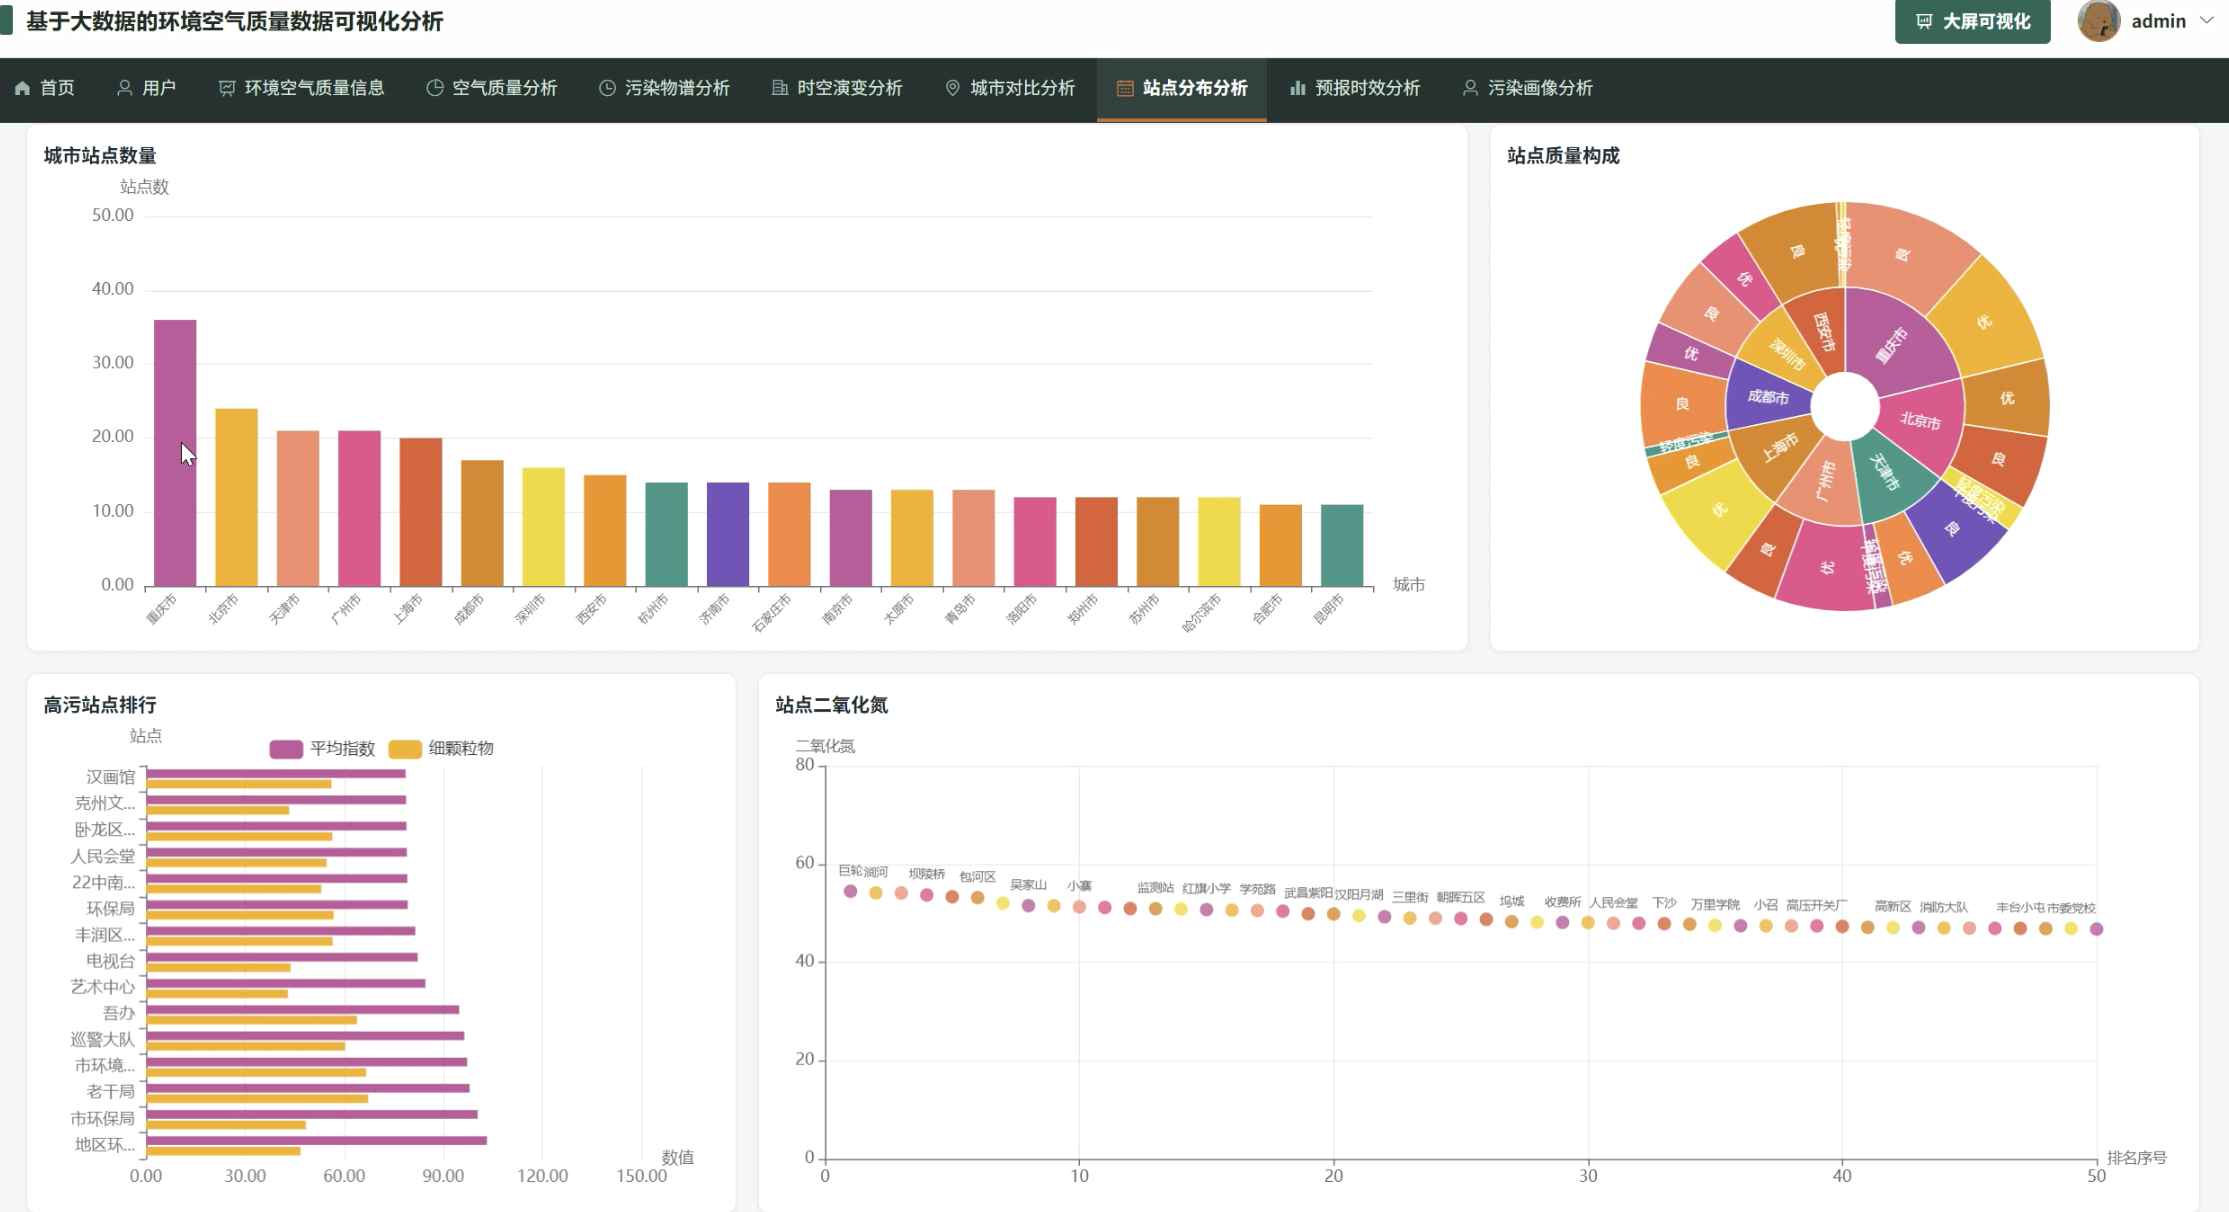
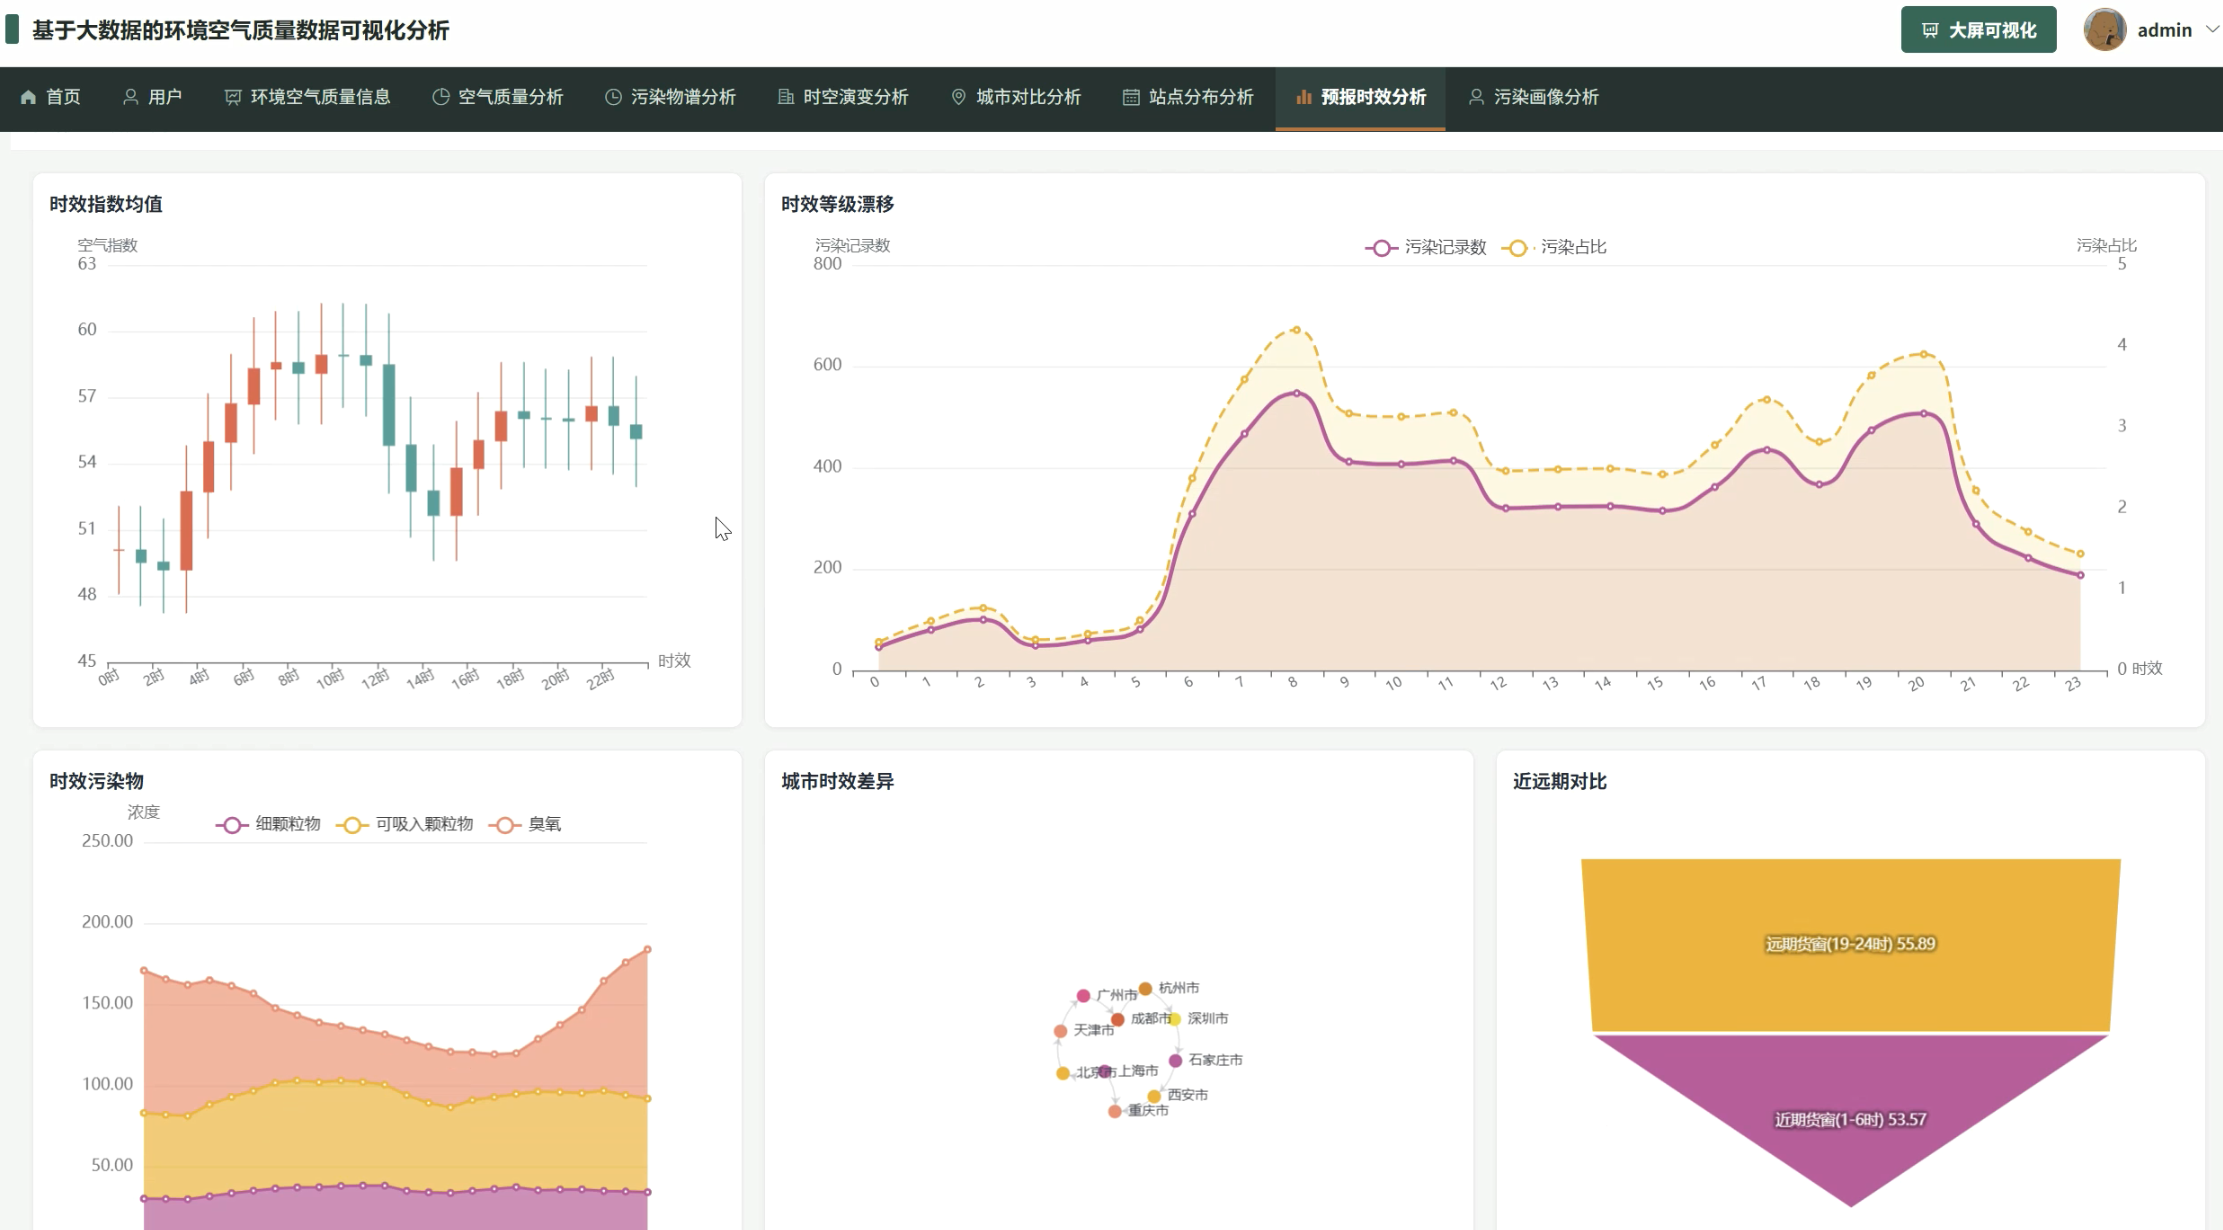
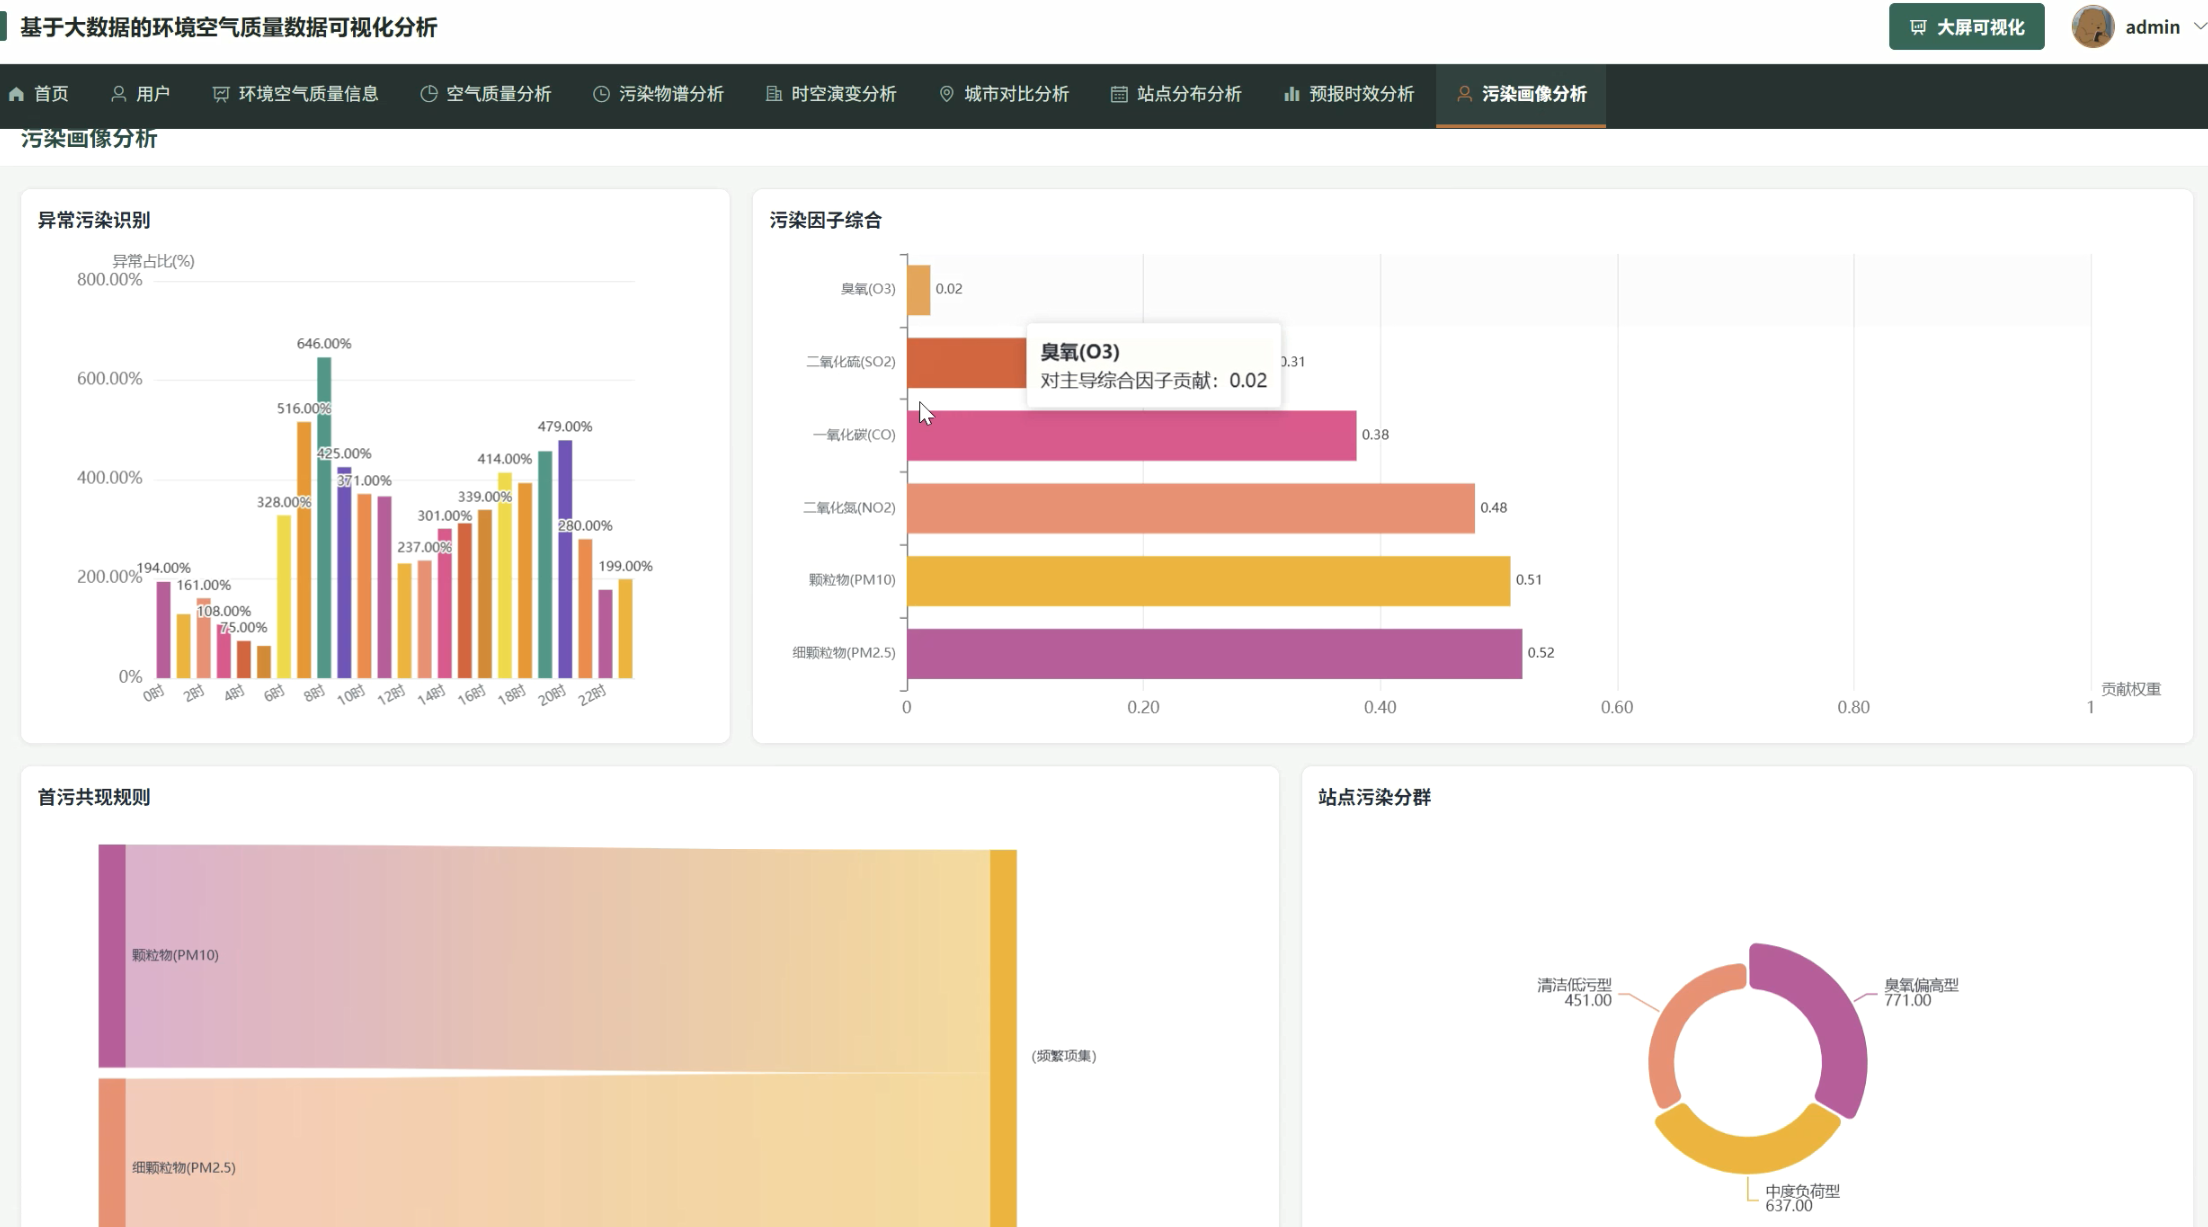
空气质量监测站点多、预报断面数据量大,城市与站点之间的污染差异常散落在表格里,翻起来挺费劲,也难一眼看出站点分群和首污共现这类规律。本文通过开发一个基于大数据的环境空气质量数据可视化分析系统,用以帮助解决空气质量预报数据难汇总、难对比、难洞察的问题。
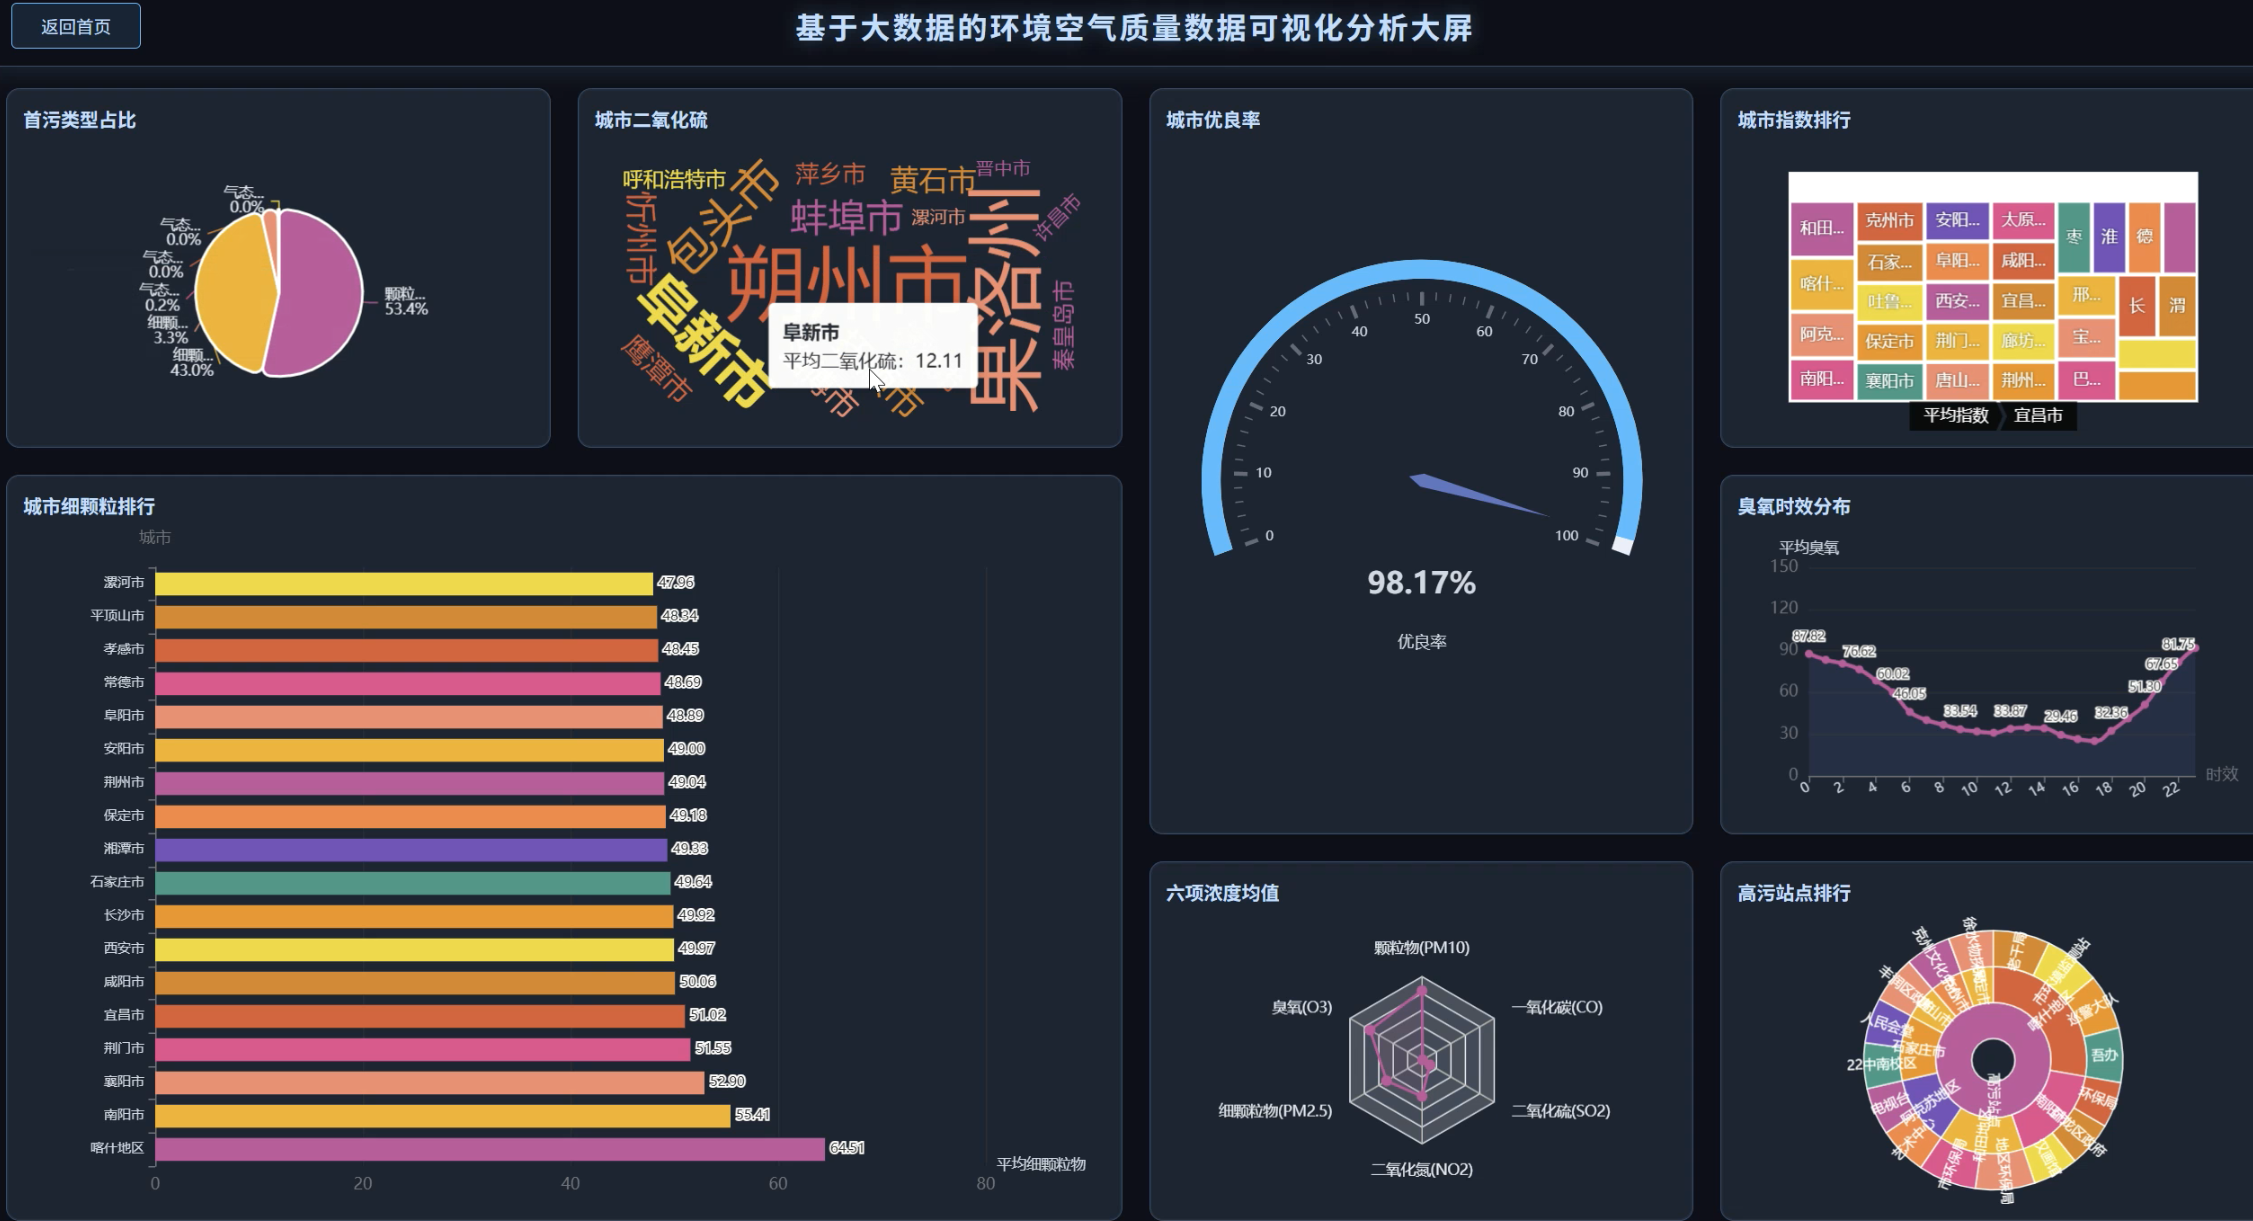
系统采用 Hadoop 与 Spark 完成数据落地和分布式分析,用 Python、Django、Vue 与 MySQL 搭建业务与展示层,并在污染画像中使用 K-Means、Isolation Forest、PCA 与 FP-Growth。功能上覆盖空气质量、污染物谱、时空演变、城市对比、站点分布、预报时效与污染画像等分析维度,同时提供可视化大屏与基础数据管理,把约三十一万行站点预报数据做成可浏览的图表结果。
经过系统测试,本系统能满足计算机及相关专业师生做课题演示、空气质量数据浏览分析等使用需求,对把站点级预报数据转成可对比、可分群的可视化结果具有一定参考意义。
二、视频展示
计算机毕业设计选题推荐【基于大数据的环境空气质量数据分析
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
- PySpark MLlib:K-Means、PCA、FP-Growth
四、系统展示
登录模块: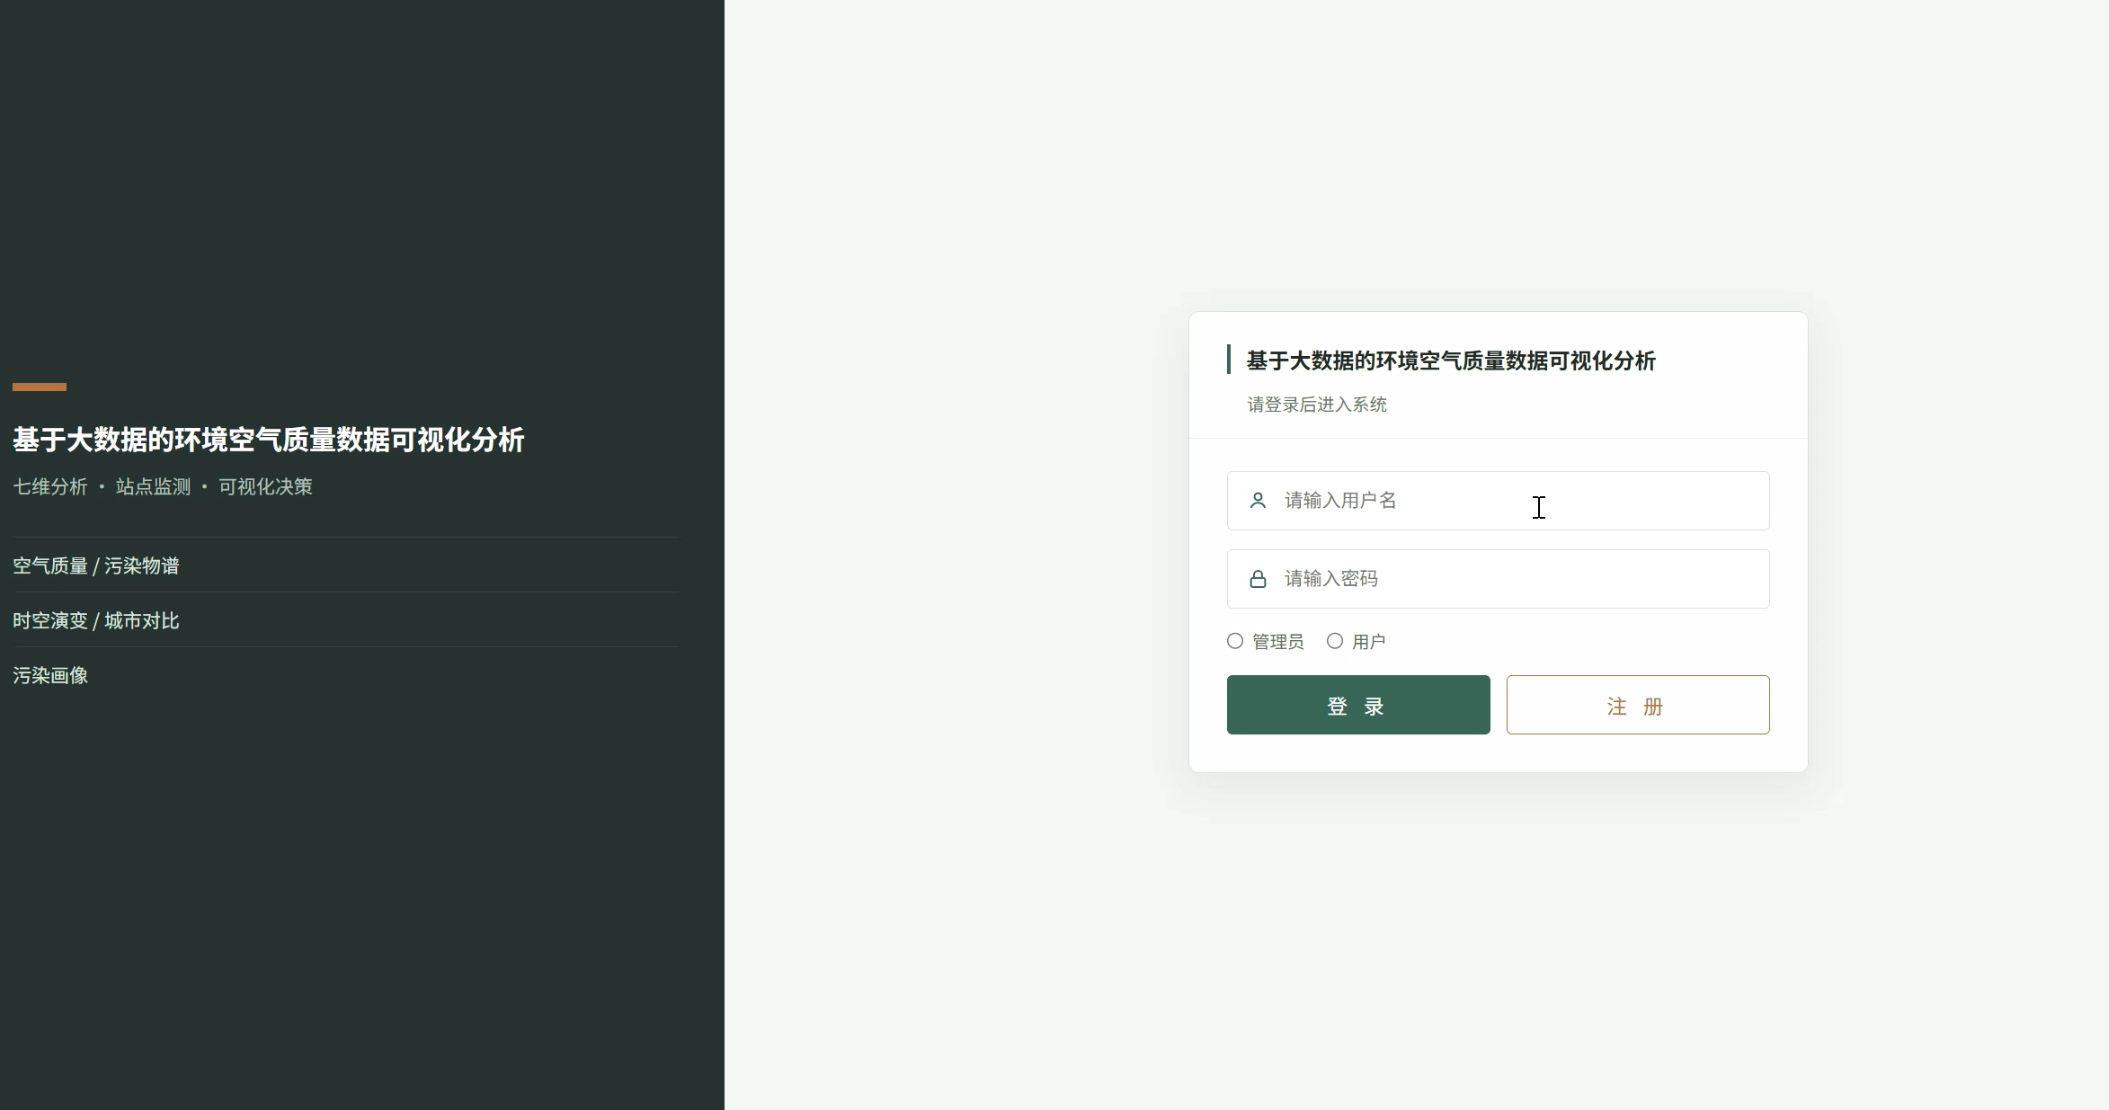
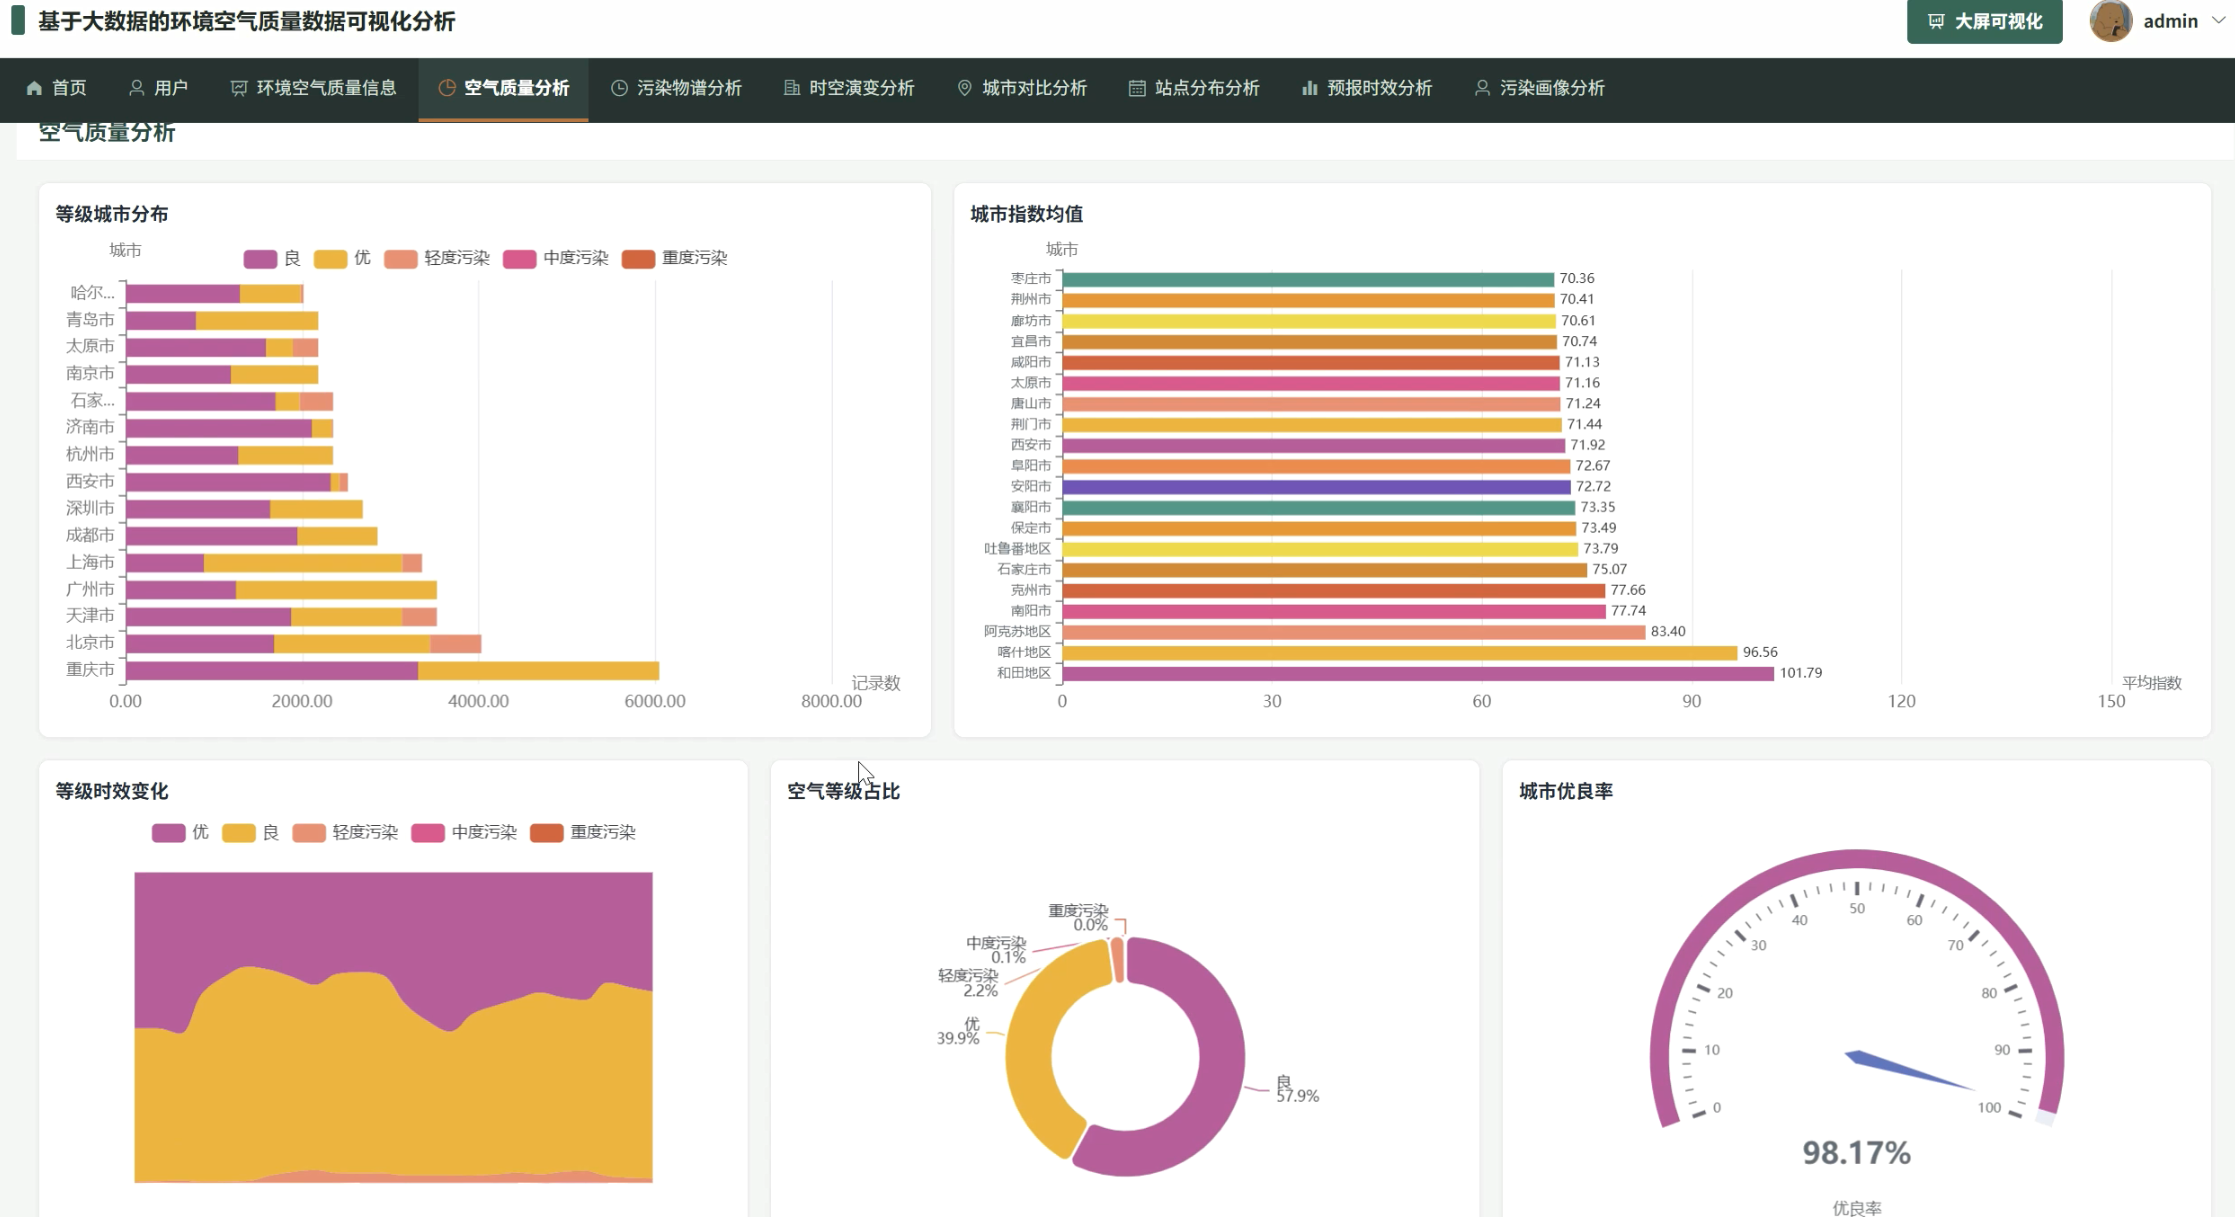
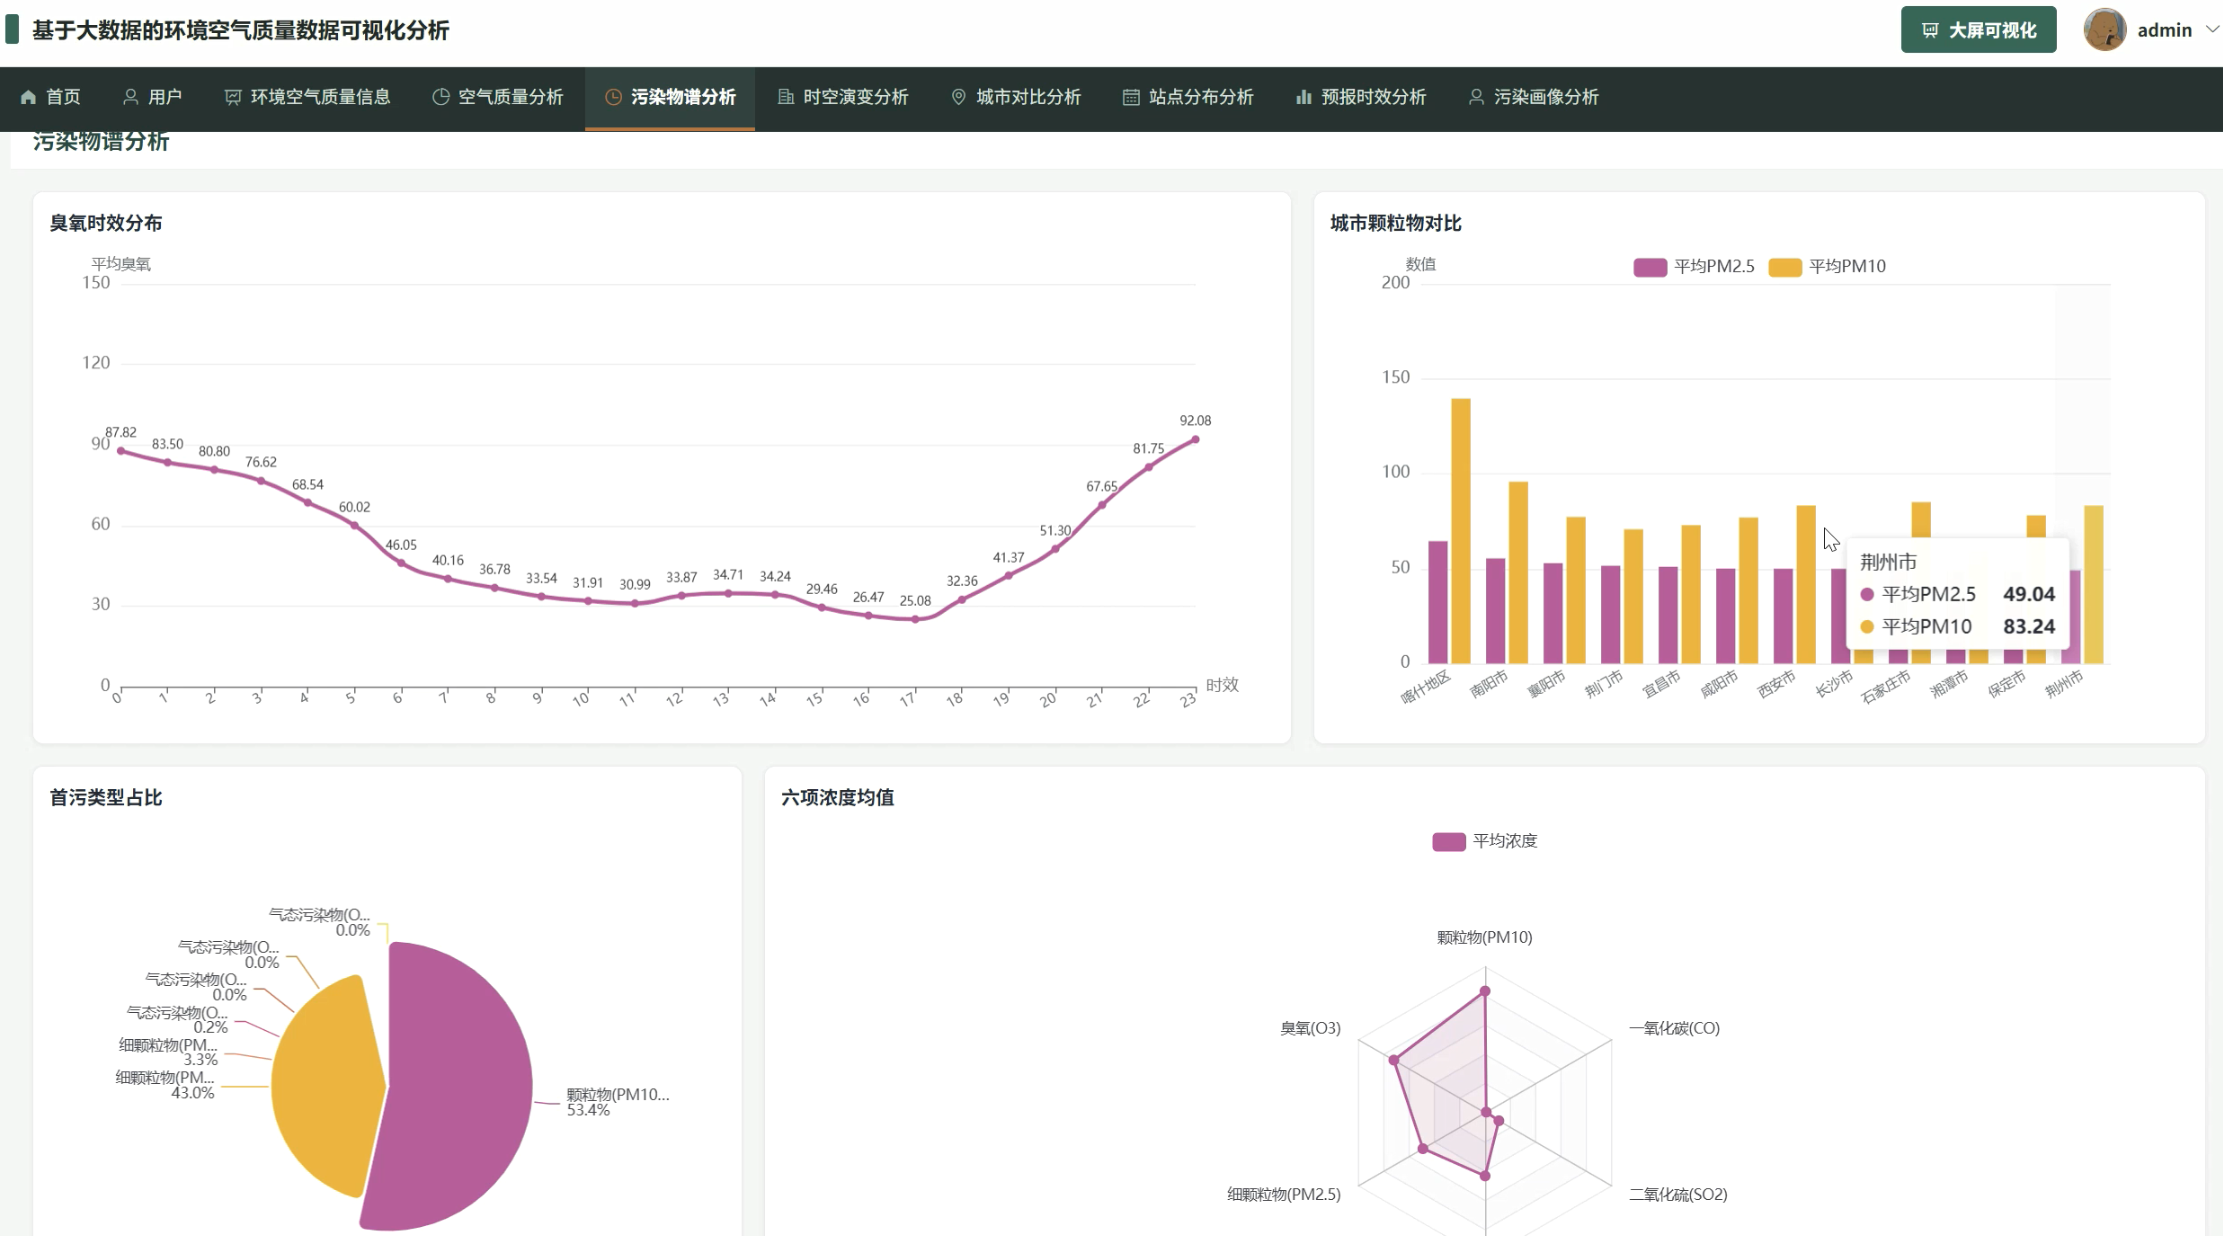
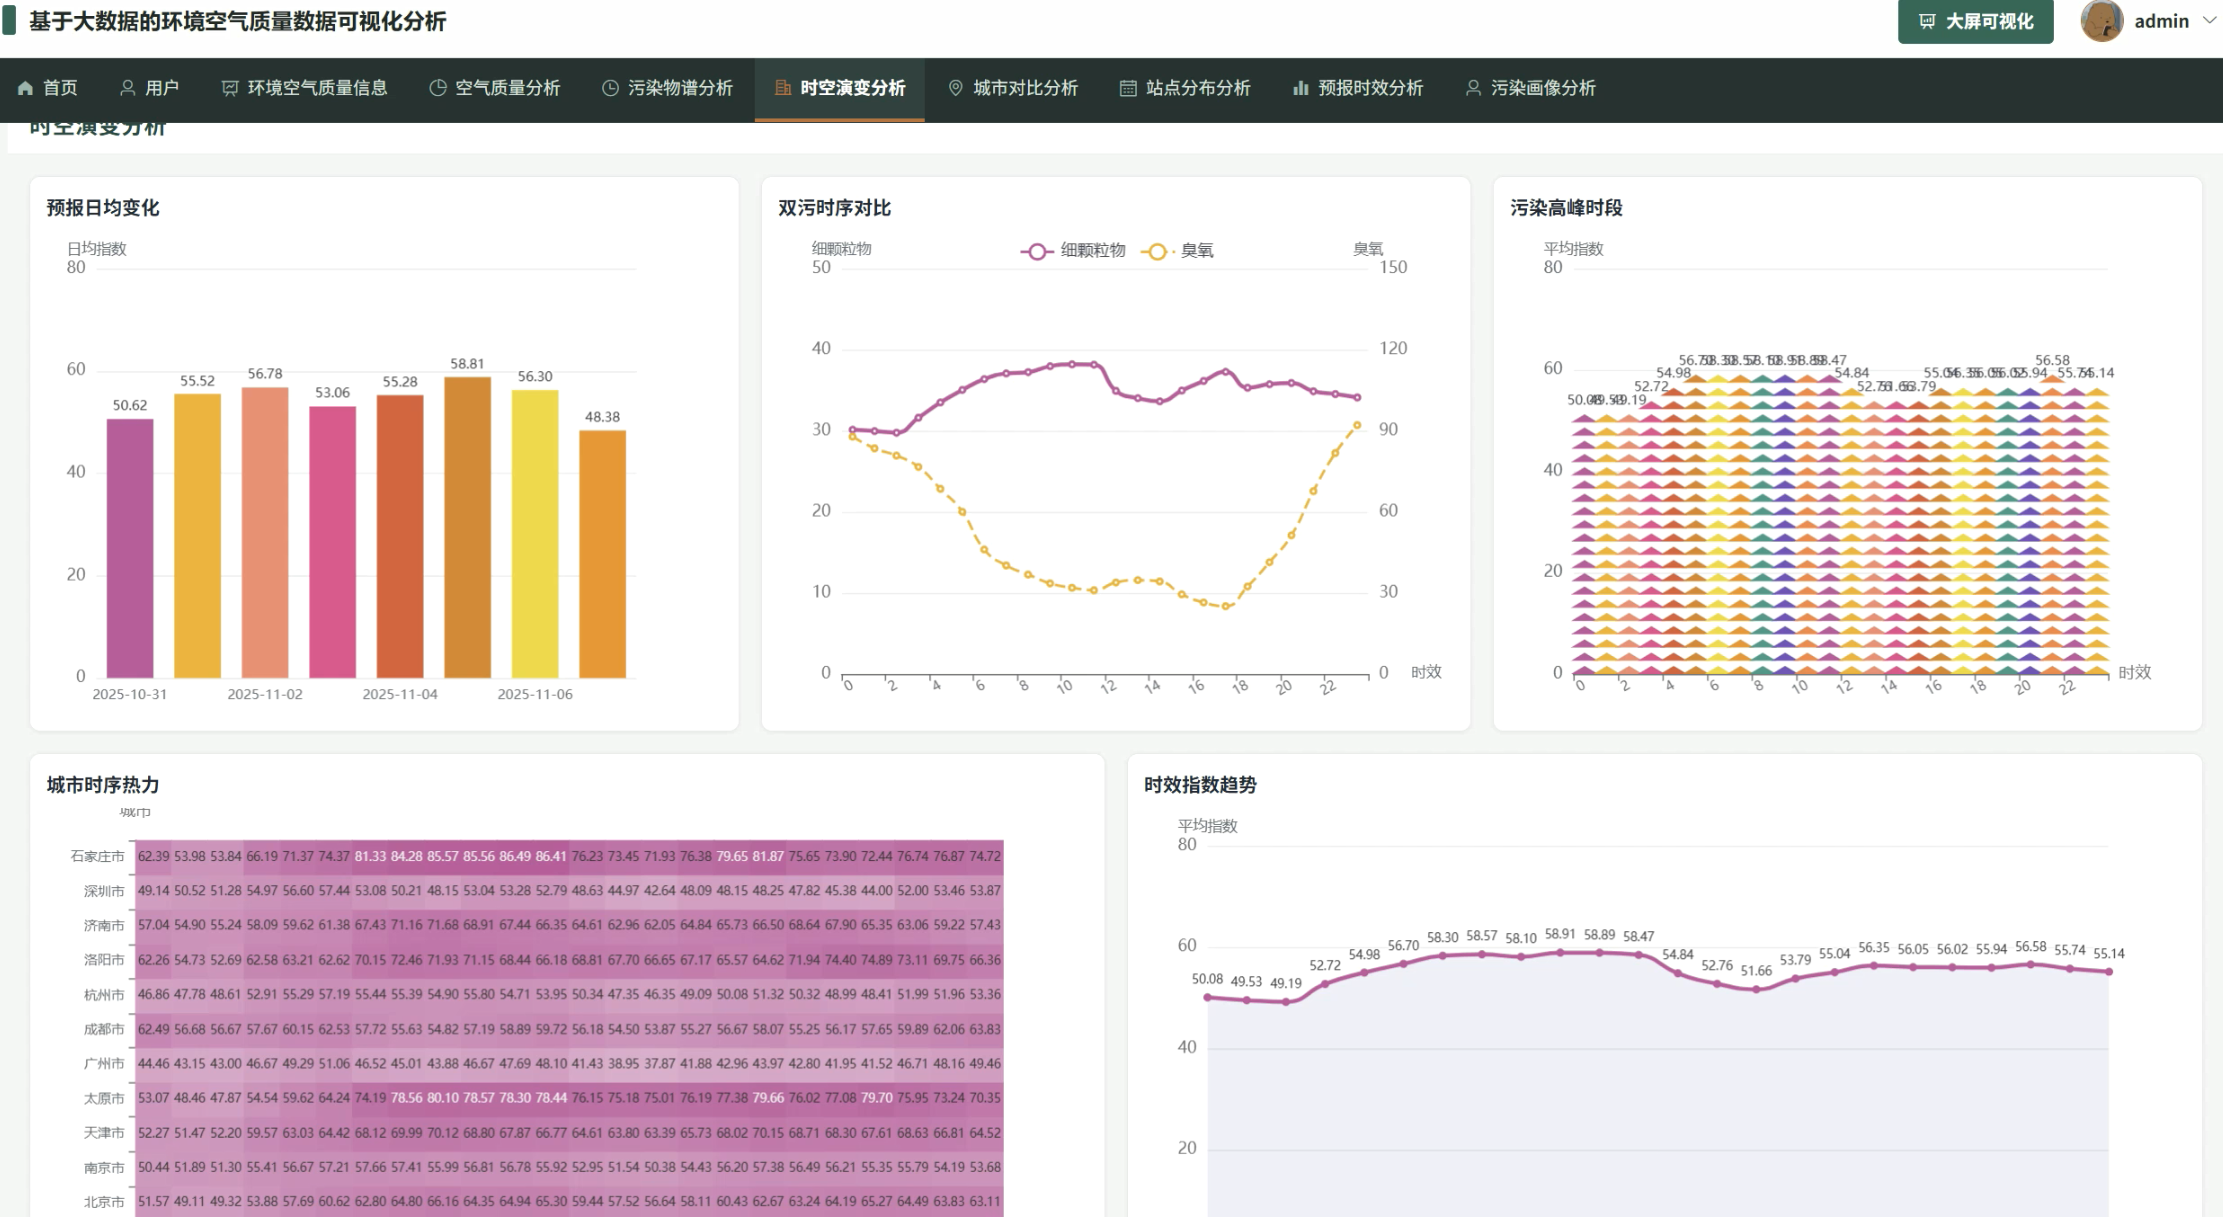
五、代码展示
# 六项瞬时污染物 + AQI:转 float
num_instant = ['PM25', 'PM10', 'SO2', 'NO2', 'CO', 'O3', 'AQI', 'AQI_24h', 'lon', 'lat']
for col in num_instant:
    df[col] = pd.to_numeric(df[col], errors='coerce')

# 24h/8h 滑动字段:转 float,保留缺失(分析时过滤)
num_sliding = ['PM25_24h', 'PM10_24h', 'SO2_24h', 'NO2_24h', 'CO_24h',
               'O3_24h', 'O3_8h', 'O3_8h_24h']
for col in num_sliding:
    df[col] = pd.to_numeric(df[col], errors='coerce')

# 瞬时浓度负值视为异常,删除
neg_mask = (df[['PM25', 'PM10', 'SO2', 'NO2', 'CO', 'O3', 'AQI']] < 0).any(axis=1)
if int(neg_mask.sum()) > 0:
    df = df.loc[~neg_mask].copy()

df['predict_hour'] = pd.to_numeric(df['predict_hour'], errors='coerce').fillna(0).astype(int)

# 从 predict_time 解析预报日期(日聚合用)
pt = pd.to_datetime(df['predict_time'], format='%d/%m/%Y %H:%M:%S', errors='coerce')
df['predict_date'] = pt.dt.strftime('%Y-%m-%d')

# pollutions 高缺失且语义=优级无首污:保留空串,禁止众数填真实污染物
df['pollutions'] = df['pollutions'].astype(str).str.strip()
df.loc[df['pollutions'].isin(['nan', 'None', 'null', 'NaN']), 'pollutions'] = ''
def station_pollution_cluster_analysis(input_df):
    """按站点聚合均值后 K-Means;用轮廓系数在 k=3..5 中选最优。"""
    base = input_df.filter(col('mp_code').isNotNull() & (col('mp_code') != '未知'))
    for c in FEATURE_COLS:
        base = base.filter(col(c).isNotNull())
    station_df = (
        base.groupBy('mp_code', 'mp_label', 'city')
        .agg(*[spark_round(spark_avg(c), 2).alias(c) for c in FEATURE_COLS])
    )

    assembler = VectorAssembler(inputCols=FEATURE_COLS, outputCol='features_raw')
    assembled = assembler.transform(station_df)
    scaler = StandardScaler(inputCol='features_raw', outputCol='features',
                            withStd=True, withMean=True)
    scaled = scaler.fit(assembled).transform(assembled)

    evaluator = ClusteringEvaluator(
        predictionCol='cluster_id', featuresCol='features', metricName='silhouette'
    )
    best_k, best_score, best_model, best_pred = 3, -1.0, None, None
    for k in [3, 4, 5]:
        km = KMeans(featuresCol='features', predictionCol='cluster_id', k=k, seed=42)
        model = km.fit(scaled)
        pred = model.transform(scaled)
        score = float(evaluator.evaluate(pred))
        if score > best_score:
            best_k, best_score, best_model, best_pred = k, score, model, pred

    # 按簇内平均 AQI 相对排序,贴中文簇标签(清洁低污型 / 高颗粒物型等)
    cluster_stats = (
        best_pred.groupBy('cluster_id')
        .agg(spark_round(spark_avg('AQI'), 2).alias('avg_aqi'),
             spark_round(spark_avg('PM25'), 2).alias('avg_pm25'),
             spark_count(lit(1)).alias('station_count'))
        .orderBy('avg_aqi')
    )
    # ... 映射 cluster_label / cluster_desc 后写出 csv
def primary_pollutant_fpgrowth_analysis(input_df):
    """过滤空 pollutions,按顿号拆项集,MLlib FPGrowth。"""
    base = input_df.filter(
        col('pollutions').isNotNull()
        & (col('pollutions') != '')
        & (col('pollutions') != 'nan')
    )
    with_items = (
        base.withColumn('items', split(col('pollutions'), '、'))
        .filter(size(col('items')) >= 1)
        .select('items')
    )

    fp = FPGrowth(itemsCol='items', minSupport=0.01, minConfidence=0.3)
    model = fp.fit(with_items)
    rules = model.associationRules
    rules_pdf = rules.toPandas()

    # 输出 antecedent → consequent、support、confidence、lift 及中文 rule_desc
    out_pdf = pd.DataFrame({
        'antecedent': rules_pdf['antecedent'].map(lambda v: '、'.join(list(v or []))),
        'consequent': rules_pdf['consequent'].map(lambda v: '、'.join(list(v or []))),
        'support': rules_pdf['support'].astype(float).round(2),
        'confidence': rules_pdf['confidence'].astype(float).round(2),
        'lift': rules_pdf['lift'].astype(float).round(2),
    })
六、项目文档展示

七、项目总结
本课题围绕环境空气质量预报数据,完成了从大数据处理到可视化展示的整套实现。系统用 Hadoop、Spark 对约三十一万行站点数据进行清洗与分析,覆盖空气质量、污染物谱、时空演变、城市对比、站点分布、预报时效与污染画像等维度,并在污染画像中落地 K-Means 分群、Isolation Forest 异常识别、PCA 降维与 FP-Growth 首污共现。业务侧以 Django、Vue、MySQL 提供分析接口、可视化大屏和基础数据管理,便于按城市、站点与预报时效查看结果。总体来看,该系统把分散的空气质量数据转成可对比、可分群的图表展示,对教学演示和空气质量数据分析具有一定实用参考价值。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
更多推荐

 7
 0
- 0


 已为社区贡献24条内容

所有评论(0)