
计算机毕业设计选题推荐【基于大数据的城市生活气象指数分析与可视化】PySpark+K-Means可视化大屏
精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
一、项目介绍
城市生活气象服务会发布霉变、舒适度、晨练、旅游、穿衣、紫外线等指数,等级和时效也一块记着,但记录多半还停在表格里,想看清哪类指数更常进入不利等级、同日哪些风险会一起冒头,翻来翻去其实挺费劲。本文通过开发一个基于大数据的城市生活气象指数分析与可视化系统,用以帮助解决生活指数多维统计与风险共现难以集中查看的问题。
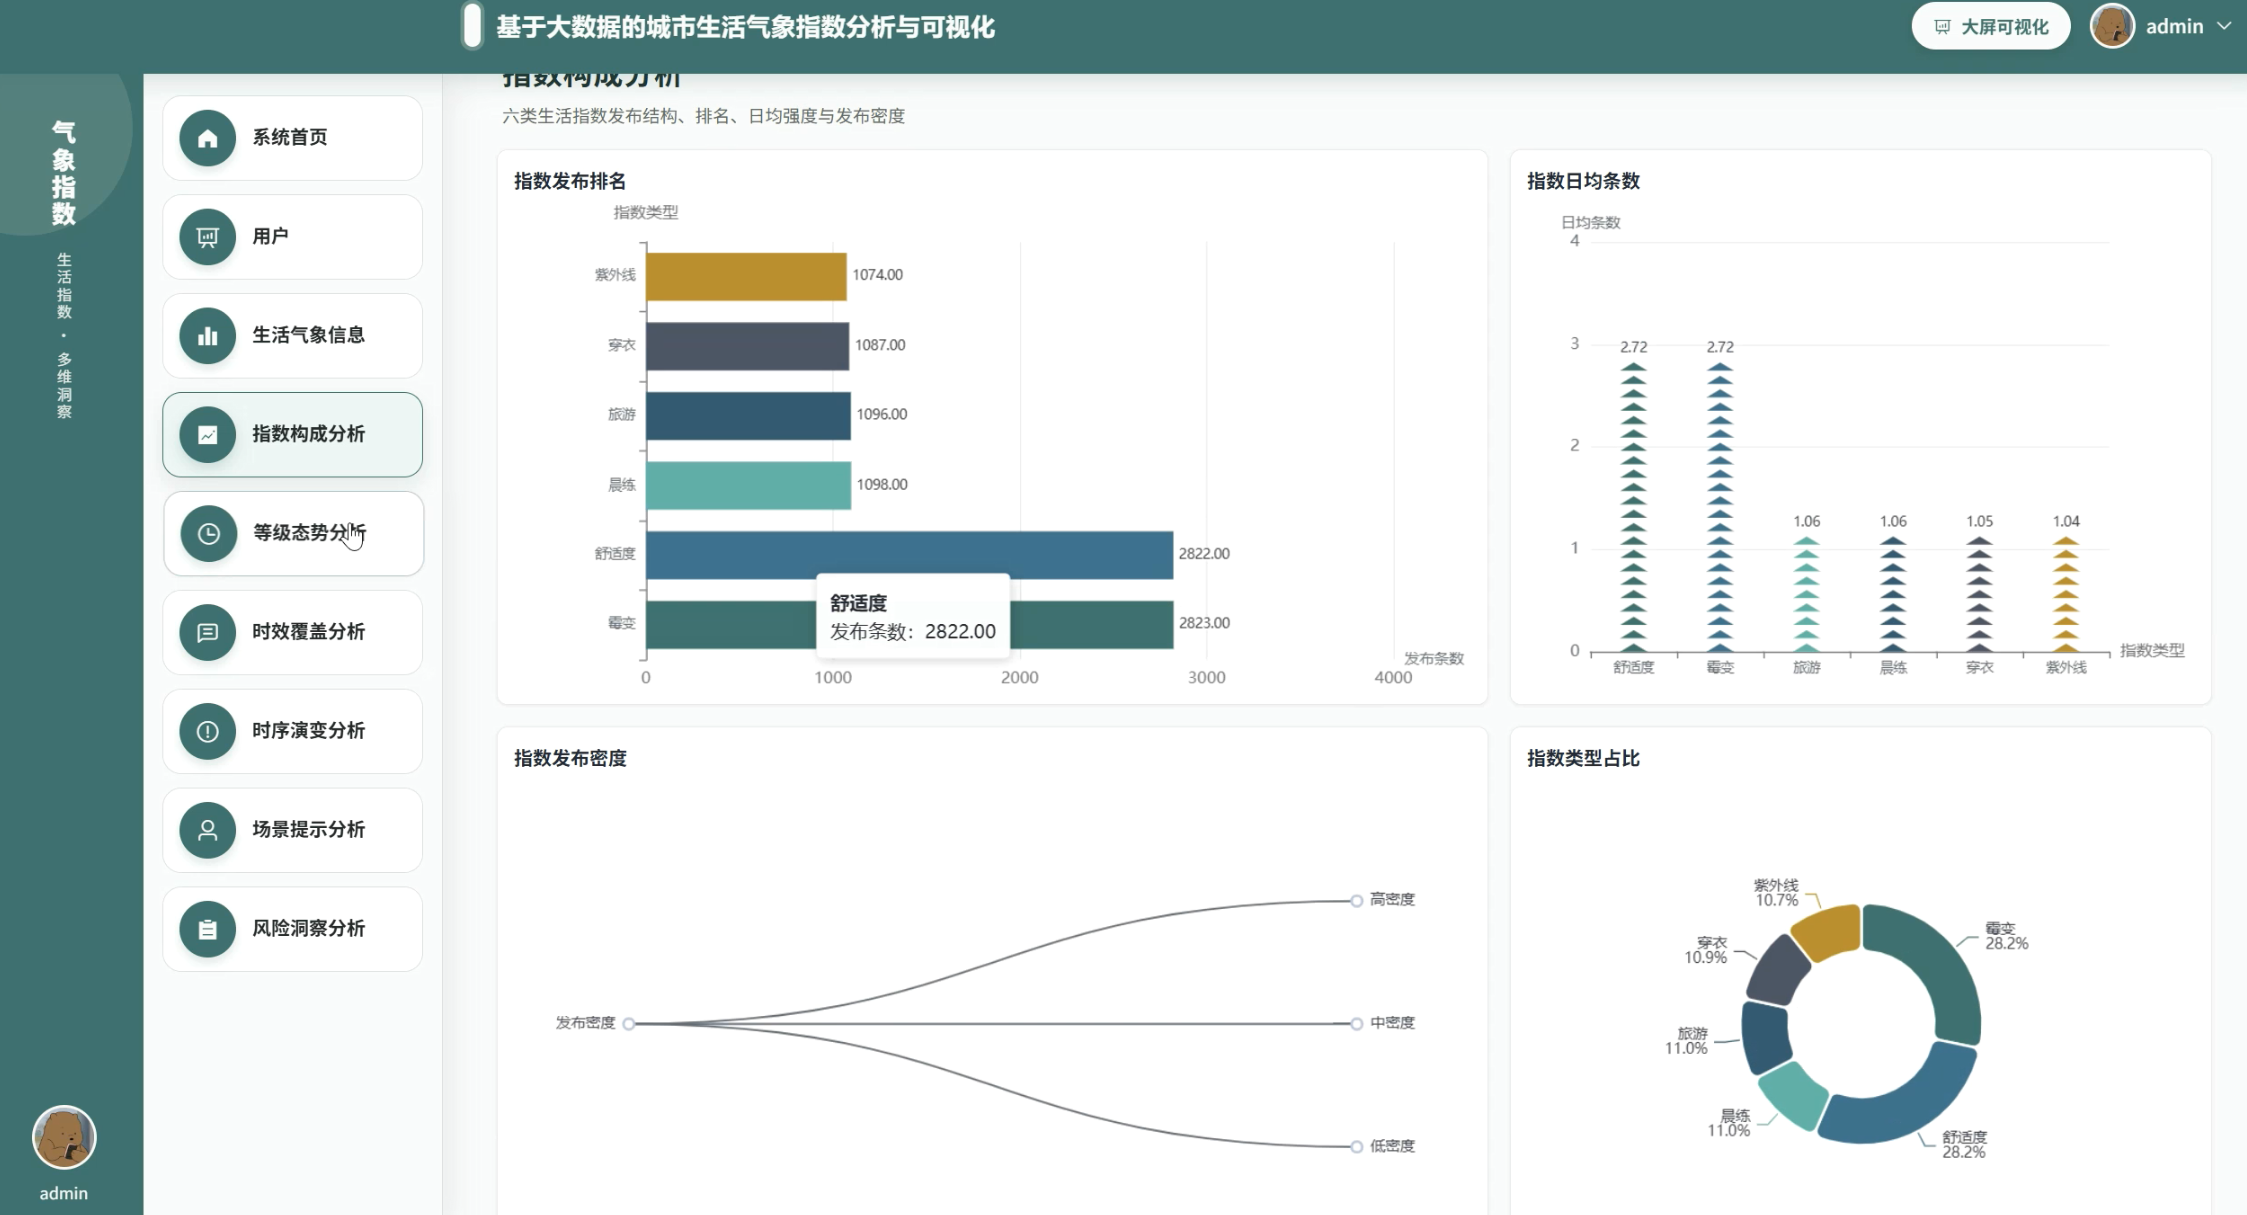
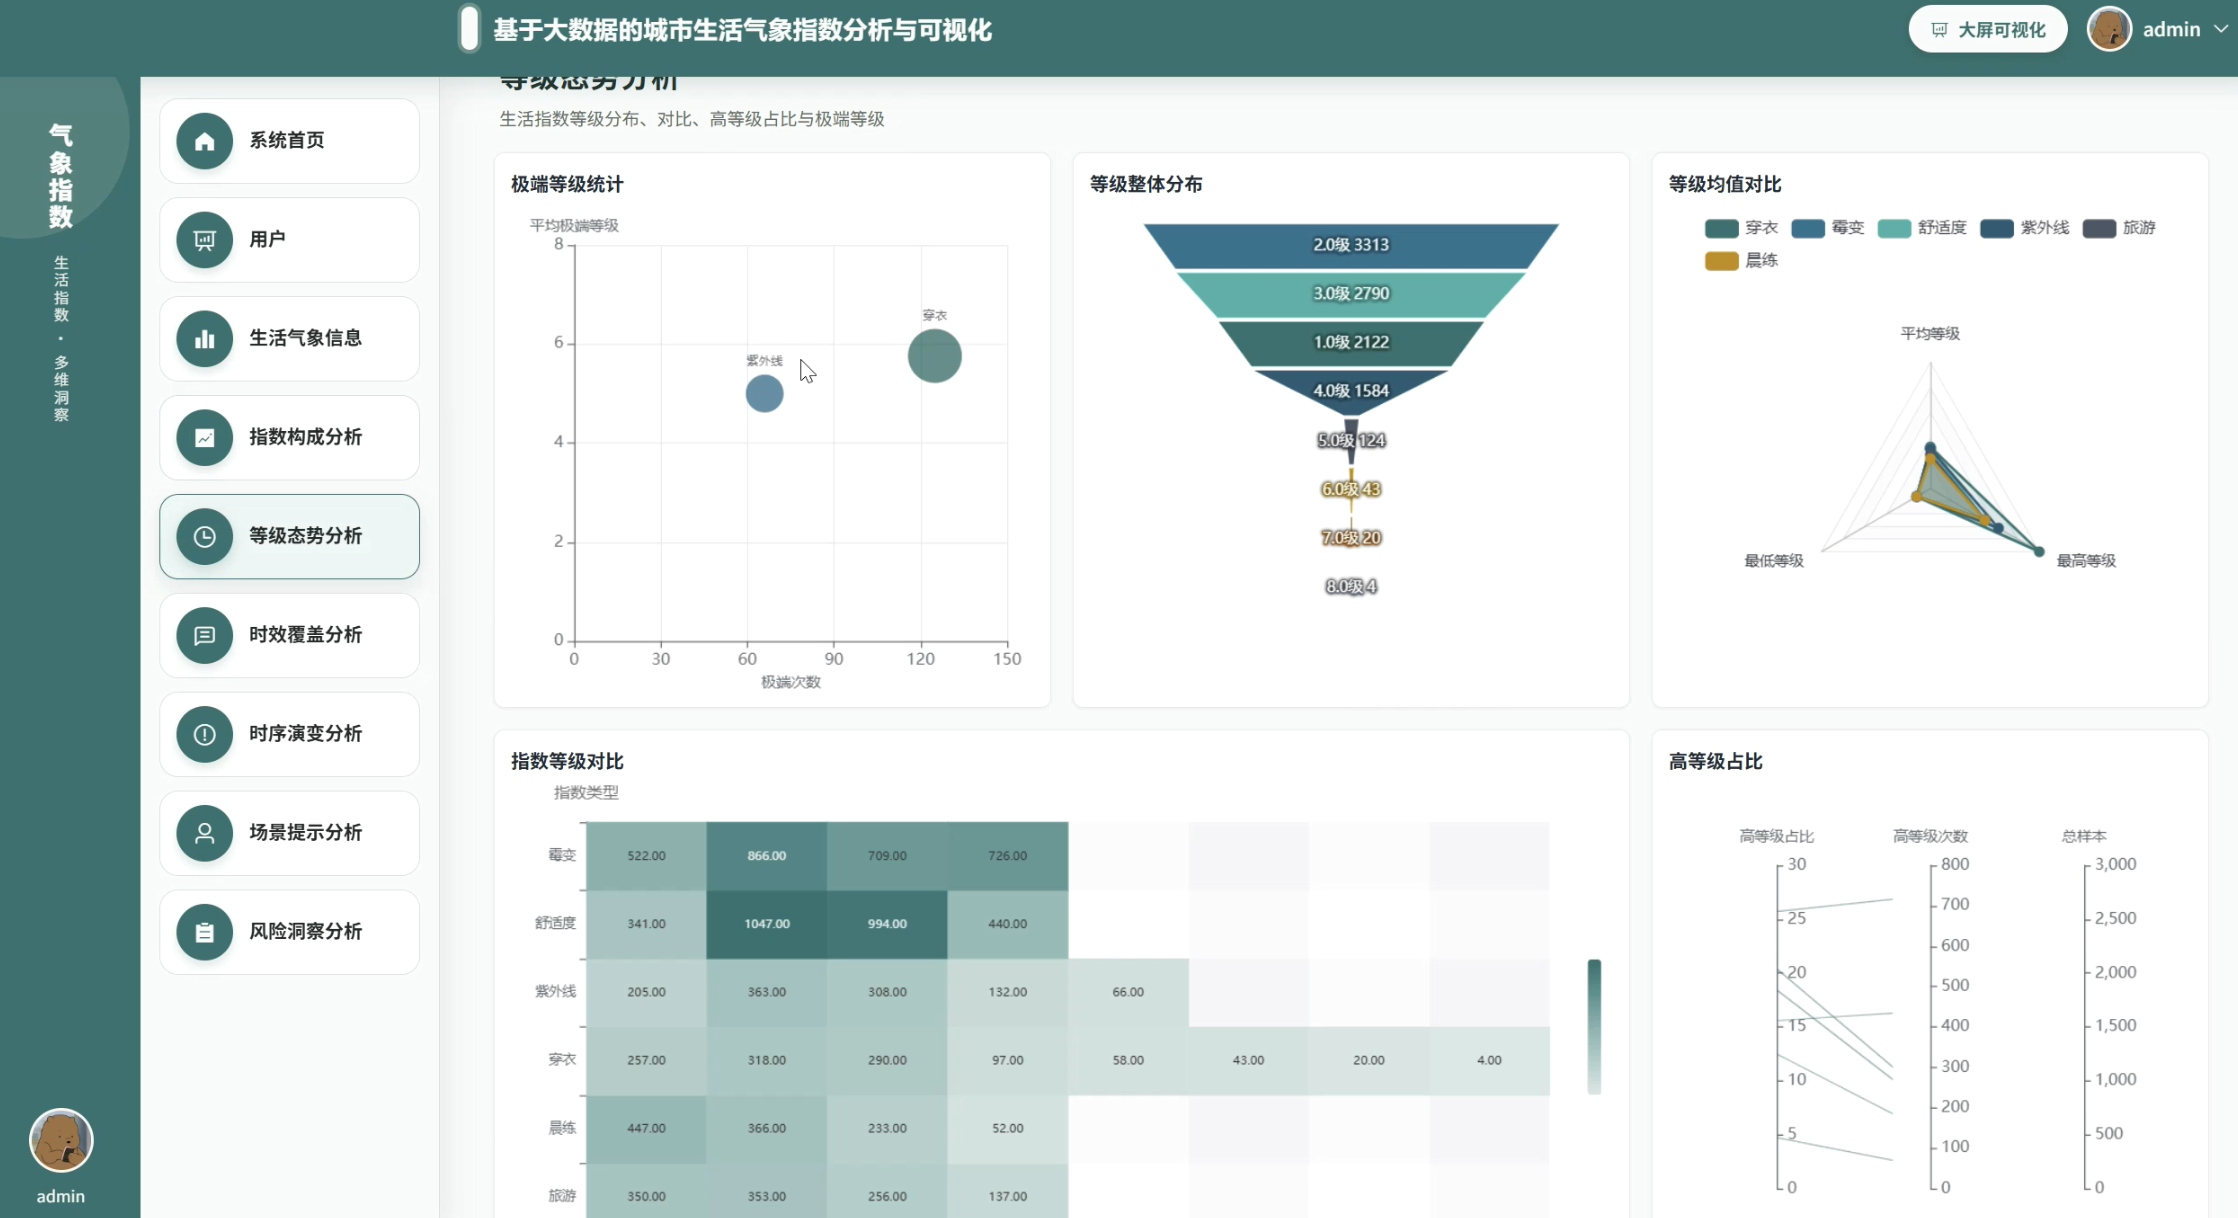
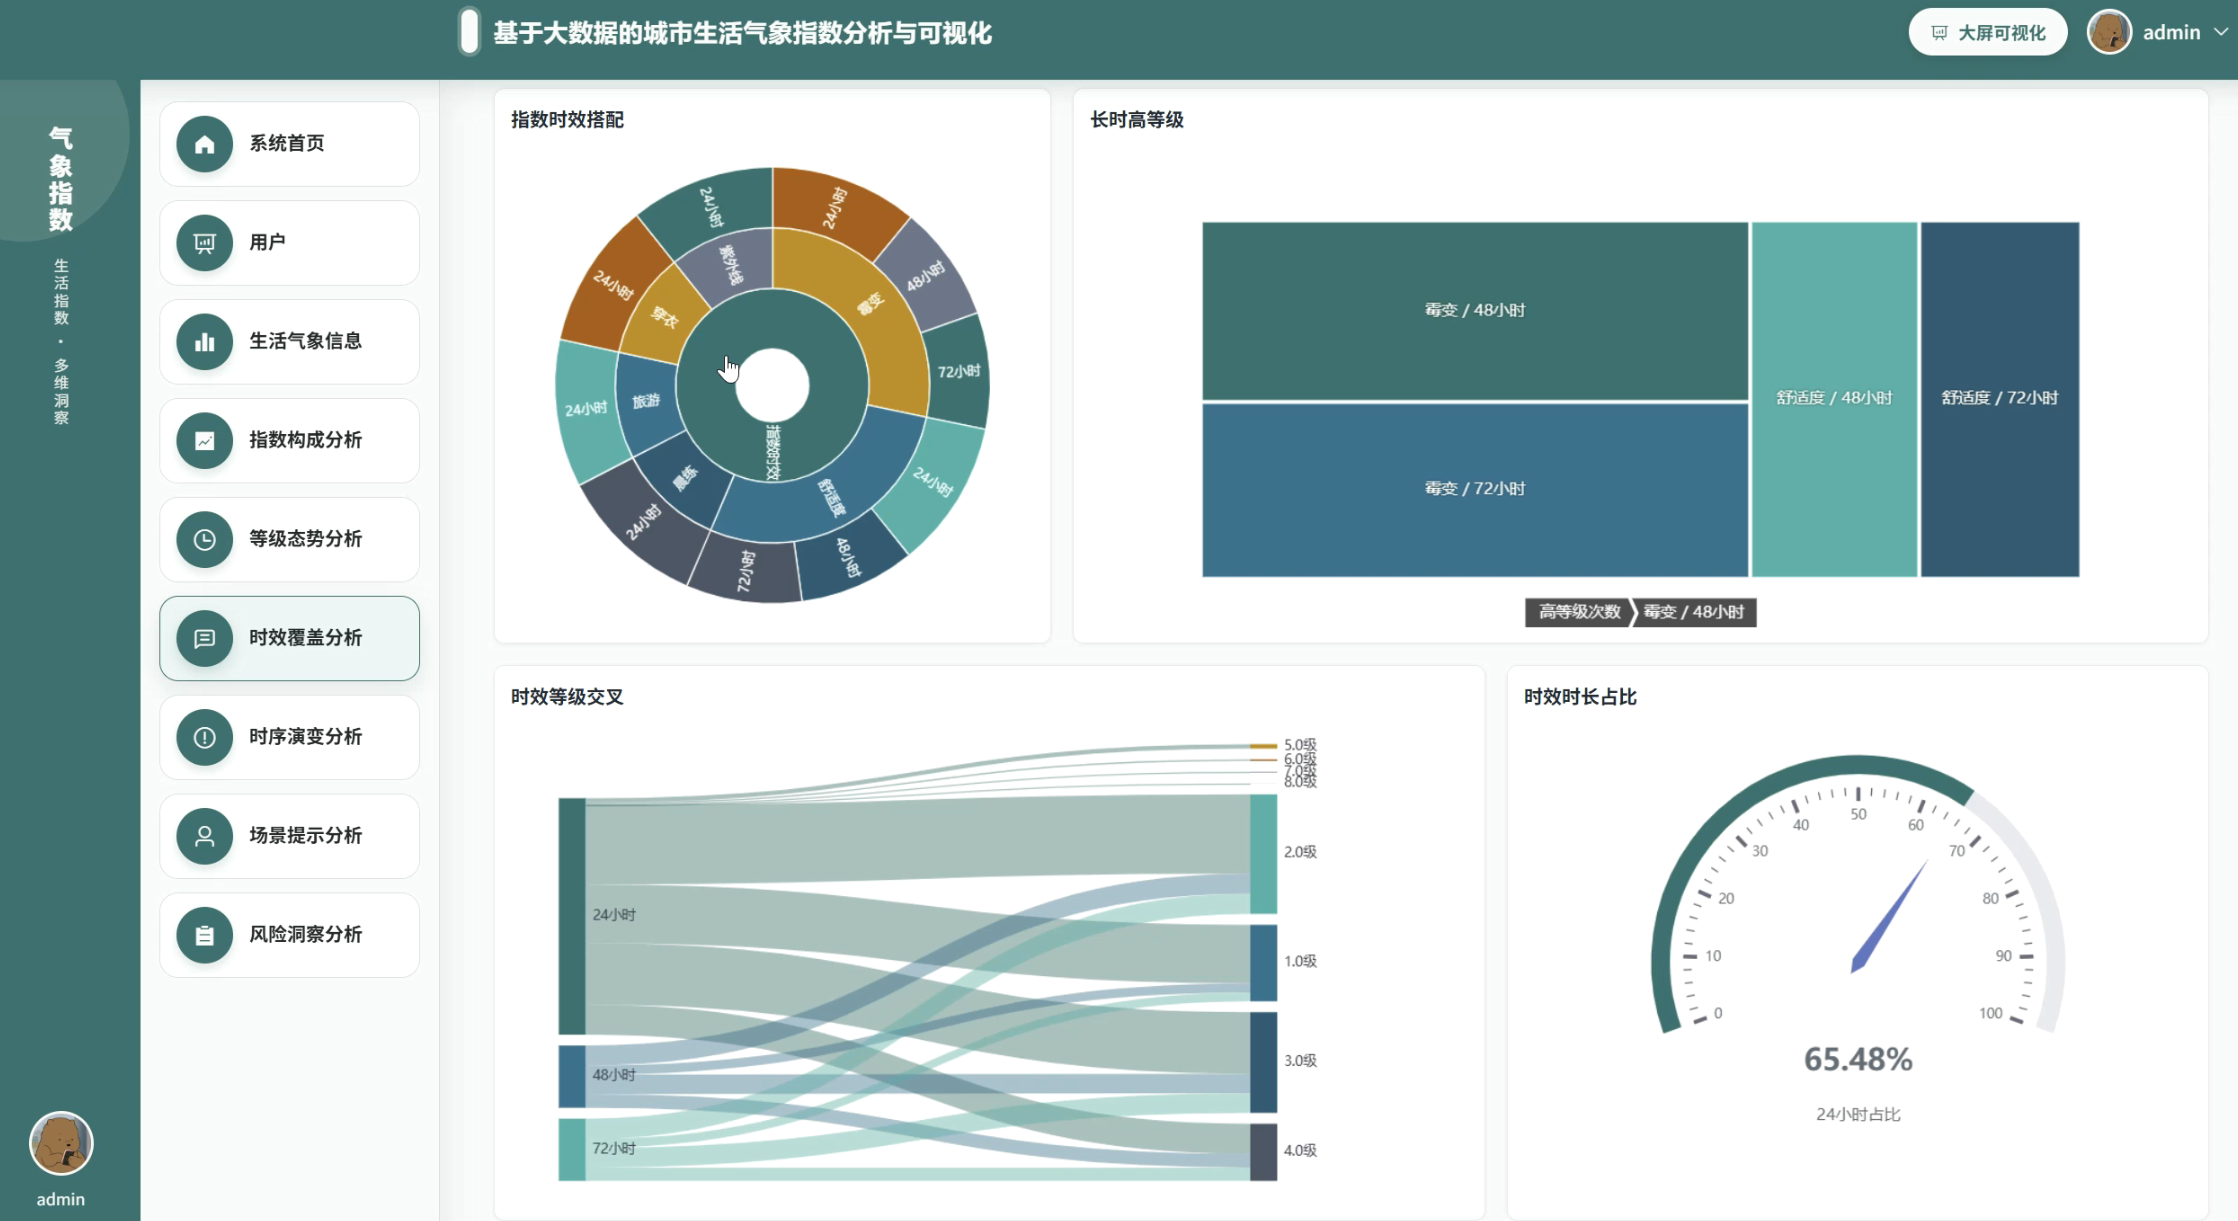
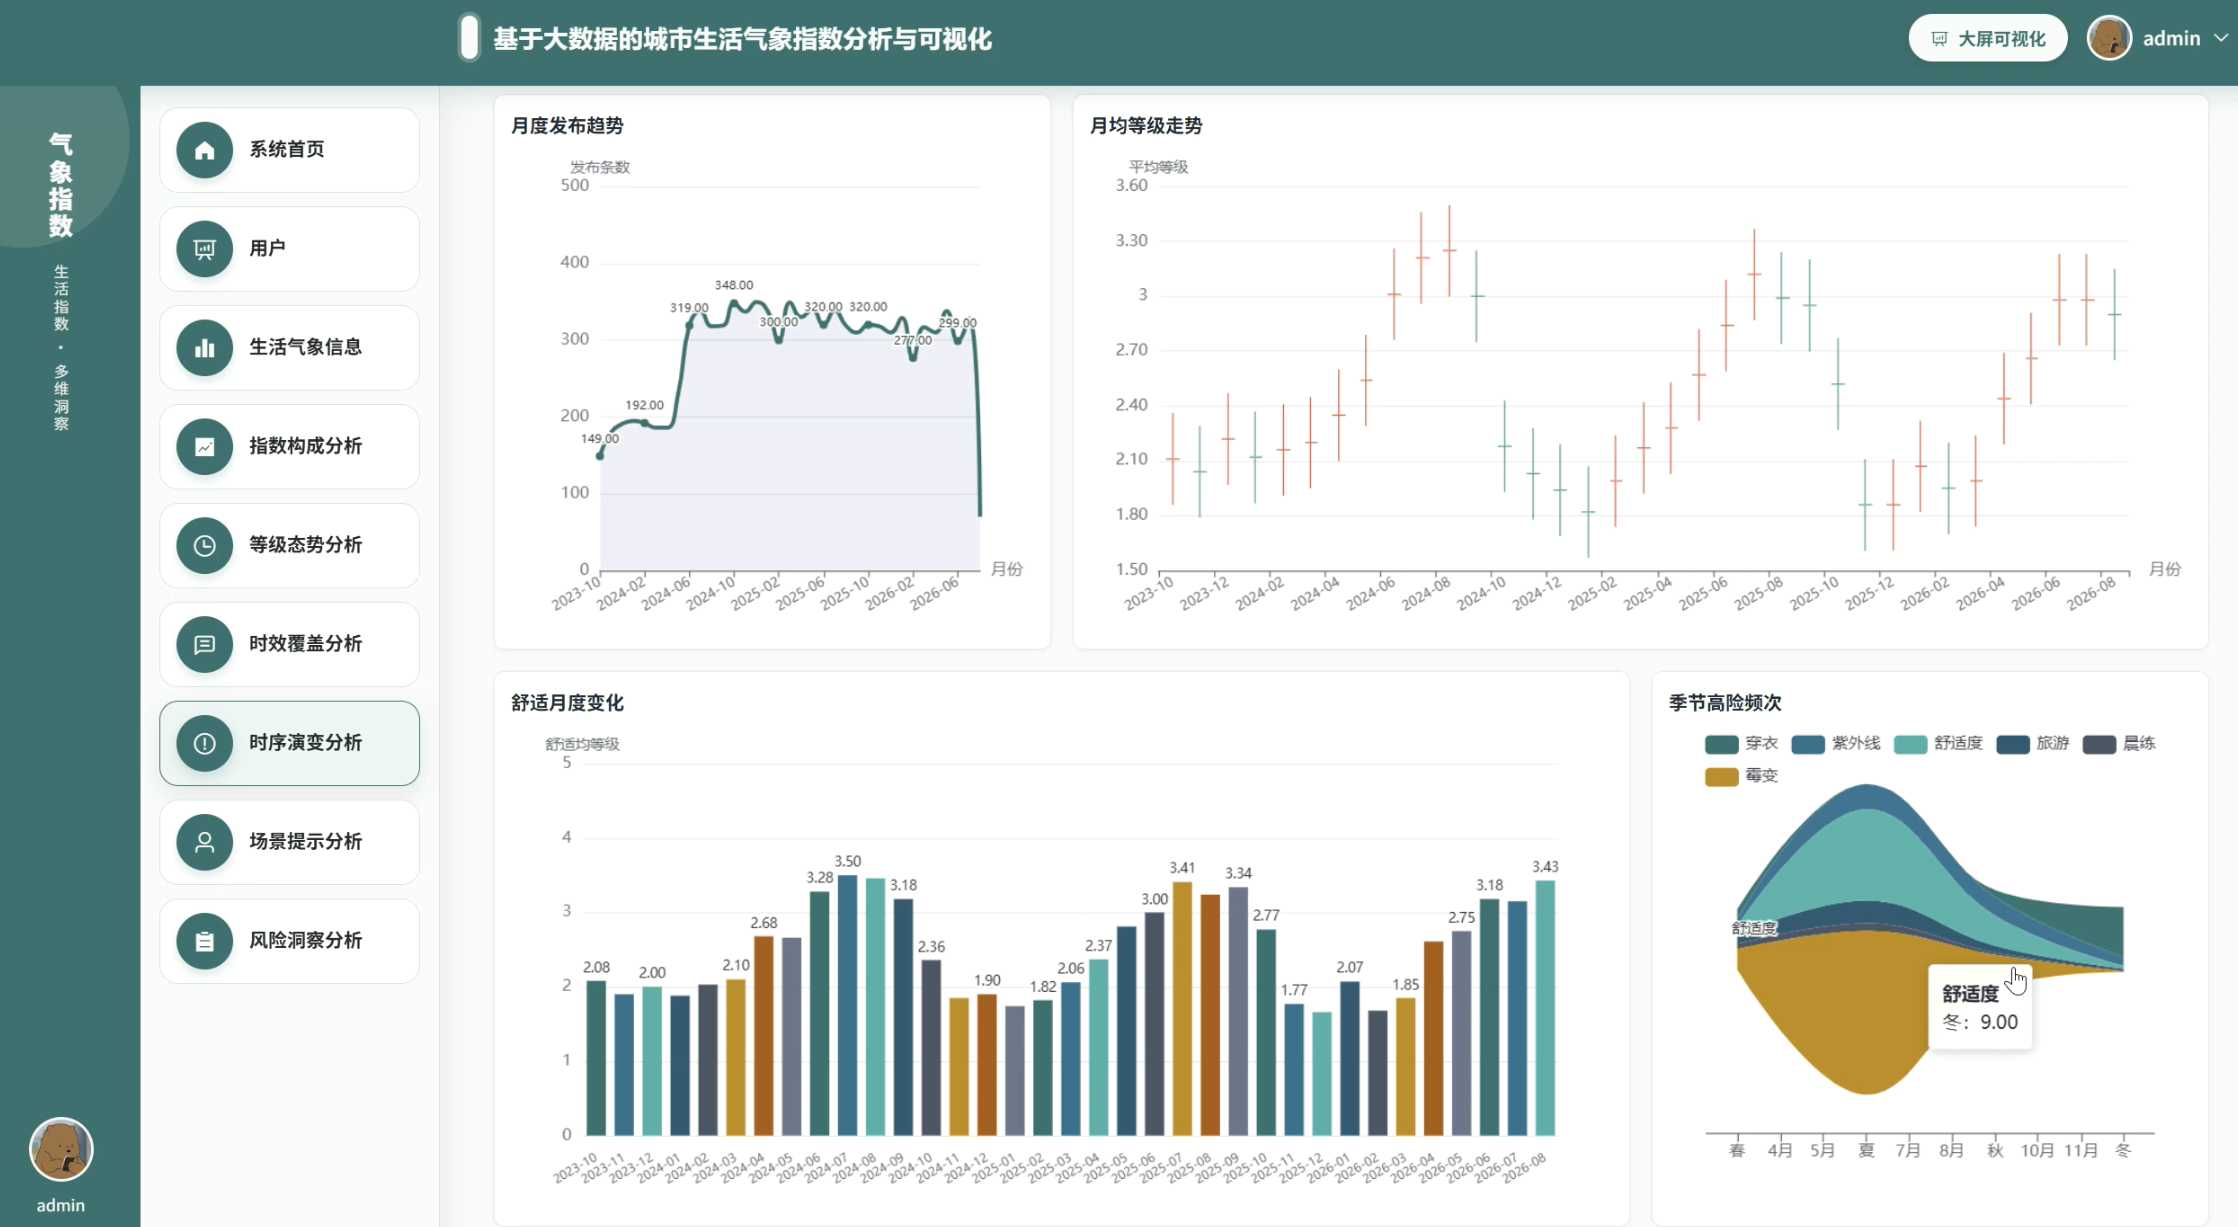
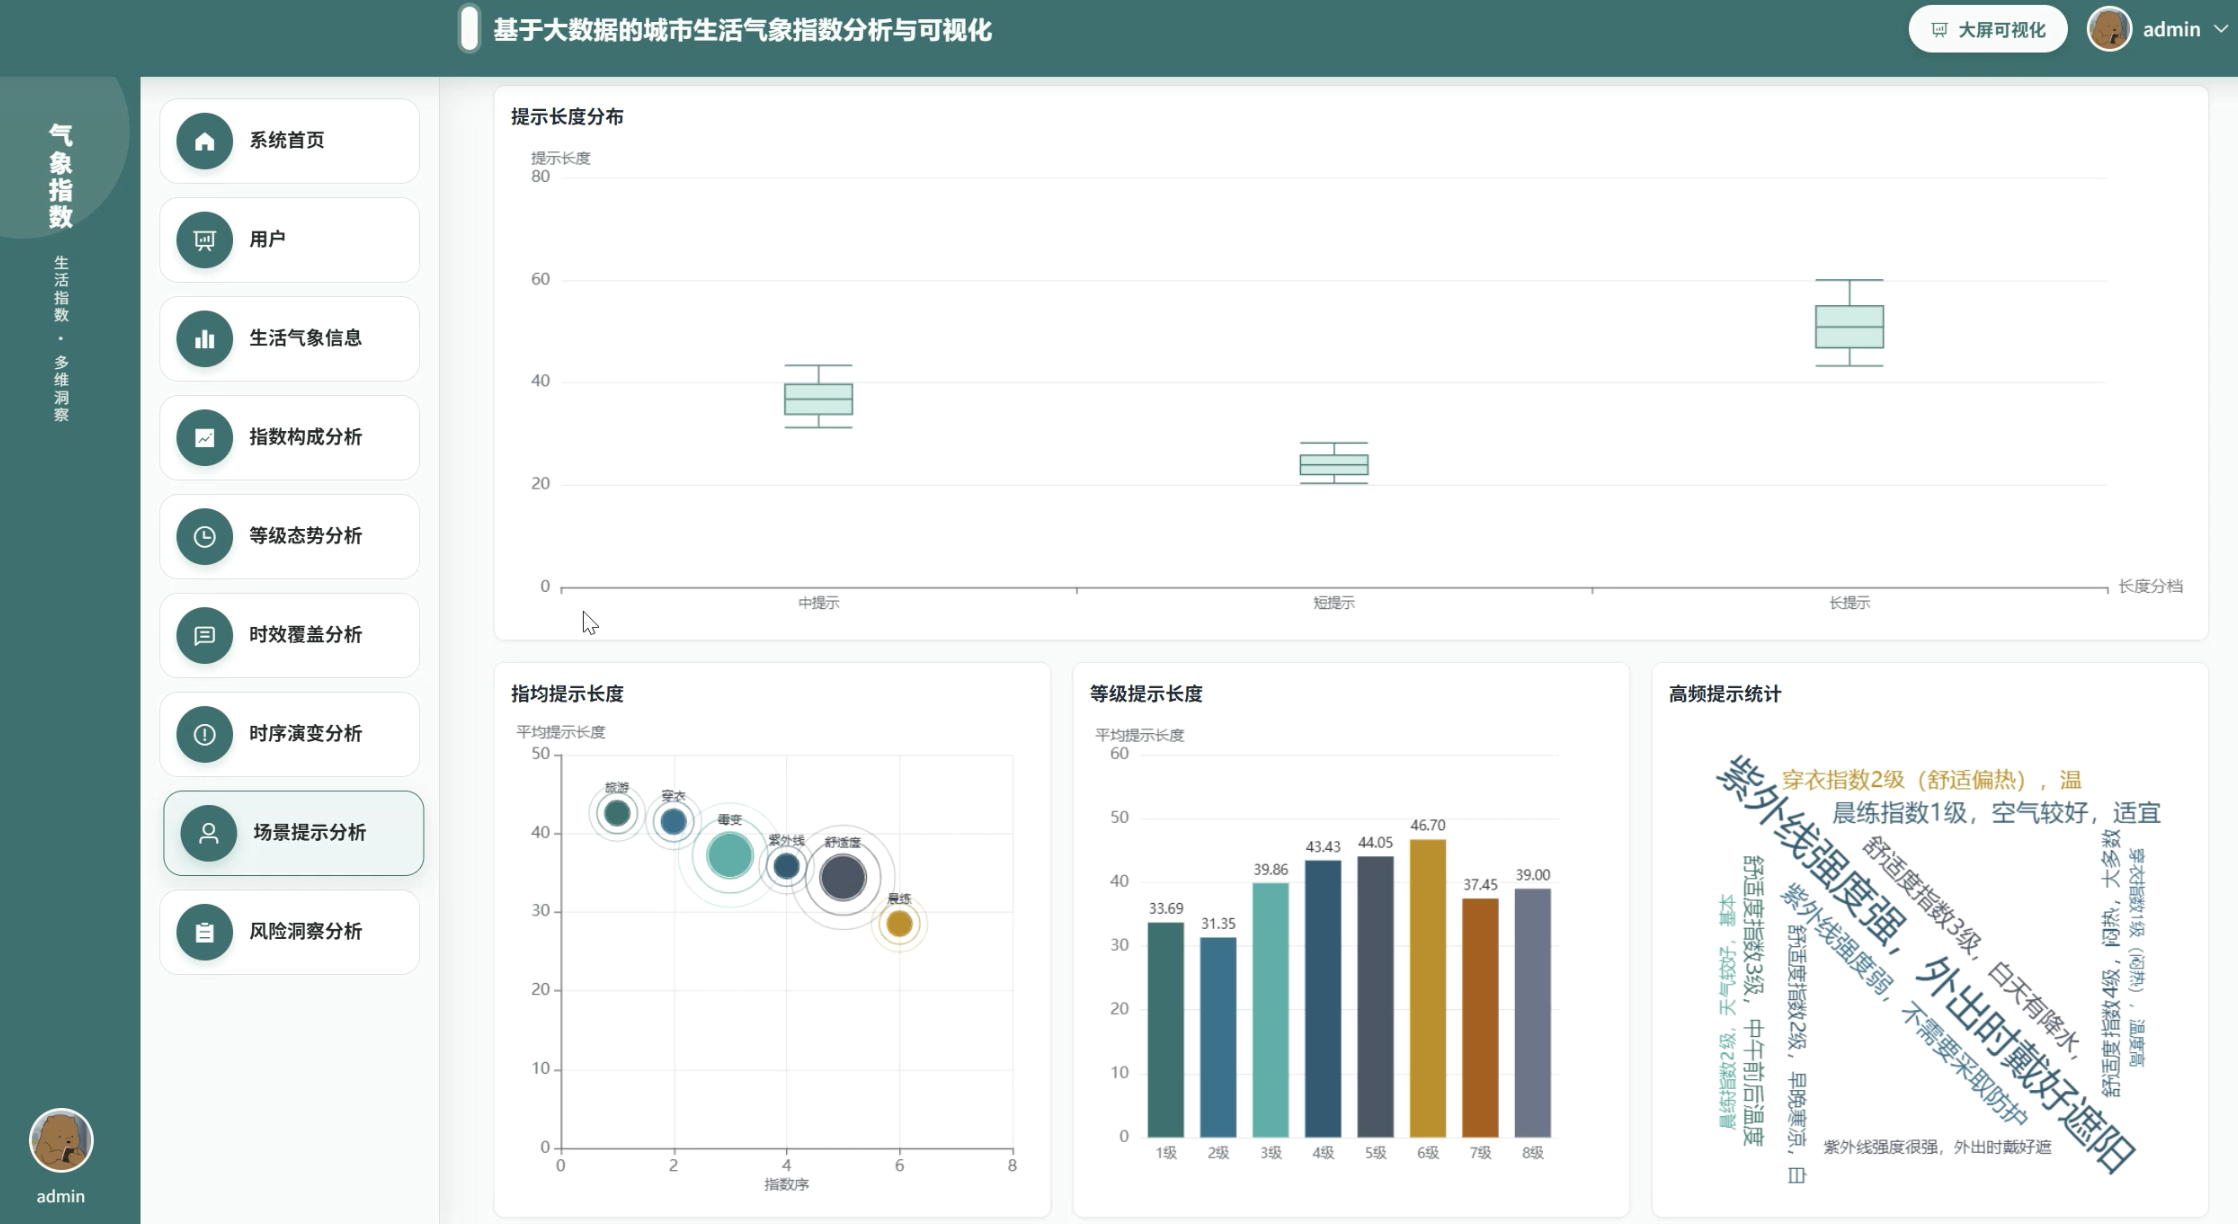
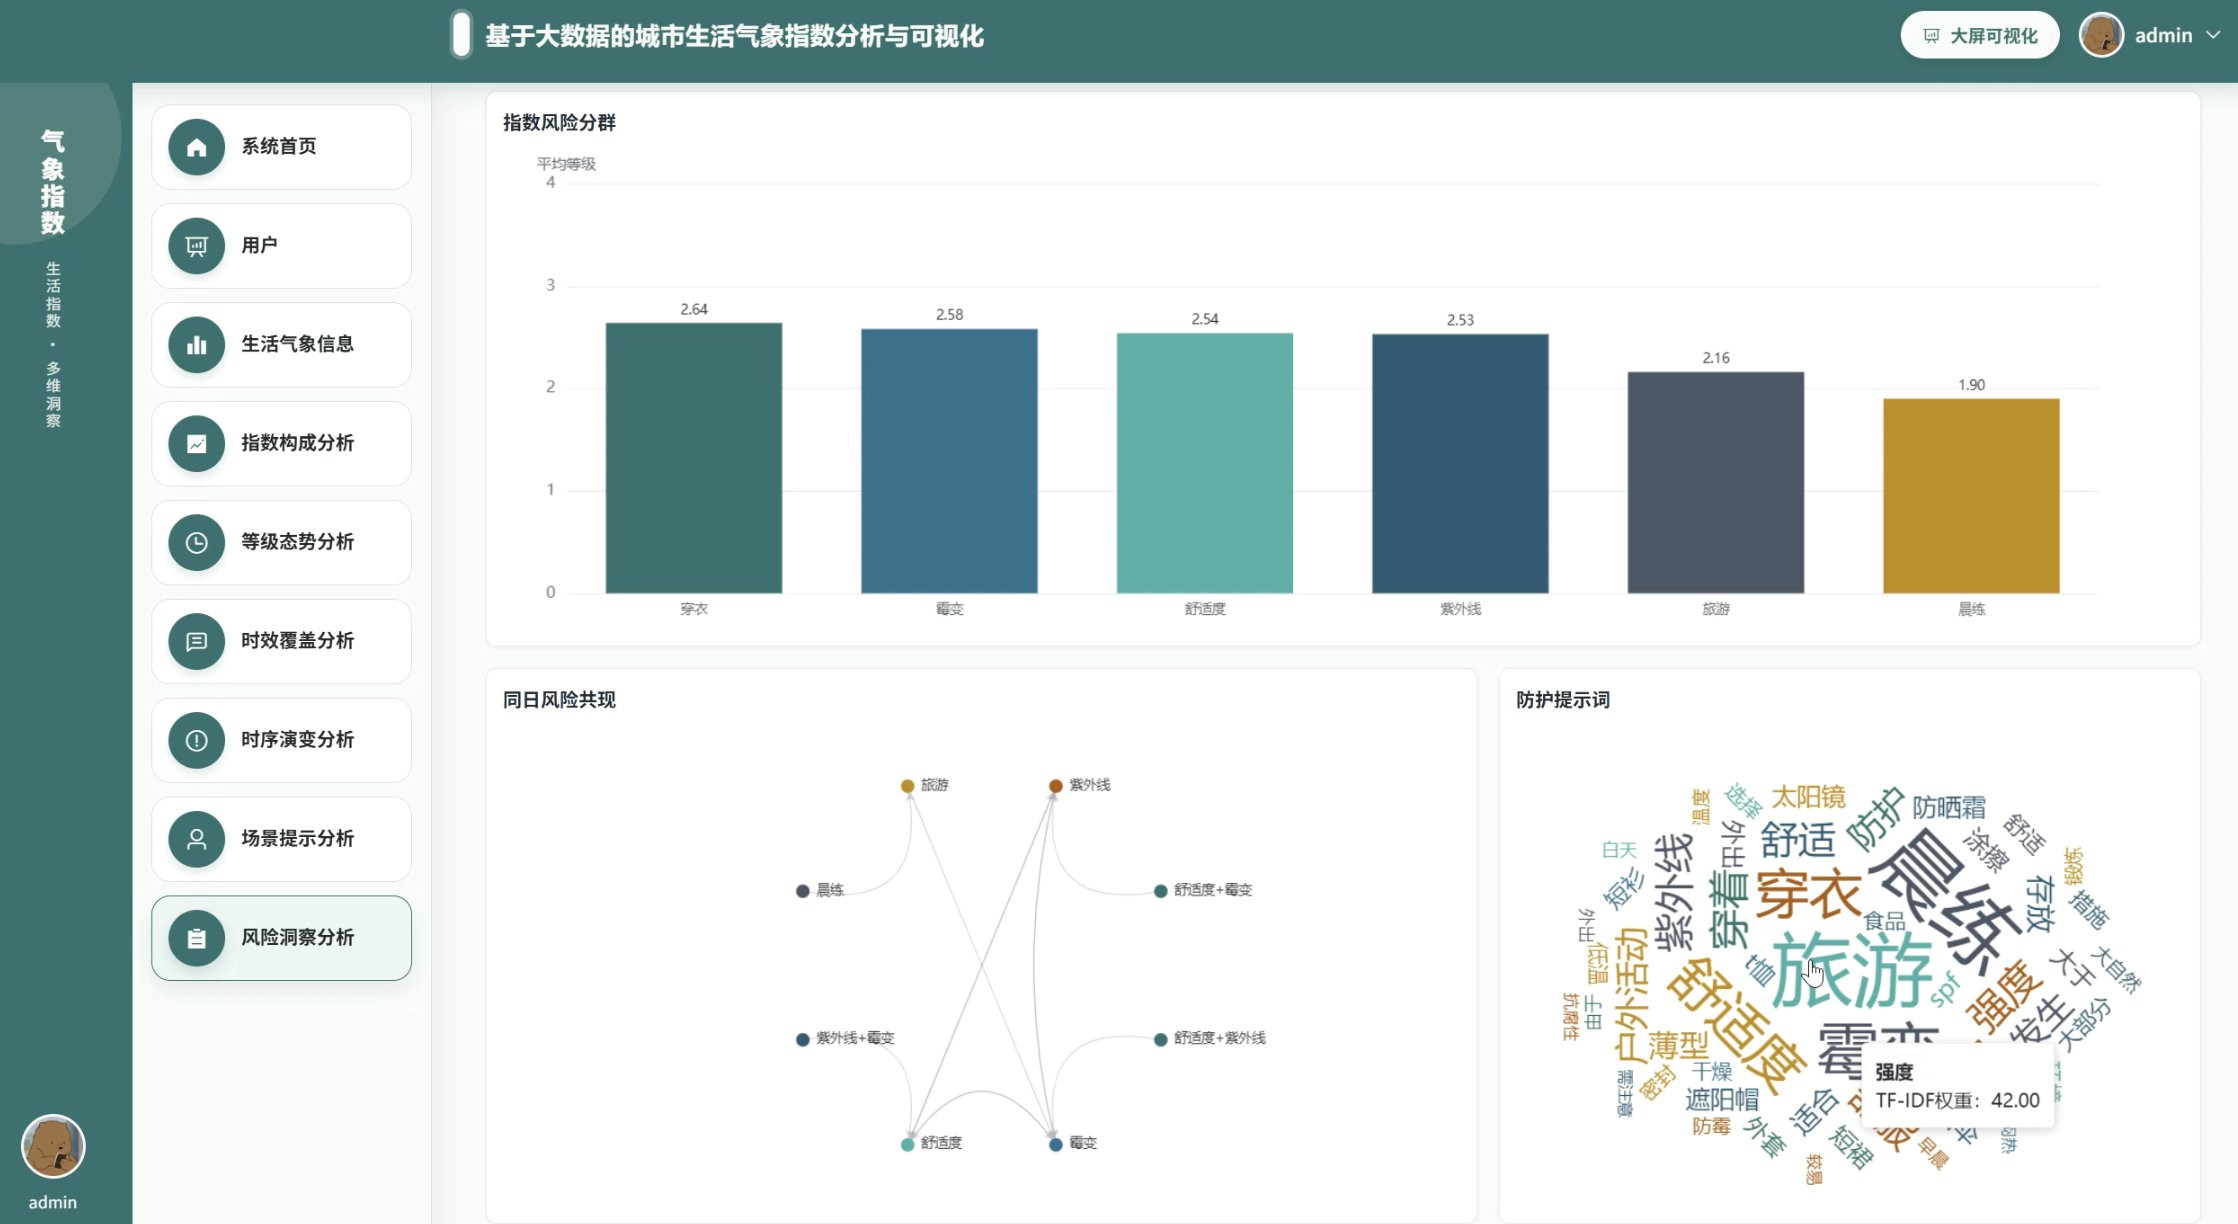
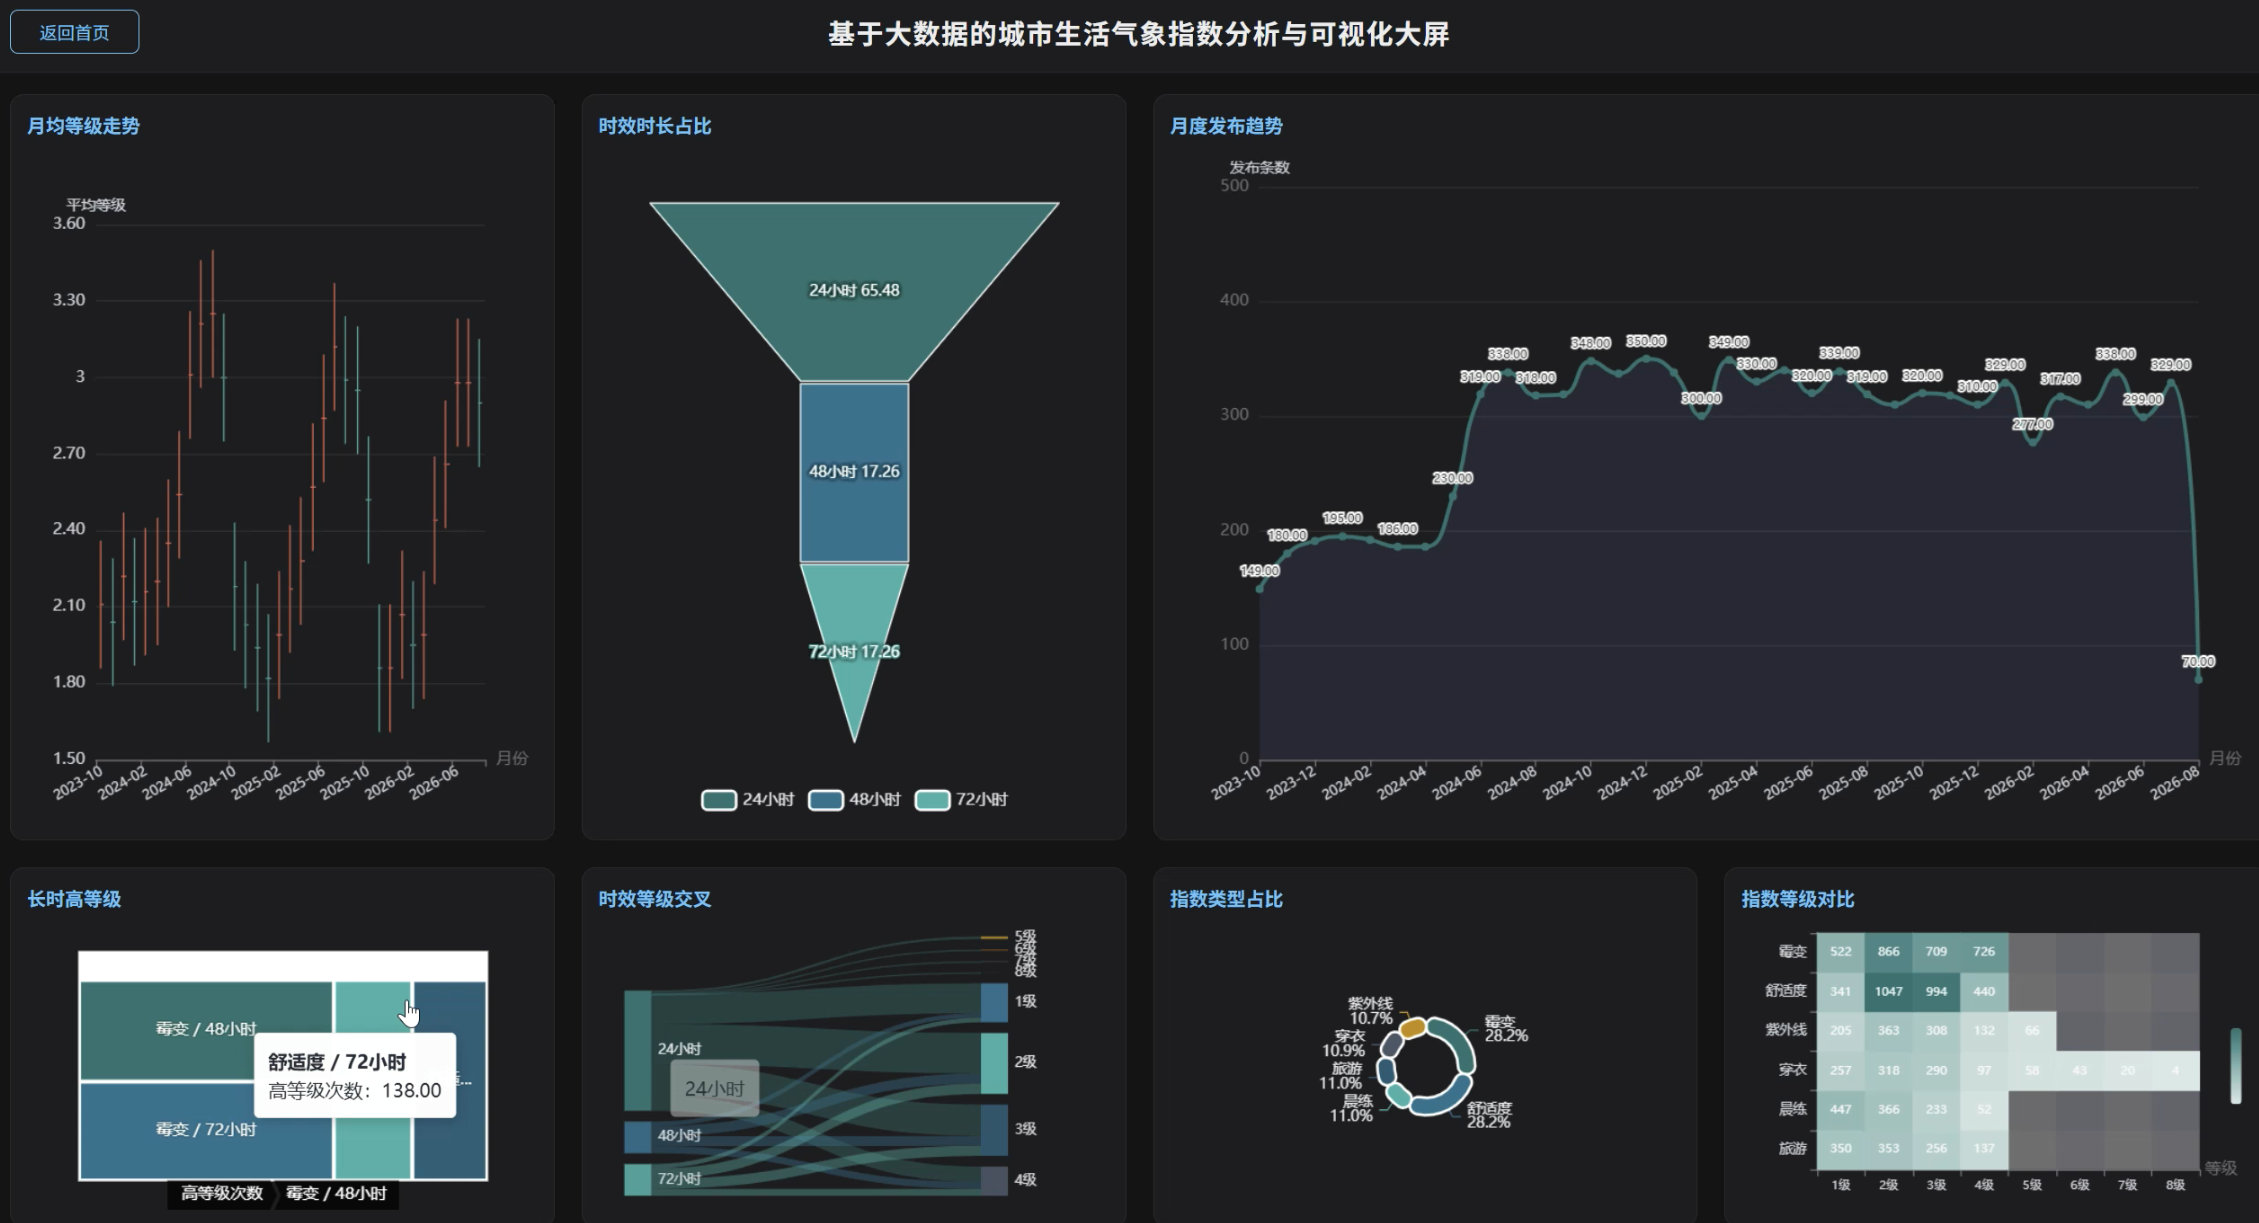
本系统采用 Hadoop 与 Spark 做数据接入和统计计算,后端用 Django 提供分析接口,前端用 Vue 与 ECharts 出图,风险洞察侧结合 K-Means、TF-IDF 与 FP-Growth;功能上覆盖指数构成、等级态势、时效覆盖、时序演变、场景提示六类分析页,以及指数风险分群、防护提示词和同日高等级共现,并附可视化大屏和生活气象信息的增删改查。
经系统测试,本系统能支撑气象相关学习者查看生活指数的等级、时效和提示结构,也能给计算机毕设同学演示 Spark 统计、K-Means 分群和 FP-Growth 共现结果,对把开放生活气象数据做成可点可查的分析站点有一点实际参考意义。
二、视频展示
计算机毕业设计选题推荐【基于大数据的城市生活气象指数分析
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
登录模块:
五、代码展示
def index_risk_cluster_analysis(input_df):
    """Spark 先聚合成指数画像,再 sklearn KMeans;标签按簇心平均等级相对排序。"""
    base = input_df.filter(
        col('index_name').isNotNull() & (col('index_name') != '')
        & col('level').isNotNull()
    )
    tip_ok = when(
        col('warm_tip').isNotNull() & (col('warm_tip') != '') & (col('warm_tip') != '未说明'),
        length(col('warm_tip')),
    )
    feat = (
        base.groupBy('index_name')
        .agg(
            spark_round(spark_avg('level'), 4).alias('avg_level'),
            spark_round(
                spark_sum(when(col('level') >= lit(HIGH_LEVEL_THRESHOLD), lit(1)).otherwise(lit(0)))
                / spark_count(lit(1)), 4
            ).alias('high_level_ratio'),
            spark_round(spark_avg(tip_ok), 4).alias('avg_tip_length'),
            spark_round(
                spark_sum(when(col('valid_hours').isin(48, 72), lit(1)).otherwise(lit(0)))
                / spark_count(lit(1)), 4
            ).alias('multi_validity_ratio'),
            spark_count(lit(1)).alias('sample_count'),
        )
    )
    pdf = feat.toPandas()
    from sklearn.cluster import KMeans
    from sklearn.preprocessing import StandardScaler
    from sklearn.metrics import silhouette_score

    feature_cols = ['avg_level', 'high_level_ratio', 'avg_tip_length', 'multi_validity_ratio']
    X = pdf[feature_cols].fillna(pdf[feature_cols].median()).values
    X_scaled = StandardScaler().fit_transform(X)

    best_k, best_score = 2, -1.0
    for k in (2, 3):
        if k >= len(pdf):
            continue
        labels_try = KMeans(n_clusters=k, random_state=42, n_init=10).fit_predict(X_scaled)
        if len(set(labels_try)) < 2:
            continue
        score = float(silhouette_score(X_scaled, labels_try))
        if score > best_score:
            best_k, best_score = k, score

    pdf['cluster_id'] = KMeans(n_clusters=best_k, random_state=42, n_init=10).fit_predict(X_scaled)
    centers_info = []
    for cid in sorted(pdf['cluster_id'].unique()):
        sub = pdf[pdf['cluster_id'] == cid]
        centers_info.append({
            'cluster_id': int(cid),
            'avg_level': float(sub['avg_level'].mean()),
            'member_count': int(len(sub)),
        })
    order = sorted(centers_info, key=lambda x: x['avg_level'])
    label_pool = ['相对温和型', '高风险常发型'] if best_k == 2 else ['相对温和型', '中等波动型', '高风险常发型']
    cid_to_label = {cinfo['cluster_id']: label_pool[i] for i, cinfo in enumerate(order)}
    pdf['cluster_label'] = pdf['cluster_id'].map(cid_to_label)
    pdf['high_level_ratio_pct'] = (pdf['high_level_ratio'] * 100).round(2)
    pdf['multi_validity_ratio_pct'] = (pdf['multi_validity_ratio'] * 100).round(2)
    return spark.createDataFrame(pdf[[
        'index_name', 'avg_level', 'high_level_ratio_pct', 'avg_tip_length',
        'multi_validity_ratio_pct', 'sample_count', 'cluster_id', 'cluster_label',
    ]])


def same_day_risk_cooccur_analysis(input_df):
    """篮子=发布日;项=当日出现过高等级(level>=4)的指数名称。"""
    from pyspark.ml.fpm import FPGrowth
    from pyspark.sql.functions import concat_ws, size, collect_set, to_timestamp, date_format

    base = input_df.filter(
        col('publish_time').isNotNull() & (col('publish_time').cast('string') != '')
        & col('level').isNotNull() & (col('level') >= lit(HIGH_LEVEL_THRESHOLD))
        & col('index_name').isNotNull() & (col('index_name') != '')
    )
    base = base.withColumn('ts', to_timestamp(col('publish_time').cast('string'), 'yyyy-MM-dd HH:mm:ss'))
    base = base.filter(col('ts').isNotNull())
    base = base.withColumn('publish_day', date_format(col('ts'), 'yyyy-MM-dd'))

    baskets = (
        base.groupBy('publish_day')
        .agg(collect_set('index_name').alias('items'))
        .filter(col('items').isNotNull())
    )
    basket_cnt = baskets.count()
    min_support = 0.05 if basket_cnt >= 20 else 0.1
    fp = FPGrowth(itemsCol='items', minSupport=min_support, minConfidence=0.3)
    model = fp.fit(baskets)
    freq = model.freqItemsets
    rules = model.associationRules

    select_cols = [
        concat_ws('+', col('antecedent')).alias('antecedent_items'),
        concat_ws('+', col('consequent')).alias('consequent_items'),
        spark_round(col('confidence'), 2).alias('confidence'),
        spark_round(col('lift'), 2).alias('lift'),
    ]
    if 'support' in set(rules.columns):
        select_cols.append(spark_round(col('support'), 2).alias('support'))

    rules_view = (
        rules.filter(size(col('antecedent')) >= 1)
        .filter(size(col('consequent')) >= 1)
        .select(*select_cols)
        .withColumn('metric_type', lit('关联规则'))
        .orderBy(desc('confidence'), desc('lift'))
    )
    if rules_view.count() == 0:
        result = (
            freq.withColumn('itemset', concat_ws('+', col('items')))
            .withColumn('freq_count', col('freq').cast('double'))
            .select(
                col('itemset').alias('antecedent_items'),
                lit('(频繁项集)').alias('consequent_items'),
                spark_round(col('freq_count') / lit(float(basket_cnt or 1)), 2).alias('confidence'),
                lit(1.0).alias('lift'),
                lit('频繁项集').alias('metric_type'),
            )
            .orderBy(desc('confidence'))
        )
    else:
        result = rules_view
    path = _save_local_csv(result, 'same_day_risk_cooccur_analysis')
    return result
六、项目文档展示

七、项目总结
本课题围绕「基于大数据的城市生活气象指数分析与可视化」展开,把深圳气象局开放的生活指数样本经清洗预处理后接入 Hadoop/Spark,按指数构成、等级态势、时效覆盖、时序演变、场景提示与风险洞察六个维度做统计与挖掘,再用 Django、Vue、ECharts 做成可查询的分析页与可视化大屏。风险侧用 K-Means 给霉变、舒适度、穿衣、紫外线等指数做风险分群,用 TF-IDF 抽取防护提示词,用 FP-Growth 挖掘同日高等级共现,把算法结果和业务图表放在同一套系统里。整体看,本系统把等级、时效和温馨提示这些原本散在表格里的记录收成可对照、可复用的分析站点,既方便查看城市生活气象服务结构,也提供信息维护入口,并能支撑毕业设计演示和相关学习使用,对同类生活气象数据分析可视化课题有一定参考价值。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
更多推荐

 5
 0
- 0


 已为社区贡献24条内容

所有评论(0)