
ICML 2026 | 如何自动检测多模态大模型的“系统性图文幻觉”?
开篇总结
多模态大模型(MLLM)在自动生成图像描述(Image Captioning)或医学影像报告时,经常产生图文不符的“幻觉”。但更可怕的是“系统性错配”(Systematic Misalignments)——即模型一看到特定视觉特征,就会稳定发生某种特定文字错误(例如:医疗X光片中一出现“起搏器”,AI报告就频繁误诊“心脏肥大”)。
斯坦福大学团队发表于 ICML 2026 的这项研究,提出了首个专门用于自动检测这种系统性图文错配的自动化框架 SYMBAL,并构建了包含170万图文对的评估基准 SYMBALBENCH。SYMBAL无需访问模型内部参数,仅靠图文数据集即可精准识别模型的系统性“盲区”,准确率比同类方法提升近4倍!
值不值得读
- 推荐指数:★★★★☆(4/5星 - 多模态/数据集审计必读)
- 适合:多模态大模型(MLLM)开发者、计算机视觉/医疗AI研究员、数据集构建与数据质量审查工程师。
- 预计阅读时间:
- 导读版:大约 8-10 分钟(精炼核心创新点与实践价值)
- 原论文:大约 45-60 分钟(全文14页,包含具体聚类算法、评估提示词及完整消融实验)
这篇论文的价值
解决的痛点是什么?
过去行业评估 MLLM 幻觉(如 CHAIR、CLIPScore),都是“单张图单句话”看错也没错。但在实际落地(尤其是医疗、安全等高危领域)中,偶然的个案错误不可怕,可怕的是“规律性犯错”。
例如,模型在训练时学到了伪相关性(Spurious Correlation)——现实中起搏器患者常伴有心脏肥大,但有起搏器不等于一定有心脏肥大。当模型形成这种定式思维后,只要看到起搏器就盲目写上心脏肥大。这种错误极具隐蔽性,传统单样本评估很难察觉,且会随着预训练数据集(如 ShareGPT4V)的传播扩散到下一代大模型中。
为什么作者要研究这个问题?
作者希望提供一种“黑盒诊断工具”,在不接触模型权重的情况下,仅通过审计生成的大规模数据集,就能自动告诉开发者:“你的模型只要遇到视觉特征 v v v,就会大概率瞎编文字错误 t t t”。
EasyReader AI论文导读示例
- 研究目的:自动化识别多模态大模型在生成图像描述时存在的系统性错配(即文字错误与特定视觉特征的高频绑定关系)。
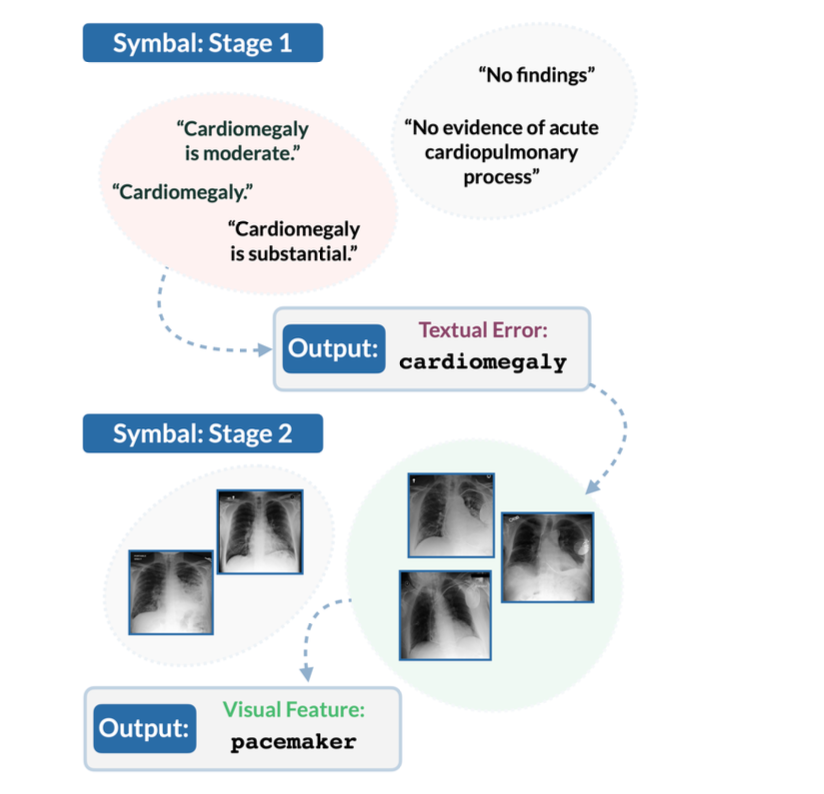
- 研究方法:提出两阶段(Dual-Stage)解耦架构:
- 阶段一(文字错误检测):将文本切分为事实语义句,利用文本嵌入(Text Embedding)进行球面 K-Means 聚类,结合 Vision-Language 打分器筛选出图文错配度最高的事实簇,并用 LLM 总结为统一概念 t ^ \hat{t} t^。
- 阶段二(视觉特征关联):提取包含错配事实 t ^ \hat{t} t^ 的图像集,利用图像嵌入进行聚类和错配打分,最后由 MLLM/LLM 总结出导致该错误的共同视觉特征 v ^ \hat{v} v^。
- 创新点:
- 首次正式定义了“系统性错配检测”(Systematic Misalignment Detection)任务;
- 提出了包含 420 个子数据集、170万图文对的基准库 SYMBALBENCH;
- SYMBAL 实现了 63.8% 的端到端检测准确率,较现有 Direct Prompting Baseline(17.1%)提升近 4 倍。
以上内容为 EasyReader自动生成导读的部分节选。
用EasyReader高效阅读论文,下载体验:
https://www.easyreader.com.cn/
✓ 核心创新点拆解
✓ 关键实验结果总结
✓ AI论文问答
✓ 思维导图
✓ 还原排版 中英对照翻译阅读
如果你只看10分钟
如果你时间有限,建议按照以下顺序和策略阅读原论文:
- Section 1 & 3 (Introduction & Task Definition) —— 精读(4分钟)
- 搞懂什么是“系统性错配”,看懂 Figure 1 的直观示例(自然图像与医疗X光的对比)。
- Section 4 (Our Approach: SYMBAL) —— 精读(3分钟)
- 看懂 Figure 2 的两阶段流程(Stage 1 找文本错配句,Stage 2 找对应的视觉特征)。
- Section 6.3 & 6.4 (Results & Real-World Settings) —— 泛读(3分钟)
-
看 Figure 3/4/5。重点关注在真实开源数据集(如 ShareGPT4V)中,Symbal 发现了什么(例如:模型看到餐桌/蛋糕就盲目生成“白色桌布”的规律性幻觉)。
-
可跳过部分:Section 2(Related Work)、Section 5(Benchmark 详细构造过程)以及 Appendix。除非你需要复现基准测试,否则跳过不影响理解主干。
总结
为什么值得关注:
随着合成数据(Model-Generated Captions)成为多模态大模型预训练的主力,预训练集中的“毒素”与系统性偏见将严重影响下一代模型。Symbal 提供了一套高效、自动化的“数据质检与模型审计”解决方案。
阅读建议:
- 谁应该继续阅读原论文:正在从事 MLLM 数据集清洗、模型 Hallucination 评估、以及医疗 AI 可信度研究的科研人员,建议深入论文 Section 4 与 Appendix 了解其 Prompt 设计与模型搭配。
- 谁只看导读即可:仅需了解多模态最新进展、或寻找数据集审计工具思路的读研/读博同学,阅读本篇导读已能完全掌握其核心思想。
论文原文
更多推荐



 8
 0
- 0


 已为社区贡献4条内容

所有评论(0)